FreefieldがHiggsfield風の120アプリをComfyUIワークフローとして実行
FreefieldはHiggsfieldのクリエイティブアプリを、オープンウェイト上のComfyUIワークフローとして再構築します。各アプリはapp.jsonと検証済みのAPIワークフローを収めた1つのフォルダーです。
ほとんどのAI動画・写真サイトは、同じものを別の名前で売っています。固定パイプラインの上にフォームを載せただけです。Freefieldの作者はそのカタログを分解し、各項目をAPI形式のComfyUIワークフローとして作り直しました。さらに、アプリごとのコードを書く代わりに、ワークフローのマニフェストからウェブUI全体を生成しています。
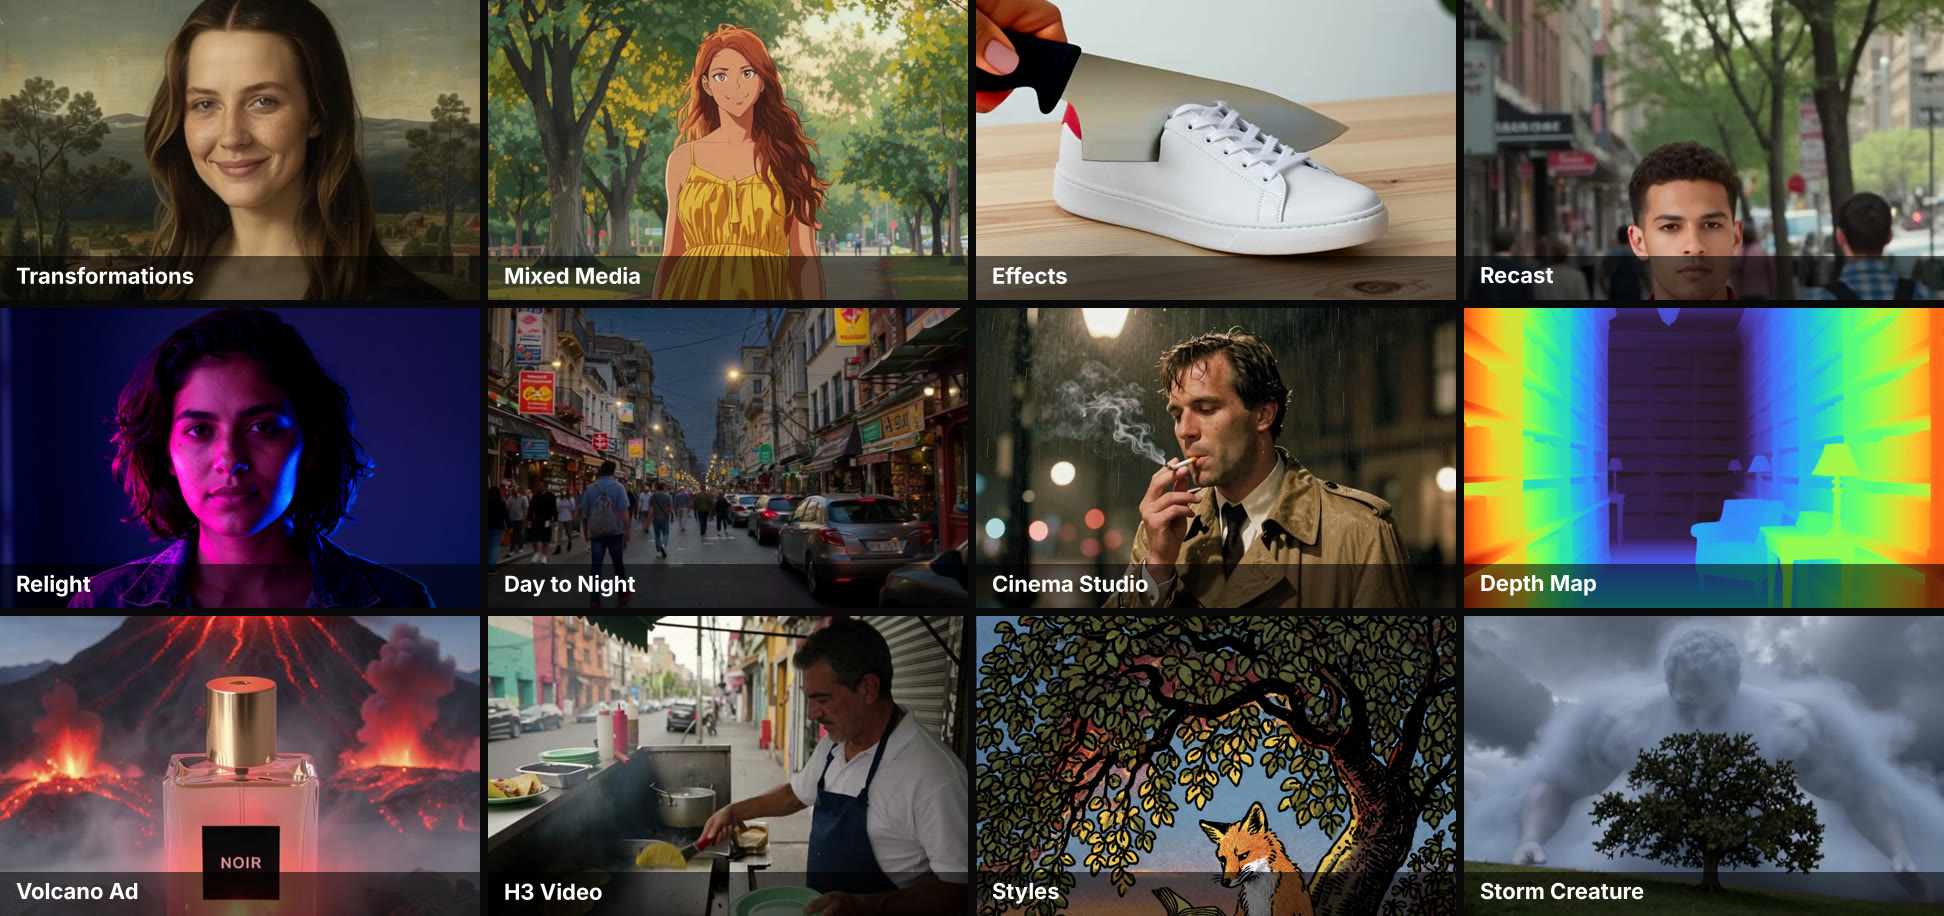
アプリの作例12点。いずれも固定シードでの実行結果で、アプリは結果の横に実時間とピークVRAMを表示します。
すべてのアプリは1つのフォルダー
Freefieldのアプリは apps/ 配下のディレクトリで、app.json マニフェストとAPI形式のComfyUIワークフローを格納しています。メニュー、フォーム、モデルのダウンロード、VRAMマップ、テストはすべてこれらのマニフェストから導出されるため、アプリの追加はフォルダーとワークフローの追加だけで済みます。リポジトリには現在120個のアプリフォルダーがあり、そのうち119個が準備完了とされています。作者のローンチ記事では、Higgsfieldが掲載する129個のツールとアプリのうち95個をカバーしているとされています。
リクエストの経路は短く、ComfyUI APIの内側で完結します。
browser ──▶ web/ + server/ (Node, Comfy SDK) ──▶ gateway :8000 ──▶ comfy-api-proxy :8189 ──▶ ComfyUI :8188
             forms drawn from apps/*/app.json      unloads the GPU   Comfy API v2        your GPU
                                                   when the app changes
2つのアプリが異なるベースモデルを使う場合、ゲートウェイはComfyUIの POST /free を呼び出すため、前のアプリの内容がVRAMに残ることはありません。
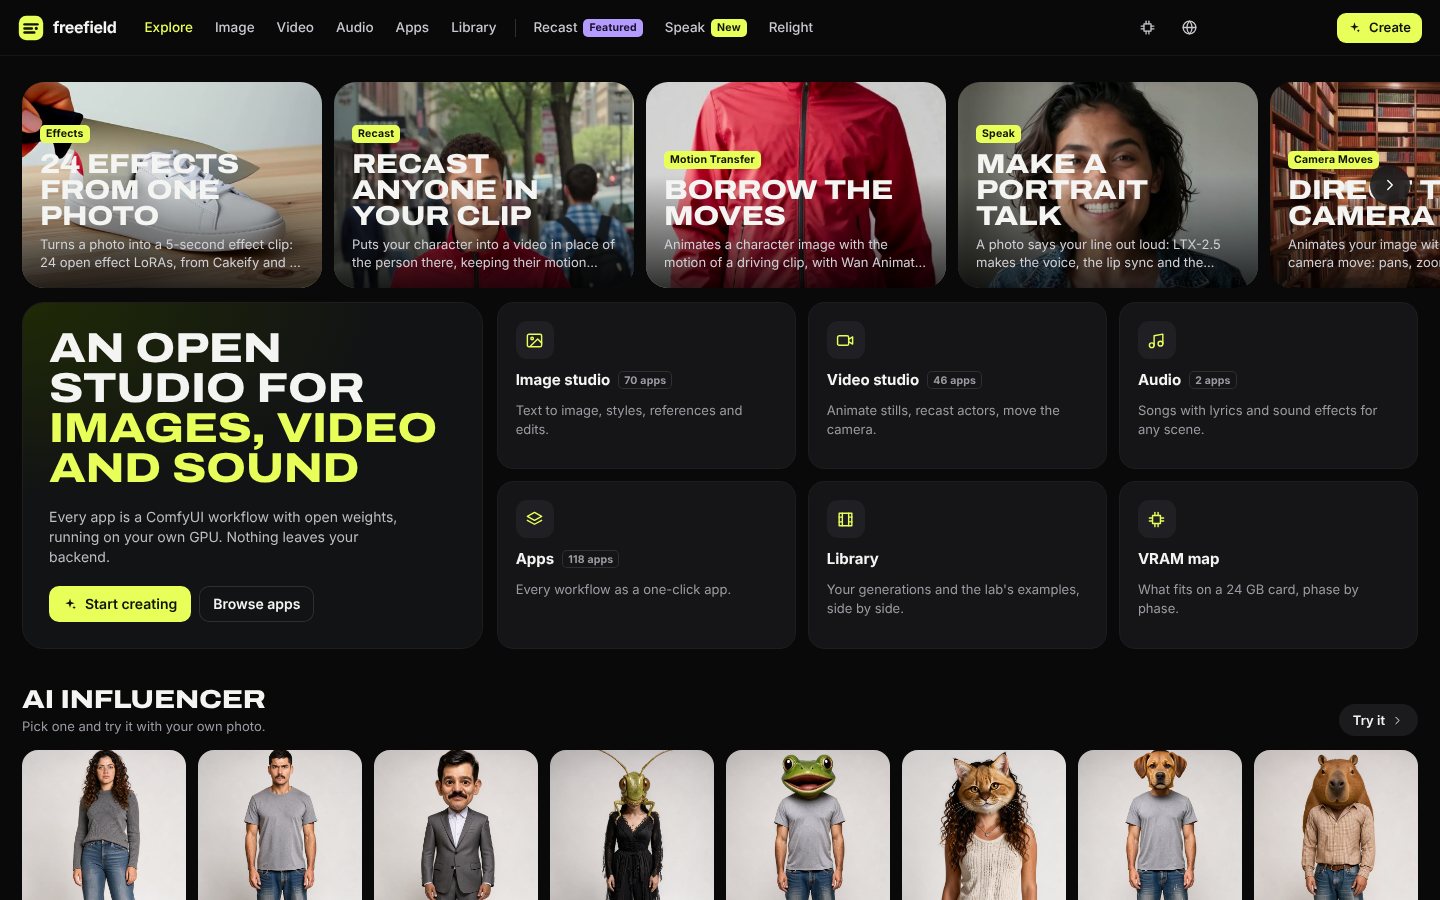
Exploreタブ。注目アプリは動画カードとして描画され、スタジオがカタログをメディア別に分けています。
各アプリを支えるオープンウェイト
Freefieldは意図的に厳格なルールを守っています。すべてのモデルはダウンロード可能なファイルであり、Hugging Faceのリポジトリ、サイズ、ライセンスとともにアプリのマニフェストに記載されます。LightricksのLTXサンプルにあるクラウドのテキストエンコーダー分岐は、そのために削除されています。ベースセットは次のとおりです。
- FLUX 3 Image Klein(int8): Create Imageと編集パイプライン向け。Black Forest Labsの9Bプロンプトアップサンプラーをトグルで切り替え可能
- Z-Image Turbo(int8): 高速な下書きとラボの参照写真向け
- MOSS-Image SFT(int8): レイアウトプロンプトの下書き用
- LTX-2.5: 独自の音声を伴う画像から動画への変換用。加えて5つのIC-LoRAアプリ(
genjutsu、reframe、sdr-hdr、mixed-media、dub) - MiniMax H3(int8): テキストや写真から音声付きクリップへの変換、および新しい角度からのクリップ再撮影用
- Qwen-Image-Edit-2509: Multiple Anglesとnext-sceneのLoRA付き。Wan 2.1 / 2.2: エフェクトLoRA付き
- SeedVR2、Stable Audio 3、MiniMax Music 3: アップスケーリングと音声用
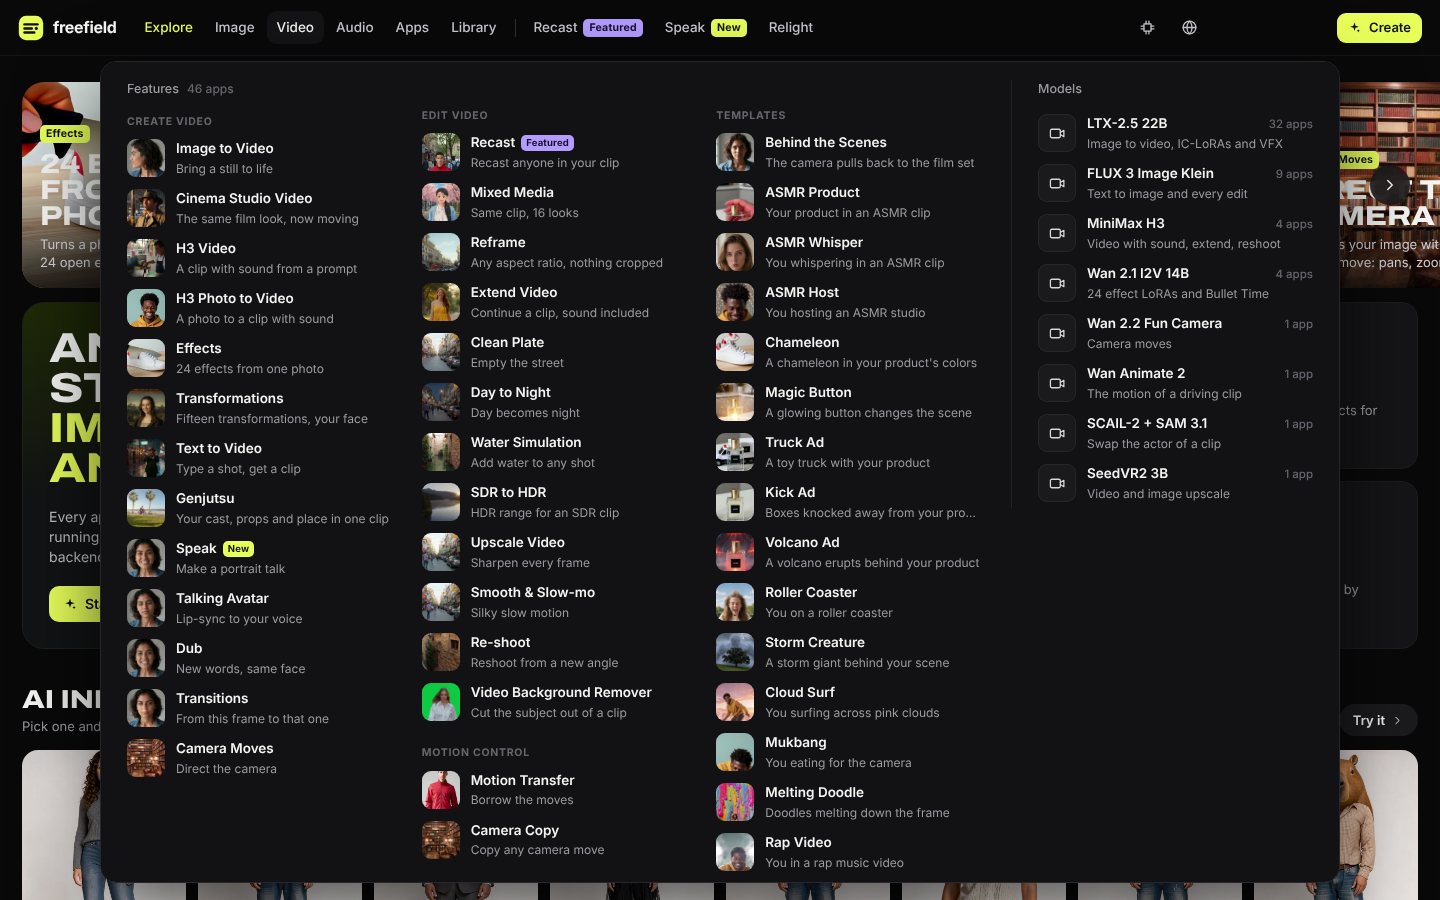
動画メニューには46個のアプリが並び、その横に各アプリが実行するオープンモデルが表示されます。
ワークフローは一次ソースから組み立てられています。ComfyUI自身のテンプレート、Lightricksの ComfyUI-LTXVideo サンプル、Comfy-Orgの comfy-reshoot などで、リポジトリは検証済みのバージョンをピン留めしています(ComfyUI e3bee7f、0.42.0ビルド、および ComfyUI-LTXVideo 44c8a36 と ComfyUI-CrossViewWarp fbb1e93)。HiggsfieldのSoul IDは写真から人物のモデルをトレーニングしますが、Freefieldはトレーニングを一切行いません。キャラクターアプリは毎回の実行で1枚または3枚の参照画像から人物をコピーし、ラボではL40Sで13.0秒かかります。実際のキャラクターLoRAに向けた TrainLoraNode の経路は将来的な課題として残されています。
ラボでの実行で測定されたこと
リポジトリには独自の計測ハーネスが含まれています。10月20日から26日の間にL40SとH100カードで48回の実行がModalに送られ、733ケースのうち710ケースがOKで返りました。ウェブアプリに表示されるすべての作例はこれらの実行の1つで、実時間とピークVRAMが添えられており、実行ごとのログは docs/lab-runs.md にあります。
プロジェクトが公開しているエンドツーエンドの数値は3つのブラウザ実行です。morph はボタン押下から動画まで160.8秒(うち128.7秒がGPU上)、mixed-media は149秒、dub はH100で72秒です。face-swap はホスト版デモでGPU時間25.2秒と測定されています。プロジェクトはVRAMマップも維持しています。create-image は17.8 GBで24 GBカードに完全に収まり、z-image は12.2 GBです。一方、cinema-video はピーク44.3 GBでModal実行が必要で、H3アプリはテキストエンコーダーだけで27.1 GBを必要とします。
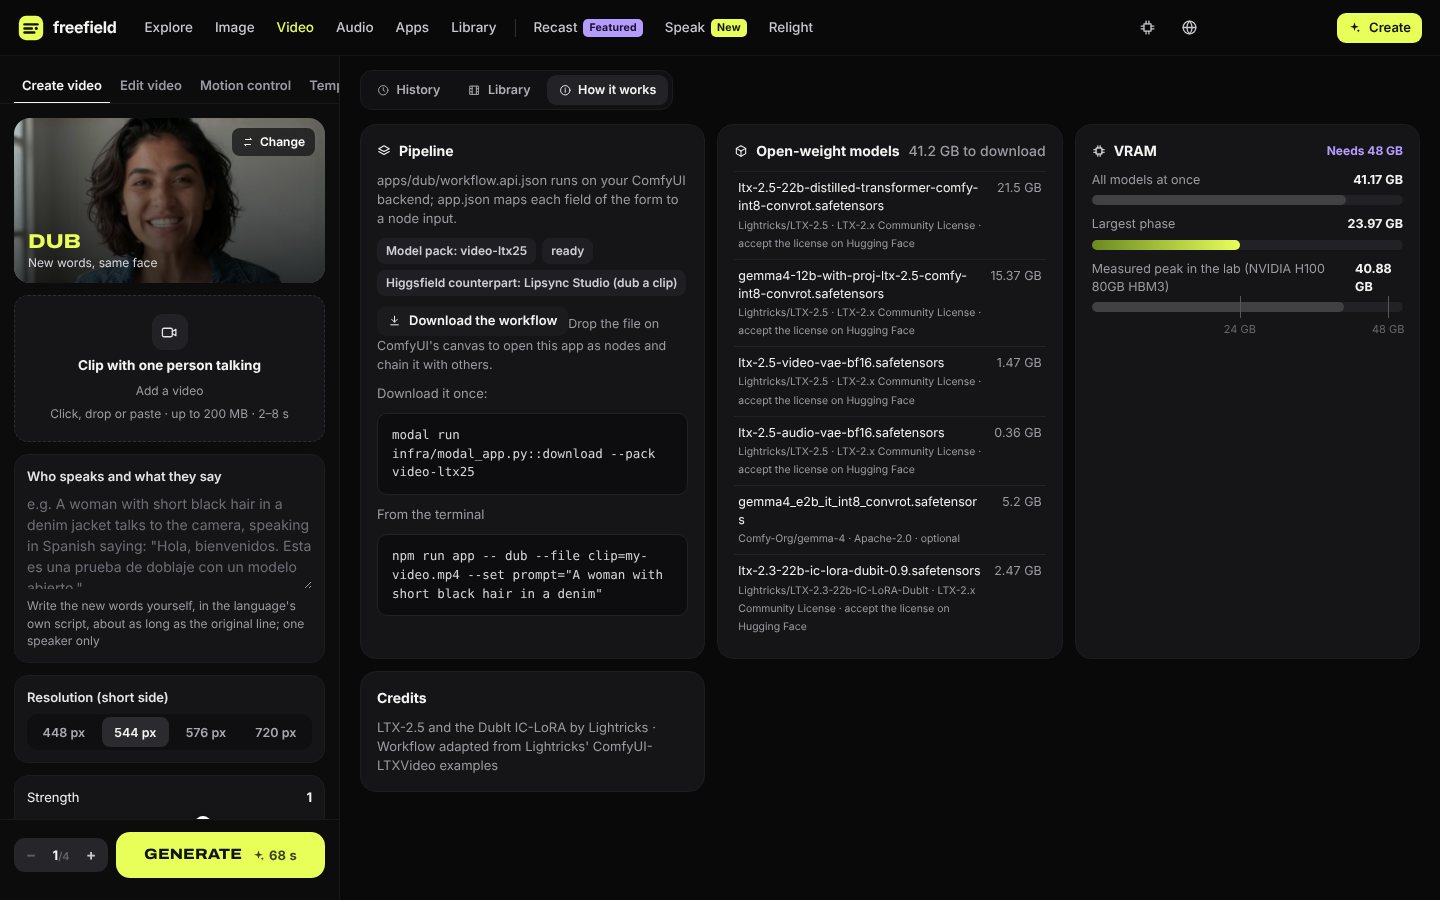
すべてのアプリには「How it works」タブがあり、モデル名、ライセンス、各フェーズに必要なVRAMが記載されています。
画像モデルの選定
Create Imageは10月24日までZ-Image Turboで動作していました。FLUX 3 Image Kleinへの切り替えは2つの材料から決まりました。1つは2026年10月のArtificial Analysisのテキストから画像へのアリーナで、Kleinが1043 Eloでオープンウェイトモデルをリードしています(Qwen-Image-2.1が1042、Fibo 2.0が1039、Z-Image Turboが936)。もう1つは、ラボが共通のシードで5つのモデルに対して行った6プロンプトの比較です。このテストでKleinは要素数を維持し(リンゴ3個、レモン5個)、Krea 2が空白のままにしたラベルを埋め、Kreaが見逃した真上からの視点を保ち、JSONプロンプトをシーンとして読解しました。一方Z-Imageは看板にキーを印刷してしまいました。
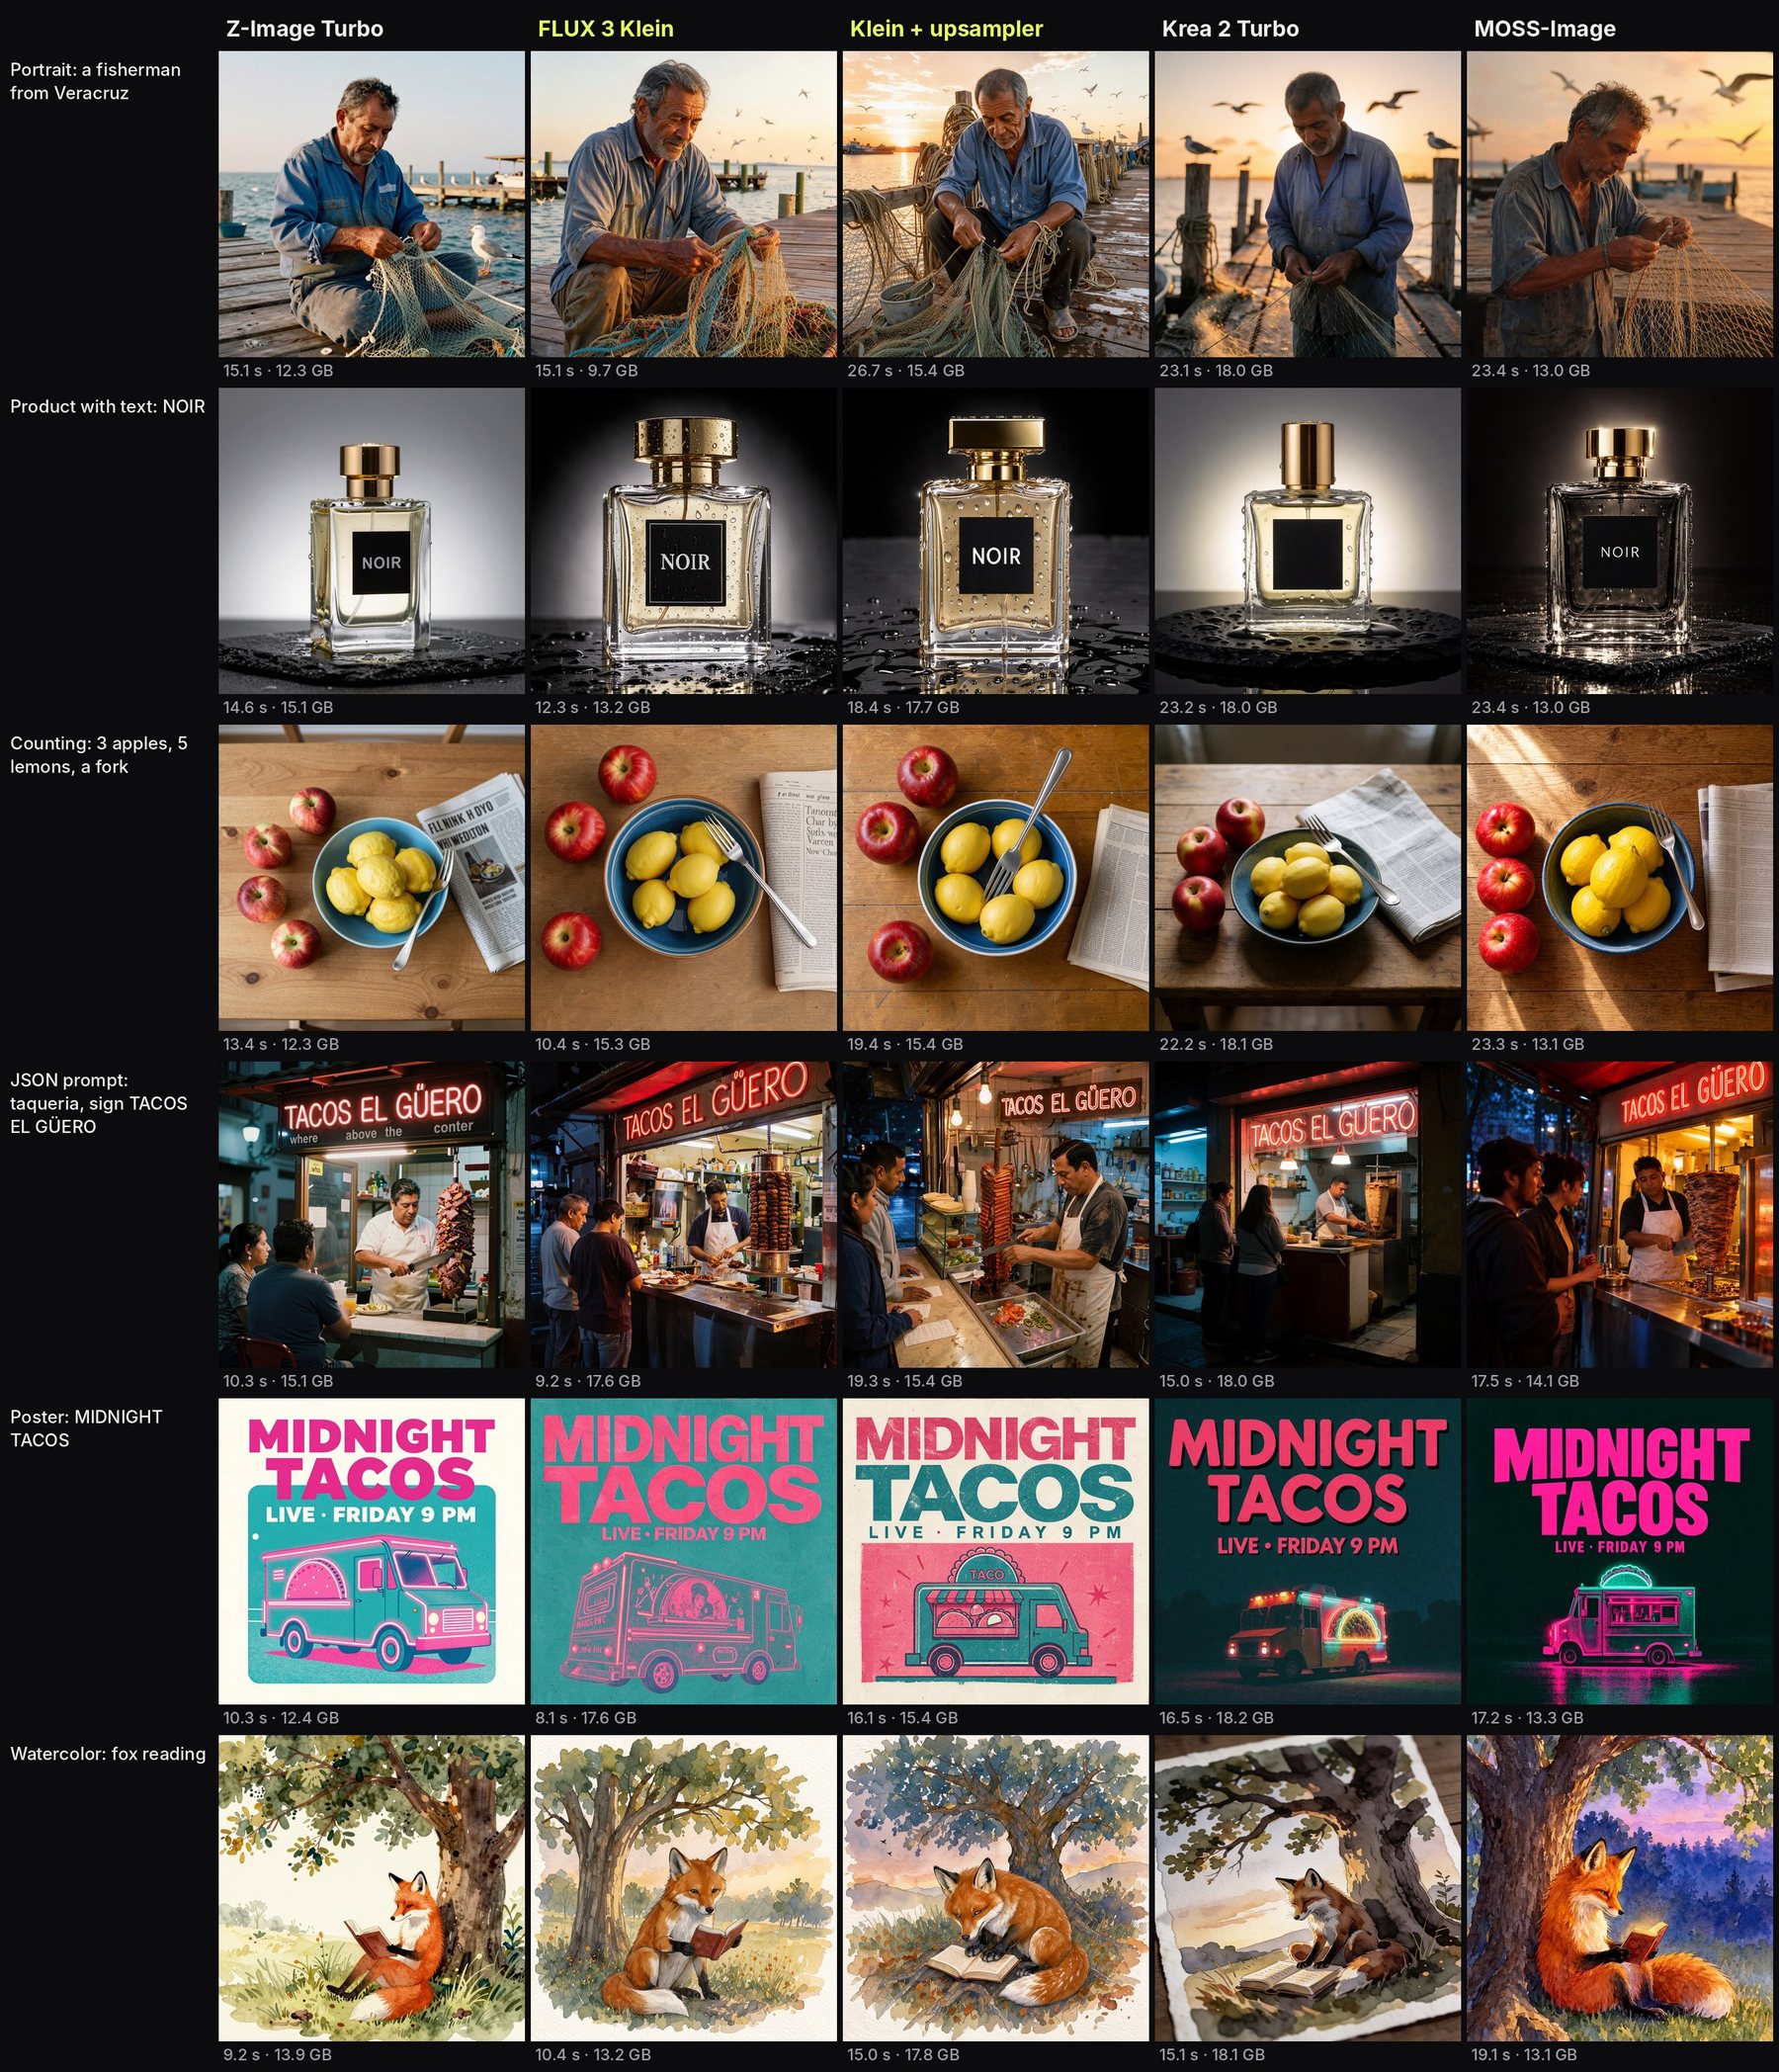
6プロンプトの比較。各結果の下にGPU秒数とピークVRAMを記載。
自分のワークフローを持ち込む
tools/import_workflow.py は、手持ちのComfyUIワークフローから新しいアプリの下書きを作成します。マニフェストを書き出し、ワークフローをフォルダーに配置すると、そのアプリは組み込みアプリと同じランナー、モデルのダウンロード、VRAM計算を引き継ぎます。テンプレートアプリは逆方向に働きます。72個のテンプレートアプリは既存パイプラインに対する固定プロンプトで、手書きではなくテーブルから tools/template_apps.py によって生成されます。
実行方法
FreefieldにはNode 22.6以上とPython 3.10以上が必要で、Modal上でも所有するGPU上でも動作します。ローカルで動かす場合は tools/local_backend.py setup を実行します。これはピン留めされたコミットのComfyUIを、ピン留めされたカスタムノード、comfy-api-proxy、そして手前のトークンゲートウェイとともにインストールします。続いて tools/local_backend.py download がアプリに必要なモデルパックを取得します。ダウンロードの前に、不足しているものとそのサイズを報告します。一部のモデルはHugging Faceでゲートされているため、HFトークンとライセンスへの同意が必須です。tools/doctor.py が起動前に両方をチェックします。
リポジトリにはまだタグ付きリリースがありません。2026年10月20日に作成され、112スターと26フォークを数え、最後のプッシュは10月27日です。
コメント
GitHubでサインインしてディスカッションに参加しましょう。