Qwen-Image 2.1を2ステップで: CFG 1で動くDMD2 LoRA
DMD2蒸留LoRAを使えば、Qwen-Image 2.1のテキストから画像への生成とマルチ参照編集をCFG 1で2ステップ実行できます。ライブSpaceデモとBanodocoのテスト報告もあわせて紹介します。
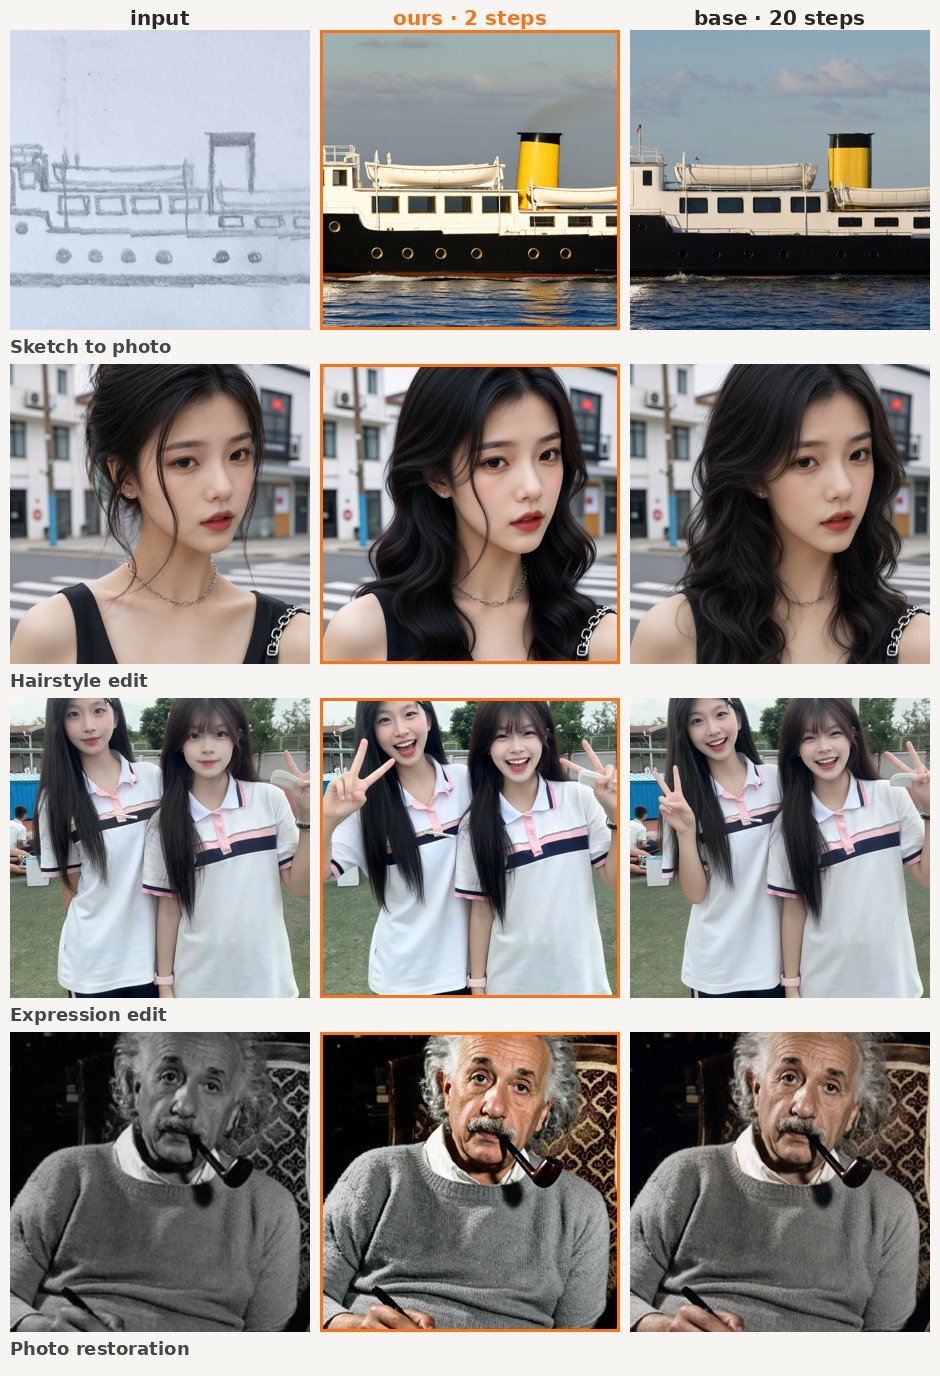
スケッチから写真、ヘアスタイル、表情、写真復元。入力・プロンプト・シードは共通です。各行は入力、LoRAの2ステップ、ベースモデルの20ステップの順に並んでいます。
2ステップが別格である理由
Qwen-Image 2.1は40ステップで提供されており、これまでに公開された高速化手法は8ステップ(Alibaba自身のTurbo checkpoint)と4ステップ(LightX2VのLightning LoRA)に到達しています。このアダプターはその範囲の下限を狙っており、スケジュールは推奨値ではなく固定値です:
| 設定 | 値 |
|---|---|
| ステップ数 | 2 |
| シグマスケジュール | [1.0, 0.5]、固定 |
| CFG | 1(true_cfg_scale=1.0) |
| LoRA rank / alpha | 32 / 32 |
| 適応モジュール | アテンションのみ: to_q、to_k、to_v、to_out.0 |
| ファイルサイズ | 64 MB(256 tensors) |
カードには、LoRAがまさにこのシグマのペアでトレーニングされたことが明記されているため、スケジューラーはuse_dynamic_shifting=Falseとshift=1.0でピン留めする必要があります。動的シフトを有効にしたままだと解像度ごとにシグマが再スケールされ、アダプターは蒸留時に通ったパスをサンプリングしなくなります。
アテンションのみを適応することも意図的な選択です。カードでは、フィードフォワードブロックも適応する場合よりも、編集中の入力画像を忠実に保持できると説明されています。このモデル向けの以前の数ステップアダプターは、まさにそのフィードフォワードブロックに予算の大半を費やしていました。
トレーニング方法
オンポリシー分布マッチングとteacherのCFGガイダンスを用いたDMD2(Distribution Matching Distillation)を採用しており、目的関数に回帰損失とGAN損失はありません。トレーニングは単一のH100上で、約1 MPのマルチアスペクトクロップに対して2,000ステップ実行されました。これはデモで使用されている解像度範囲と一致します。20ステップのteacherはカードが比較対象としている参照であり、モデルのデフォルトである40ステップではありません。
2ステップで維持されるもの
編集とマルチ参照の合成はどちらも機能し続けます。Qwen-Image 2.1は条件画像のリストを受け取り、プロンプトはそれらを位置で参照するため、2ステップ実行でも「Picture 1の猫をPicture 2のビーチに置く」といったプロンプトを、単一の参照に潰れることなく解決できます:
image = pipe(
    prompt="Place the cat from Picture 1 on the beach from Picture 2.",
    image=[cat, beach],
    num_inference_steps=2,
    sigmas=[1.0, 0.5],
    true_cfg_scale=1.0,
).images[0]テキストから画像への生成は、image引数を外した同じ呼び出しです。アルファチャンネルはアダプターではなくベースモデル由来のため、RGBA出力は変わりません。
作者のデモSpaceであるQwen Image 2.1 Realtimeは、同じスケジュールをライブインターフェースの背後に置いています。リアルタイムモードではプロンプトの変更に合わせて更新される512pxの結果がストリーミングされ、フル品質モードでは1024と1536に切り替わります。
コミュニティでの実行
Banodocoの#qwen-imageチャンネルでは、テスターがComfyUI内でネイティブのQwen-Image 2.1ノードの上にアダプターを載せて実行し、ステップ数の比較を投稿しました。RuneXは、Euler、ER-SDE、LCMの各サンプラーで2ステップのヘッドスワップが機能し、1ステップ追加するとわずかに良くなると報告しています。patientxは2、3、4ステップを連続して計測し、3ステップは「本物に非常に近い」、4ステップは使用可能、8ステップは劣化だと結論づけました。モデルの読み込みが支配的なため、合計実行時間は2ステップから4ステップの間でほとんど変わりませんでした。
ComfyUIにとっての唯一の引っかかりは命名です。safetensorsはdiffusers/PEFT形式、つまりtransformer.transformer_blocks.N.attn.to_q.lora.down.weightと対応する.lora.upテンソルで保存されていますが、ComfyUIのローダーはtransformer_blocks.Nから始まるモデル自身のパラメータ名をキーにします。ローダーがマッピングを行う前に先頭のtransformer.を削除する必要があり、そうしないとキーが未マッピングとして報告され、LoRAは何も作用しません。
入手方法
LoRAの重み: Hugging Faceのlinoyts/Qwen-Image-2.1-DMD2-2steps。ベースモデル: Qwen/Qwen-Image-2.1。デモ: Qwen Image 2.1 Realtime。
コメント
GitHubでサインインしてディスカッションに参加しましょう。