MiniMax H3 Gets a VBVR LoRA for Motion and Object Consistency
Licon VBVR is an image-to-video LoRA for MiniMax H3 trained on VBVR video reasoning data, aimed at object duplication, clipping and broken action order. Loads in ComfyUI.
Licon VBVR は、Licon Studioが10月23日に公開したMiniMax H3向けの画像から動画へのLoRAです(Hugging Face)。このアダプターはH3向けに再処理されたVBVRデータでトレーニングされており、1つのクリップで複数のオブジェクトを時間を通じて保持する必要があるときに現れる失敗パターン、すなわち同じオブジェクトが意図せず複製される、物体が小道具を突き抜ける、操作が誤った順序で行われる、といった問題を対象としています。
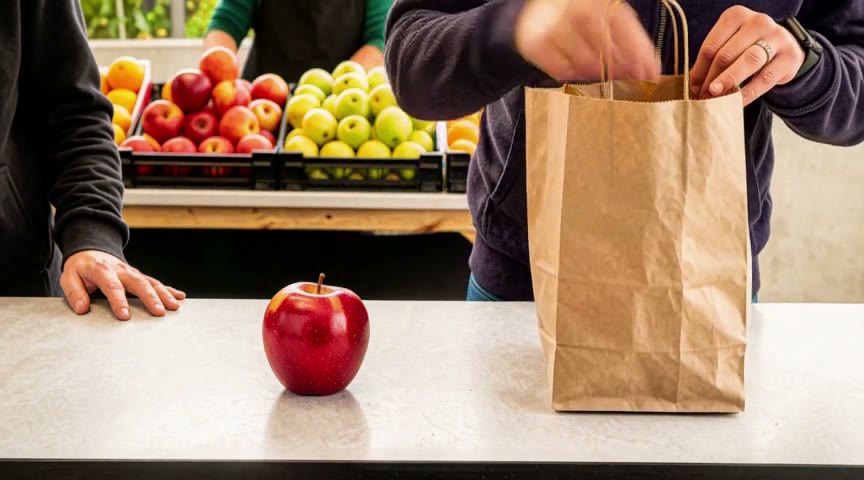
プロジェクト自身の検証クリップからのフレーム。ソース: Licon VBVR
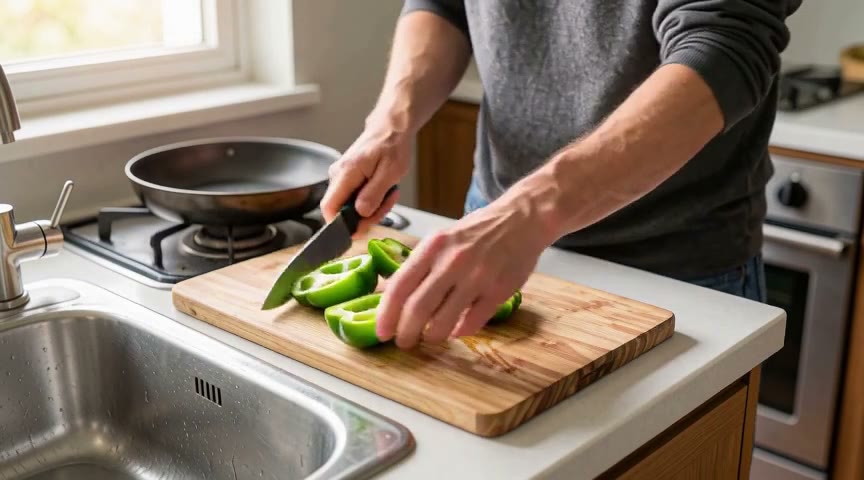
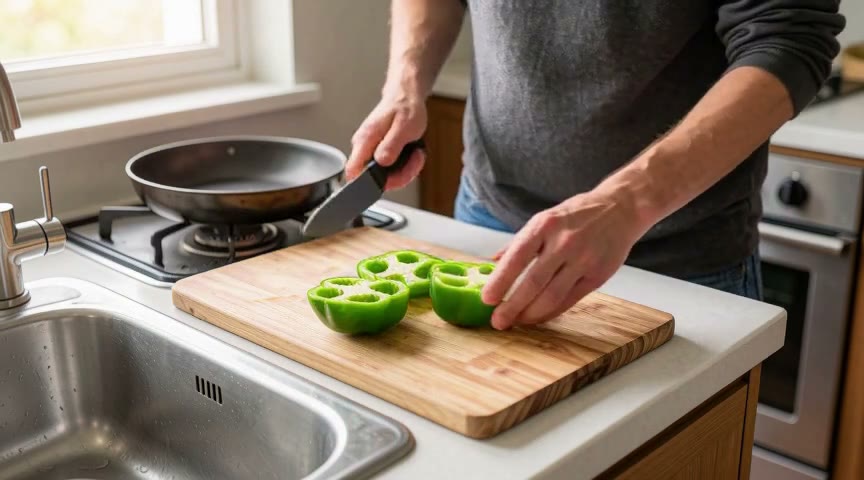
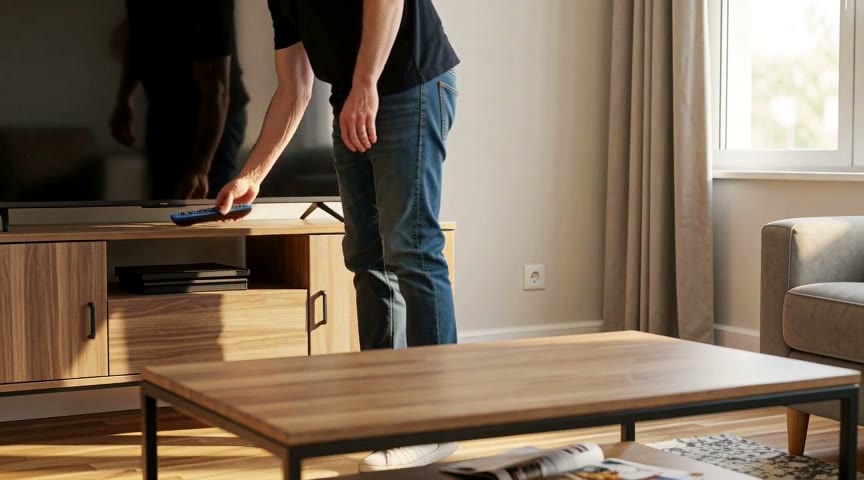
このリリースには6つの検証ケースが含まれ、それぞれに最初のフレームの入力、正確なプロンプト、そして同じシードでLoRAあり/なしを並べてレンダリングしたペアが付属しています。以下に示す2つは864x480、384フレーム、各12.25秒です。
 |  |
|---|---|
| キッチンシーン、ベースのH3 | キッチンシーン、H3 + VBVR |
 |  |
|---|---|
| リビングルームシーン、ベースのH3 | リビングルームシーン、H3 + VBVR |
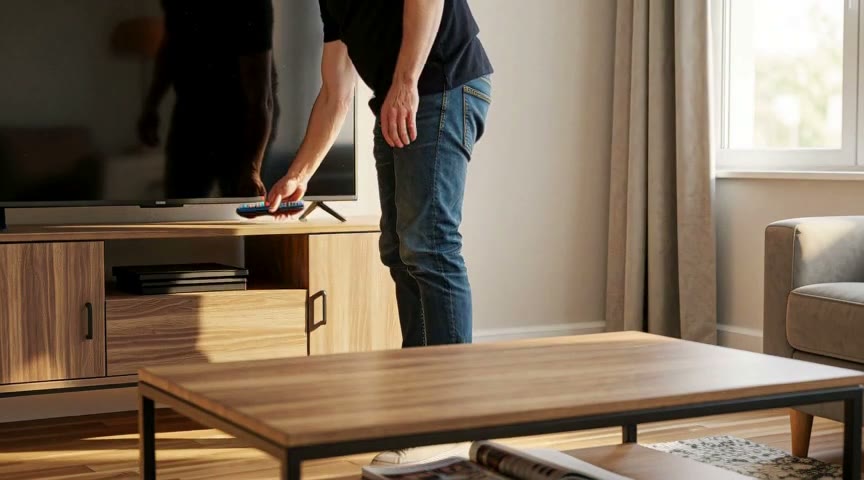
キッチンのケースでは、緑のピーマンを1つ洗って切り分け、鍋に移すという作業を、その過程を通じて同じ切り分けた片を保ったまま行うようモデルに求めています。リビングルームのケースでは、指定された順序で2つの移動を行います。まず雑誌を下の棚へ、次に青いリモコンをテレビの横へ運び、その他のオブジェクトはすべて元の位置に残します。どちらのプロンプトも操作を段階的に記述し、余計なオブジェクトを禁じており、これはまさにこのLoRAが実際に従うことを意図した種類の指示です。
キッチンのプロンプトに対するベースのMiniMax H3。
VBVR LoRAを読み込んだ状態での同じプロンプトとシード。
VBVRがこのLoRAに加えるもの
VBVR(A Very Big Video Reasoning Suite)は動画推論データセットの系列です。検証可能なタスクを中心に構成されたクリップ群で、たとえばオクルージョンを経てもオブジェクトを追跡する、規則に従ってオブジェクトを並べる、形状の系列を継続する、といったタスクがあり、プロンプトがそのタスクを正確に記述します。公開されているSFTスプリット(VBVR-Pro-SFT-Video)はそうしたクリップの大規模なセットで、トレーニングコードとベンチマークは別プロジェクトです。
作者は、別のモデルの形式でトレーニングするのではなく、H3自身のパイプラインに合わせてこのデータを再構築し、準備と前処理をH3のトレーニング方法に適応させました。LoRAのヘッダーには、1280x720で7,000ステップにわたる434,894件のトレーニング項目、rank 16、コサイン減衰付きの学習率5e-05が記録されており、各ブロックの4つのプロジェクションのみを対象としています: attn.qkv_proj、attn.out_proj、mlp.fc1、mlp.fc2。教師信号は動画のみで、音声の損失重みはゼロに設定されているため、このLoRAはH3がフレームとともに生成する音声ブランチには触れません。
アダプターは149 MBで、H3としては小さく、rank 16の構成と整合しています。トレーニングのメタデータにはベースcheckpointとしてminimax_h3_fl2va_bf16.safetensorsが記載されているため、T2VAではなくFL2VAのベースに適用するものです。
ComfyUIでの使い方
特別なインストールは不要です。H3-Licon-VBVR-I2V.safetensorsをComfyUI/models/loras/に置き、H3の画像から動画へのワークフローにあるLoraLoaderModelOnlyノードで選択します。
このファイルはkohya形式の命名(lora_unet_blocks_0_attn_qkv_proj.lora_up.weightなど)を使用しており、ComfyUI標準のLoRAローダーがH3のブロック名に直接マッピングするため、変換スクリプトやカスタムノードは不要です。プロジェクトはワークフローJSONを公開していません。既存のH3最初のフレーム用ワークフローであれば動作し、LoRAは通常のモデルパッチとして適用されます。
制限事項
比較は定性的なもので、作者によるものです。ベンチマークの表やLoRA強度に関するアブレーションはないため、低い強度でどの程度まで効果が保たれるかは文書化されていません。6つの検証クリップはすべて864x480のフォトリアルな屋内シーンで、操作対象のオブジェクトは1つか2つであり、トレーニングセットのタスク構成より狭い範囲です。他のH3 LoRAと同様、音声ブランチには手を加えていないため、サウンドはベースモデルが生成するものになります。
入手方法
このLoRAは、6つの検証ペアとそのプロンプトすべてとともにHugging Faceで公開されています。同じラボは以前にLTX-2.3 VBVR LoRAとComfyUI対応のWan 2.2 VBVRビルドを公開しており、今年の初めにはLicon MSR-v2で取り上げたMSR-v2マルチ被写体参照LoRAをリリースしました。
コメント
GitHubでサインインしてディスカッションに参加しましょう。