H3 Motionで被写体をキーフレーム指定しMiniMax H3にアニメートさせる
H3 MotionはComfyUIを操作するローカルアプリです。SAM 3.1で写真から被写体をクリックで選択し、キーフレーム化したパスに沿ってドラッグすると、MiniMax H3が音声付きでショットをレンダリングします。
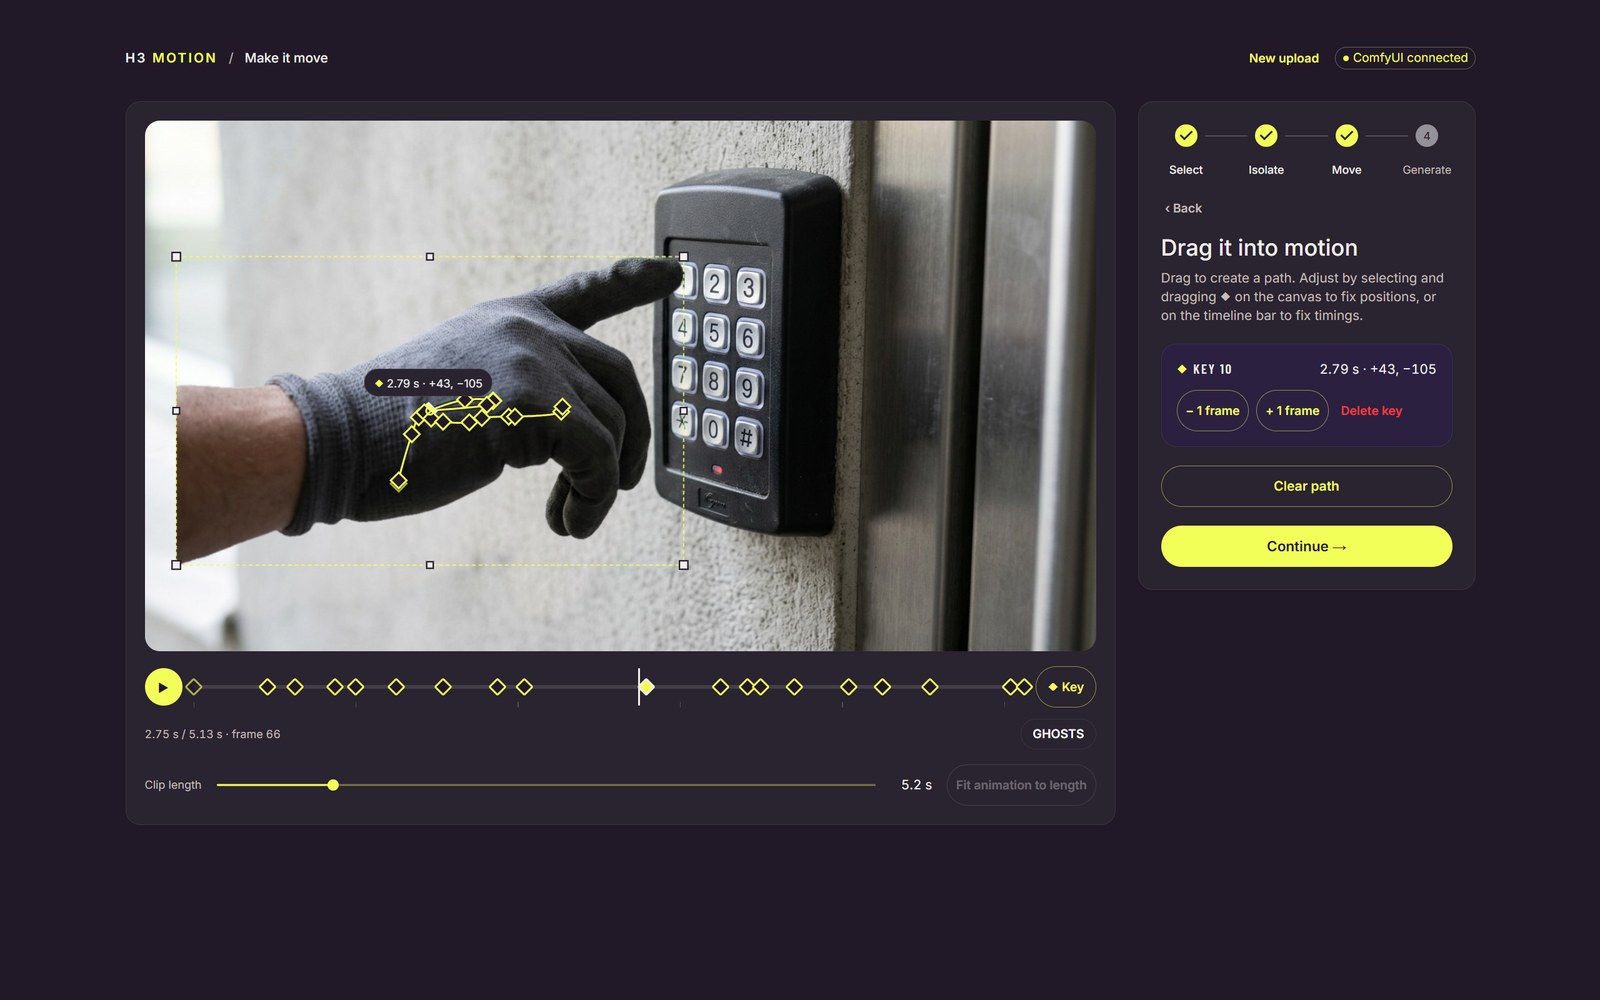
Moveフェーズ。選択済みの各被写体には独自の色付きパスとキーが割り当てられ、クリップ長はH3のフレームグリッドにスナップします。
これはH3 Motion Contextとは別物です。あちらのノードパックは完了したクリップをつないでカットをまたいでモーションを継続させますが、H3 Motionは1つのクリップを対象に、その中の被写体を動かします。
写真: 選択、切り抜き、パスのドラッグ
クリップ長は3.0〜15.1秒で、H3がサンプリングするグリッドである17フレーム刻みです。最初のフレームは常にオリジナルの写真です。パスは背景のやり直し後も保持されるため、分離に失敗しても被写体を描き直す必要はありません。
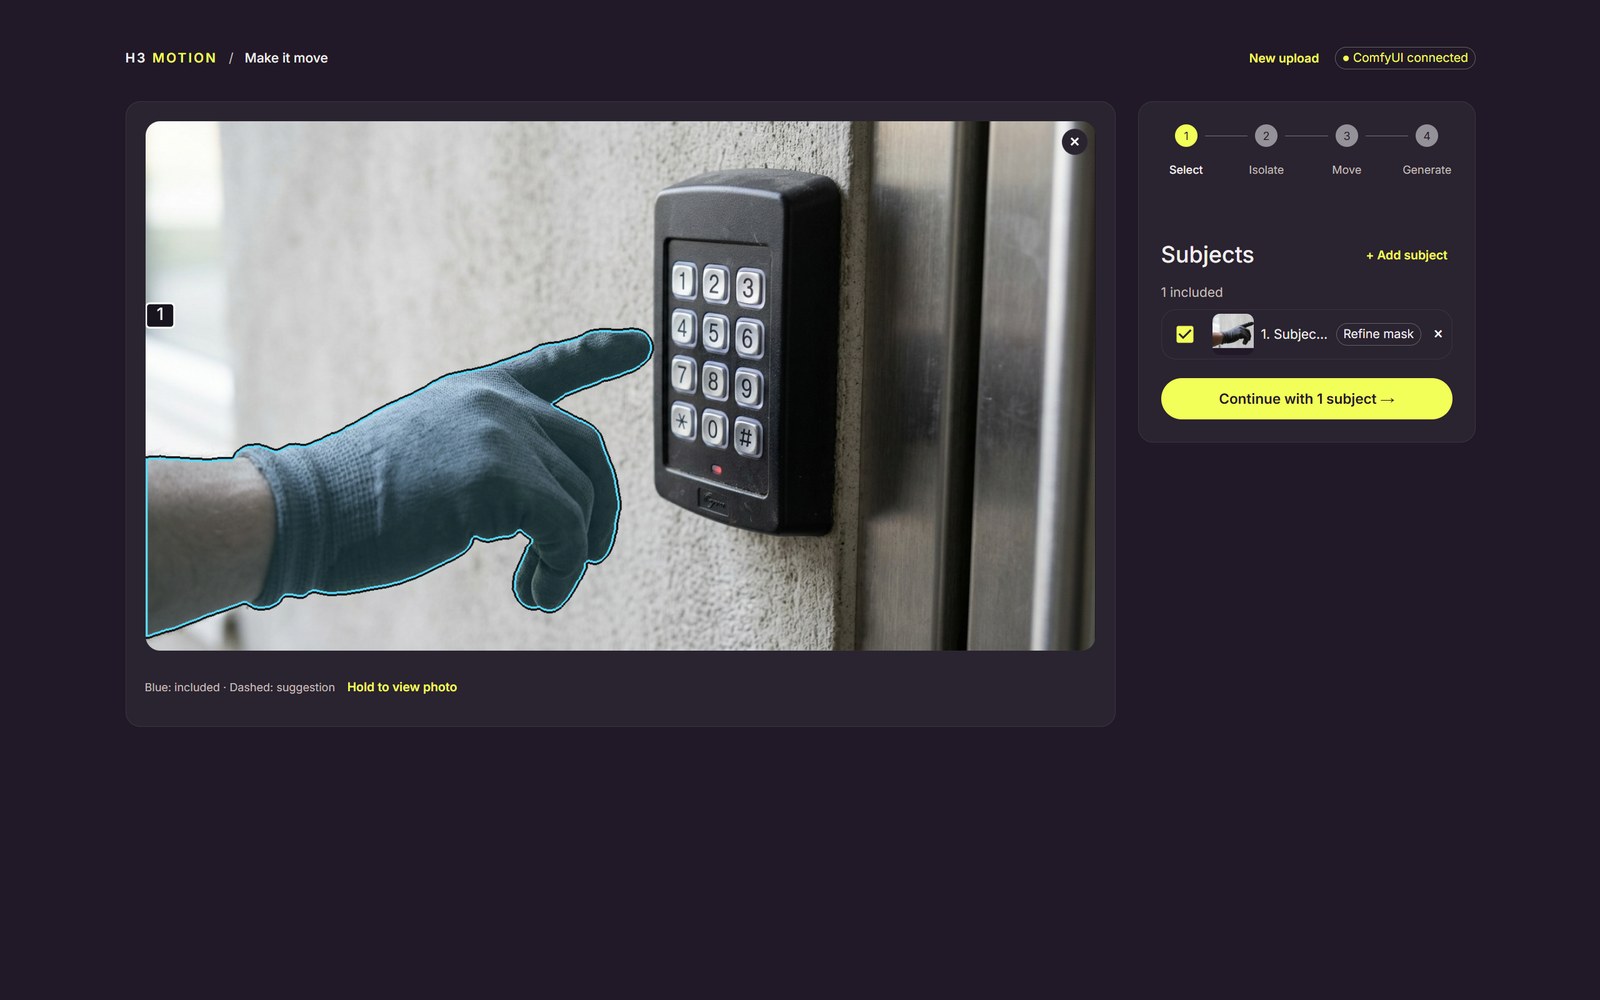
Selectフェーズ。プロンプトが候補を見つけ、ポイントが最終的なマスクを決定します。
動画: フレームではなくマスクをアニメート
クリップの一部に矩形または楕円を描きます。マスクは同じパスツールで手動アニメートするか、オブジェクトを追従させることができます。SAM 3.1が最初のフレームでセグメント化し、コアのSAM3_VideoTrackノードがそれを伝播します。面積や位置が大きく跳ぶフレームはアプリが却下します。表示させたい内容を説明し、必要に応じて参照画像を指定します。参照画像は説明から生成するか、マスク内の現在のフレームを編集して作成します。H3のref2vaモデルが1回のサンプリングパスでマスク領域を再生成し、アプリがフェザーエッジ付きで結果を合成して戻します。元の音声は保持、参照、または置き換えが可能です。
リポジトリのwebアセットに含まれるデモクリップ(1280×720、4秒)。
実行方法
アプリはソースのみの提供です。クローンしてnpm install、npm run devを実行し、http://127.0.0.1:5180を開きます。すでにポート8188で実行中のComfyUIに接続し、APIプロキシは自身で起動します。ComfyUIの起動やモデルのダウンロードは行いません。2つ目のターミナルでnpm run check-envを実行すると、すべてのノードとモデルファイルが揃っているか確認できます。
必要なものは、ComfyUI(READMEではv0.41.0-18でテスト済み)、vloTimeToMove、vloSAM3RefineMask、vloMaskToLatentMaskノード用のComfyUI-vlo 0.3.0以降、Node 22.12以降、そしてuvです。両方のH3ワークフローはComfy Kitchen INT8アテンションを使用するため、NVIDIAまたはAMDのGPUが必要です。READMEには11個のファイル(SAM 3.1、Qwen Image 2.1とそのQwen3-VLエンコーダおよびVAE、H3のfl2vaとref2va diffusionモデル、H3のテキストエンコーダと2つのVAE、さらにPika Flex LoRA)の正確なhf downloadコマンドが記載されています。
制限
- ネイティブWindowsは未テストで、テスト済みの経路はWSLです。ホスト型Comfy APIへのデプロイについても説明がありますが、こちらも未テストです。
- 写真と動画は1:4〜4:1の範囲である必要があります。4:1より横長のものは768pで出力できないためです。
- タグ付きリリースはまだなく、最後のコミットは11月3日です。
入手方法
- プロジェクト: github.com/PxTicks/h3-motion
- 使用手順:
docs/usage.md - パイプラインの解説:
docs/how-it-works.md - 必須ノードパック: ComfyUI-vlo
コメント
GitHubでサインインしてディスカッションに参加しましょう。