MiniMax H3 PTD LoRAでRef2VAを8ステップ・4ステップに短縮
Taobao Content AIのPTD per-hop LoRAがMiniMax H3 Ref2VAを8ステップまたは4ステップに短縮。RefAsymOPD版と検証済みのComfyUIノードも提供します。
taobao-content-ai アカウントは MiniMax H3 向けの Ref2VA 高速化 LoRA を2種類公開しました。per-hop 構成の PTD ペア(MiniMax-H3-Ref2VA-PTD-8Step / -4Step)が2026年10月20日に登場し、PTD + RefAsymOPD で学習した3つ目のチェックポイントが10月22日に続いています。執筆時点で PTD リポジトリは約33いいね、480ダウンロードです。
PTD は Parametric Trajectory Distillation(パラメトリック軌道蒸留)の略で、EPFL、NVIDIA、Stanford の Lan Feng 氏らによる論文 arXiv 2610.11498 として公開されています。対応するプロジェクトページの映像はすべて MiniMax H3 上で生成されたものです。この論文は、50ステップでサンプリングされる33Bの音声映像ジョイントモデルを、LoRAと軌道の教師信号だけで4ステップまたは6ステップの生徒モデルに蒸留します。
今回の2つのリポジトリが加えるのは、その話のうち Ref2VA 側です。参照画像を入力し、動画と音声を出力するもので、トランスフォーマーの評価回数は8回または4回となります。
アダプターの仕組み
チームが以前公開した PDD(MiniMax-H3-Acc-LoRAs)は、ベースモデルの単一の出力ヘッドを、区間ごとのヘッド群に置き換えました。PTD はそのヘッド群を維持したまま、推論ステップごとに1つの独立した低ランクアダプターを学習します。拡散バックボーン上の「per-hop」LoRA であり、各ホップが自身のアダプターを選択して自身のヘッドを融合します。そのため8ホップのチェックポイントは8回のトランスフォーマー評価で、4ホップのチェックポイントは4回で動作します。
各チェックポイントは safetensors のメタデータに自身の設定を持っています(ptd_num_hops、pdd_num_steps=32、pdd_block_size、lora_rank、lora_alpha、lora_targets)。付属の apply_ptd_lora はこのメタデータを読み取り、ステップ数を独自に導出します。ComfyUI ノードにステップ用のスライダーが存在しないのはこのためで、シグマのグリッドはチェックポイントの属性なのです。
| ファイル | ステップ | サイズ | 備考 |
|---|---|---|---|
MiniMax-H3-Ref2VA-PTD-8Step.safetensors | 8 | 11.1 GB | per-hop LoRA、8ホップ、rank 128、BF16 |
MiniMax-H3-Ref2VA-PTD-4Step.safetensors | 4 | 5.58 GB | per-hop LoRA、4ホップ、rank 128、BF16 |
MiniMax-H3-Ref2VA-PTD-RefAsymOPD-8Step.safetensors | 8 | 11.1 GB | 同じ構成で、PTD と RefAsymOPD を併用して学習 |
デモでわかること
PTD のカードは、MiniMax-H3-Turbo のサンプルから3つのケース(プールサイドの格闘、倉庫での対峙、モニターから飛び出すバイク)を再利用し、ベースの Ref2VA モデル、4ステップの Turbo LoRA、8ステップの PDD と並べて比較しています。参照画像、プロンプト、predict_ref2v.py スクリプトがリポジトリに含まれているため、各列を再現できます。
RefAsymOPD のカードはさらに進んで、768×1344、124フレーム、24 fps、音声付きの新しい5つのケースを公開しています。各行では、品質の上限としての40ステップのベース、8ステップの PDD、8ホップの通常 PTD、8ホップの RefAsymOPD を比較しています。そこに添えられている主張は限定的なものです。同じステップ数で通常の PTD より背景の妥当性、シャープさ、リアリズムが向上し、しかも追加コストはありません。チェックポイントが通常の PTD LoRA と構造的に同一で、コードを変更せずに差し替えられるからです。
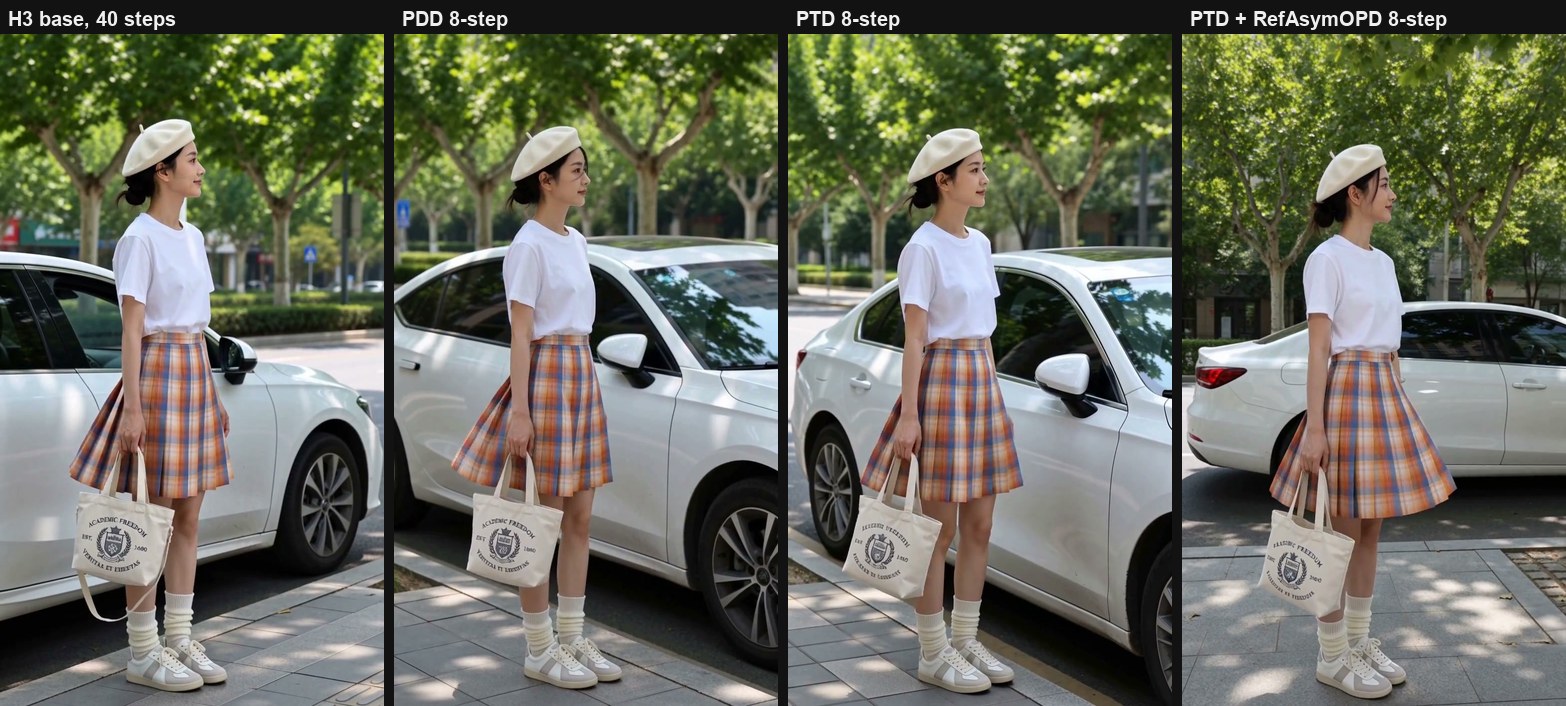
デモケース sample-0 の4列それぞれから、クリップの同じ時点で切り出した1フレーム。40ステップのベース、PDD 8ステップ、PTD 8ステップ、PTD + RefAsymOPD 8ステップ。
sample-0 の RefAsymOPD 8ステップのクリップ全体と、生成された音声。カバー画像は別のケース(sample-2)の2パネルフレームです。
ComfyUI での実行
両方のリポジトリは同じカスタムノードパック comfyui_node/ComfyUI-MiniMaxH3-PTD/ を同梱しています。これは PTD サンプリング自体を再実装したものではなく、上流の ComfyUI-PTD ノードのフック機構を再利用し、ローダー、ホップのグリッド、出力ヘッドのみを置き換えています。このような分離になっているのは、上流が4ホップと6ホップのチェックポイントを受け付け、ベースの出力ヘッドに対する per-hop の差分を前提としているのに対し、これらのアダプターは4ホップと8ホップで、PDD の区間ごとのヘッド群の上で学習されているためです。
パックのドキュメントに沿ったセットアップ手順は次のとおりです。
- 上流の
ComfyUI-PTD(ブランチrelease/comfyui-inference)をcustom_nodes/にインストールし、さらにpip install -eを実行します。そのptd_comfyモジュールは隣接するptdパッケージをインポートするため、単なるクローンではインポート時に失敗します。 - リポジトリから
ComfyUI-MiniMaxH3-PTDをcustom_nodes/にコピーします。 - アダプターのチェックポイントを
ComfyUI/models/ptd/に配置します。 - ベースは自分で変換します。これらのアダプターには MiniMaxAI/MiniMax-H3 のオリジナルでプルーニングされていない
transformer_ref/が必要で、scripts/convert_comfy_base.pyで変換します。プルーニング済み、Turbo、PDD、量子化済みのベースは明示的に無効です。 - ComfyUI を
--disable-dynamic-vram付きで起動します。
テキストエンコーダー(qwen3vl_32b_minimax_h3_bf16)と映像・音声の VAE は Comfy-Org/MiniMax-H3 から取得します。ベースを含めると、重み一式はおよそ140 GBになります。
グラフは短いものです。拡散モデルを読み込む、MiniMax-H3 PTD アダプターを読み込む、PTD サンプラーと PTD シグマのノードをカスタムサンプラー(高度)に接続する、MiniMax H3 リファレンスから動画へで条件付けする、最後に AV の潜在を分離して動画と音声をデコードする、という流れです。API 形式のサンプルワークフローがリリースごとに1つリポジトリに含まれていますが、README では参照画像をまず asset/ から ComfyUI/input/ にコピーする必要があると警告しています。
作者によれば、両方の PTD チェックポイントについて ComfyUI の HTTP キュー経由のエンドツーエンド検証が行われています。チェックポイントのノットでちょうど8回と4回のトランスフォーマー評価、1344×768、243フレーム、24 fps、32 kHz ステレオ音声で、シーン、同一性、音声構造が Diffusers スクリプトと一致しています。同じシードでも Diffusers の出力がビット単位で再現されるわけではありません。2つのフロントエンドでは初期ノイズの生成方法が異なるためです。検証に使われた構成は ComfyUI 5cc4b87、ComfyUI-PTD 43ae22c、PyTorch 2.13.0+cu130 で、単一の H20-3e 上での実行です。
コミュニティによる回避策
アダプターがプルーニングされていない140 GBのベースを必要とするため、コミュニティの最初の反応はより小さな環境に収めることでした。PTD の公開から1日後、コンパクトなローダー(ComfyUI-PTD-Compact、10月22日作成)がプルーニング済みおよび量子化済みのベースへの対応を追加し、あわせて4ステップアダプターの int8 版も提供しました。Banodoco のユーザーはそうした変換から得た最初の静止画やクリップを投稿しています。その作者の GPU では、8ステップの int8 ビルドは 4 MP で1枚あたりおよそ14秒で動作します。
入手方法
両方のアダプターセットは Hugging Face で公開されています。8ステップと4ステップのペアは MiniMax-H3-PTD-LoRAs、RefAsymOPD 版は MiniMax-H3-PTD-RefAsymOPD-LoRAs です。ComfyUI 以外での推論は、diffusers >= 0.40.0 と ref2va ワークフローを用いた MiniMax-H3 の Diffusers モジュラーパイプラインで実行します。
コメント
GitHubでサインインしてディスカッションに参加しましょう。