Hy-Nomas: Tencent Hunyuanのインタラクティブワールドモデル
Tencent HunyuanがHy-Nomasを公開しました。テキストとカメラ制御の下で720p動画を生成する8ステップのインタラクティブワールドモデルで、ComfyUIへの移植版もすでに登場しています。
Hy-NomasはTencent Hunyuanのインタラクティブワールドモデルです。世界を記述すると、モデルが生成を続ける間、テキスト指示とカメラの動きで操作し続けられます。チームは2026年10月21日に重み、推論コード、トレーニングおよびデータアノテーションのコードを公開し(tencent/Hy-Nomas | GitHub)、オンラインデモと専用のベンチマークも公開しました。ComfyUI向けのコミュニティ移植版はその翌日に登場しています。
このリリースはまだカウンター上では若いままです。執筆時点でHugging Faceでは21件のいいね、GitHubでは21個のスターを獲得しています。以下の内容はすべてモデルカード、リポジトリ、公式ギャラリーから得たもので、第三者のテストによるものではありません。
ひとつの世界をセグメント単位で生成
Hy-Nomasはフレーム単位ではなく動画セグメント単位で自己回帰します。各セグメントは、それ以前に生成されたすべてのセグメントのkey/valueキャッシュにアテンションしながら、モデルの圧縮潜在空間内でガウスノイズからデノイズされます。現在のターンのプロンプト、カメラ軌道、そしてそのキャッシュだけが入力であり、アテンションはセグメント間で因果的であるため、あるセグメントの生成に未来のセグメントは必要ありません。
蒸留構成はEuler ODEソルバーで8回のデノイズステップをテキストとカメラのガイダンス1.0で実行し、720 × 1280を24 FPSで出力します。セグメント長はプロンプトファイルから決まります。JSONリクエストには、開始・終了タイムスタンプを持つsegments、冒頭用のvisual_description_long、以降の各ターン用のdescription_change、そして独自のタイムスタンプを持つcontained_actionsが並びます。inference.video_length=eventを設定すると、これらのイベント時刻からセグメント長が導出されます。
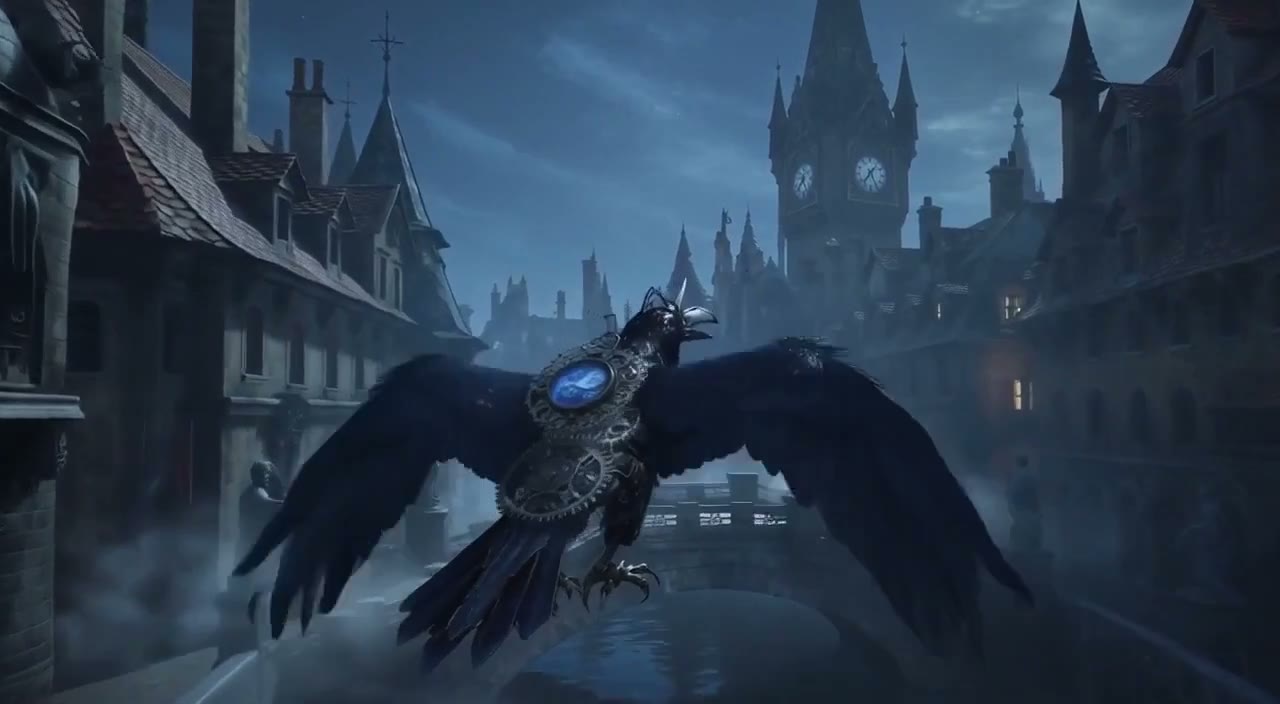
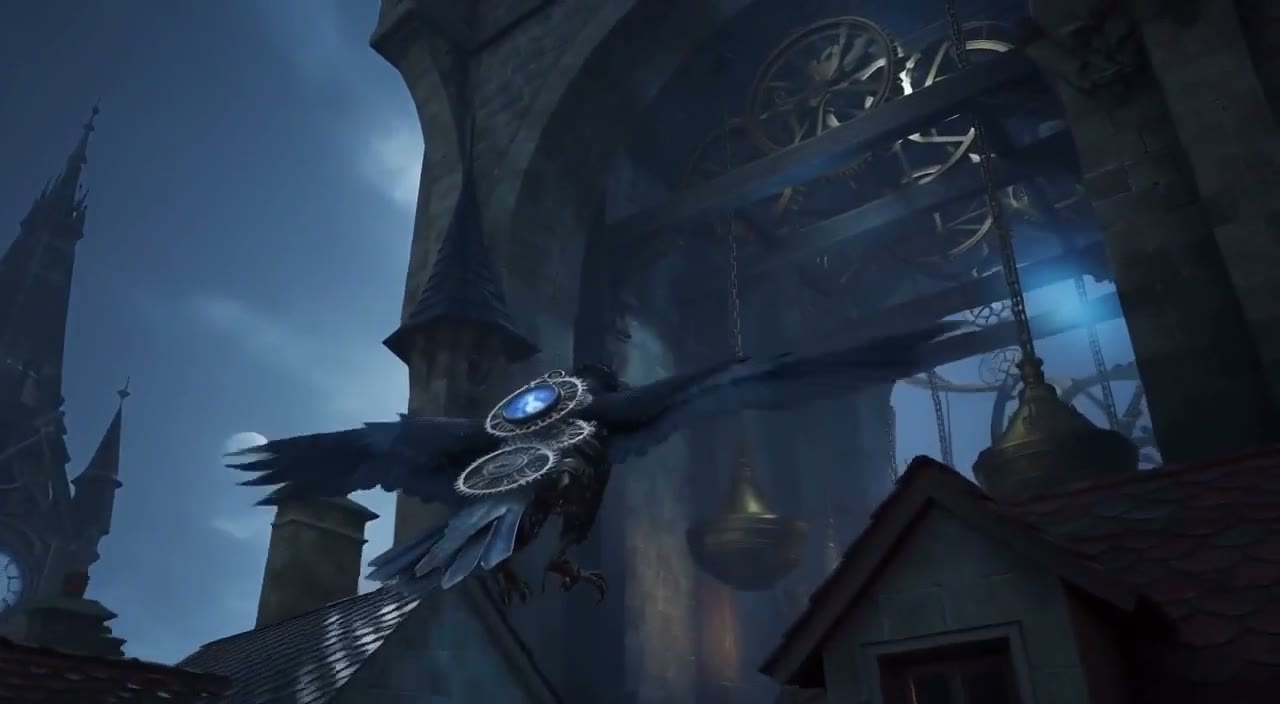
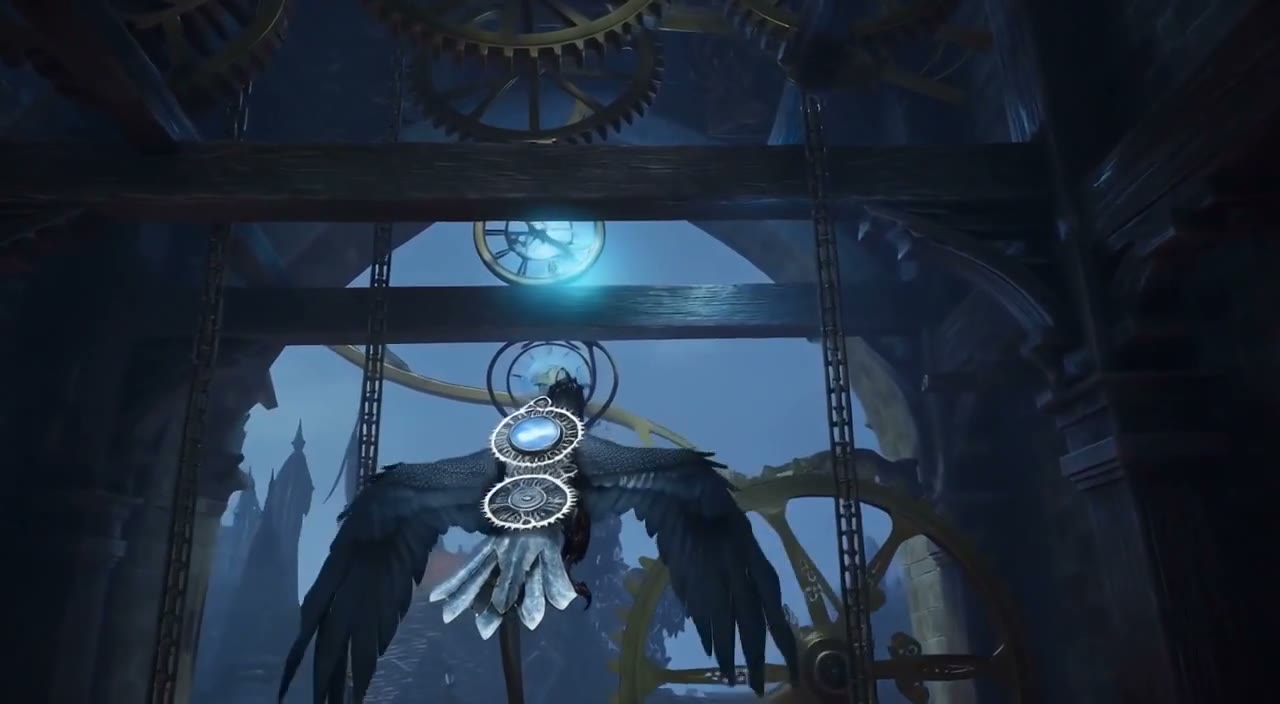
公式ギャラリーでは、より長い実行でそれがどう振る舞うかが示されています。これはclockwork-flightという1本の60秒クリップで、それぞれ12秒のテキストのみの5ターンから構成され、CGスタイルの三人称フォローカメラを使用しています。
 |  |  |
|---|---|---|
| 1秒: 「機械の鳥が屋根の上を飛び、前方には高い尖塔がそびえる。」 | 30秒: 「鳥はアーチを曲がり、塔の内部にある歯車と構造物へ向かう。」 | 48秒: 「鳥は頭上の歯車と塔の中の青い光の下を進む。」 |
同じクリップのうち、鳥が時計塔に入るターンからの6秒の抜粋。Tencent Hunyuanによる生成で、公式ギャラリーからキャプチャしたもの。
第一級の入力としてのカメラ制御
カメラの動きはプロンプトによる示唆ではなく、独立した条件付けパスです。軌道ファイルには形状[N, 4, 4]のcamera-to-world行列c2wsと形状[N, 3, 3]の内部パラメータが格納され、モデルは外部パラメータを正規化し、4動画フレームごとにグループ化して各グループを64次元の入力に平坦化します。ビデオトークンはそれを、すべてのデュアルストリームブロック内でクロスアテンション経由でクエリします。スケールは2つ公開されています。trajectory_translation_scaleのデフォルトは1.0、trajectory_rotation_scaleは2.5です。
テキストとカメラは1回の実行内で交互に切り替えることもできます。ギャラリーはサンプルをスタイル(実写映像、CG、ビデオゲーム、アニメーション、アニメ)とパースペクティブ(一人称、三人称フォロー、三人称オブザーバー)で分類しており、デモではWASDと矢印キーを押すかマウスをドラッグして生成された世界を移動でき、その移動は24 FPSで記録され次のターンで再生されます。
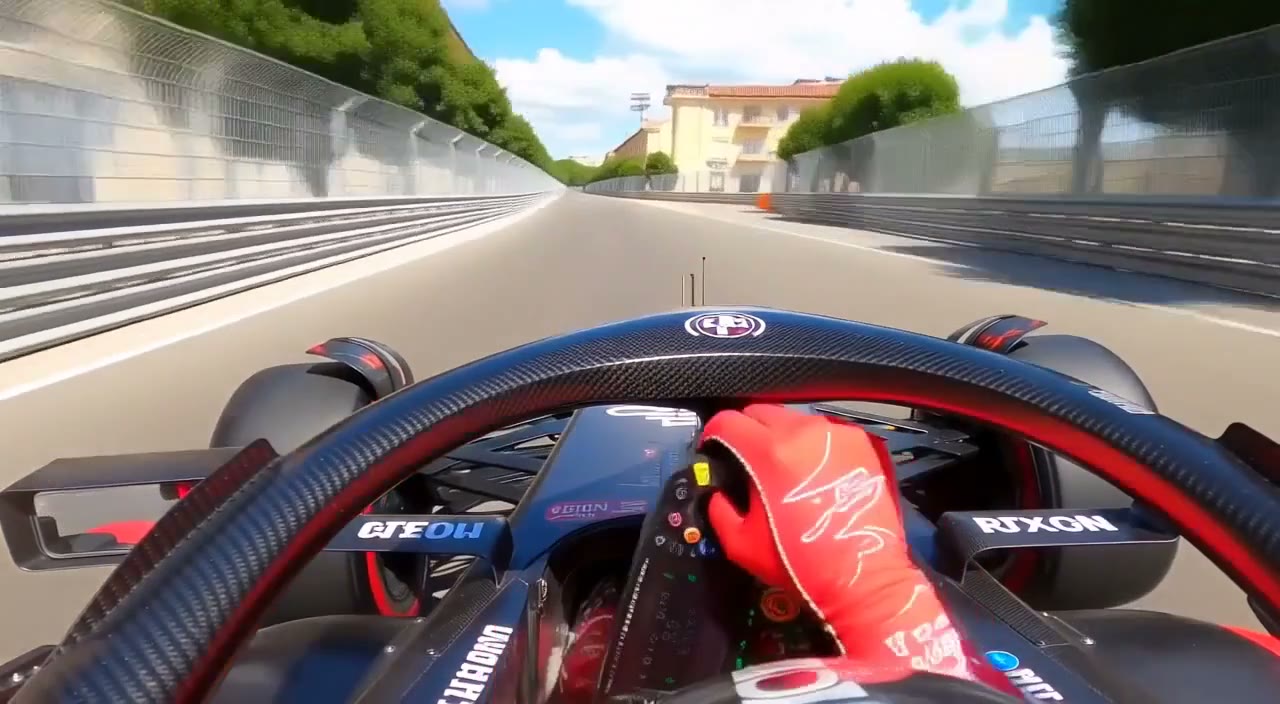
ギャラリーの一人称サンプルcircuit-drive。レーシングコックピット内から見た市街地コース。Tencent Hunyuanによる生成。
モデルの内部
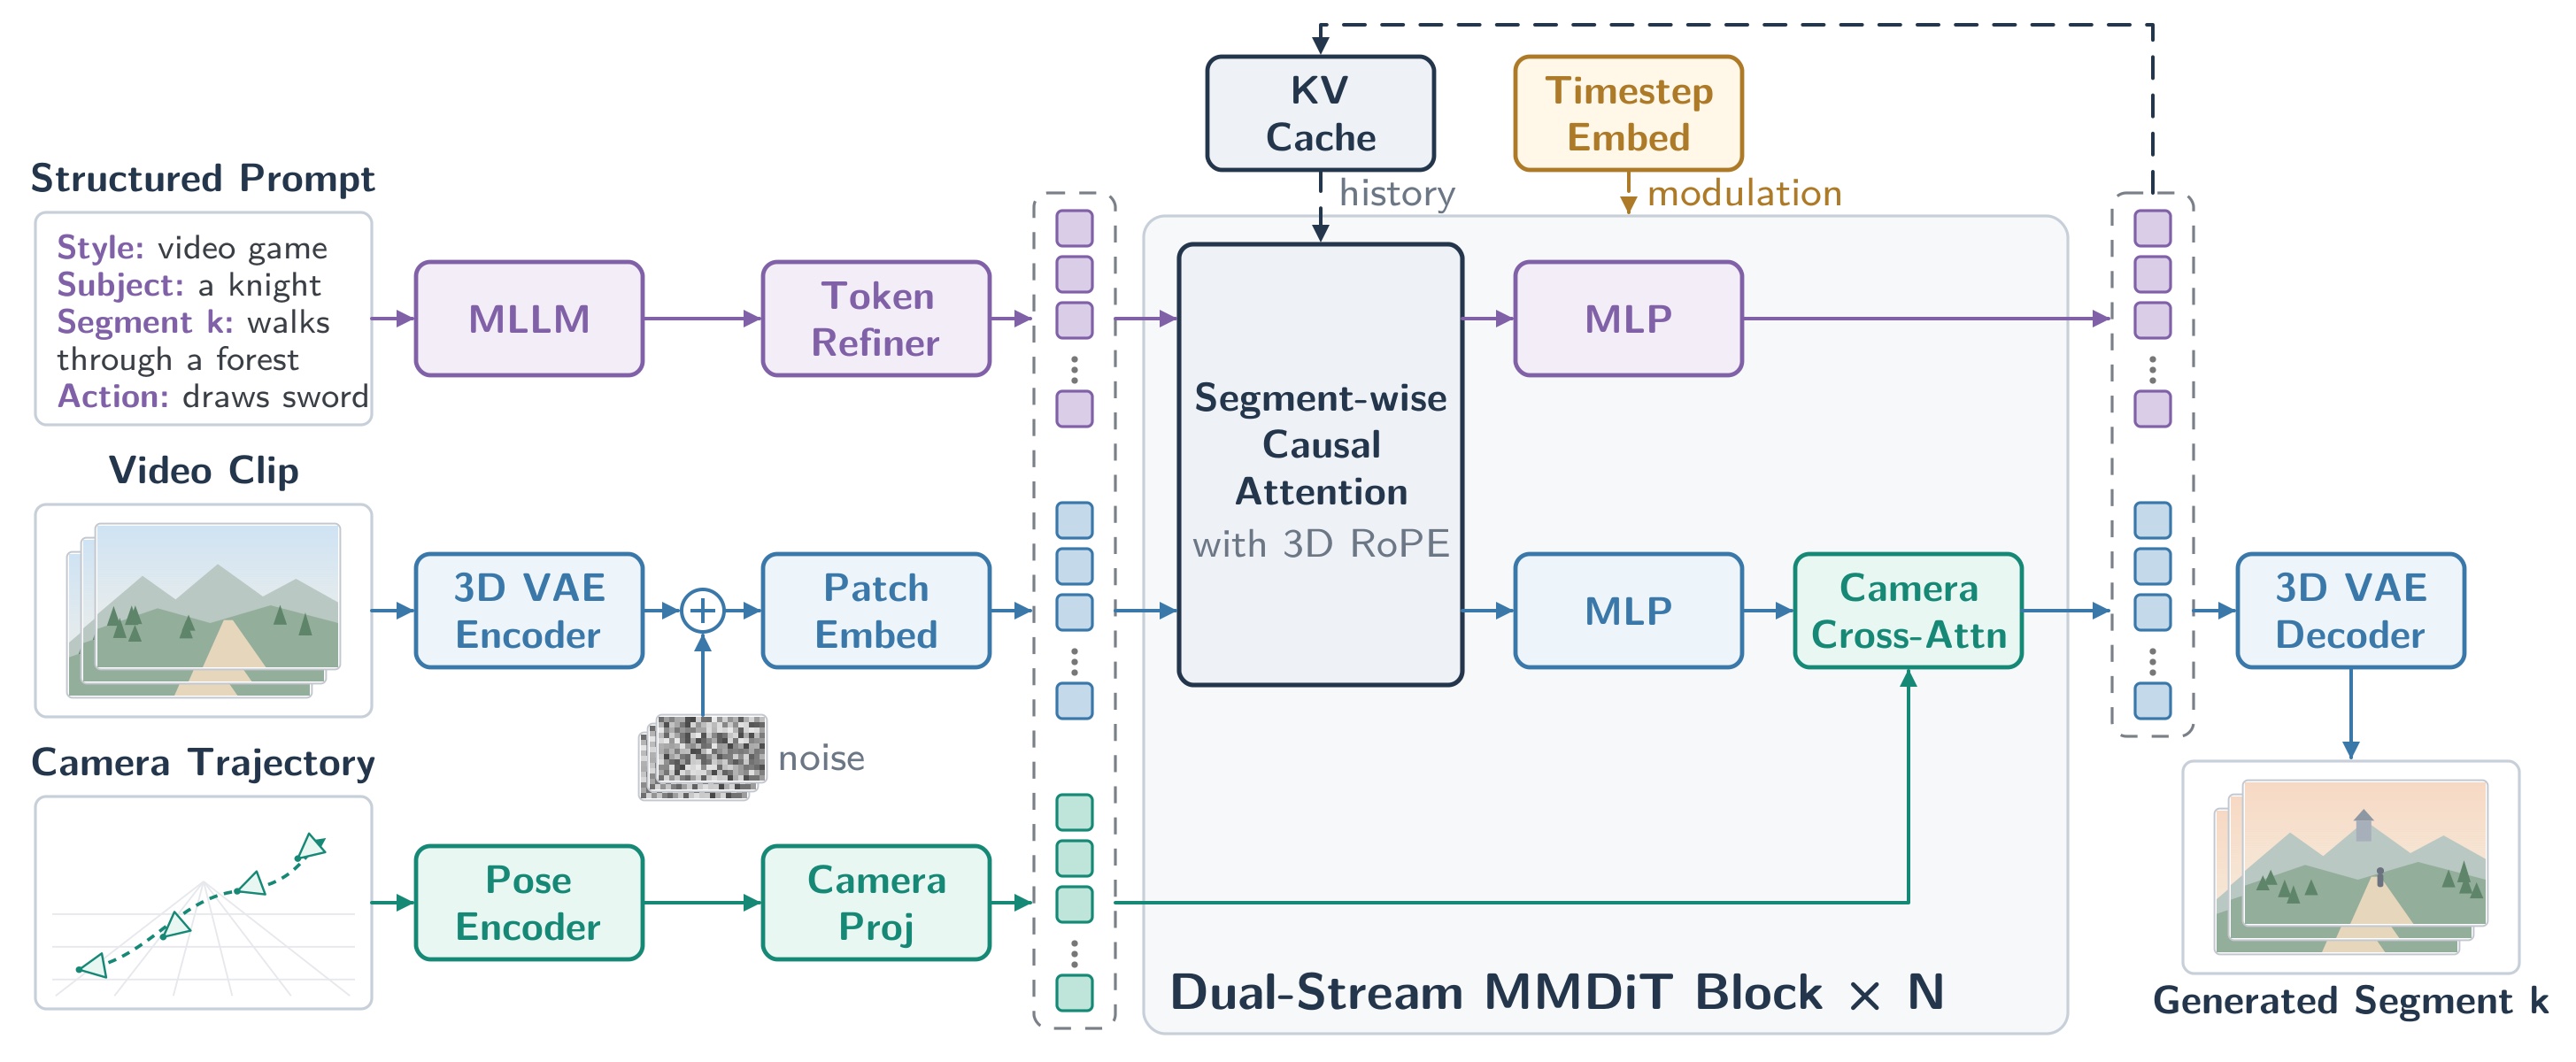
リリースリポジトリのフレームワーク図。テキスト、動画潜在、カメラ軌道がデュアルストリームMMDiTブロックに入力される。
| 項目 | 構成 |
|---|---|
| バックボーン | 54個のデュアルストリームMMDiTブロック、シングルストリームブロックなし |
| 隠れ層サイズ | 2,048、128次元のヘッド16個 |
| フィードフォワード | 4倍拡張、中間サイズ8,192 |
| 潜在 | 入出力32チャンネル、パッチ1 × 1 × 1 |
| 位置エンコーディング | 3D RoPE、サイズ[16, 56, 56]、theta 256 |
| テキスト条件付け | Qwen2.5-VL-7B-Instructの隠れ状態3,584次元、2層のトークンリファイナー |
| カメラ条件付け | デュアルストリームブロック内のクロスアテンション経由の外部パラメータ埋め込み |
| 予測 | フロー速度、Euler ODEサンプリング |
動画はDCAE-V f32t4c32潜在に格納されます。32チャンネル、各方向32倍の空間圧縮、4倍の時間圧縮です。デコードは36層、隠れサイズ4,096、クエリヘッド32、KVヘッド8のファインチューニング済みPixelUMMデコーダーが担当し、10潜在フレームの時間ウィンドウと5フレームのオーバーラップで4 × 16 × 16のタブレット単位にRGBを再構成します。このデコードは1ステップで、DiTの8デノイズステップとは別です。
単一4090構成
参照セットアップは1つの推論グループを8つのGPUに広げ、8-wayシーケンス並列と分散デコードを使用します。2つ目の構成は単一のRTX 4090を対象としており、変更点はすべてメモリ管理です。
- DiTの重みとキャッシュされたキー・バリューはINT8で格納され、リニアレイヤーとアテンションは引き続きBF16で計算されます。
- PixelUMMデコーダーはCUTLASSカーネル経由でFP8で動作し、DiTはFlexAttentionを使用します。
- テキストエンコーダー、DiT、デコーダーはそれぞれのステージでGPUに移動され、その後CPUにオフロードされます。
- GPU履歴は
temporal_contextでサンプリングされる18個の過去潜在フレームに制限され、より古い履歴はシステムRAMにアーカイブされます。
カードはトレードオフについて明示しています。システムRAMはオフロードされたモデルと増え続ける履歴アーカイブを保持する必要があり、CPUからGPUへの転送はレイテンシを追加し、履歴予算は現在のセグメントのメモリを上限化しません。セグメントごとの所要時間は公開されていないため、執筆時点で4090での速度は未検証です。
LoRAファインチューニングとプロンプトサービス
リリースには2つのアダプターが同梱されています。Cinematic LoRAは互換性のある浮動小数点DiT向けのオプションの視覚品質アダプターとして提供され、Robotics LoRAはRealSource-Worldロボットアームデータセットでトレーニングされ、蒸留DiTにマージして生成世界内の模擬操作を強化することを目的としています。INT8ローダーは推論時に別のLoRAを読み込めないため、アダプター作業はBF16またはFP32の重みを経由します。
リポジトリにはファインチューニングの手順も含まれています。SFTデータの準備、長いシーケンスのためのオフラインシーケンスパッキング、そしてトレーニングとマージです。Webデモには1つのハード依存があり、Nomas-PEという別サービスがユーザー指示を構造化された生成プロンプトに変換します。オフライン推論では準備済みプロンプトファイルを読み込んでこれを省略できます。ビルド済みDockerイメージ(hynomasoss/hynomasoss:cu130)にはPyTorch、FlashAttention、MagiAttentionが含まれ、CUDAカーネルを手動でビルドする手間を省けます。
Hy-Nomas-Bench
モデルと並んで、チームはHy-Nomas-Benchを公開しました。280のテストケースを持つ4つのベンチマークで、マルチターンの自由形式テキスト対話、カメラナビゲーション、テキストとカメラ制御の交互実行、空間記憶をカバーします。データセットには構造化プロンプト、インタラクションシーケンス、キーボードタイムライン、参照カメラ軌道が含まれ、単一のクリップではなく長い生成実行全体での一貫性をスコアリングするのに使えます。
入手方法
このリリースにネイティブのComfyUIサポートはありません。コアノードもComfy-Orgによる再パッケージも存在しません。公式の入手経路はDockerイメージ付きのGitHubリポジトリと、ホストされたインタラクティブデモです。
ComfyUI向けには、コミュニティ移植版Nynxz/ComfyUI-HyNomasが10月23日に登場し、変換済みの重みがnynxz/Hy-Nomasにあります。
| ファイル | フォルダー | サイズ |
|---|---|---|
nomas_dit_distilled_int8_convrot.safetensors | models/diffusion_models | 9.0 GB、INT8 ConvRot |
nomas_dit_distilled_bf16.safetensors | models/diffusion_models | 17.1 GB、LoRAマージ用のベース |
nomas_pixelumm_vae_bf16.safetensors | models/vae | 15.8 GB、PixelUMMデコーダーとDCAE-Vエンコーダー |
移植版はDiTを標準のLoad Diffusion Modelで、テキストエンコーダーをLoad CLIPでComfyUI自身のqwen_2.5_vl_7b.safetensors(Comfy-Org/Qwen-Image_ComfyUIのタイプqwen_image)を使って読み込み、デコーダーをLoad VAEで読み込むため、カスタムカーネルは不要です。作者によれば、RTX 5090でINT8チェックポイント、1280 × 704の3秒ターンが約21秒、加えてウィンドウごとに約4秒のデコードがかかります。これらの数値は登場から1日しか経っていない移植版に関するあるユーザーの計測値として扱い、公式構成が対象とする4090の数値とは分けて考えてください。
コメント
GitHubでサインインしてディスカッションに参加しましょう。