Iris-3B TurboがVAEなしでCPUとApple Silicon上で動作
Iris-3B TurboはVAEを使わない3Bパラメータのピクセル空間拡散トランスフォーマーです。FastSDCPUのOpenVINOビルドによるCPUと、Apple Silicon上のMetalエンジンで動作するようになりました。
Iris-3B はSperidlabsによる3Bパラメータの拡散トランスフォーマーで、RGBピクセルを直接デノイズします。VAEも潜在空間も存在せず、ネットワークの最後のブロックが各16×16パッチをピクセルに戻すため、最終段でのデコードは不要です(モデルカード | コード | 論文)。
参照実装はCUDA対応のNVIDIA GPUを要求します。現在では2つの独立した移植版が、多くの人がすでに所有しているハードウェアで同じ重みを実行できます。FastSDCPU は10月18日に4ステップのTurboチェックポイントをOpenVINO経路に追加し、Iris-3B Metal はカスタムMetalカーネルとネイティブmacOSアプリを備え、Apple Silicon上で動作します。
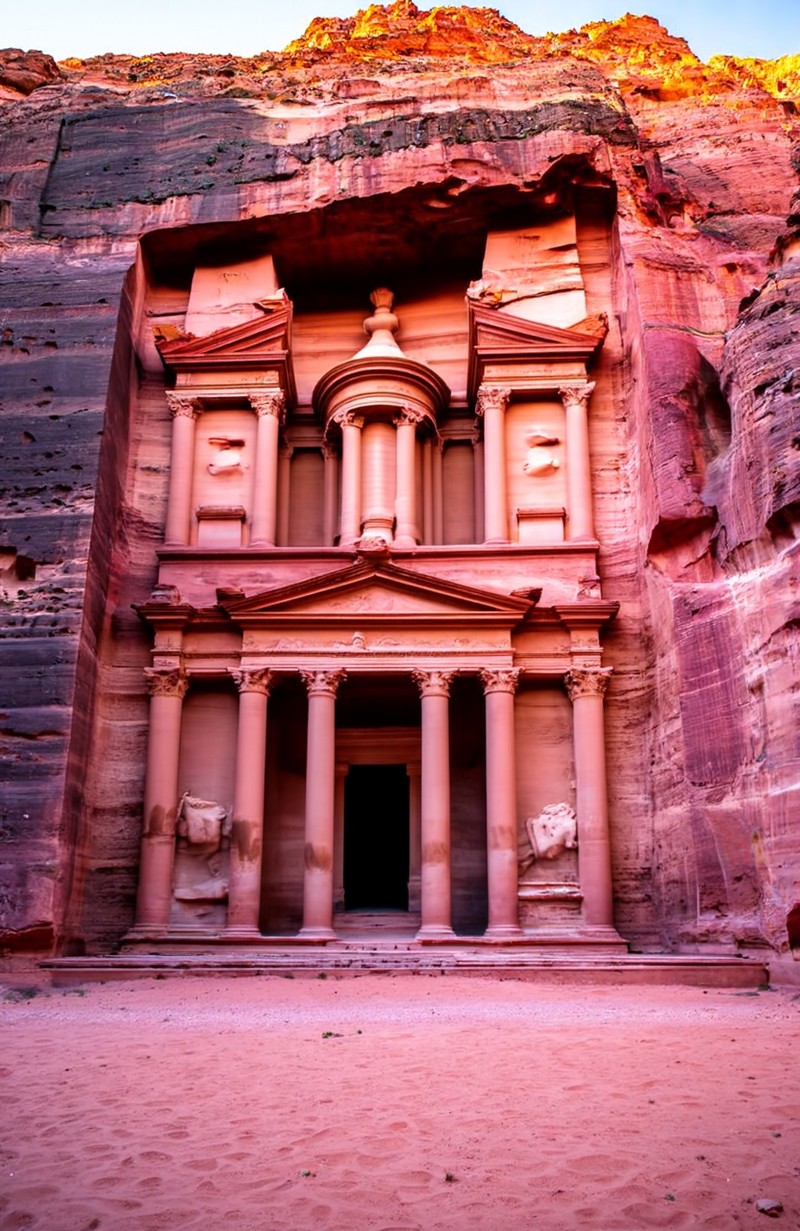
朝の光に照らされた古代都市ペトラ。Iris-3Bのデフォルト設定である100ステップで生成。出典: speridlabs/iris-3b
モデルの内部
アーキテクチャはかなり小規模な拡散トランスフォーマーです。8つのデュアルストリームブロックと16のシングルストリームブロックに続き、入力の各16×16パッチをピクセルに戻す4ブロックのピクセルヘッドを備えています。テキストは凍結されたQwen3-VL-4B-Instructエンコーダから供給されます。トレーニングはrectified flowで、256pxからスクラッチで開始し、512px、1024pxへと進み、1024pxでの教師ありファインチューニングを含めて合計665Kステップです。
VAEを省略することでエンコードとデコードの段階がなくなりますが、著者らはピクセル空間が自動的に安価になるわけではないと慎重に述べています。トランスフォーマー自体の計算コストは、同じパラメータ数の潜在モデルより重くなるため、以下のCPUでの数値は秒ではなく分単位で測定されています。
同じバックボーンはアーキテクチャを変更せずにファインチューニングされ、2つの高密度タスクに利用されます。単眼相対深度と4倍の画像復元です。どちらも空のプロンプトでモデル全体を1回のフォワードパスで実行するため、テキストエンコーダがまったく必要ありません。
Turbo: 4ステップ、CFGなし
Iris-3B Turboは同じリポジトリのturbo/フォルダーに含まれており、Trajectory Distribution Matchingで蒸留された3Bパラメータ全体のフルファインチューニングです。Classifier-free guidanceは重みに組み込まれているため、各ステップは1回のフォワードパスになります。モデルカードでは、バッチ4のH100 1基で1024×1024画像あたり約0.7秒と測定されています。
サンプリングは4ステップのスケジュール(σ = 1, 0.938, 0.833, 0.625)と決定論的なflow-Eulerステップに固定されているため、--steps、--cfg-scale、ネガティブプロンプトは適用されません。Turboは1024×1024、752×1344、896×1344、896×1200とその転置を含む、約1メガピクセル前後の7つのアスペクト比バケットで蒸留されています。
Iris-3B Turboの生成結果。H100上でシード6を使用。出典: speridlabs/iris-3b
| ベンチマーク | Iris-3B | Iris-3B Turbo |
|---|---|---|
| GenEval | 0.798 | 0.820 |
| DPG-Bench | 86.52 | 86.68 |
| LongText-Bench (EN) | 0.857 | 0.804 |
| OneIG-Bench (EN) | 0.540 | 0.516 |
Turboはプロンプト追従性でベースモデルをわずかに上回り、長いテキストの描画とOneIG-Benchでは下回ります。この差は主にテキストと出力の多様性に由来します。モデルカードでは、平坦なベクター風の背景に発生する粒状感や、シード間のばらつきが少ないことが、4ステップスケジュールの既知のトレードオフとして挙げられています。
CPU上で、OpenVINO int8経由
FastSDCPUは10月18日にリリースv1.0.0-beta.600でIris-3B Turboのサポートを公開しました。トランスフォーマーとQwen3-VLエンコーダをint8 OpenVINOに変換したものです(重み)。
| FastSDCPU、OpenVINO int8 | |
|---|---|
| ダウンロード | 6.9 GB |
| ピークシステムRAM | 約8.4 GB |
| 画像サイズ | 1024×1024のみ |
| ステップ数 | 4(1〜3でも動作するが、画像は粗くなる) |
| レイテンシ | Core i7-12700で1画像あたり約90秒 |
この統合はテキストから画像への生成のみです。ガイダンススケール、LoRA、ControlNetはIris経路では効果がなく、READMEにはCPUと統合GPUでテストしたと記されています。
Apple Silicon上で、Metal経由
Iris-3B Metalは独立したMPSおよびMetalエンジンで、独自のカーネルに加えてmacOSアプリ、CLI、Python API、ローカルHTTP APIを備えています。バージョン0.5.0は独自のファインチューニングなしで公式の重みを実行します(リポジトリ)。
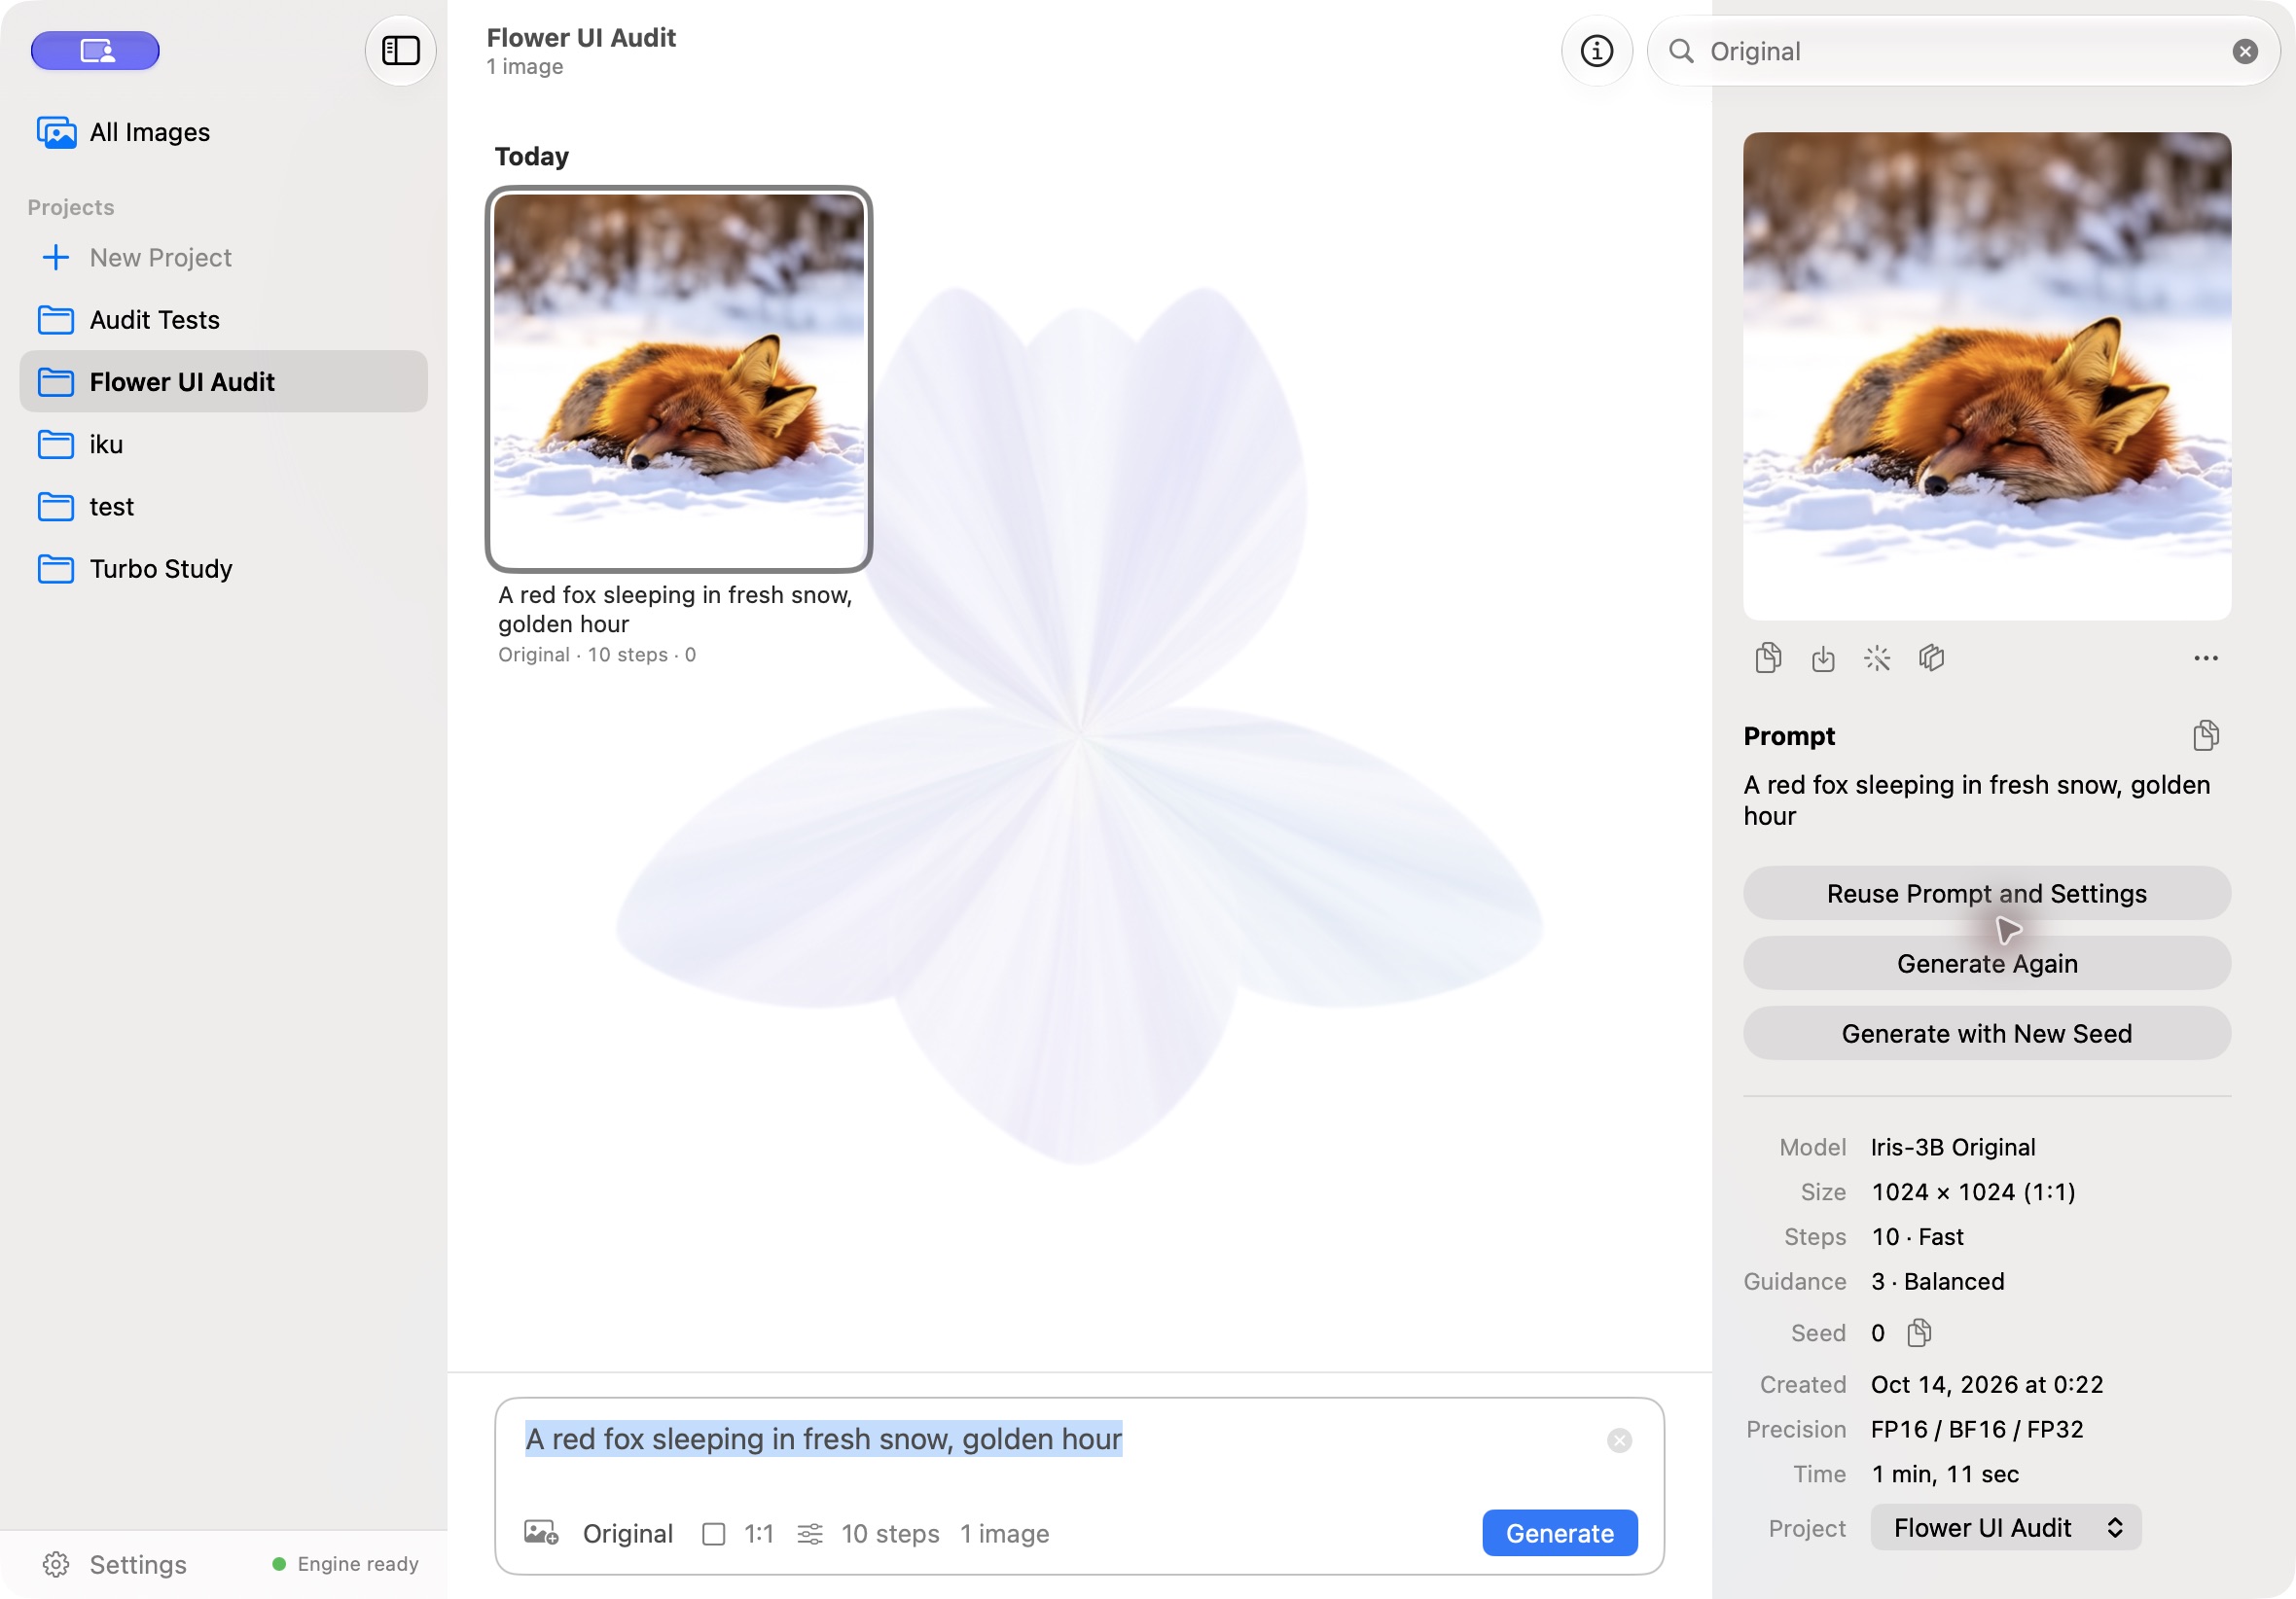
ネイティブmacOSアプリと、Iris-3Bによる生成画像。出典: TKY-27/iris-3b-metal
24 GiBを搭載するベースモデルのM5 MacBook Proでは、READMEにウォーム状態でTurboの4ステップが12.07秒、オリジナルモデルの10ステップが38.38秒、20ステップが76.04秒と報告されており、プロセスのピークメモリは約10 GiBです。16 GB搭載のマシンではテストされていません。
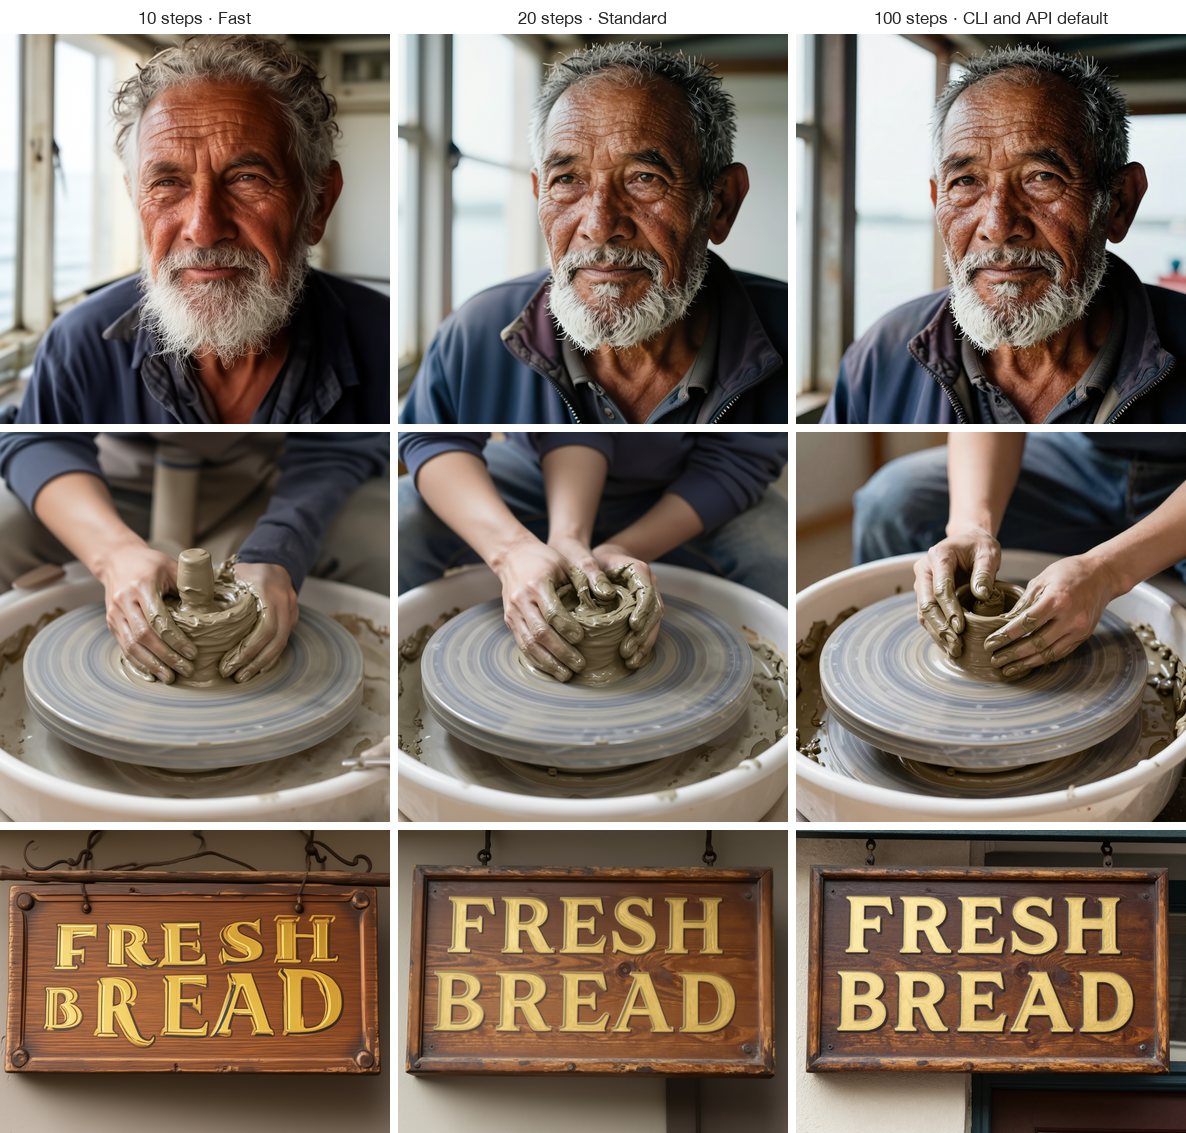
3つのプロンプトを同じシードで10、20、100ステップ実行した結果。構図は保たれるが、細部は変化し続ける。出典: TKY-27/iris-3b-metal
深度と復元
どちらの高密度タスクも、別個の視覚バックボーンをトレーニングする代わりに生成事前分布を再利用します。Marigold V2プロトコルにおいて、NYUv2、KITTI、ETH3D、ScanNet、DIODEにまたがるゼロショットで、深度モデルはAbsRel 0.071、δ1 0.946を報告しています。深度は相対的かつアフィン不変であり、メートル法ではありません。復元およびアップスケーリングモデルは、4倍でのDIV2K検証においてLPIPS 0.292、PSNR 20.68を報告し、大きな出力は重複する1024×1024ウィンドウにタイル分割します。
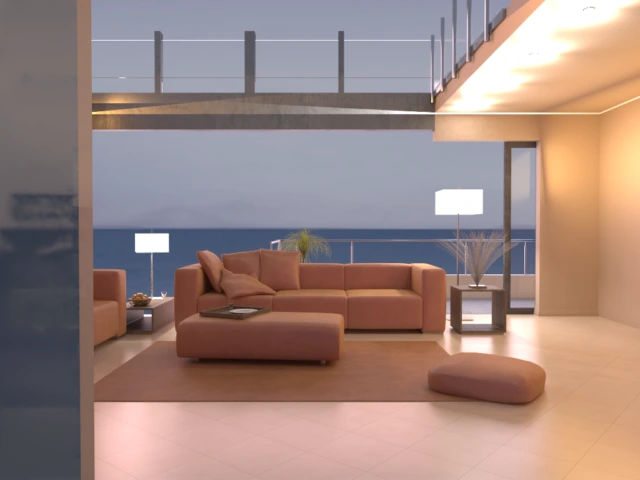 | 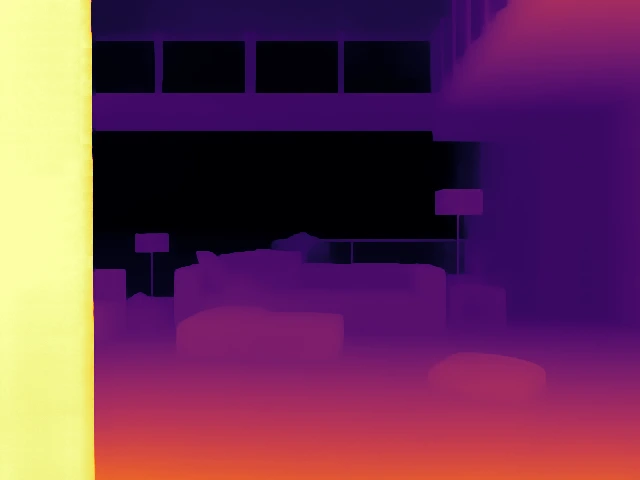 |
|---|---|
| 入力写真 | 相対深度、手前ほど明るい |
 | 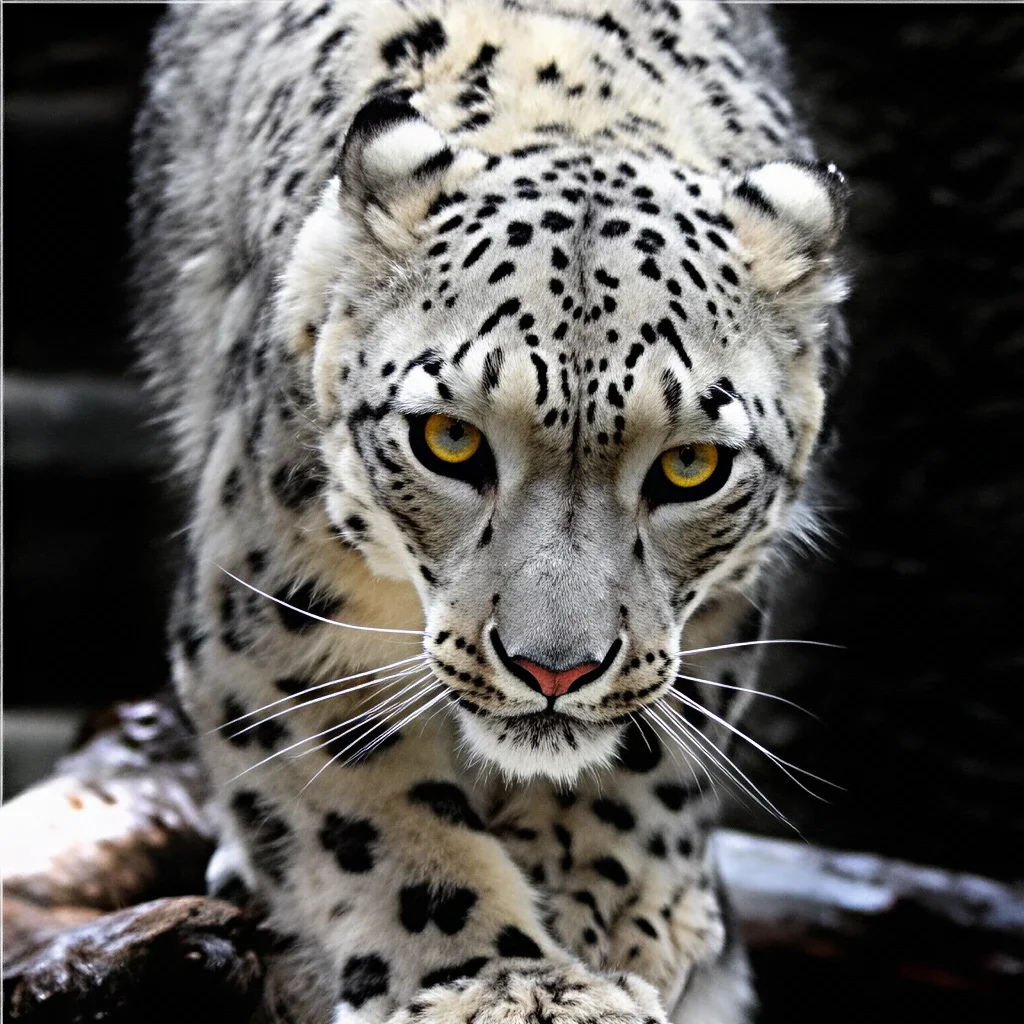 |
|---|---|
| 劣化入力 | 4倍復元 |
利用可能性
ComfyUIにはまだIris-3B用のネイティブローダーがありません。テキストから画像への生成は、参照用Pythonスクリプト、上記の2つの移植版、またはTurboデモSpaceで実行できます。ComfyUI向けのコミュニティノードパックが3つ存在します。ScryptHunter/ComfyUI-iris、RealRebelAI/ComfyUI-Iris-3B、bani4kaskashka/Iris-3B-Comfy-Nodesで、いずれも10月初旬に公開されたばかりの小規模なものです。
コメント
GitHubでサインインしてディスカッションに参加しましょう。