MiniMax H3 Character Swap v1.1: 80 MBのLoRAで類似度が向上
AlissonerdxがMiniMax H3 Character Swap v1.1を公開。80 MBの動的rank SVD抽出で参照画像への類似度が向上し、ComfyUIワークフローも2種(うち1つはネイティブノードのみ)同梱されています。
このリポジトリは、10月上旬に v1.0 を扱った H3 キャラクタースワップとライブ壁紙 LoRA と同じもので、執筆時点で約458件のいいねと144,700ダウンロードを記録しています。パック内のすべてのアダプターは H3 の ref2va 重みに対してトレーニングされており、同じ条件付けの考え方を使っています。ソースクリップは MiniMaxH3AddGuide を通じて、ゆるい動画参照ではなく整列されたガイド格子として注入されます。
v1.1 はタスクを変更しません。同じ body_swap: トリガーによるガイド駆動のボディスワップで、リリース全体が v1.0 に対する1つの不満、つまりスワップ後のキャラクターが参照画像に十分似ていなかったという点に対応しています。
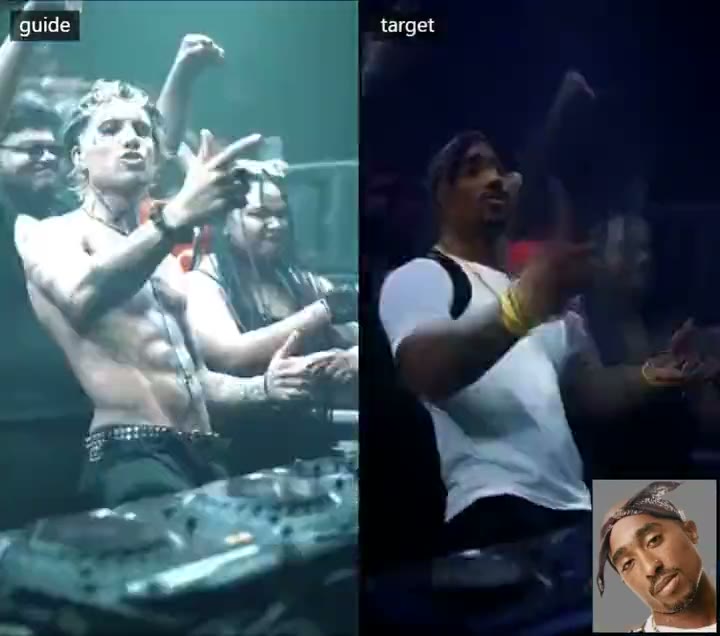
作者の v1.1 テストにおけるガイド対ターゲットの比較クリップの1フレーム。
v1.1 で変わったこと
作者はこのリリースのために新しいアダプターを再トレーニングしていません。v1.1 は v1.1 トレーニング実行の 80 MB の SVD 抽出で、Frobenius ノルムのエネルギー分析によってレイヤーごとに動的な rank を選択しています。208 レイヤーのそれぞれが自身のエネルギーの 95% を保持する最小の rank を維持し、その結果は rank 4 から rank 34、中央値は 7 になります。これによりファイルは v1.0 の rank-64 チェックポイントより約8分の1小さくなりながら、類似度ではより良いスコアを出します。そのため参照が顔、髪、体、衣服により密接に適用され、ガイドは引き続きシーン、カメラ、パフォーマンスを提供します。
| チェックポイント | サイズ | 内容 |
|---|---|---|
minimax_h3_character_swap_v1.1_ref2va_fro | 80 MB | レイヤーごとの動的 rank(4〜34、中央値 7)。推奨リリース |
minimax_h3_character_swap_v1.0_ref2va_r64_gl | 620 MB | rank 64。前回のリリースで、並べて比較するために残されています |
ガイドでは強度 1.0 を指定しており、これは作者が公開時に掲げるルールでもあります。1.0 で動作しない LoRA はリリースされません。
作者はリリースが進行中の段階で、rank 比較のうち3本を投稿しました。1本目はエネルギー分析で抽出した rank を使用し、2本目は v1.1 の背後にある2つのトレーニング段階を混在させたもの、3本目はガイドとターゲットの完全な比較です。
Frobenius エネルギーによる rank 抽出。v1.1 で採用された方式です。
v1.1 の背後にある2つのトレーニング段階を組み合わせた混合 rank のテスト。
ガイドとスワップ後の出力を並べたクリップ。
v1.1 の2つのワークフロー
v1.1 には新しいグラフのペアが付属しており、どちらを選ぶかは主にクリップの長さで決まります。
| ワークフロー | 使用するもの |
|---|---|
| Shot Planner | ComfyUI-BFSNodes 1.113.0 以降。長い動画はショットに分割され、各ショットがレンダリングされて結合されます。参照と {details} はプランナーで記述され、グラフが並べて比較する形に構築します。 |
| ネイティブノードのみ | Generate Text が参照画像を見て完全なプロンプトを書き、続いて MiniMax H3 Reference to Video と Add Guide が1つのクリップをレンダリングします。コミュニティのノードパックは不要です。 |
どちらも DMD turbo LoRA を使って8ステップで実行され、1280×704 で LMS シャープネス LoRA と latent upscaler を追加するオプションの2パス目を備えています。各ワークフローには、読み込むすべてのモデルのダウンロードリンクを示したノートがあり、モデルローダーは保存時のフォルダー名を保持しています。そのためファイルが別の場所にある場合は、各ローダーを選び直す必要があります。
プロンプトテンプレート
参照がどれだけ残るかを決めるのはキャラクターの説明の部分です。ガイドには固定テンプレートが付属するようになりました。1行で使い、{details} だけを、性別から始まる参照キャラクターのカンマ区切りの説明に置き換えます。
body_swap: subject_definitions: <Subject 1> is the {details} shown in <Picture 1>, whose identity, face, head, hair or fur, skin, body shape, proportions and clothing define the character in the target video. The guide video provides the scene and the performance: its background, environment, lighting, camera, framing, body pose, hand and arm movement, head rotation, gaze direction, lip movement and facial expression, frame by frame; only the main subject of the guide video is replaced: its face, hair, body and clothing become <Subject 1>. summary: [video generation + reference] Replace the guide subject with <Subject 1>, keeping the scene, camera and the complete motion and performance of the guide video. detailed_description: [Shot 1] <Subject 1> takes the exact place of the guide subject and moves with the same timing, body pose, gestures, head motion, gaze, speech and facial expressions, while keeping the complete identity from <Picture 1>: facial structure, hair or fur, skin, body shape and clothing stay stable in every frame. The background, lighting, colors and camera of the guide video are preserved. Prevent identity drift, clothing changes, texture crawling and flicker.{details} は頭からつま先まで書くことを意図しています。性別、身長と体格、顔の形と肌の色、髪、色と素材を含む上下の衣服、履物、アクセサリー、そしてタトゥーや傷跡、しわなどの特徴的な要素です。ガイドは、そのスロットに背景、カメラ、照明を書くことを禁じています。
自動で埋める方法は2つあります。Shot Planner では {details} がプロンプトに残り、パネルの Describe refs アクションが各参照の説明を書くか、ワークフロー実行時に言語モデルが書きます。ネイティブワークフローでは Generate Text が参照画像と、完全なプロンプトを返す指示を受け取ります。ガイドでは、プロンプトの末尾が切れないよう max_length を約768に設定することを推奨しています。
入手方法
LoRA を ComfyUI/models/loras/ に配置し、v1.1 ワークフローのいずれかを読み込み、グラフ内のノートで必要なモデルを確認してください。公開されているセットアップでは、H3 の ref2va diffusion モデル(作者の例では pruned int8_convrot ビルド)、H3 テキストエンコーダー、動画と音声の VAE、8ステップ DMD turbo LoRA を読み込みます。オプションの qwen3.5_9b_w4a8_gptq 視覚言語モデルは、参照の説明にのみ使われます。
入力の順序が重要です。LoRA はガイドの latent でトレーニングされているため、オリジナルのクリップを frame_idx = 0 で MiniMaxH3AddGuide に送り、キャラクター画像は H3 のネイティブな画像参照パスを通じて <Picture 1> として送ってください。出力のアスペクト比とフレーム数をガイドに合わせ、H3 のフレーム数 17n + 5(5、22、39、56、73、90、107、124 など)を使い、長いクリップを実行する前に短い範囲でテストしてください。
コメント
GitHubでサインインしてディスカッションに参加しましょう。