MOSS-Image Few-Step LoRA:4ステップ rapid-moss と8ステップ DMD
2つのコミュニティ製LoRAが MOSS-Image-SFT を50ステップから4回または8回のネットワーク評価に短縮します。4ステップの rapid-moss アダプターには専用サンプラーを備えた ComfyUI カスタムノードとネイティブワークフローが同梱されています。
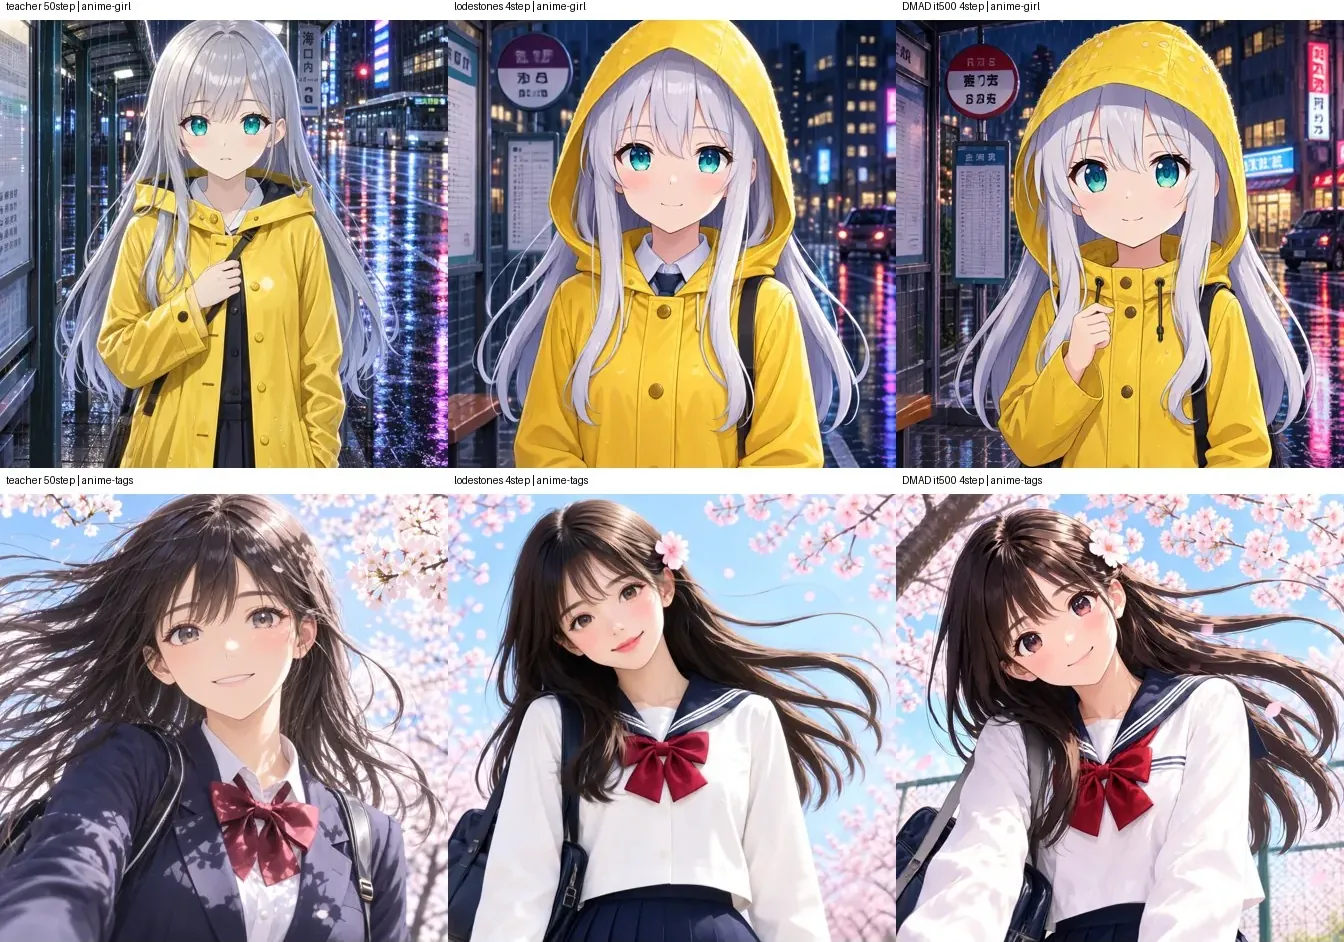
左から右へ:50ステップのティーチャー、8ステップチェックポイントを4ステップで実行したもの、4ステップの rapid-moss アダプター。同じシード、トレーニングでは使用していない評価プロンプト。ソース:darask0
サンプリングループが短くなる理由
MOSS-Image-SFT は CFG 3 で50ステップかけて1枚の画像を生成し、CFG はフォワードパスを2倍にするため、1枚あたり約100回の DiT 評価が必要です。8ステップチェックポイント はそのループをデータ空間DMD(arXiv 2610.12102)に置き換えます。ジェネレーターは固定されたノイズテンソルから自身のクリーンな推定値を4~8回反復し、CFGもタイムステップスケジュールも使いません。
4ステップアダプターはそのチェックポイントから継続し、反復回数を4回に制限したもので、DMAD(arXiv 2610.02188)でトレーニングされています。凍結されたティーチャー上のLoRAクリティックがティーチャーのサンプルと生徒のサンプルを分離し、生徒はクリティックのネガティブロジットを最小化します。作者は各1つのティーチャーサンプルを持つ3,199件のプロンプトでトレーニングし、その後の反復でプロンプト追従性が低下し始める前の500イタレーションのチェックポイントを公開しました。
H100 1基での 1024² 画像あたりの DiT 時間:
| チェックポイント | DiT 時間 | DiT 評価回数 |
|---|---|---|
| MOSS-Image-SFT(50ステップ、CFG 3) | 16.2 s | 100 |
| lodestones 8ステップ DMD | 1.54 s | 8 |
| rapid-moss 4ステップ DMAD | 0.81 s | 4 |
計測時間はトランスフォーマーのみで、Qwen3.5-9B テキストエンコーダーや VAE は含みません。RTX PRO 6000 上の ComfyUI 内では、テキストエンコードとデコードを含めて 1024² 画像で4.5~6.9秒と作者は計測しています。
ComfyUI ノード
どちらのアダプターも fp32 のLoRAデルタで、その大きさは bf16 の丸め幅より小さいため、bf16 の重みにマージすると蒸留の大部分が失われます。そのため LoraLoaderModelOnly、diffusers の fuse_lora、マージ済みの重みを読み込むワークフローは使えません。同梱の MOSS-Image Few-Step Adapter (rapid-moss) ノードは、代わりに実行時に fp32 でLoRAを加算し、fp32 の時間パスを置き換え、対応する MODEL、SAMPLER、SIGMAS の3点セットを返します。
出力はセットとして接続する必要があります。MODEL を CFG なしで BasicGuider に、次に SAMPLER と SIGMAS を SamplerCustomAdvanced に、最後に VAEデコードへ接続します。Euler、sgm_uniform、shift 5 の ModelSamplingSD3、layer 22 のスキップはすべて50ステップのティーチャー向けの設定であり、ここでは追加すべきではありません。ステップ数は rapid-moss では1~4、8ステップチェックポイントでは1~8で、strength 1.0 が推奨のデフォルトです。
ワークフローは2つ含まれています。ネイティブなものは標準の ComfyUI ローダーを使用します。Comfy-Org/MOSS-Image の moss_image_sft_bf16.safetensors、type が moss_image の CLIPLoader、そして FLUX.2 VAE です。
2つ目のワークフローは OpenMOSS 自身の moss-image HF Loader ノードを保持し、ローカルの Diffusers ディレクトリを指します:
comfyui/rapid-moss/ を ComfyUI/custom_nodes/rapid-moss/ にコピーして再起動します。
2. lora.safetensors、time_embedding.safetensors、dataspace.safetensors を ComfyUI/models/rapid_moss/rapid-moss-4step/ に置きます。models/rapid_moss/ 以下の各サブフォルダーはノードの adapter メニューの項目になるため、8ステップのファイルは2つ目のフォルダーに入れます。
3. ワークフローを読み込み、アダプターを選択し、ベースのディフュージョンモデルに bf16 または fp32 の SFT 重みを設定します。
並べて比較した結果
17件の評価プロンプト全体で、作者は8ステップチェックポイントを4ステップで実行した場合よりも背景のディテールが多く構図が生き生きしていると報告しており、さらに縦長ポスターで「夏」が二重になる問題が修正され、付箋や看板、吹き出しの日本語テキストも正確なままです。
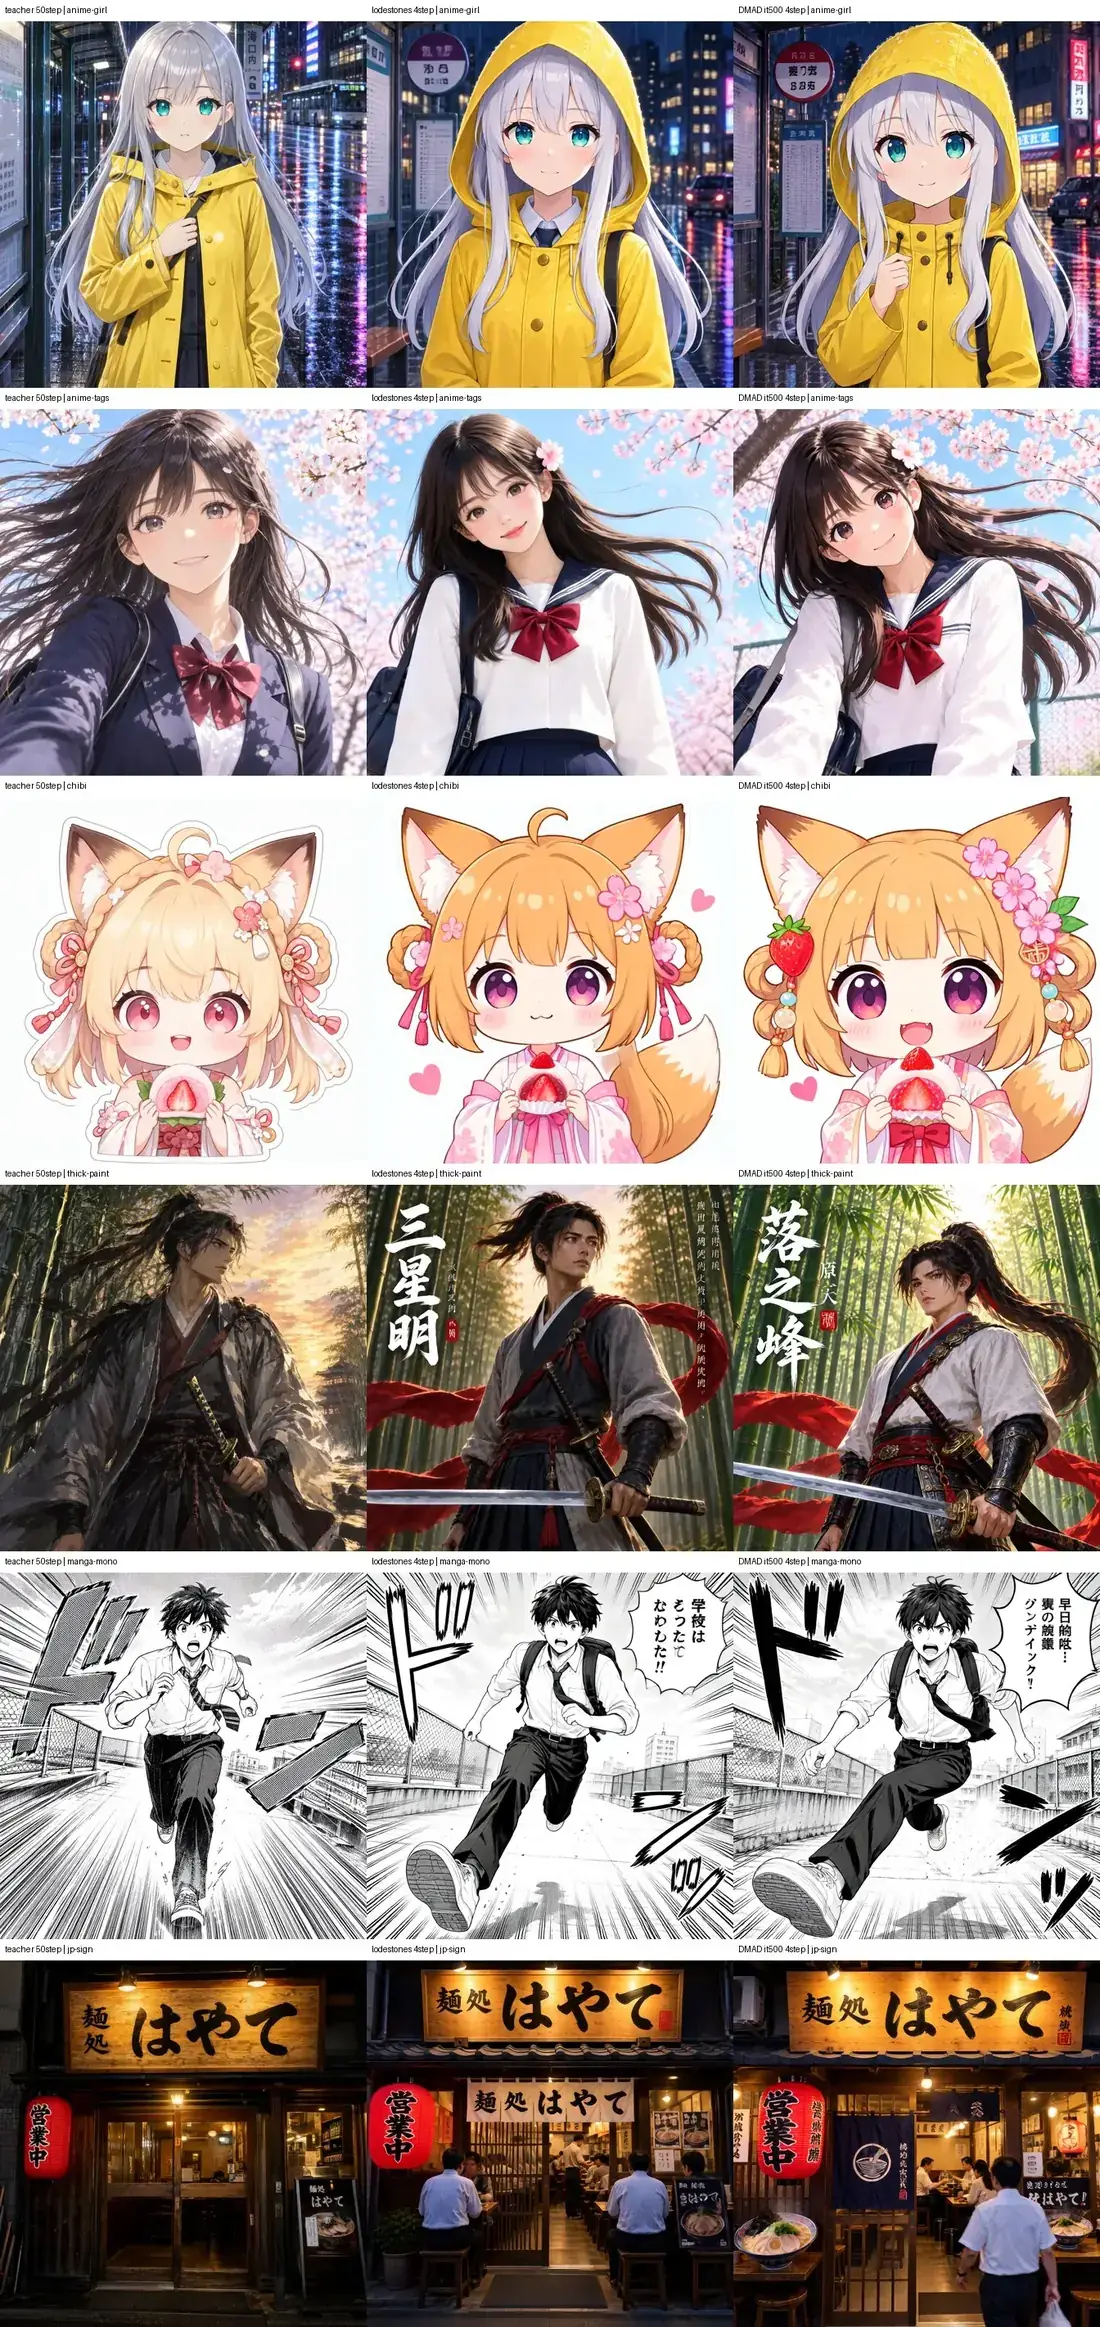
ティーチャー、8ステップチェックポイントを4ステップで実行したもの、4ステップアダプター。ソース:darask0
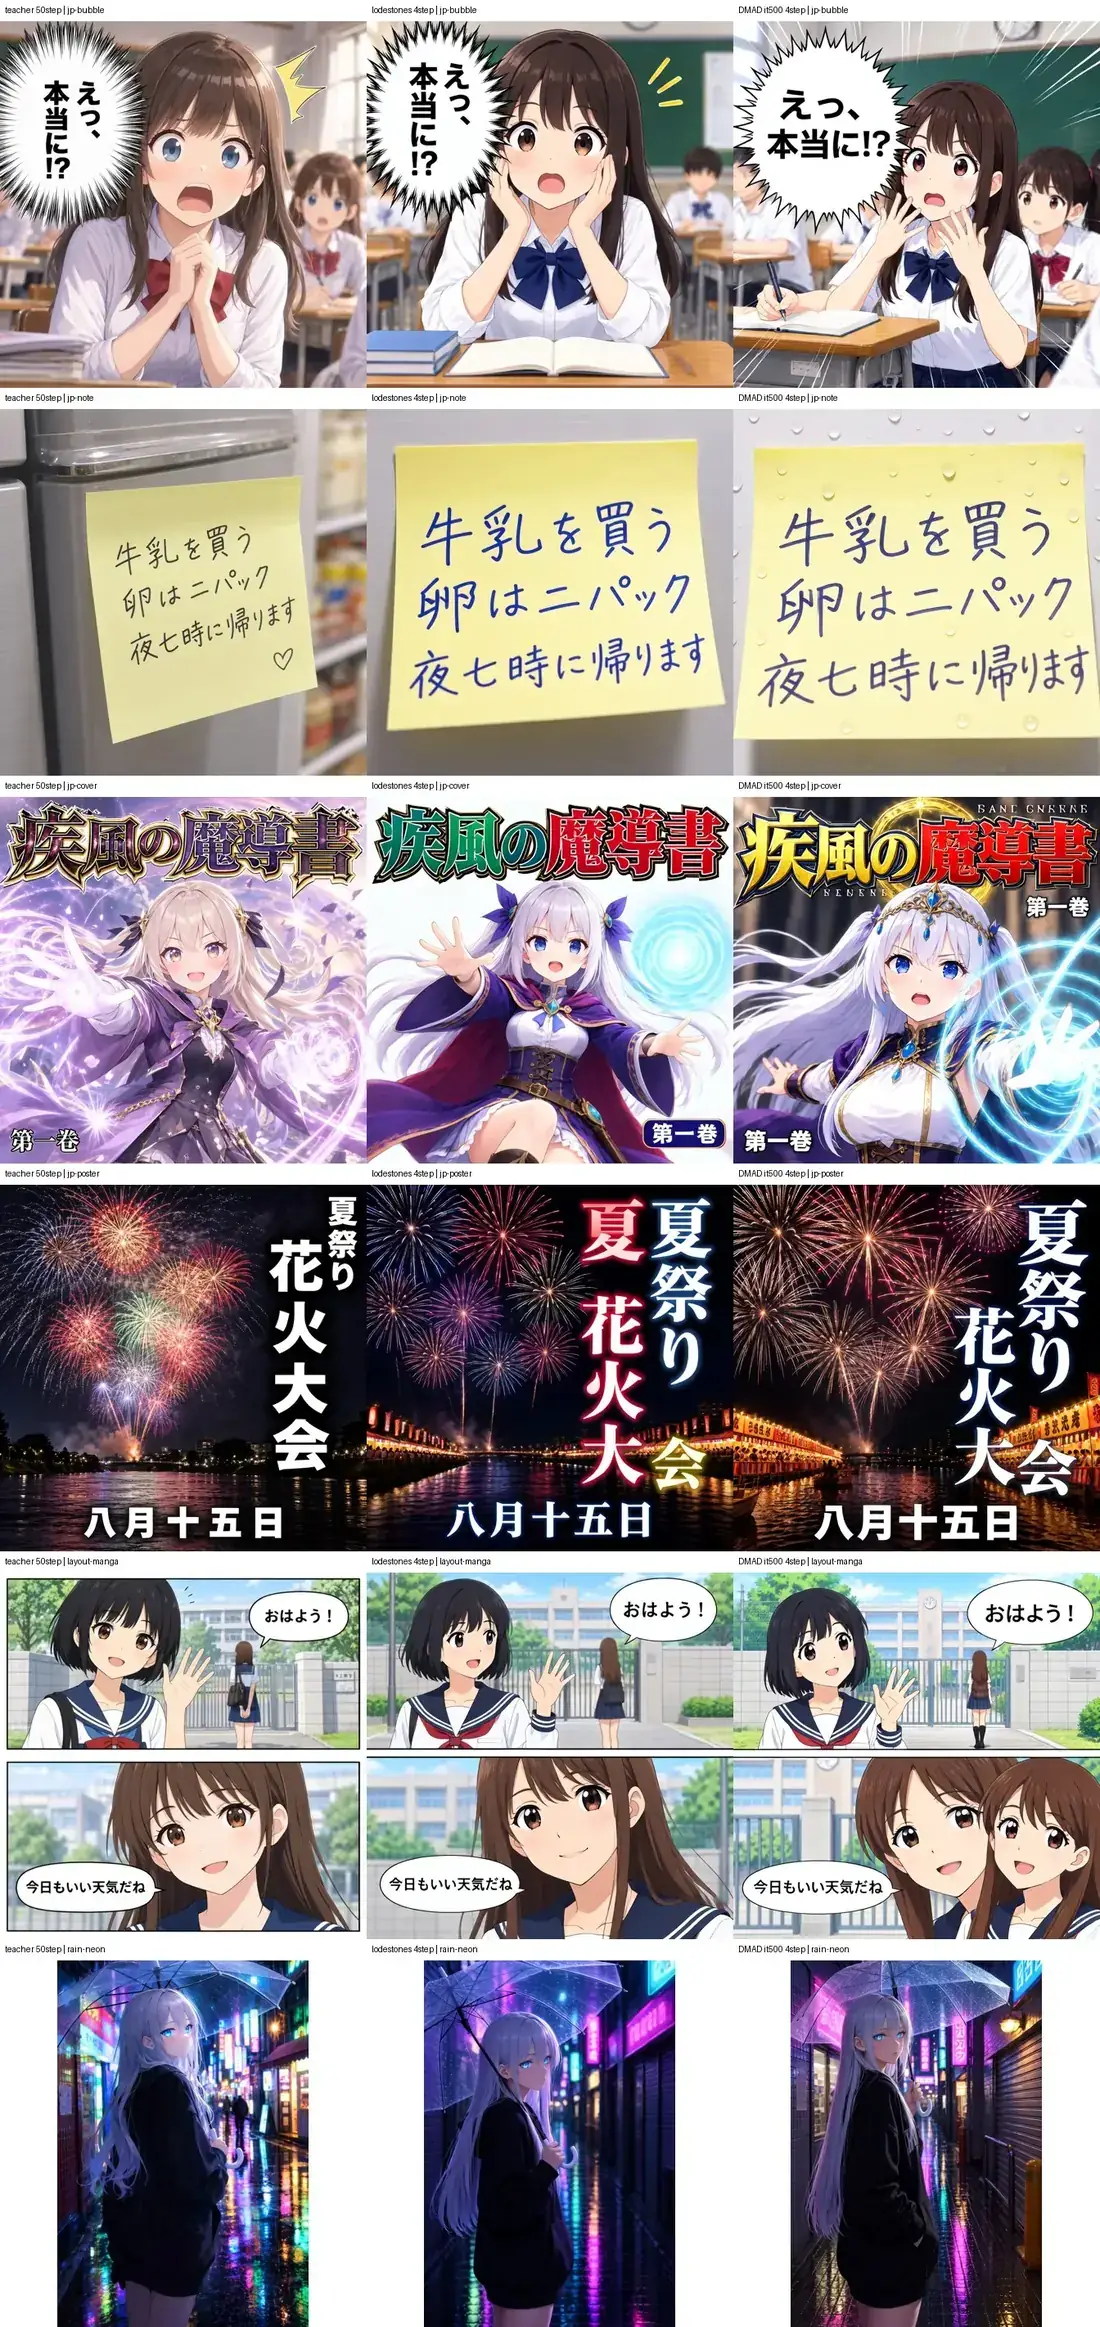
2つ目のプロンプトでの同じ3者比較。ソース:darask0
作者は問題を覆い隠すことなく、劣化した点も挙げています。ライトノベルの表紙に不要なラテン文字が現れる、2コマ漫画の JSON レイアウト要求で下段に要求していない2人目が追加される、店の暖簾や漫画の吹き出しの小さな文字は依然として失敗する、といった点です。品質は50ステップのティーチャーを下回ります。
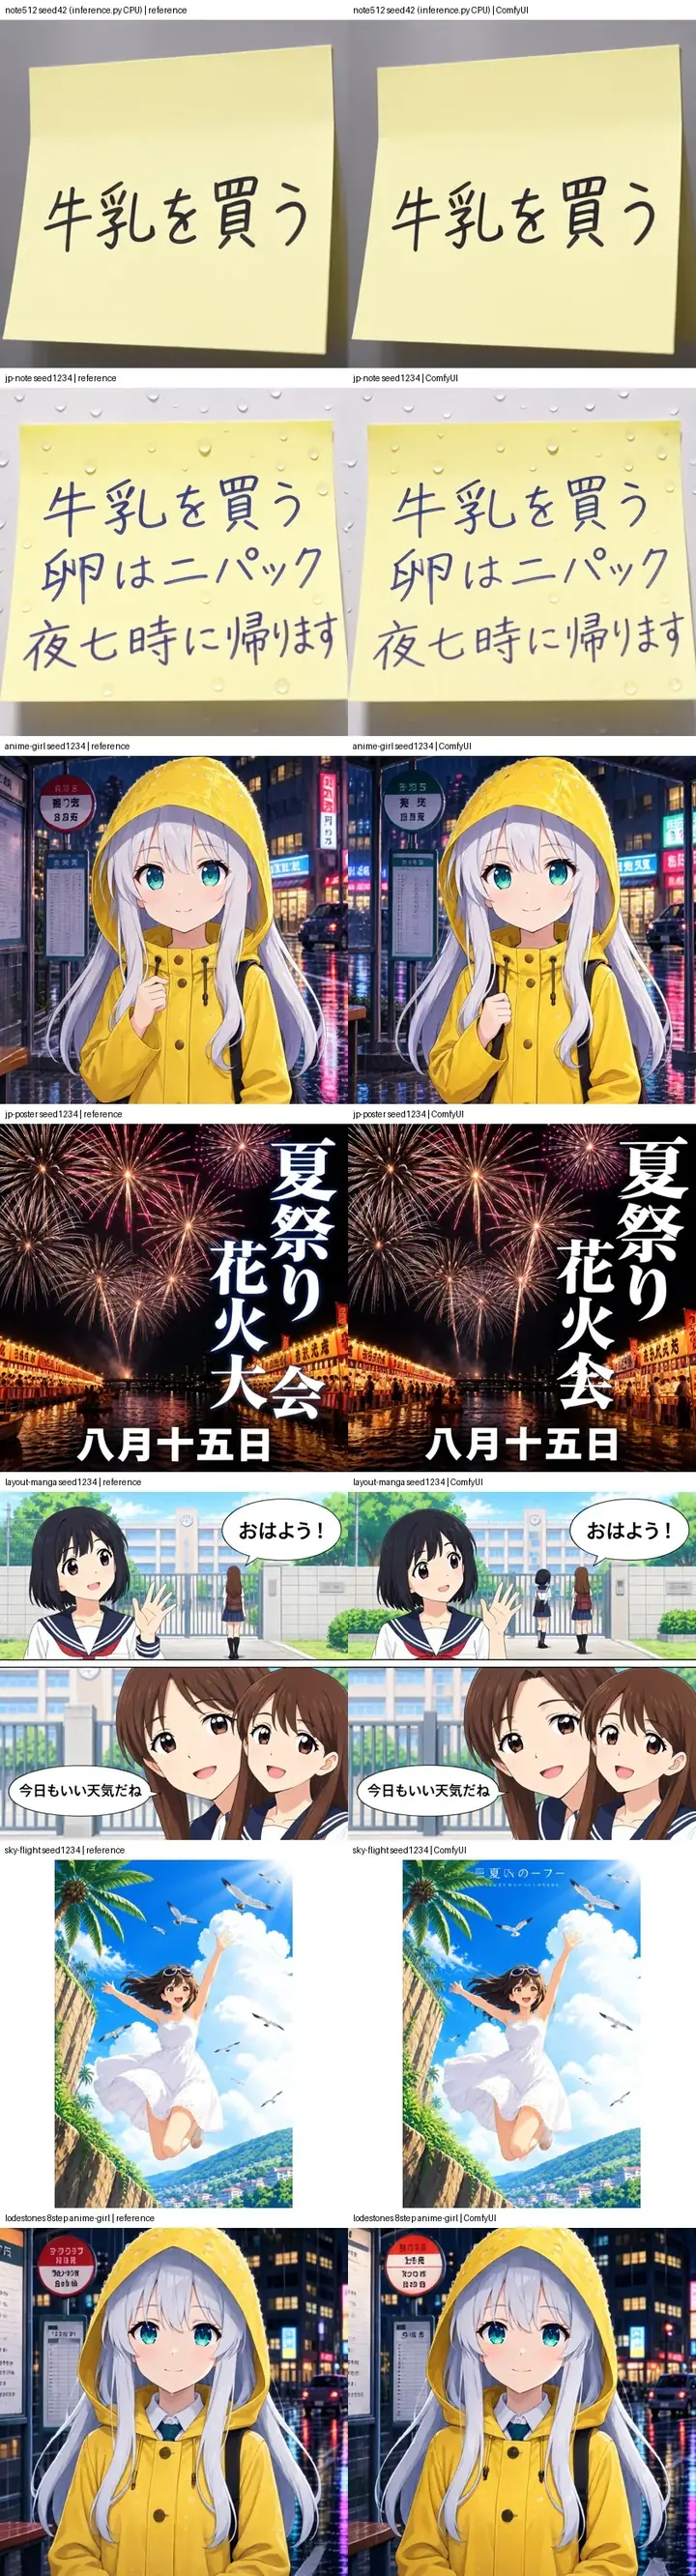
ComfyUI 内の rapid-moss ノード。fp32 アダプターを BasicGuider と SamplerCustomAdvanced に接続している。ソース:darask0
8ステップチェックポイント単体
lodestones 氏は以前の8ステップチェックポイントを10月16日に進行中の作業として公開しました。ファイルのみの提供で、strength 1.0 の lora.safetensors または 0.7 の lora_latest.safetensors、そして同じ time_embedding.safetensors と dataspace.safetensors です。8ステップの重みには自身のカードで標準の ComfyUI LoRA ローダーを指定していますが、rapid-moss ノードは4ステップのデルタが必要とする fp32 パスで両方のアダプターを動かせます。
ComfyUI の外でアダプターを動かす場合、4ステップリポジトリの inference.py がサンプラーをそのまま再現します。初期ノイズテンソルを固定し、dataspace.safetensors 内の 128x128 行列を通して現在の推定値と混合し、同じファイルからステップコードを読み取ります。
入手方法
- 4ステップアダプター: darask0/MOSS-Image_4-step_adapter_lora。トレーニングコード、ログ、評価プロンプト、ComfyUI ノードを含みます。
- 8ステップチェックポイント: lodestones/MOSS-Image-SFT-8-steps-dmd。公開デモ Space 付き。
- ベースモデル: OpenMOSS-Team/MOSS-Image-SFT と、Comfy-Org/MOSS-Image の ComfyUI 向け再パッケージ版。
コメント
GitHubでサインインしてディスカッションに参加しましょう。