H3 Anti-Burn LoRA: 連続H3クリップの顔の焼けを抑制
MiniMax H3の継続クリップ向けrank-32 LoRAが、lightx2v 8ステップのチェーンで顔の焼けを+44%から0%へ、未学習のturboでも+61%から+4%へ低減します。
diffusion_model.*)を使用しているため、カスタムノードは不要です。
対象となる問題
長いH3動画は通常、チェーンで作成します。クリップ2はクリップ1の最後のフレームから続き、クリップ3はクリップ2から続く、という具合です。各継続は渡された終端をコピーし、そこに独自のエラーを少しずつ上乗せします。数クリップを重ねると顔が焼けます。肌と輪郭がざらつき、彫り込まれたようになり、フレーム全体が硬い印象になります。
このLoRAは継続パスのみに読み込まれ、通常どおり生成される最初のクリップの見た目に近づけます。クリップ1には焼ける元となるものが何もないため、明示的に対象外です。
使用方法
- 継続クリップをレンダリングするモデル(クリップ2以降)にのみ、
LoraLoaderModelOnlyで読み込みます。 - 強度0.5から開始します。クリップを重ねるごとに顔がざらつく場合は上げ、顔が柔らかくなる、あるいはワックスのようになる場合は下げます。
- 強度はturboとパイプラインによって変わります。LoRAを8ビットチェックポイントにマージすると効果が弱まるため、4〜5クリップのチェーンでいくつかの値を試してから決めることを推奨します。
測定結果
10クリップのチェーン、各約37秒、4シーン(キッチン、同じキッチンで別シード、公園、ポーチ)で、設定ごとに全チェーンを平均したものです。「顔の焼け」は、クリップ1とクリップ10の間で顔の細かいテクスチャがどれだけ変化したかを示します。ゼロはクリップ10がクリップ1と同じくらいクリーンであること、正の値は焼けたこと、負の値はクリップ1より柔らかくなったことを意味します。
| Turbo | LoRAなし | 0.4 | 0.5 | 0.6 | 0.8 |
|---|---|---|---|---|---|
| 未学習モデル(トレーニング対象外) | +61% | +29% | +4% | −13% | |
| HyperFlow 8ステップ | +25% | +4% | −1% | −14% | |
| lightx2v 8ステップ v1.0 768p | +44% | +14% | 0% | −7% | −37% |
| Larry Turbo v4(step 600 EMA) | +261% | +212% | +159% | +57% |
最も重要なのは未学習モデルの列です。このLoRAはLarry Turbo v4、HyperFlow、lightx2vでトレーニングされており、それでも0.6で、一度も見たことのない4つ目のturboを+4%に抑えました。
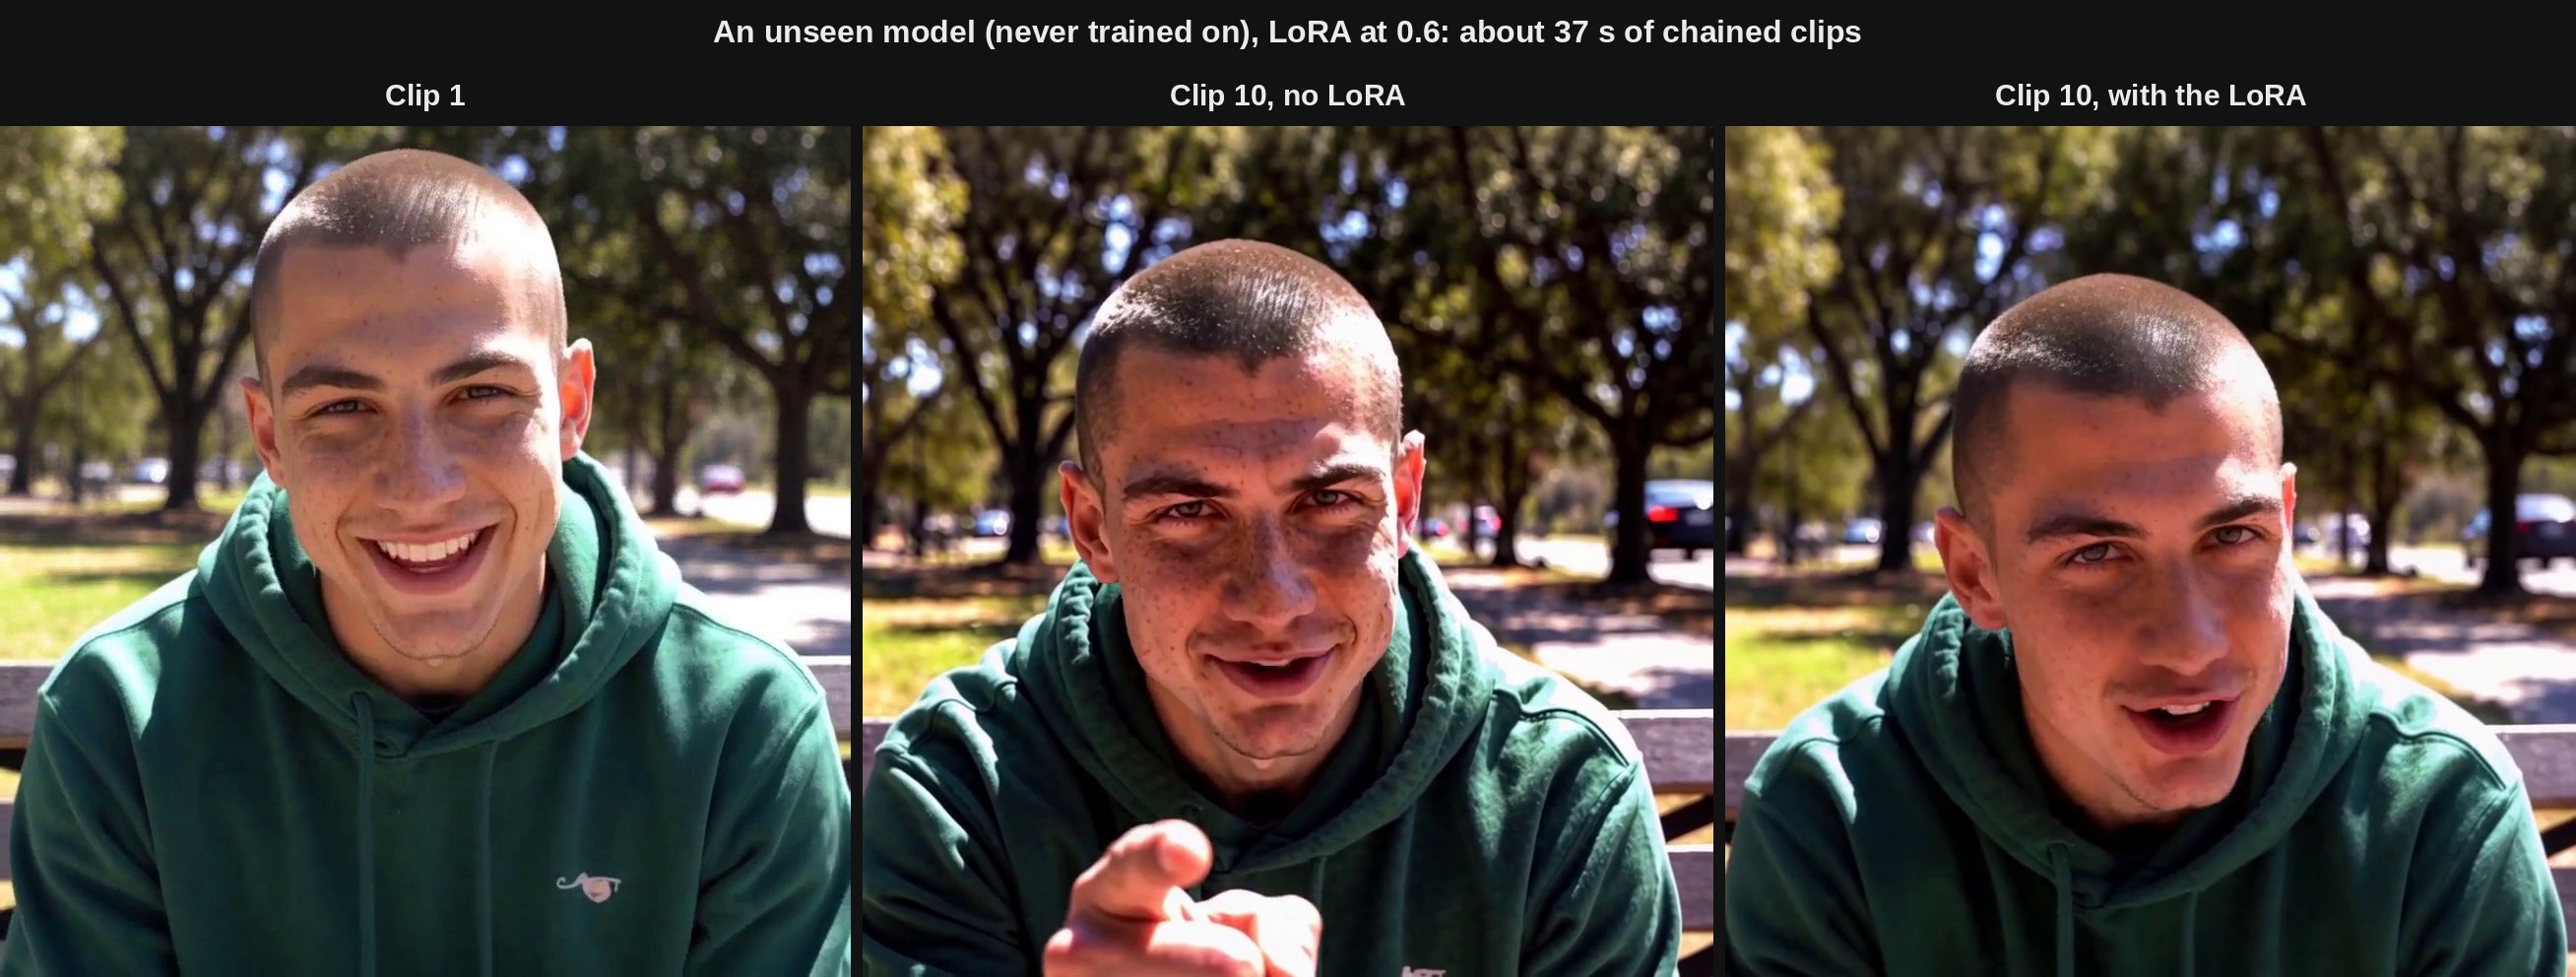
LoRAが一度もトレーニングしていないturbo。クリップ1、LoRAなしのクリップ10、0.6でLoRAを適用したクリップ10。このシーンでは顔の焼けが+51%から−4%になります。
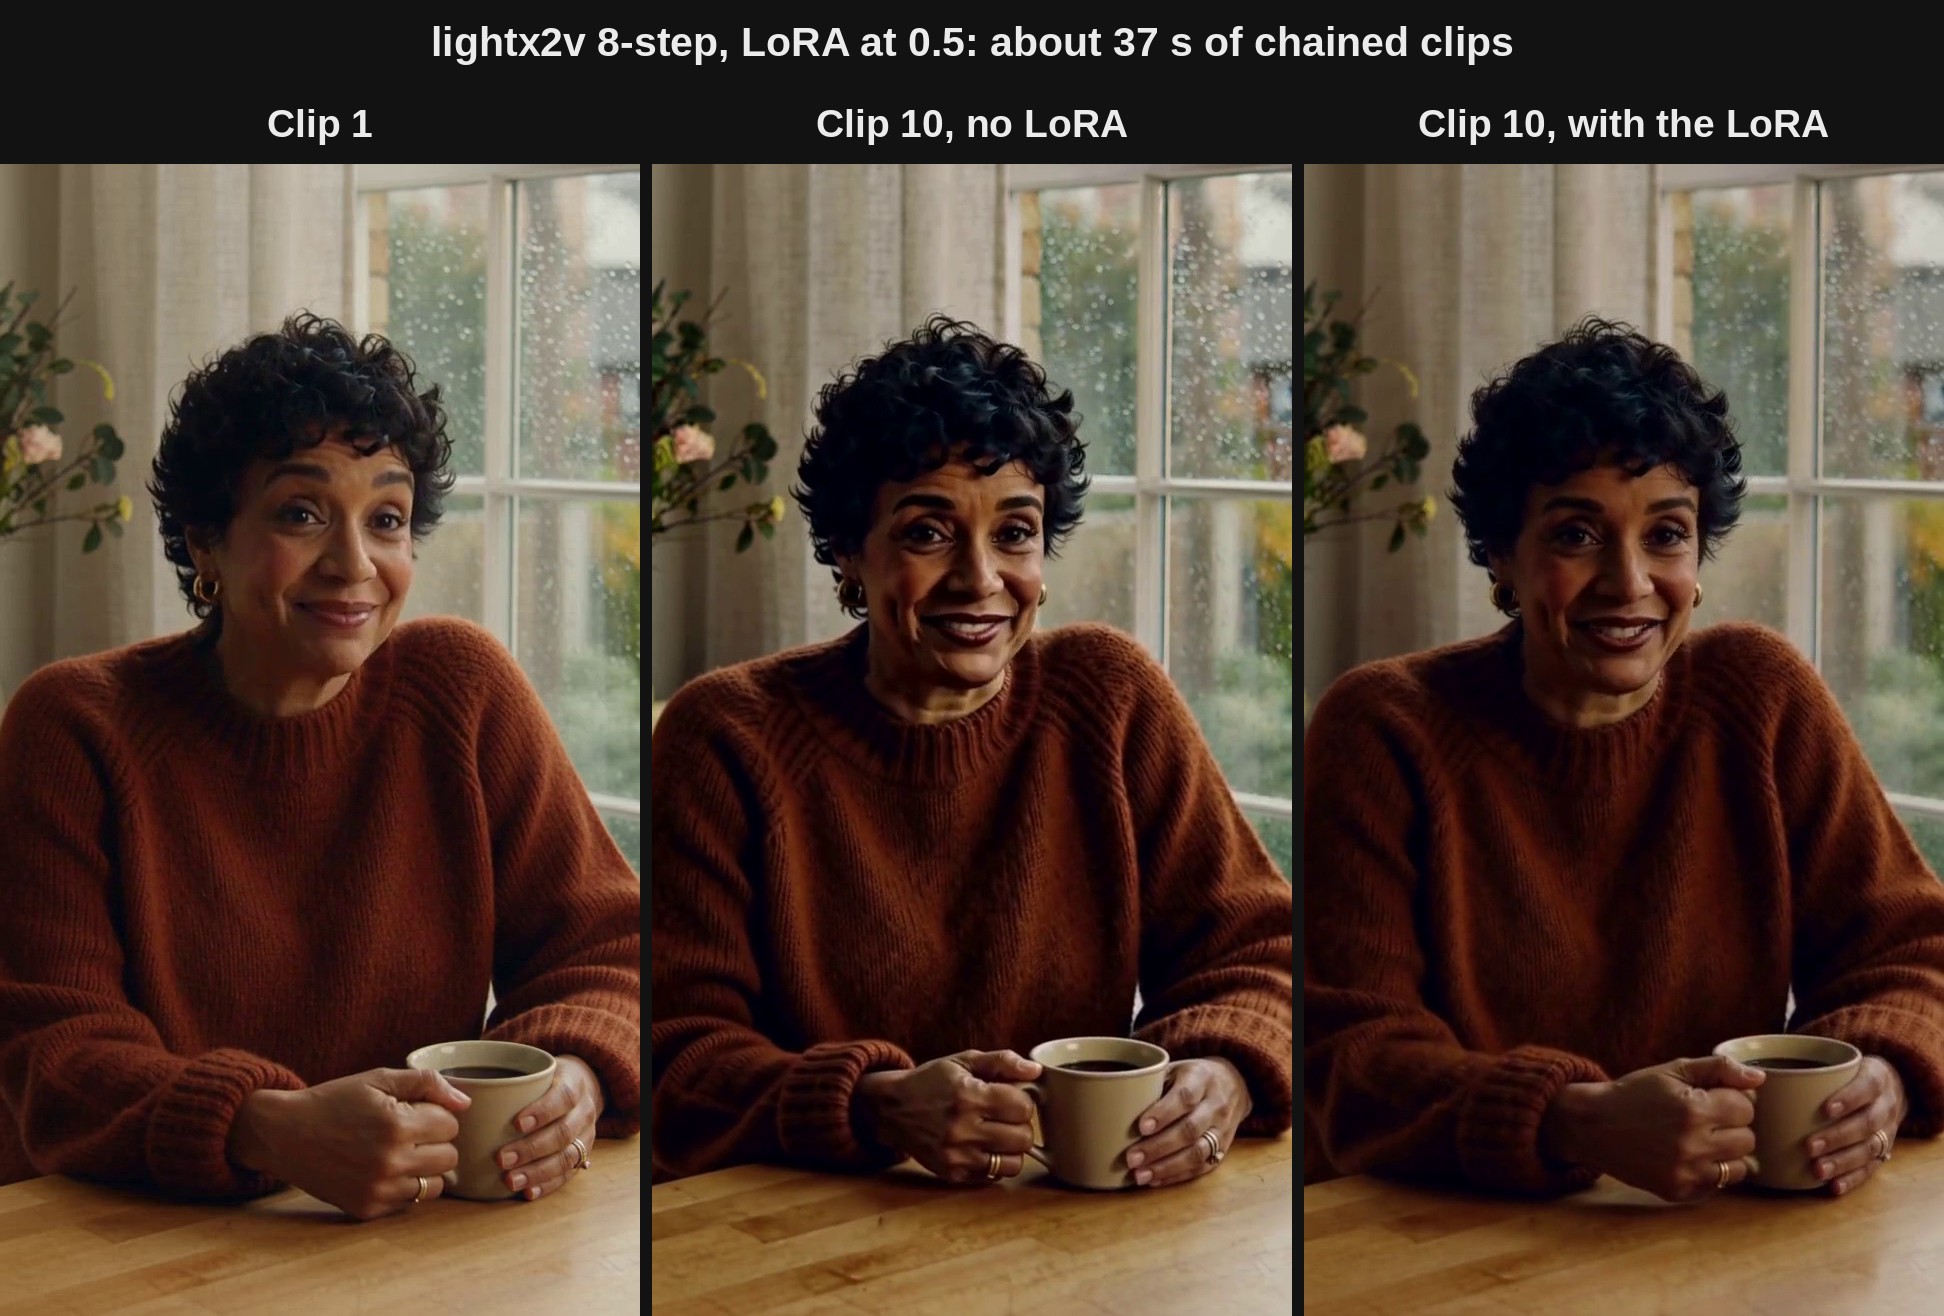
キッチンシーンでのlightx2v 8ステップ v1.0 768p: LoRAなしで+52%、0.5で適用して+6%。
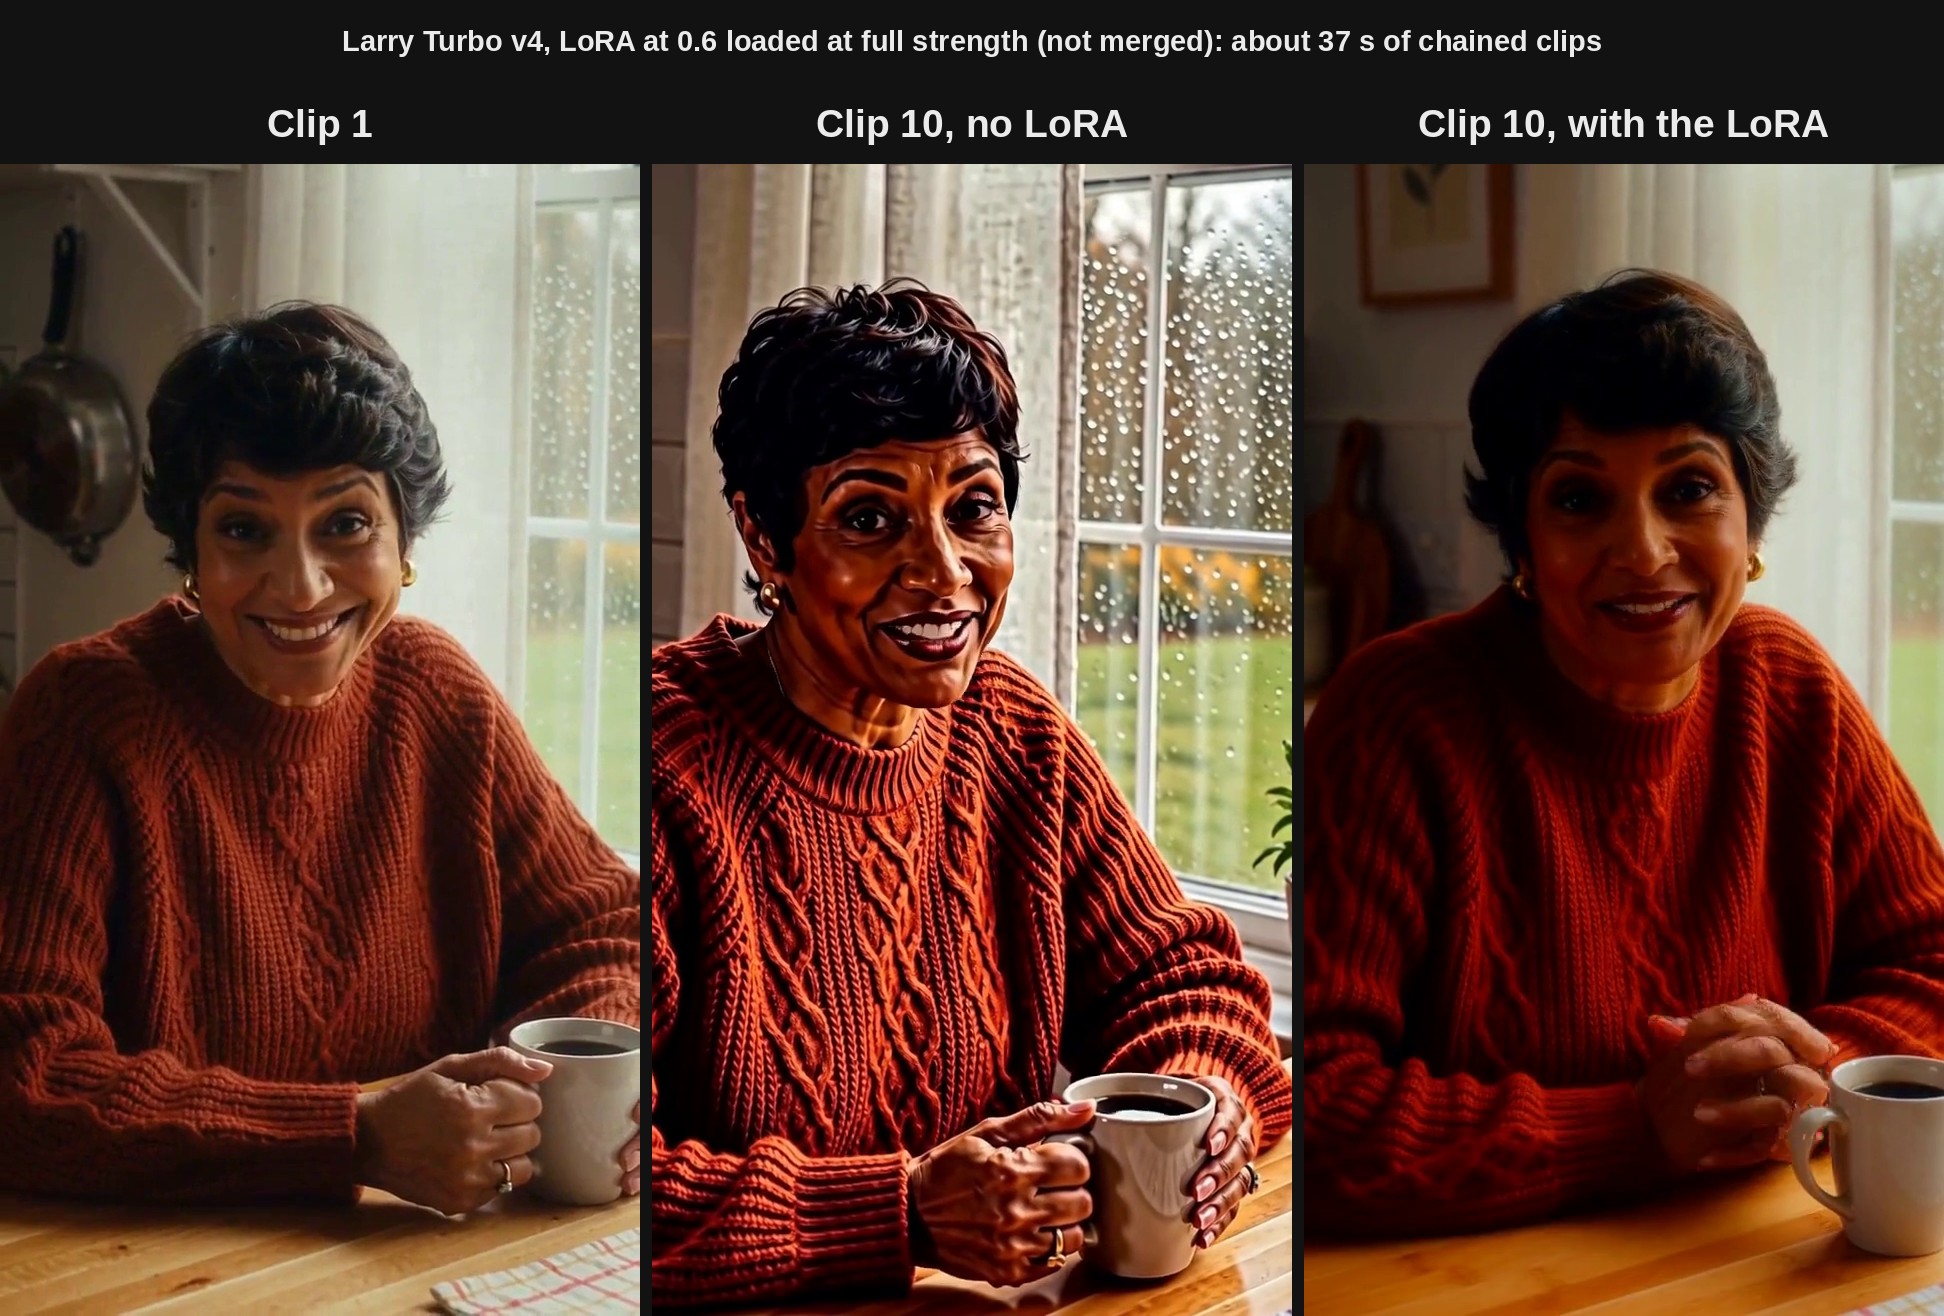
テストで最も焼けやすいLarry Turbo v4: LoRAなしで+189%、フル強度で読み込んだ0.6で−15%。Larryは依然として画像を柔らかくし、より暖かく暗い方向へドリフトします。
Larryはマージ構成では0.8より高い強度が必要です。1.0では顔の焼けは解消しましたが(−19%、2チェーン)、カメラのフレーミングが変わり始めました。マージせずフル強度で読み込んだ場合、0.6で+261%から−5%になりました。
彩度、肌の赤み、リップシンクはLoRAなしの場合と変わりません。細部はわずかに低下し、クリップ1より4〜14%低くなります(LoRAなしでは3〜18%高い)。強度が高すぎると、柔らかくワックスのような顔として現れます。
数値の裏側にある構成
- ComfyUIのint8 ConvRotでプルーニングされたComfy-Org/MiniMax-H3のMiniMax H3チェックポイントを使用。クリップ1は
fl2va、継続はref2vaを使用。 - LoRAはturbo LoRAの前に
LoraLoaderModelOnlyでマージ。 - 各継続は、前のクリップの最後の39フレームとその音声を保護されたマスク付きコンテキストとして引き継ぎます。
- 8ステップ、CFG 1、640×1152、1152×640、864×864。
その他のチェックポイント(bf16、fp8、GGUF)、他のステップ数、他の継続方法では異なる強度が必要になります。
制限事項
カードは適用範囲について率直に述べています。設定ごとに4シーンは小規模なテストであり、単一の10クリップチェーンでは±15ポイント変動することがあります。焼けを防ぎますが、すでに焼けてしまった動画を修復するものではありません。マスク付きコンテキストからの継続でのみテストされており、動画を延長する他の方法ではテストされていません。また、中距離から近距離に顔がある話者人物のみが対象です。
トレーニング方法
トレーニングは軌道自己蒸留です。作者は、各turboが新規の8ステップ生成で実際にどう振る舞うかを記録しました。合計150回のフルサイズ実行で、Larry、HyperFlow、lightx2vからそれぞれ50回ずつです。その後、LoRAは継続モードでトレーニングされ、同じ動画の冒頭を保護されたコンテキストとしてピン留めし、turbo自身の新規実行をターゲットとしました。これにより、継続はコンテキストにあったものを増幅するのではなく、新規生成のように見えることを学習します。合成による焼けやフレッシュノイズ損失は使用していません。これらを使用した以前のバージョンでは、すべてが柔らかくなっていました。
実行設定は300ステップ、rank 32、学習率1e-4、ネットワーク重み0.6、解像度864、124フレームで、単一のRTX PRO 6000上で行いました。
入手方法
アダプターはHugging Faceリポジトリのh3_antiburn_universal_v1.safetensorsです。416テンソル、bf16で、50個のDiTブロックと2個のtoken-refinerブロックのアテンション層とMLP層をカバーし、adaLNは含みません。ComfyUI/models/loras/に配置してください。トレーニングコード、設定、記録およびスコアリング用スクリプトは、ai-toolkitフォークのh3-antiburnブランチにあります。
コメント
GitHubでサインインしてディスカッションに参加しましょう。