SMD: 画像、動画、3D、MiniMax H3 向けの4ステップ蒸留
Simplified Matching Distillation は、少数ステップ拡散のための回帰のみのレシピです。その生徒モデルは FLUX、Qwen-Image、Wan2.1、MiniMax H3、3D をカバーし、H3 用の ComfyUI ワークフローも用意されています。
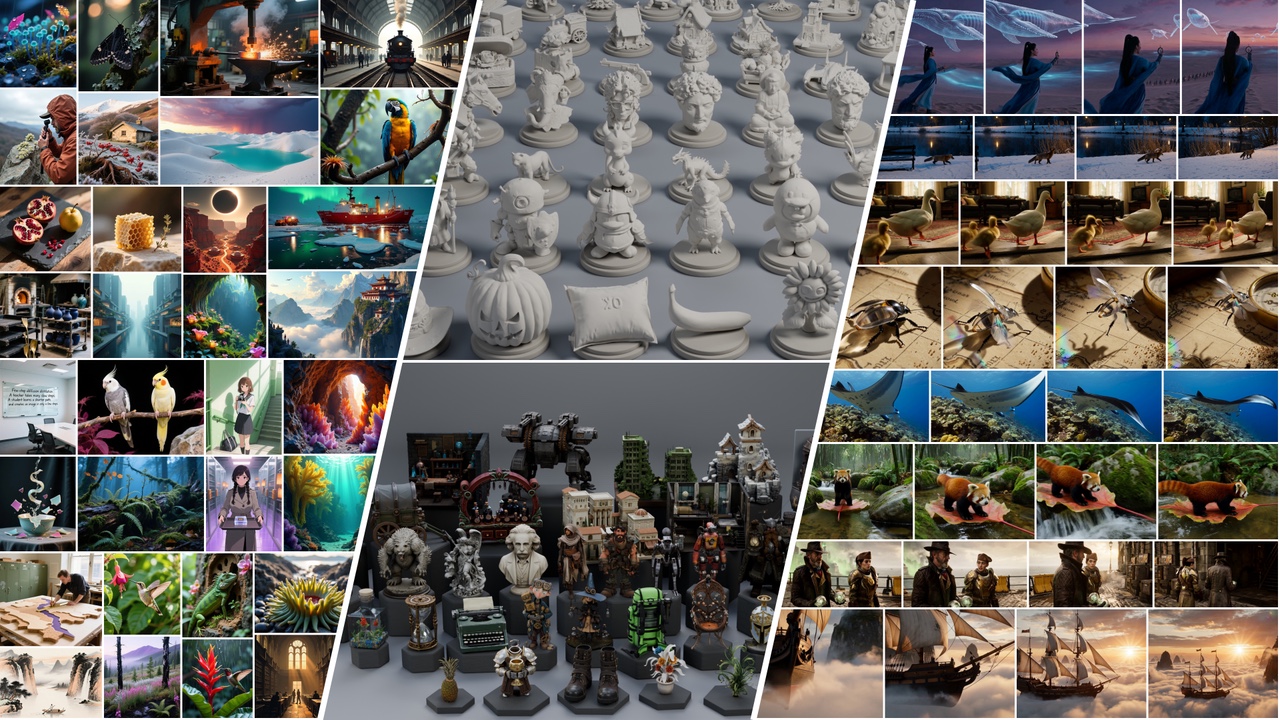
公開された SMD 生徒モデルの出力: 画像生成と編集、3D アセット、音声が同期した動画。
SMD が変えるもの
SMD は素朴なオンポリシー速度回帰から始まります。生徒モデルは教師サンプルではなく自身の軌跡でトレーニングされます。残りの方法を支えるのは2つの追加要素です。Pivot はトレーニング専用の残差プロキシで、教師が粗い遷移内で行う局所的な補正を、生徒自身の区間平均予測から切り離して保つため、4ステップの生徒モデルでも単独では表現できなかった教師の速度変動を表現できます。もう1つは、生徒モデルをより弱い教師予測から遠ざける反発項で、論文では望ましくないモードを避けるための軽量な方法と説明されています。
推論には何も追加されません。オンラインのスコア推定も、偽スコアモデルも、敵対的識別器もなく、デプロイされる生成器はそのアーキテクチャを維持します。これにより、同じ方法を既存のチェックポイント上の LoRA として、あるいは完全なデノイザーとして、同じリリースで提供できます。論文では 330億パラメータ までのスケーリングと、モデル横断、マルチ教師、因果的動画の蒸留への対応が報告されています。
公開されたもの
| タスク | 生徒モデル | 形式 |
|---|---|---|
| テキストから画像へ | FLUX.1-dev、Qwen-Image、SD3.5-Medium、FLUX.2 Klein 4B、Lens | LoRA、SD3.5 はさらに完全な transformer としても |
| 画像編集 | Qwen-Image-Edit-2511 | LoRA |
| テキストから動画へ | Wan2.1 1.3B、Wan2.1 14B、因果的 Wan2.1 1.3B | LoRA |
| 音声と動画 | MiniMax H3 T2VA 4ステップと8ステップ、H3 Ref2VA 4ステップと8ステップ | LoRA アダプタ |
| 画像から3Dへ | Hunyuan3D-2.1 Shape、TRELLIS.2 の形状とテクスチャ | 蒸留された各段階ごとの LoRA |
2つの派生ブランチは単一教師の蒸留を超えています。FLUX.2 9B は Klein 4B と Lens の両方の教師として使用され、SD3.5-Medium は self、clipscore、geneval、ocr、pickscore、multi の6つのバリアントで提供され、各スペシャリストは異なる報酬を最適化します。
コレクション内のすべてのリポジトリには、重みと、プロンプトまたは参照入力、シード、サンプリング設定を含む実例が付属しています。LoRA パッケージには対応するベースモデルとリビジョンが必要で、完全な transformer もエンコーダとデコーダをベースから取得します。
リリース全体の例
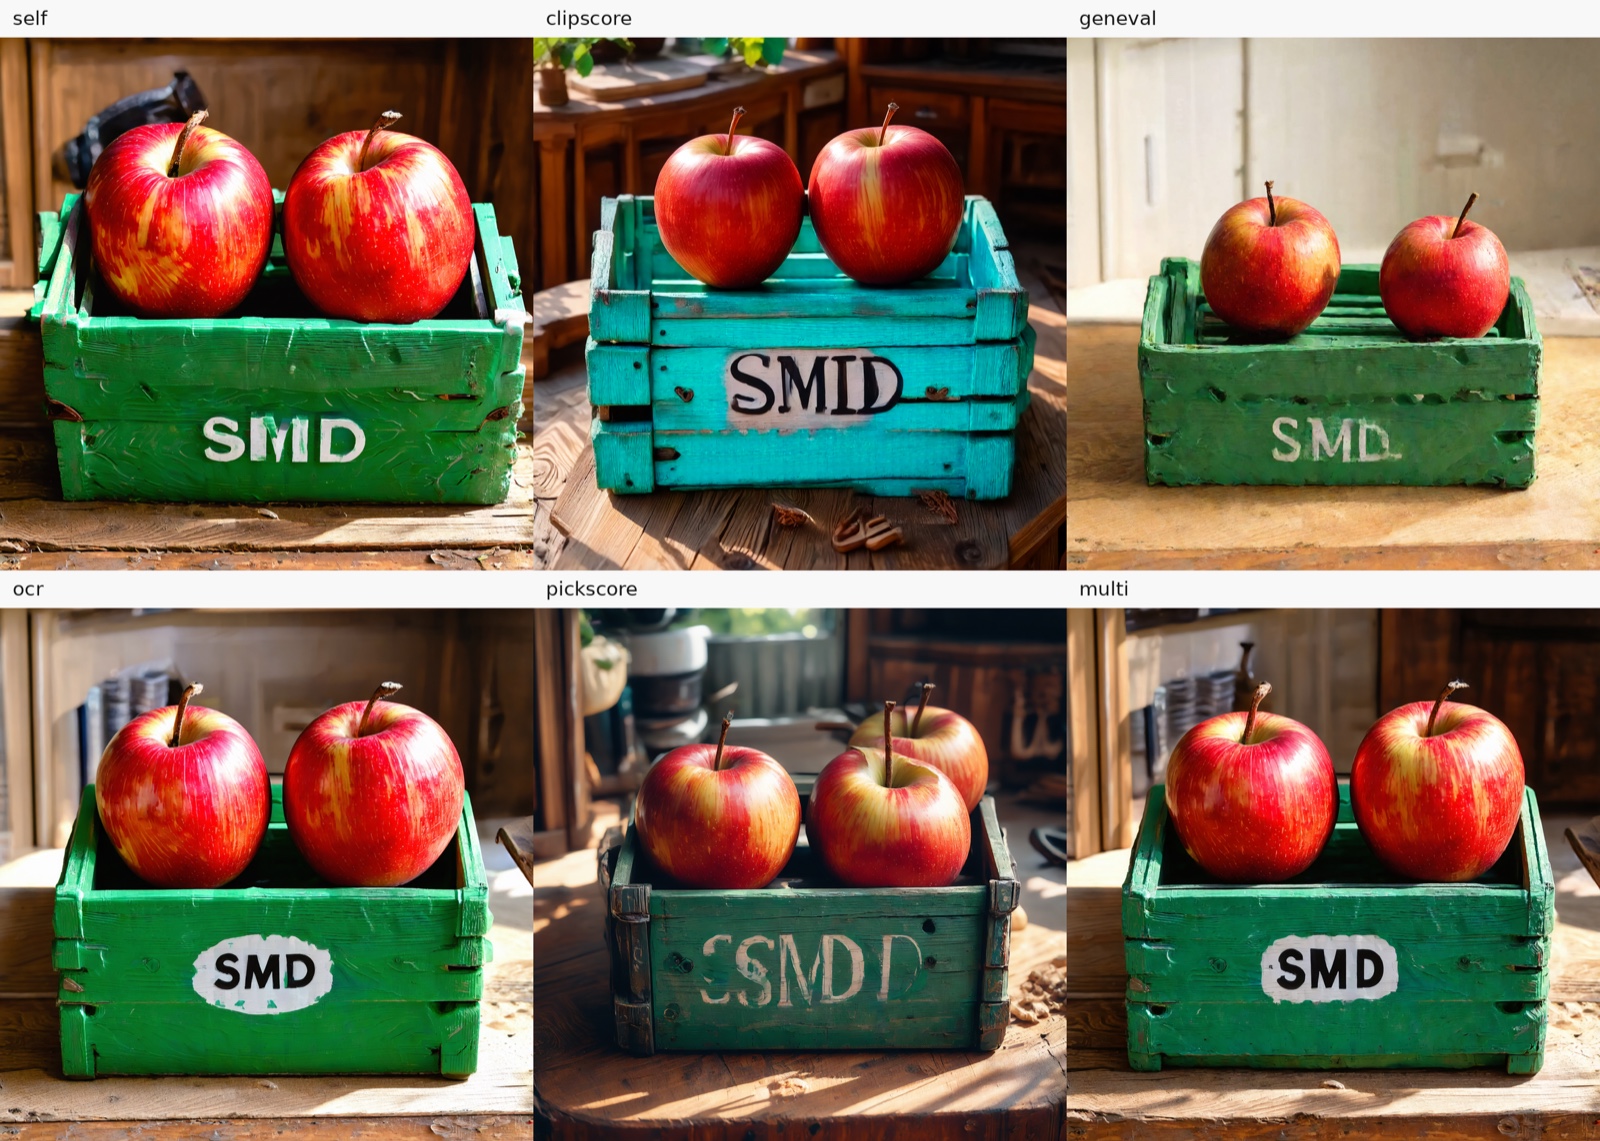
6つの SD3.5-Medium 生徒モデルを並べて比較。マルチ教師の multi バリアントも含みます。
画像の生徒モデルはそれぞれ4サンプリングステップを使用し、モデルカードにはそれらを生成した設定が示されています。FLUX.1-dev はキャンバストートバッグ、Qwen-Image はアフタヌーンティー、Qwen-Image-Edit-2511 はソースと編集後のペア、FLUX.2 Klein 4B と Lens は2教師の比較です。動画側は Wan2.1 14B と因果的 1.3B モデルで4ステップで動作し、3D 側は Hunyuan3D-2.1 Shape と TRELLIS.2 の両段階向けに4ステップ LoRA を提供し、それぞれにターンテーブル動画が付属しています。
ComfyUI での MiniMax H3
4つの H3 生徒モデルには、標準の ComfyUI ノード で動作する専用パッケージがあり、カスタムノードパックも SMD トレーニングリポジトリのチェックアウトも不要です。
| パッケージ | ステップ数 | 例のクリップ |
|---|---|---|
| SMD-MiniMax-H3-T2VA-4step-ComfyUI | 4 | テキストから音声と動画へ |
| SMD-MiniMax-H3-T2VA-8step-ComfyUI | 8 | テキストから音声と動画へ |
| SMD-MiniMax-H3-Ref2VA-4step-ComfyUI | 4 | 参照画像から音声と動画へ |
| SMD-MiniMax-H3-Ref2VA-8step-ComfyUI | 8 | 参照画像から音声と動画へ |
各パッケージには、変換済みの LoRA、完全なワークフロー、例の入力が含まれています。download_models.py はモデルファイルをチェックし、例の入力をコピーし、ワークフローを ComfyUI のデフォルトユーザーライブラリに追加するため、サイドバーの SMD の下に表示されます。ワークフローの JSON をキャンバスにドラッグすることもできます。参照条件付きのグラフは UNETLoader、LoraLoaderModelOnly、MiniMaxH3SigmaShift、MiniMaxH3ReferenceToVideo、ManualSigmas を使用するため、LoRA が処理を担い、サンプリングスケジュールはパッケージから取得されます。4ステップと8ステップを切り替えるには、対応するパッケージのワークフローと LoRA を開きます。
4ステップ Ref2VA パッケージによる5秒の H3 参照画像から音声と動画への生成。リポジトリに同梱された2枚の参照画像で生成されています。
パッケージは1つの落とし穴について警告しています。H3 の重みを ComfyUI のデフォルト画像テンプレートに代入すると audio_scale が不足しているエラーで失敗することがあるため、代わりにパッケージの完全なワークフローを使用してください。
独自の生徒モデルをトレーニングする
トレーニングコードは推論の例と同じリポジトリにあります。Linux x86_64 上で Conda を使って実行します。environments/setup_conda.sh は Python 3.12、PyTorch 2.7.1、CUDA 12.6 のホイールを含む環境を構築し、FlashAttention はソースからコンパイルされます。実行は、データパスを指定したトレーニング設定の1つに対する torchrun 呼び出しです。たとえば Qwen-Image 用に prompt 列を持つ Parquet ファイルを使い、2つの GPU で実行します。--download-resources は設定が必要とするものを取得します。
トレーニングはトレーニング基盤として NVIDIA FastGen を基に構築され、モデル実装には Hugging Face Diffusers を使用します。H3 のエクスポートパスはサンプリングメタデータ付きの LoRA アダプタを書き出すため、融合されたベースチェックポイントは不要です。リポジトリには、環境構築、トレーニング、推論、および新しいモデルのオンボーディング用のエージェントスキルも同梱されています。
制限
- ステップ数と品質の主張は著者自身によるものです。4 NFE で、SMD は強力な少数ステップベースラインを上回り、いくつかのベンチマークでマルチステップ教師を超えると報告されています。これらの数値は論文からのものであり、ここでの独立した再現によるものではありません。
- 蒸留された生徒モデルは、それぞれのパッケージ内のベースリビジョンとサンプリング設定に紐づいています。特に H3 の生徒モデルは、キャッシュされた条件を持つ LoRA アダプタです。
- トレーニングリポジトリは Conda と CUDA 12.6 対応の NVIDIA ドライバを備えた Linux を対象としています。3D の段階には2つ目の環境が必要です。
- 公開された生徒モデルのうち、2つの H3 参照条件付きパッケージがこれまでで最も多くダウンロードされています(執筆時点で約1,500と1,200)が、画像と3D のリポジトリはまだ1桁または2桁のままです。
入手方法
コード: zjwfufu/SMD
プロジェクトページ: zjwfufu.github.io/SMD-Page
論文: arXiv 2610.18472
重み: Hugging Face コレクション
データセット: zjwfufu/smd-data
H3 パッケージ: T2VA 4ステップ · T2VA 8ステップ · Ref2VA 4ステップ · Ref2VA 8ステップ
ベースモデル: MiniMax H3
コメント
GitHubでサインインしてディスカッションに参加しましょう。