LightVAE: WanとH3向けの高速な動画VAEデコード
ModelTCがLightVAEを公開。オリジナルの潜在インターフェースを維持したままWan2.1、Wan2.2、MiniMax-H3の動画VAEデコーダを圧縮し、ComfyUIで最大2.94倍高速化します。
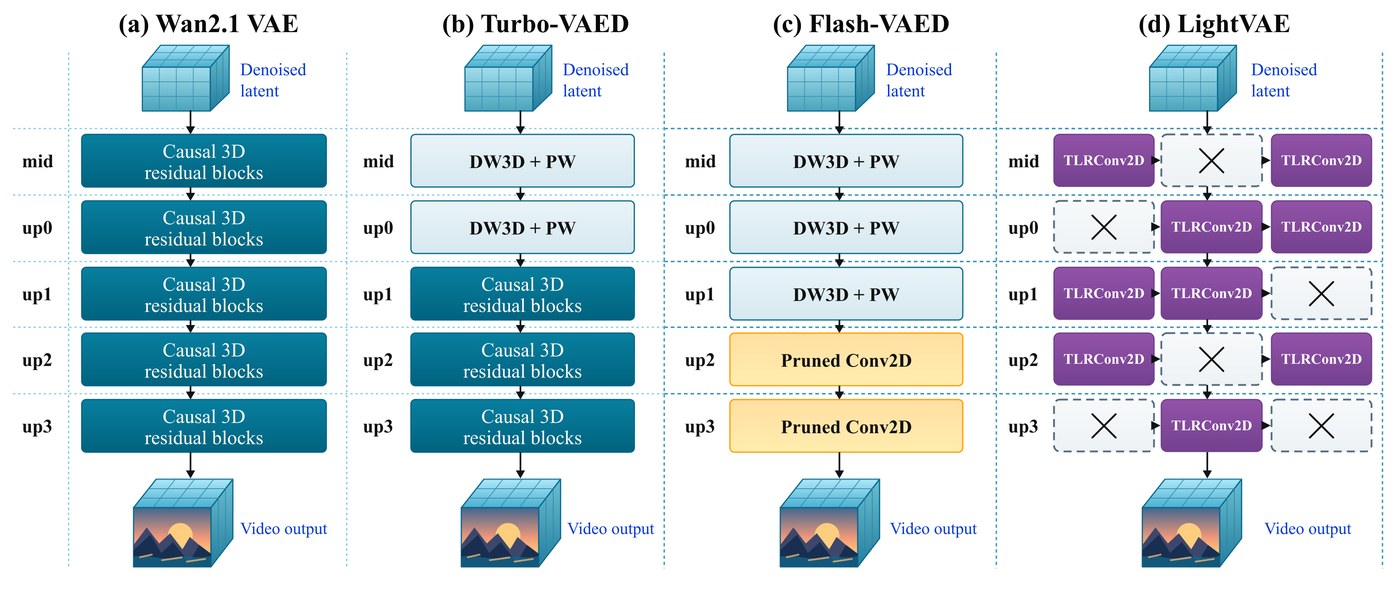
プロジェクトリポジトリより: Wan2.1 VAEと、Turbo-VAED、Flash-VAED、LightVAEの比較。
LightVAEが行うこと
動画VAEのデコードは動画生成のコストの大きな部分を占めます。潜在クリップは毎回数百フレームに戻す必要があるためです。LightVAEはデコーダの役割をそのままに、それを実行するネットワークを小さくします。
- LightVAE-Pro はオリジナルのデコーダと同じ深さで時間方向の低ランク畳み込みを使用するため、再構成の忠実度はオリジナルに近いままです。
- LightVAE-Lite はさらにブロックプルーニングを追加し、わずかな忠実度と引き換えにさらなる高速化を実現します。
- オリジナルの潜在インターフェース。 Wanモデルは独自の非圧縮エンコーダを維持するため、既存のワークフローはデコード側を差し替えるだけで済みます。MiniMax-H3にはプルーニング済みデコーダと、別途Liteエンコーダが用意されています。
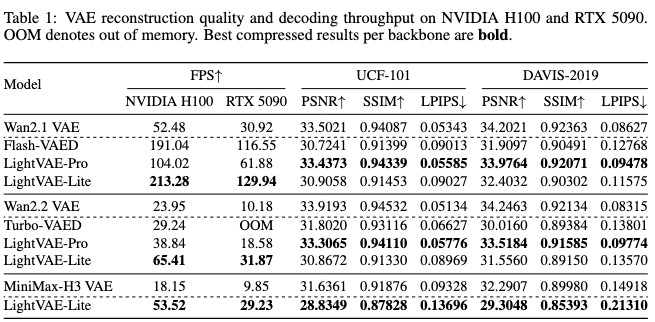
論文の表1: デコーダのスループットと再構成PSNRの比較。
デコード速度
著者らがComfyUI上、H200で768 x 1344、バッチサイズ1、Wanは125フレーム、H3は124フレーム、ウォームアップ1回と3回の実行の中央値で測定した結果です。
| バックボーン | オリジナルVAE | LightVAE-Pro | LightVAE-Lite |
|---|---|---|---|
| Wan2.1 | 6.844秒 / 18.26 FPS | 3.754秒 / 33.30 FPS (1.82倍) | 2.330秒 / 53.64 FPS (2.94倍) |
| Wan2.2 | 6.886秒 / 18.15 FPS | 4.420秒 / 28.28 FPS (1.56倍) | 2.999秒 / 41.68 FPS (2.30倍) |
| MiniMax-H3 | 6.303秒 / 19.67 FPS | 提供なし | 3.574秒 / 34.69 FPS (1.76倍) |
この測定はGPU同期されたVAE.decodeのみを対象としているため、生成全体ではなくデコードの高速化です。LightVAEは拡散モデルやテキストエンコーダのメモリコストを削減するものではありません。
チェックポイントの選択
| 生成モデル | LightVAEデコーダ | エンコーダ |
|---|---|---|
| Wan2.1 / Wan2.2 14B | lightvae-{pro,lite}-wan21-decoder-comfy.safetensors | オリジナルのWan2.1 VAE |
| Wan2.2 5B TI2V | lightvae-{pro,lite}-wan22-decoder-comfy.safetensors | オリジナルのWan2.2 VAE |
| MiniMax-H3 | lightvae-lite-h3-decoder-comfy.safetensors | lightvae-lite-h3-encoder-comfy.safetensors またはオリジナルのH3動画VAE |
Wan2.2 14BはWan2.1 VAE(16潜在チャンネル)を使用し、5BモデルはWan2.2 VAE(48チャンネル)を使用するため、自由に選べるわけではありません。WanのエンコーダとH3の音声VAEは、どの構成でも変更されません。
ComfyUIでの使用
python comfyui/install.py --comfy-root /path/to/ComfyUIでアダプタがComfyUI/custom_nodes/ComfyUI-LightVAE/にコピーされ、*-comfy.safetensorsの重みはComfyUI/models/vae/LightVAE/に配置します。ノードはLoad LightVAE (TLR)で、重要なのは、パッケージ化されたエクスポートがスタンダードなVAELoaderの経路ではなく、通常のLoad VAEを置き換えるという点です。
- オリジナルのLoad VAEノードを残し、LightVAEの
base_vaeに接続します。 - 使用するバックボーンに応じてProまたはLiteデコーダを選択し、
encoder = noneのままにします(Wan)。またはH3 Liteの両方のファイルを選択します。 - LightVAEの
VAE出力を、ワークフロー内のエンコードおよびデコードノードに接続します。
Wanではデコード側のみが変更され、参照条件付けはオリジナルのエンコーダを使い続けます。H3ではオプションのLiteエンコーダが参照エンコード経路とデコードの両方を置き換え、その構成ではオリジナルの動画VAEは不要です。両方の選択をnoneに設定すると、オリジナルのVAEが正確に復元されます。
リポジトリにはこのノード用の6つのフラットなワークフローが同梱されており、ComfyUI本体以外に必要なものはありません。
| ワークフロー | タスク | LightVAEコンポーネント |
|---|---|---|
wan21_t2v_lightvae.json | Wan2.1 1.3B テキストから動画、832x480、81フレーム | wan21 Pro / Liteデコーダ |
wan22_5b_t2v_lightvae.json | Wan2.2 5B テキストから動画、1280x704、121フレーム | wan22 Pro / Liteデコーダ |
wan22_5b_i2v_lightvae.json | Wan2.2 5B 画像から動画 | wan22 Pro / Liteデコーダ |
wan22_14b_i2v_lightvae.json | Wan2.2 14B 画像から動画、2エキスパート | wan21 Pro / Liteデコーダ |
h3_ref_image_lightvae.json | H3 参照画像から動画と音声、1344x768 | H3 Liteエンコーダ + デコーダ |
h3_ref_video_lightvae.json | H3 参照動画とサウンドトラックから動画と音声 | H3 Liteエンコーダ + デコーダ |
6つすべてはworkflowsディレクトリにもあります。
ハードウェアサポート
LightVAEはHopperに限定されません。NVIDIA BF16でTritonが利用可能な場合は融合カーネルを使用します。動作するTritonコンパイラがない場合やその他のPyTorchデバイスでは、TLR畳み込みは因数分解されたままPyTorchフォールバックで実行され、デバッグ用のCPU FP32経路も用意されています。H3の経路はWanのTritonカーネルではなくPyTorchの畳み込みとアテンションを使用しており、著者らは未検証のGPUファミリーでは速度を保証しないと述べています。このノードはPython 3.11のComfyUI e8665caで検証され、H3の完全な生成が1344x768、362フレーム、24 FPSで確認されています。
入手方法
重み: Hugging Faceのlightx2v/LightVAE。コード、ベンチマーク、ワークフロー: GitHubのModelTC/LightVAE。
コメント
GitHubでサインインしてディスカッションに参加しましょう。