Spark-H3: ブロックスパースアテンションでComfyUIのMiniMax-H3を高速化
Spark-H3はSpark-AttnブロックスパースアテンションをComfyUIのMiniMax-H3に導入します。RTX 40/50シリーズ向けのビルド済みノードを備え、10%密度で1.73倍高速なDiTを実現します。
プロジェクトリポジトリより: 同じプロンプト、シード、スケジュールをDenseアテンション、10%密度のSpark-H3、Sol-H3でレンダリングした結果。
Spark-Attnが変えるもの
ブロックスパースアテンションは、動画のアテンションパスを2つのブランチに分割します。上位にランクされたkey/valueブロックを完全に計算するexactブランチと、それ以外を低コストでカバーするcompressedブランチです。Spark-Attnはこの両方を再設計しており、Spark-H3はそのMiniMax-H3実装です。テクニカルブログは2026-09-23に公開され、最終更新日は2026-10-08です。
- Spark-Reblock は、固定の時空間タイルを適応的な分割に置き換えます。2つのクエリは、キーに対するアテンションスコアパターンが類似している場合に類似していると見なされ、これは反対側の二次モーメントに誘導されるマハラノビスコサイン距離で測定されます。階層的パーティショナーは、すべてのリーフがターゲットのブロックサイズを保持するまでグループの分割を繰り返します。
O(N log N)時間で動作するため、ブロックレイアウトは固定の近傍ではなく、入力、レイヤー、ヘッドに追従します。 - Spark-Reweight は、compressedブランチの平均プールされたkey/value要約を、重み付き要約とlog-massバイアスに置き換えます。アテンションは正規化の前にlogitsを指数化するため、平均プールはアテンションマスを過小評価します。つまり
E[exp(x)]の代わりにexp(E[x])を用いてしまいます。このバイアスが失われたマスを復元し、スコアリングではヘッドごとに1つのアンカーとして動画クエリの平均を使用するため、追加コストはリニアに保たれます。
両方のパートはそれぞれ個別に、10%のTop-Kバジェットで測定されています:
| アブレーション | アテンションマスの再現率 | PSNR | SSIM | LPIPS |
|---|---|---|---|---|
| 固定ブロック分割 | 68.66% | 18.61 | 0.68 | 0.26 |
| + Spark-Reblock | 81.54% | 22.41 | 0.80 | 0.14 |
そしてcompressedブランチについては:
| アブレーション | log-mass絶対エラー (nats) | PSNR | SSIM | LPIPS |
|---|---|---|---|---|
| 平均プール | 3.86 | 18.61 | 0.68 | 0.26 |
| + Spark-Reweight | 2.78 | 19.17 | 0.70 | 0.24 |
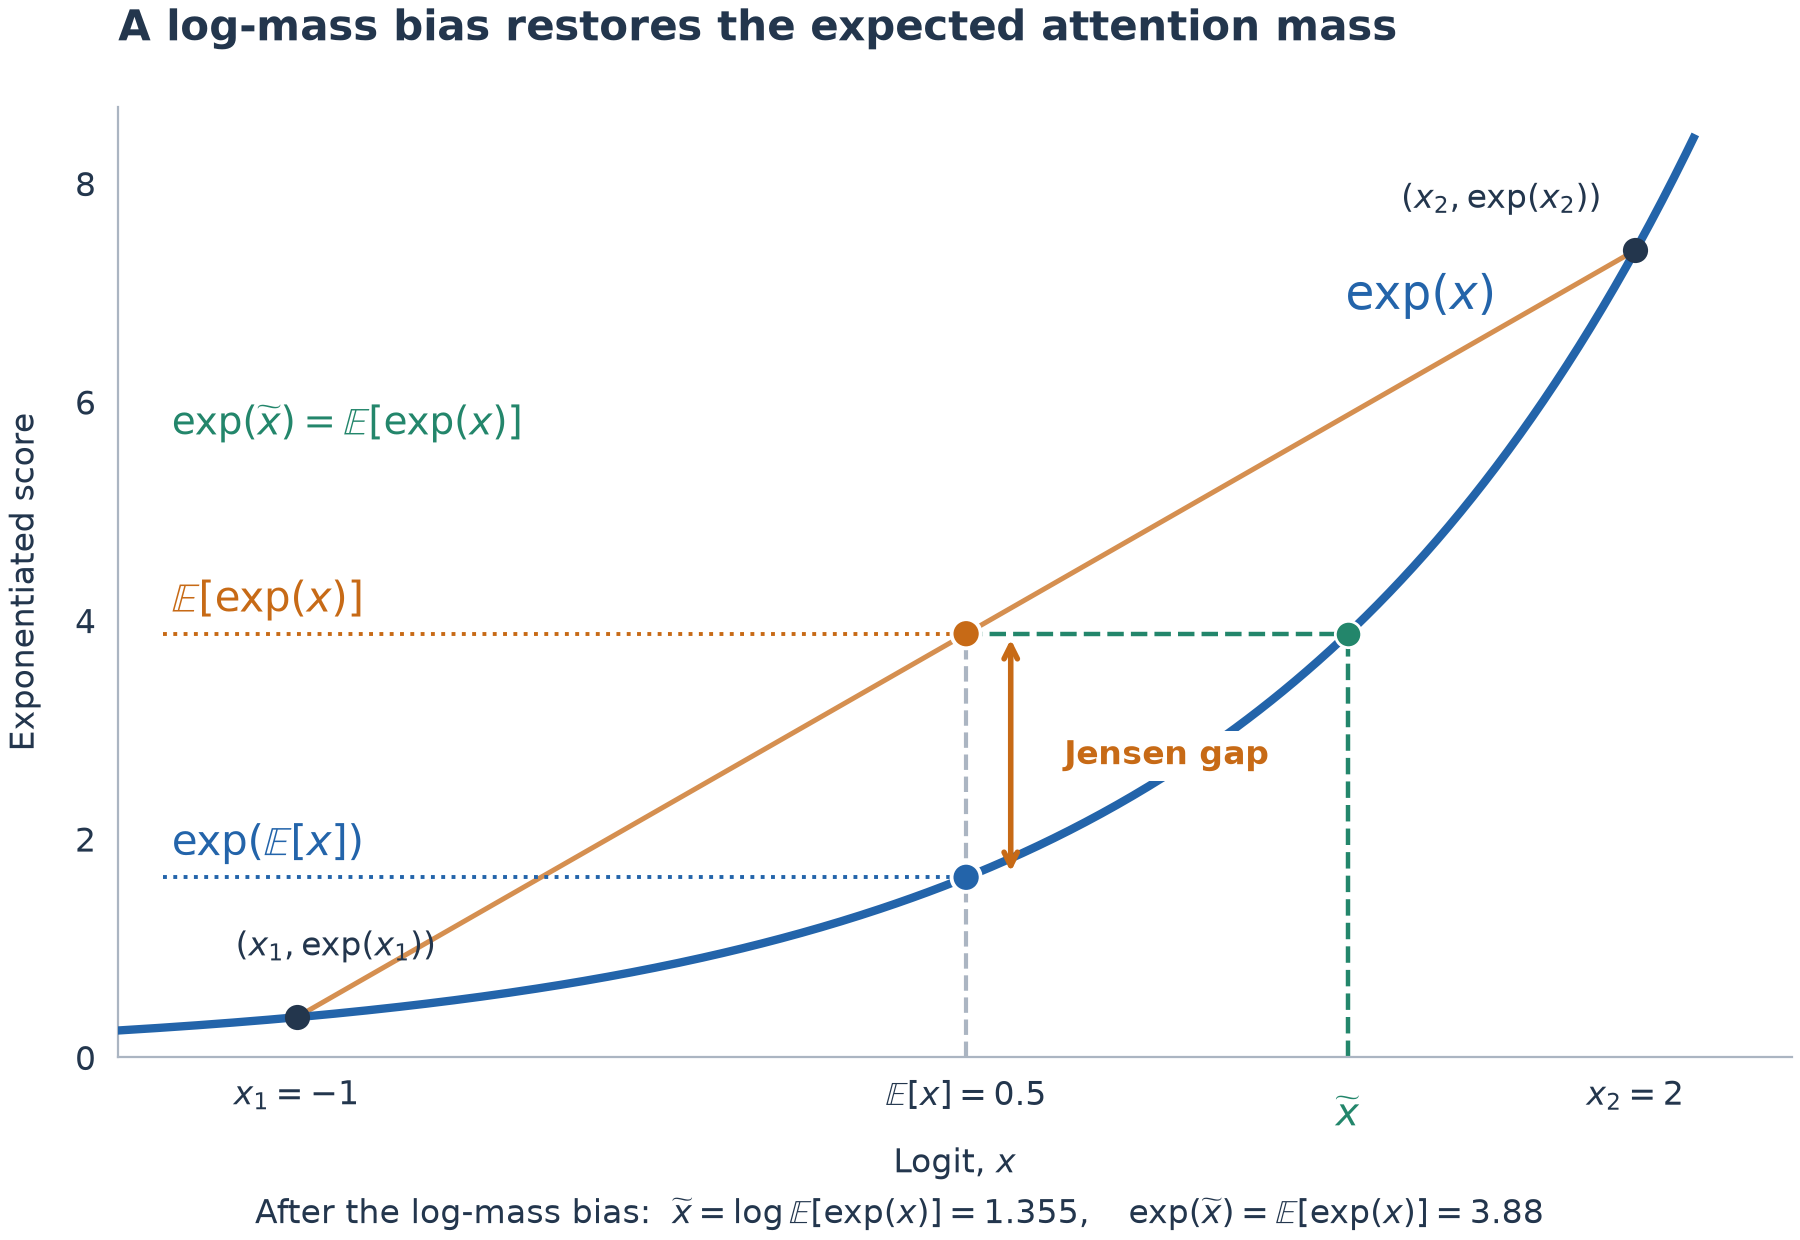
平均プールは青で示されるexp(E[x])を生成し、これはオレンジで示される期待値である指数E[exp(x)]を下回ります。緑の点はlog-massバイアス適用後の実効的なプール済みlogitで、その指数は期待値の指数と一致します。
ベンチマーク
比較数値は、単一のRTX PRO 6000 Blackwell上で、1344x768、24 fpsで240フレーム、19ステップのMiniMax-H3スケジュールという条件でVBenchプロンプトを使用しています。ここに示すすべてのスパース手法は20%のDenseウォームアップを共有し、最初のTransformerレイヤーは常にDenseのまま保持され、同じプロンプトとシードによるDense出力と比較されます。
| 方法 | 密度 | DiTレイテンシ | DiT高速化 | PSNR | SSIM | LPIPS | ATTN高速化 |
|---|---|---|---|---|---|---|---|
| Dense | 100% | 583.3 s | 1.00x | 参照 | 1.00 | 0.00 | 1.00x |
| Sol-H3 | 動的 | 355.4 s | 1.64x | 20.36 | 0.71 | 0.20 | 2.19x |
| Spark-H3, Speed | 10% | 337.4 s | 1.73x | 23.30 | 0.80 | 0.14 | 2.33x |
| Spark-H3, Balanced | 20% | 371.1 s | 1.57x | 25.38 | 0.85 | 0.09 | 1.96x |
| Spark-H3, Fidelity | 30% | 404.1 s | 1.44x | 27.07 | 0.88 | 0.07 | 1.76x |
| Spark-H3-Lite, Speed | 10% | 330.2 s | 1.77x | 23.34 | 0.80 | 0.14 | N/A |
10%密度において、Spark-H3はSol-H3比で2.94 dBのPSNRを獲得しつつ、わずかに高速に動作します。密度を上げると、速度と引き換えに忠実度が単調に向上します。Spark-H3-Liteはより低コストなバリアントで、20%と30%においてわずかな忠実度の低下と引き換えにreblockingレイテンシを半減させます。VBenchの各評価項目では、すべてのSpark-H3バリアントが被写体と背景の一貫性、モーションの滑らかさ、画質、美的品質においてDenseと約0.3ポイント以内に収まっています。
ComfyUIノード
このパッケージは、ComfyUI自身のMiniMax-H3実装向けに2つのアテンションノードを追加します: MiniMax H3 Spark Attention (SM89) と MiniMax H3 Spark Attention (SM120) です。いずれか1つをモデルローダーとBasicGuiderの間のMODELワイヤーに接続し、モデルごとに適用するアテンションパッチは1つだけにしてください。グラフ内のそれ以外は変更されないため、サンプルで使用しているコミュニティLoRAと併用できます。
| 要件 | 値 |
|---|---|
| ComfyUI | 0.38.x または 0.39.x |
| Python | 3.12+ |
| PyTorch / CUDA | CUDA 13.0、BF16 |
| OS | Linux または Windows x86_64 |
| SM89 | GeForce RTX 40シリーズ |
| SM120 | GeForce RTX 50シリーズ、RTX PRO 5000 / 6000 Blackwell |
インストーラーは、お使いのComfyUIに合ったバックエンドを選択します: 0.38.xではcomfy-kitchen 0.2.36、0.39.xでは0.2.37です。リリースv0.1.2では検証済みのWindowsパッケージが追加され、同梱のワークフローとインストールドキュメントが更新されました。CUDA 12.8はソースビルドのパスからのみ利用できます。モデルファイルは引き続きComfy-Org MiniMax-H3リポジトリから入手でき、ComfyUIガイドでは中国語のインストールガイドもリンクされています。
同じRTX PRO 6000 Blackwell上で、1344x768・14.4秒のクリップをComfyUIでエンドツーエンドで処理した場合:
| バリアント | Dense | Fidelity (20%、ウォームアップあり) | Speed (20%、ウォームアップなし) |
|---|---|---|---|
| MiniMax-H3、20ステップ | 1018.5 s | 461.7 s · 2.21x | 323.3 s · 3.15x |
| MiniMax-H3 + LightX2V 8ステップ | 408.0 s | 199.5 s · 2.05x | 129.6 s · 3.15x |
1つのクリップでDense、Fidelity、Speedのアテンションを比較したもの。ComfyUIのネイティブMiniMax-H3ワークフローで生成。プロンプトはVideo DeltaNetのプロンプトセットから取得しています。
ワークフロー
このリリースには5つのサンプルワークフローが同梱されており、いずれもtopk_mode=topk_ratioとreblock_layout=q_reuse_kに固定されています。native、LightX2V、Larryvrh、DMADの各サンプルはtopk_ratio=0.2を使用し、LBH two-passのサンプルはDiffusersのh3_lbhパスに合わせて0.1を使用します。
| サンプル | 構成 |
|---|---|
| Native MiniMax-H3 | コアサンプル: 20ステップ、LoRAなし、追加ノードなし |
| LightX2V 8ステップLoRA | models/lorasにLightX2V Turbo LoRAが必要 |
| Larryvrh 8ステップLoRA | 変換済みLoRAが必要。ComfyUI標準のLoraLoaderModelOnlyで読み込み可能 |
| DMAD 4ステップLoRA | DMAD re-noiseサンプラーを使用 |
| LBH two-pass + LightX2V 4ステップ | 公式のLBHアップスケーラーノードとその潜在アップスケーラーモデルが必要 |
このパッケージが追加のLoRAを無断でインストールすることはありません。それらはmodels/lorasに置かれ、導入するかどうかはユーザーの判断です。Larryvrhの重み用の変換スクリプトは、208個のバックボーンLoRAを保持し、51個のAdaLN更新をプルーニング済みモデルの8次元タイムステップカーブに射影します。
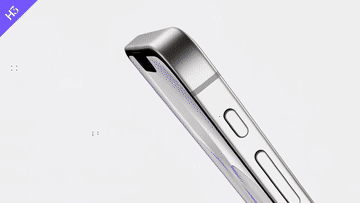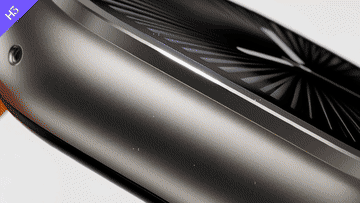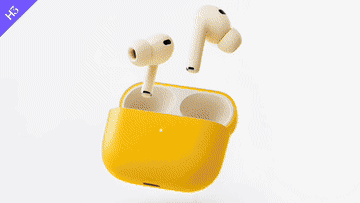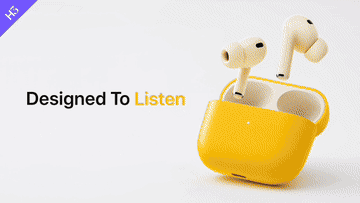
Spark-H3バックエンドでレンダリングされたミニマルな製品広告プロンプト。プロジェクトリポジトリのサンプルセットより。
入手先
Spark-H3はgithub.com/zechengtang/Spark-H3にあり、コードのみのミラーがAazeus/Spark-H3、解説記事がzechengtang.github.io/Spark-H3にあります。これはcheckpointではなく推論バックエンドであるため、モデルの重みは再配布されず、Spark-H3は既存のH3 LoRAと組み合わせることができます。プロジェクトのロードマップでは、SM120の検証が進行中、comfy-kitchen依存のない単体リリースとSM90・SM100向けカーネルが計画中、テクニカルレポートは未公開とされています。最初のComfyUIリリースも日が浅いため、パッケージングやルーティングの詳細は今後も変わる可能性があります。
MiniMax-H3でVeda sparse attentionをすでに試したことがあるなら、ブログにはSpark-Attn、Sol-Attn、Veda、および通常のブロックスパースアテンションの違いに関する議論が含まれています。VedaはTop-K選択用のスコアラーを学習し、Sol-Attnはコンテンツ適応型の閾値を使用し、Spark-Attnはブロックレイアウトと未選択ブロックの扱いを変更します。
コメント
GitHubでサインインしてディスカッションに参加しましょう。