H3 Person Remover LoRA:動画から人物を削除する
Akatz LabsのPerson Remover LoRAはSAM 3.1で人物を追跡し、マスクを緑で塗りつぶして重複ウィンドウで背景を再構築します。すぐに使えるComfyUIワークフロー付きです。
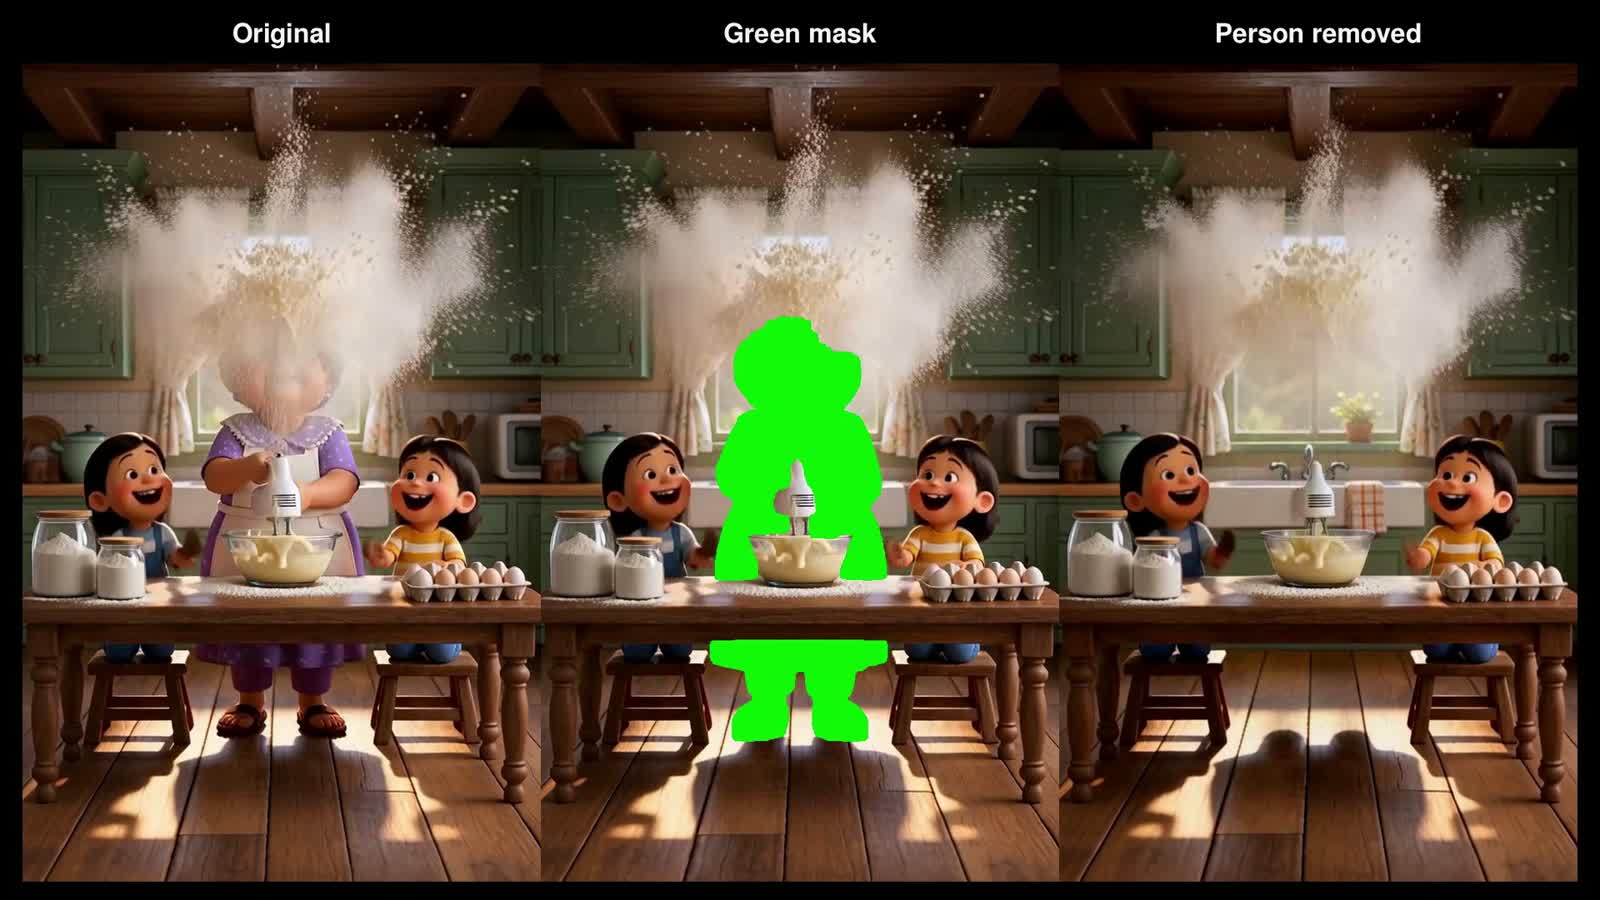
8例のショーケースより: オリジナルクリップ、緑マスク、再構築された背景。
作者によるビフォーアフターのショーケース。幅1280ピクセルで再エンコードされています。
アダプターが行うこと、行わないこと
このLoRAは人物のセグメンテーションを行わず、クリーンな背景を単独で生成することもありません。SAM 3.1はman in gray shirtのようなテキスト記述から追跡マスクを提供しますが、人物がすでに消えている動画の最初のフレームのクリーンなバージョンは、画像編集ソフトか画像編集モデルから別途用意する必要があります。そこからはウィンドウリロールのワークフローが残りを処理します。緑マスク済みのフレームが入力され、H3が覆われた領域を再生成し、再構築された境界フレームが次のウィンドウへの継続を担います。
デフォルトの削除プロンプト:
Remove the green-masked person and reconstruct the background. Preserve the rest of the video, including its camera motion and frame timing.
ウィンドウリロールの数値設定
このワークフローは汎用的ではなく調整済みで、記録された設定はコピーする価値があります。
| 設定 | 値 |
|---|---|
| スケジューラ | beta / simple |
| CFG | 1 |
| ビデオ / 音声のシグマシフト | 12 / 3 |
| マスク拡張 | 5ピクセル |
| フレームレート | 24 fps |
| シード | 904234 |
TurboやVFXのLoRAは不要です。このワークフローは17n + 5形式のH3フレーム長(22、39、56、73 ...)を使用し、22フレームから開始することを推奨しています。ウィンドウを長くするとメモリ消費が増える一方で、結果が自動的に良くなるわけではないためです。各継続は生成された境界フレームを次の参照として使用し、18フレームの生成済みビデオと音声の履歴を引き継ぎます。リレーは重複部分を削除し、結果をソースのフレーム数に合わせてトリミングします。出力はデフォルトで無音です。サウンドトラックを保持するには、ビデオコンポーネントの取得からのオリジナル音声を最後の動画を作成ノードに接続します。
入力要件は具体的です。24 fpsの動画、幅と高さが32で割り切れること、理想的には約5秒の短い連続ショットです。
トレーニング記録
V1はpruned Ref2VAモデル上のrank-16アダプターで、静的な5フレームペアと保存正則化による最初の250回の更新の後、2,000回のオプティマイザ更新でトレーニングされています。
| 設定 | 記録値 |
|---|---|
| アーキテクチャ | minimax_h3_ref2va、pruned |
| ランク / アルファ | 16 / 16、adaln_projを除く |
| テンソル | BF16、208のアダプターターゲットにまたがる416テンソル |
| オプティマイザ / 学習率 | AdamW8bit / 5e-5 |
| テキストエンコーダ | NVFP4 Qwen3VL |
| タスク / 正則化の解像度 | 1152 / 256、アスペクト比バケット |
| タスクのフレーム長 | 5、56、73、90、124(24 fps) |
| 正則化の長さ | 24 fpsで107フレーム、音声付き |
| ランタイム | AI Toolkit 0.13.23と、記録済みのaligned-video-guideパッチ |
混合フェーズのトレーニングプールには、128の静的ペア、20シーンからの80の動くマスク抜粋、6つの保存クリップが含まれます。データセットカードには構築、分割、レビューステータスが記載されており、training/には設定、スケジュール、モデルハッシュ、ランタイムパッチが含まれています。
制限事項
Akatz Labsは、まだ失敗する点について率直に述べています。
- H3はシーン全体を再生成するため、トレーニングペアがマスク外のピクセルを保持していても、マスクされていない領域はオリジナルにピクセル単位で固定されません。
- 見落とされた手、髪の輪郭、影、反射、遮蔽された身体部位が残ることがあり、マスクを大きくするほどモデルはより多くの背景を創作する必要があります。
- クリーンな最初のフレームの品質が低いと後続のウィンドウに伝播し、強いカメラモーションやハードカットは連続性を壊す可能性があります。
- ウィンドウをリロールするとその継続が変わるため、再構築された後続部分も確認する必要があります。
- 記録されたデータセット受け入れフラグはfalseのままです。技術的なチェックを通過することは、すべての例に対する人間の承認と同じではありません。
入手方法
このワークフローには、ネイティブのMiniMax H3とSAM 3.1をサポートする現在のComfyUI、およびmodels/loras/内のH3-Person-Remover-V1.safetensorsが必要です。公開されたワークフローは、H3 ref2va pruned INT8 ConvRot transformer、NVFP4 Qwen3VLテキストエンコーダ、H3のビデオVAEと音声VAE、およびSAM 3.1 multiplexを固定しています。以前の検証はRTX 4090とComfyUI 0.37.0で実行され、作者はこれを最小仕様ではなくテスト済み構成と説明しています。H3 Relayは、このワークフローが使用するウィンドウプレビューとリロールコントロールを提供します。
コメント
GitHubでサインインしてディスカッションに参加しましょう。