Qwen-Image 2.1 Restore LoRA: 元の構図を保つアップスケール
Qwen-Image 2.1 向けのコミュニティ製 LoRA は、復元または拡大した写真を元のフレームに保ちます。LoRA なしでは 2.2 px ずれるのに対し 0.3 px の誤差に収まり、ComfyUI ワークフローと 2 つのチェックポイントも用意されています。
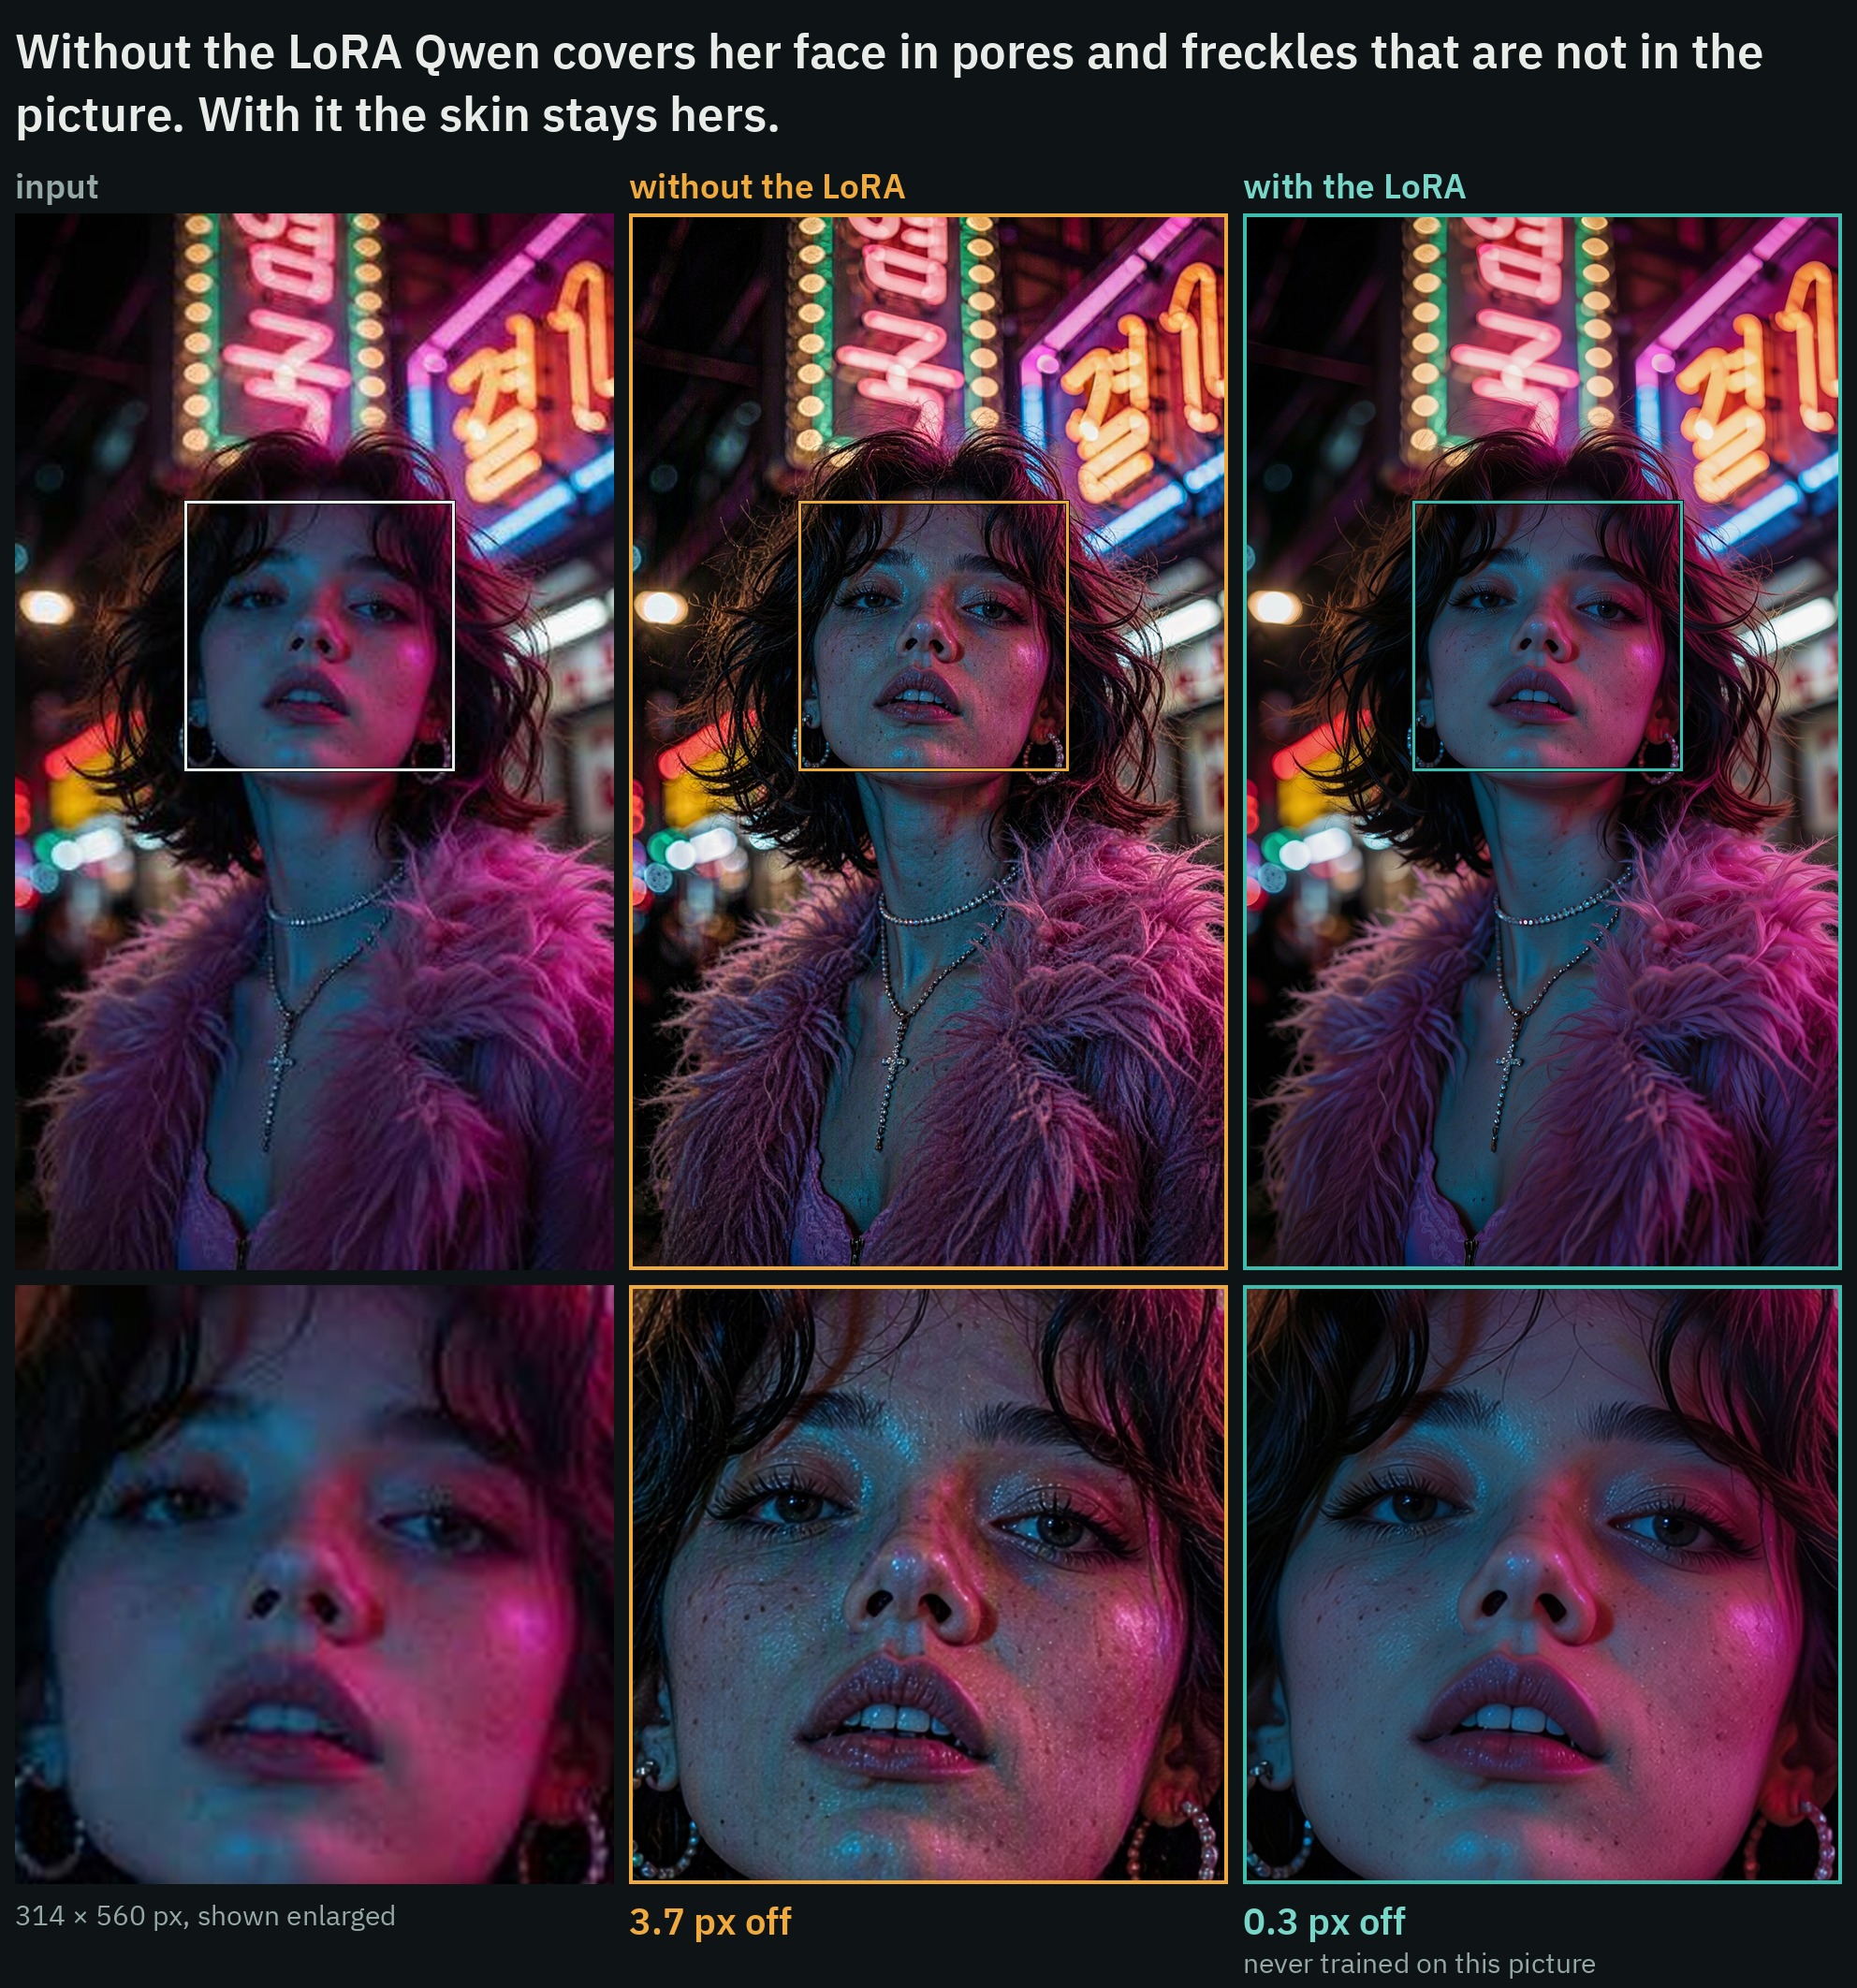
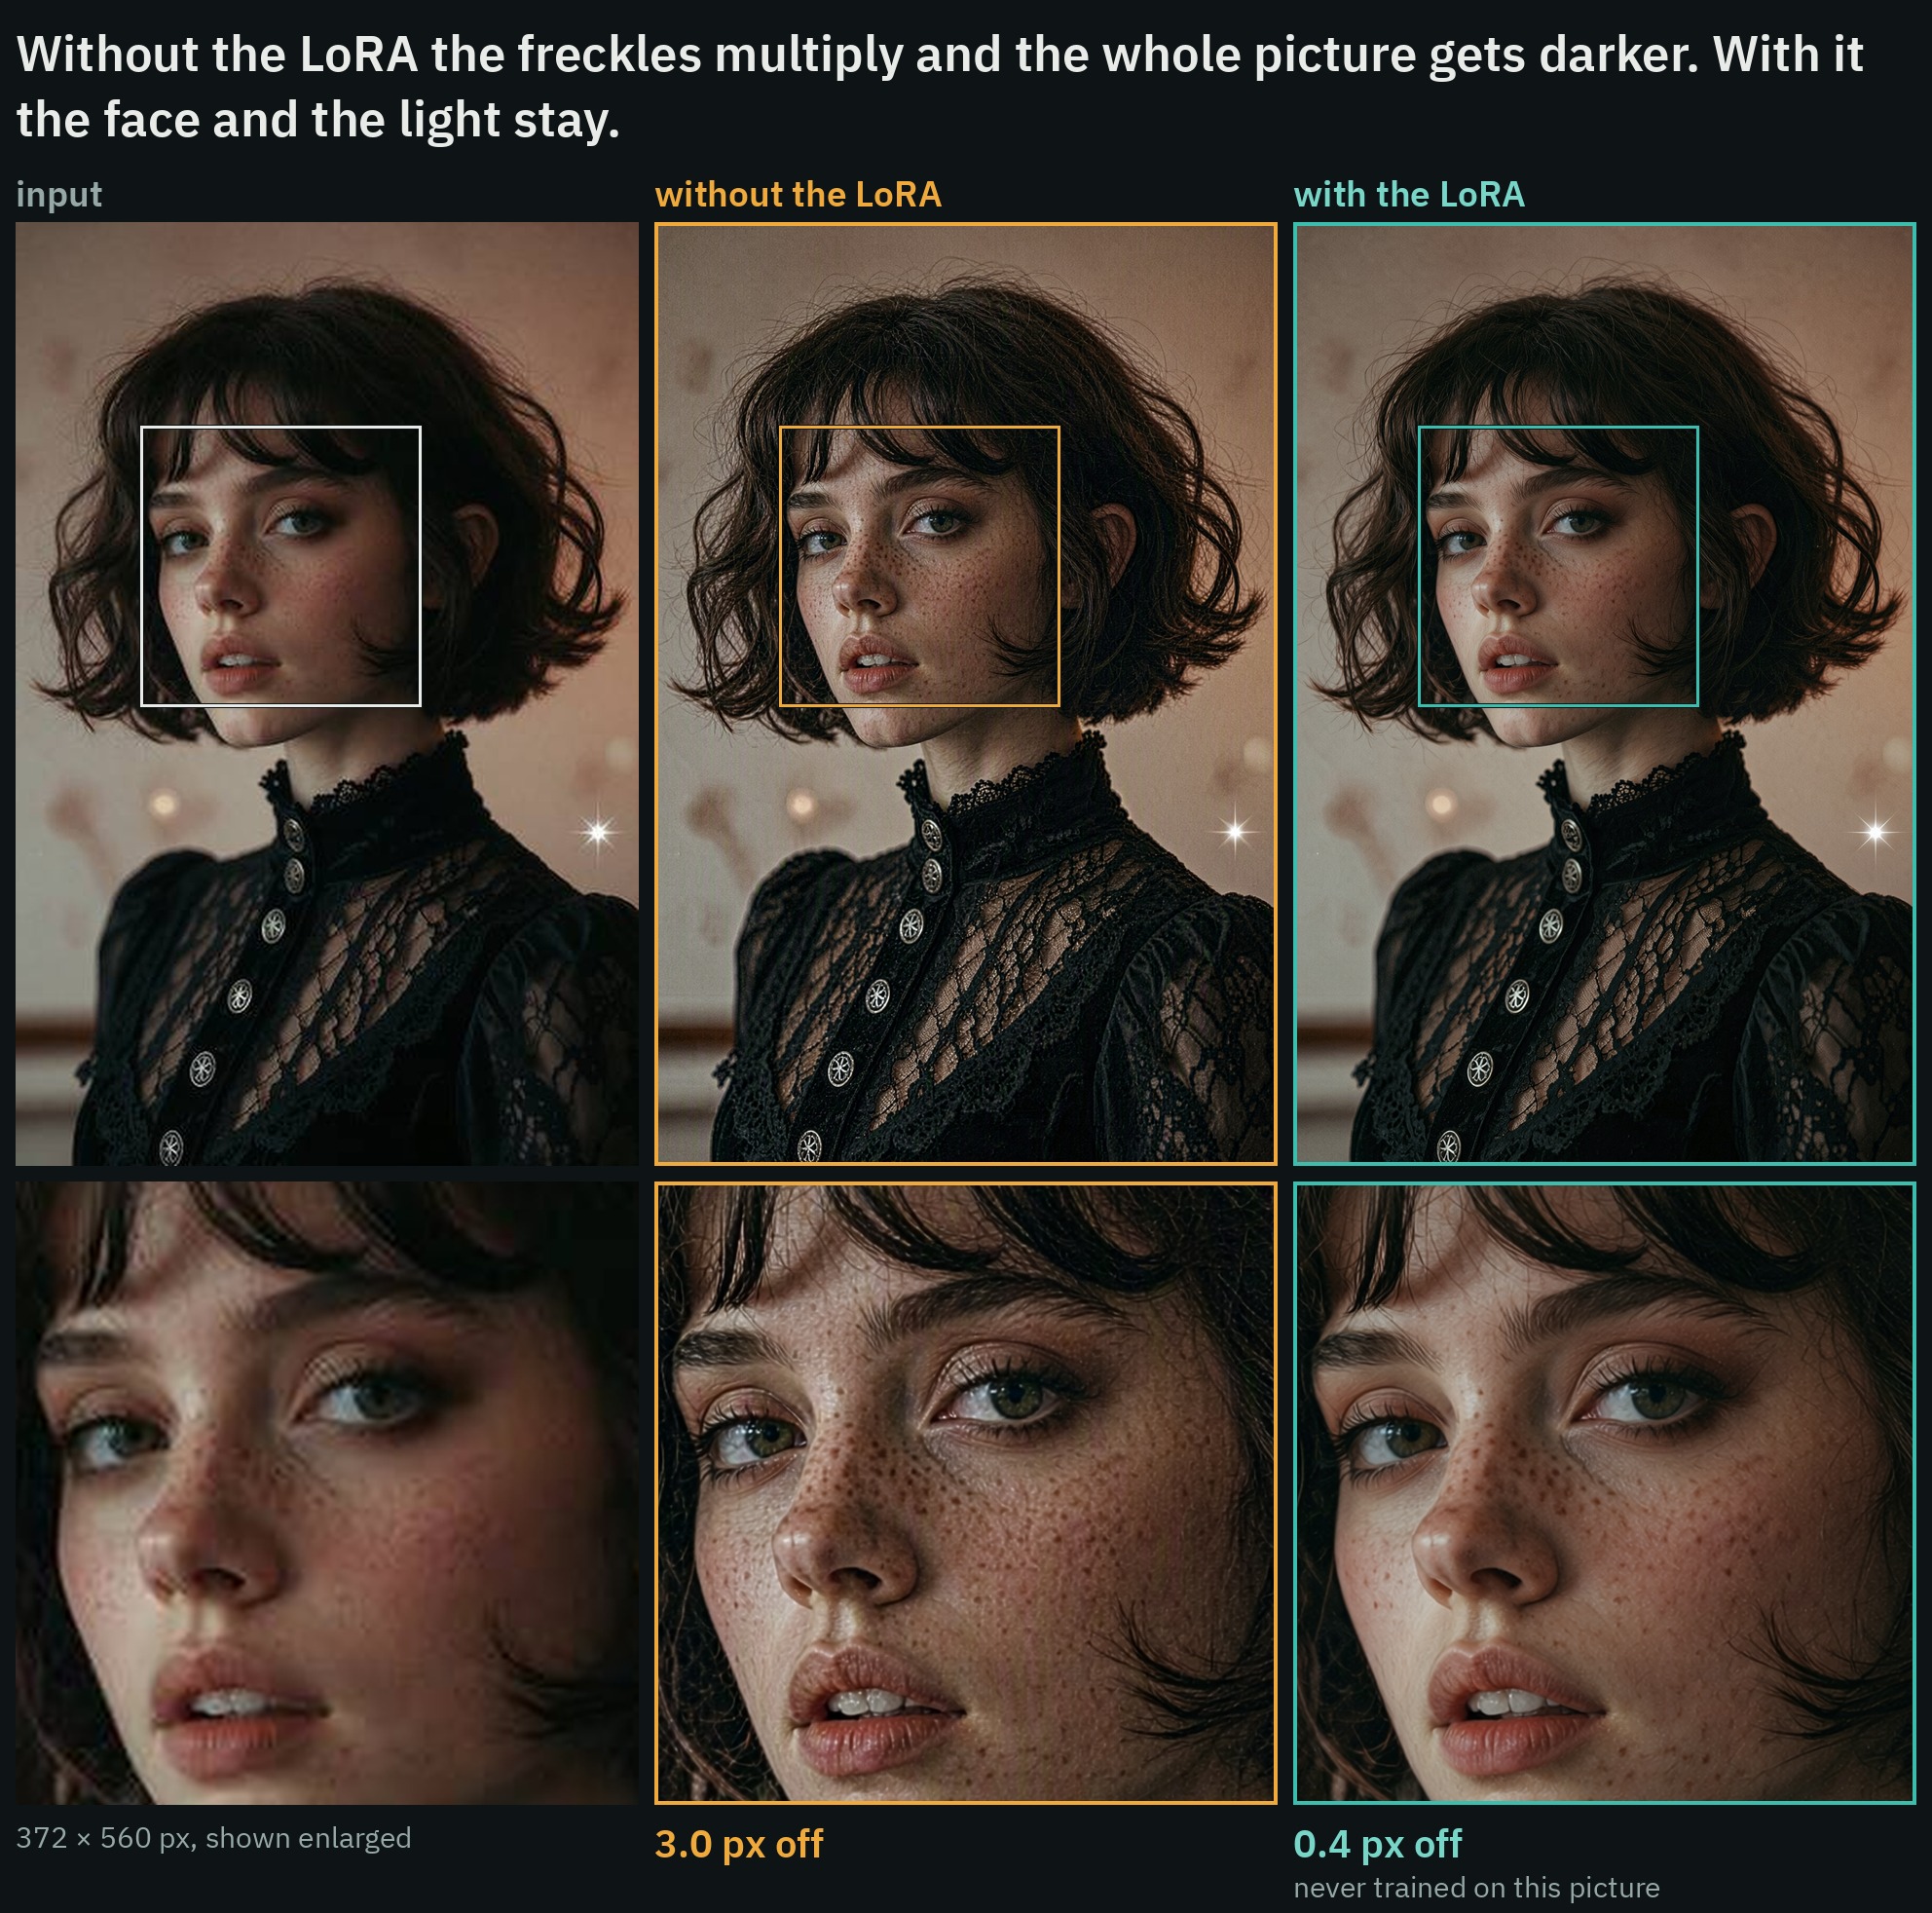
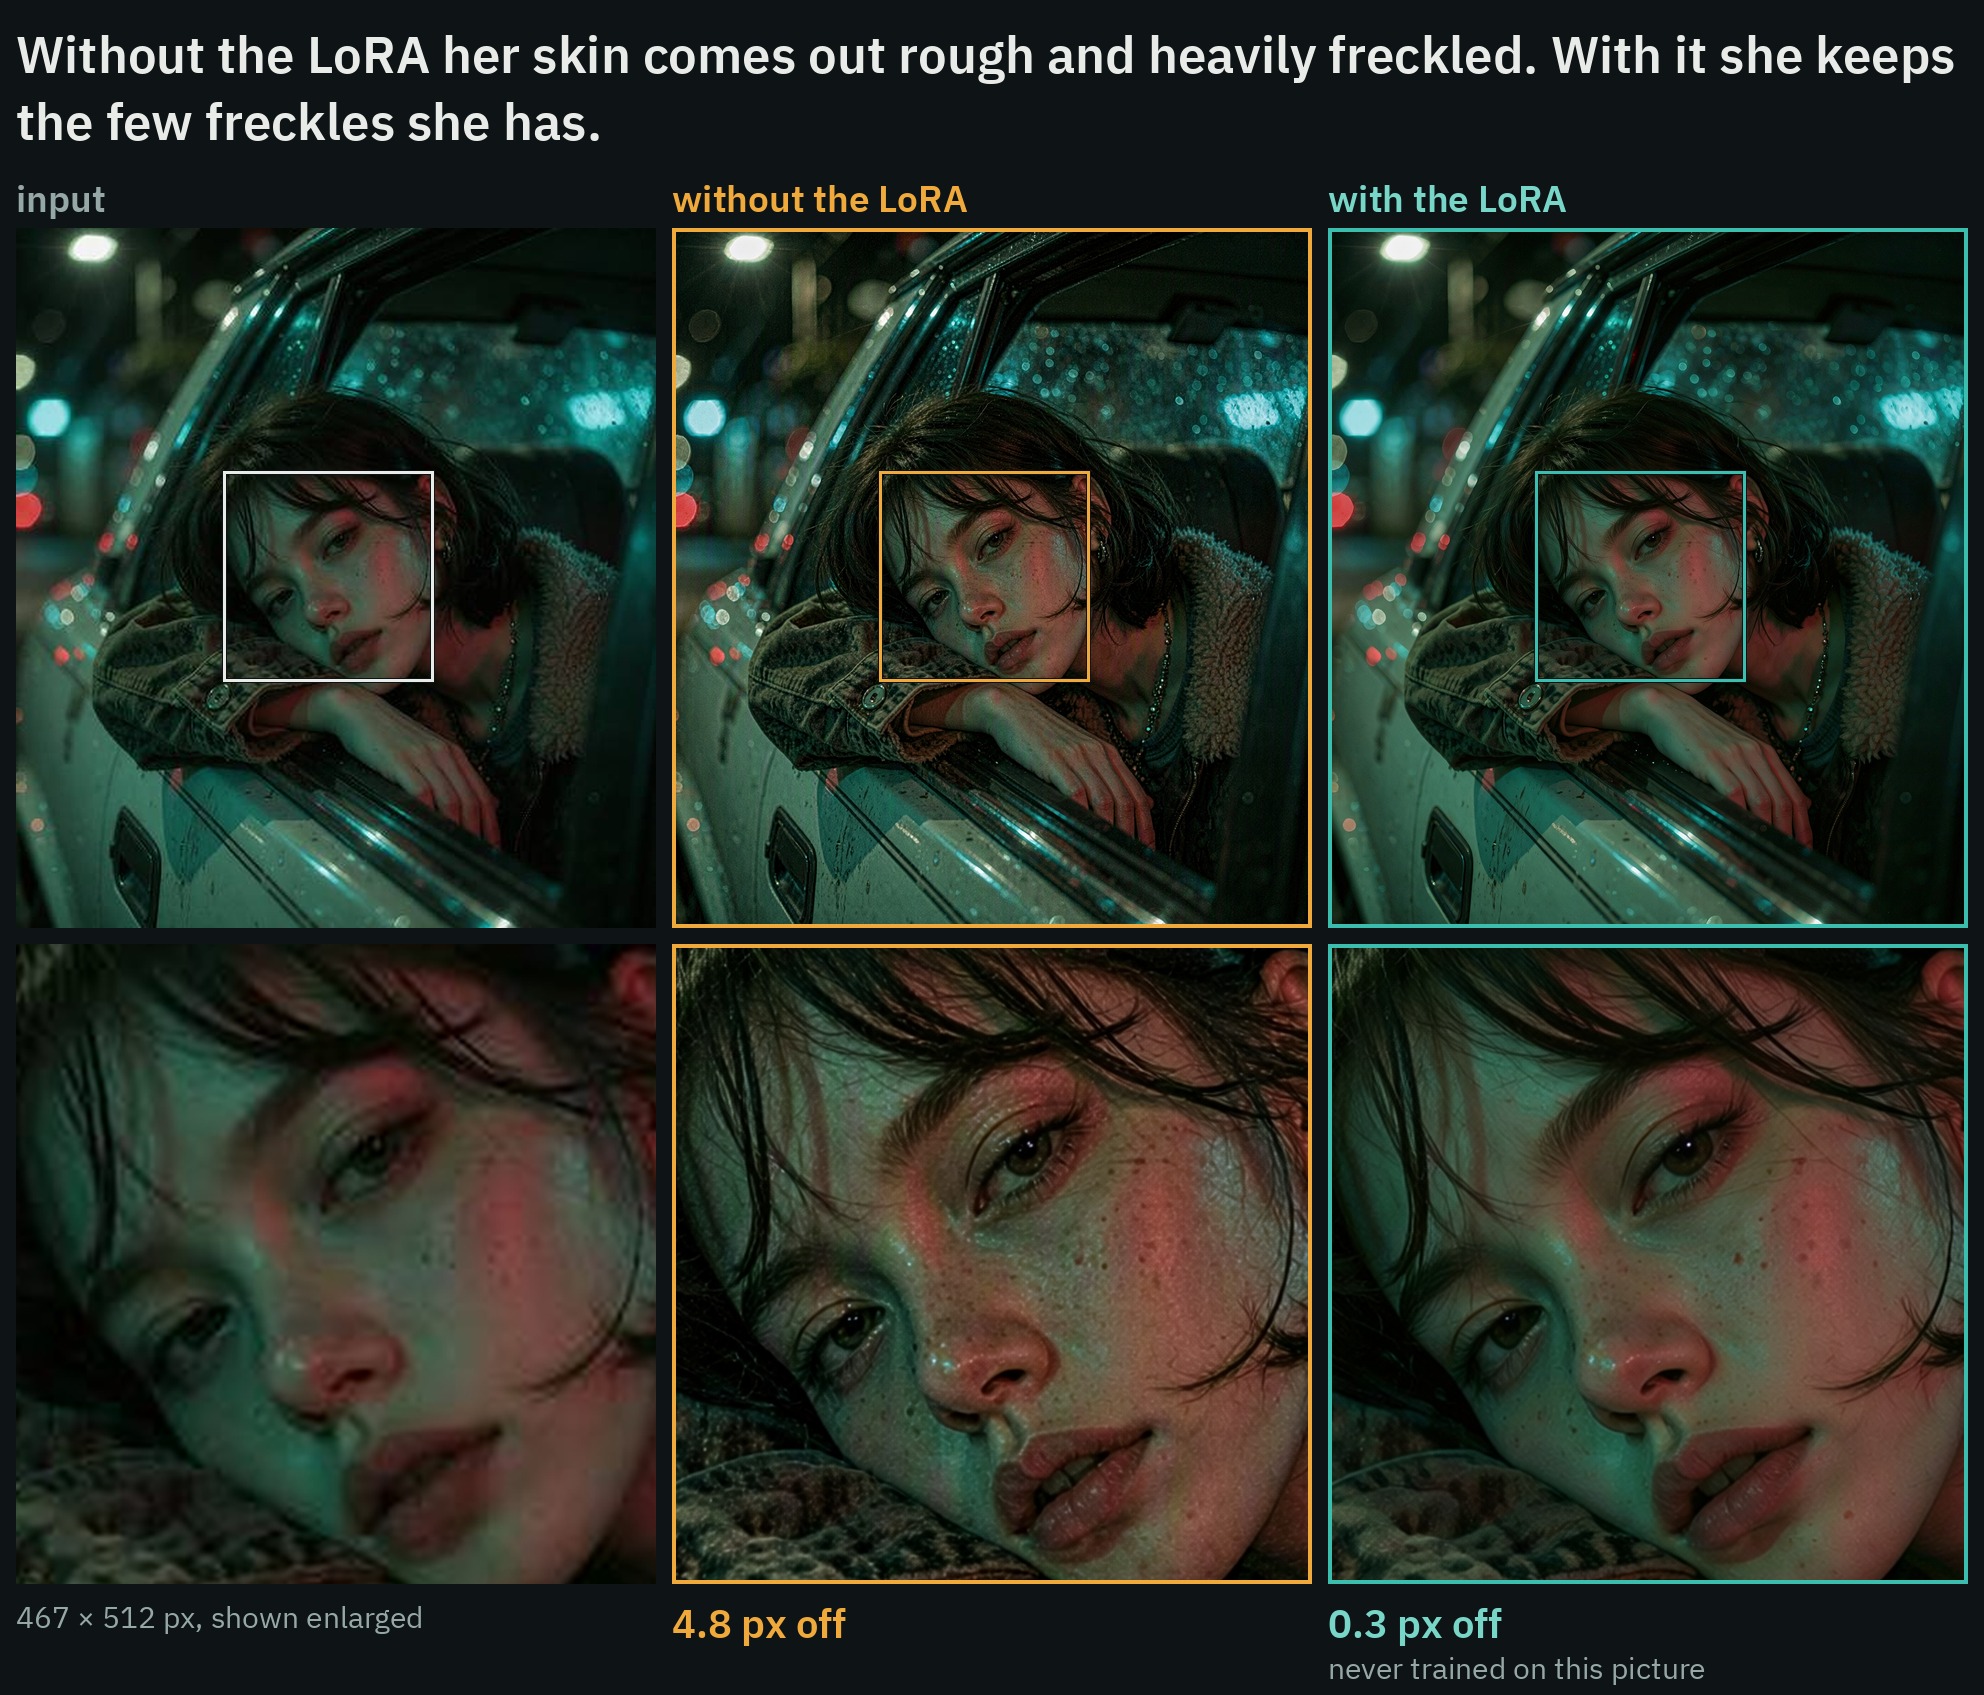
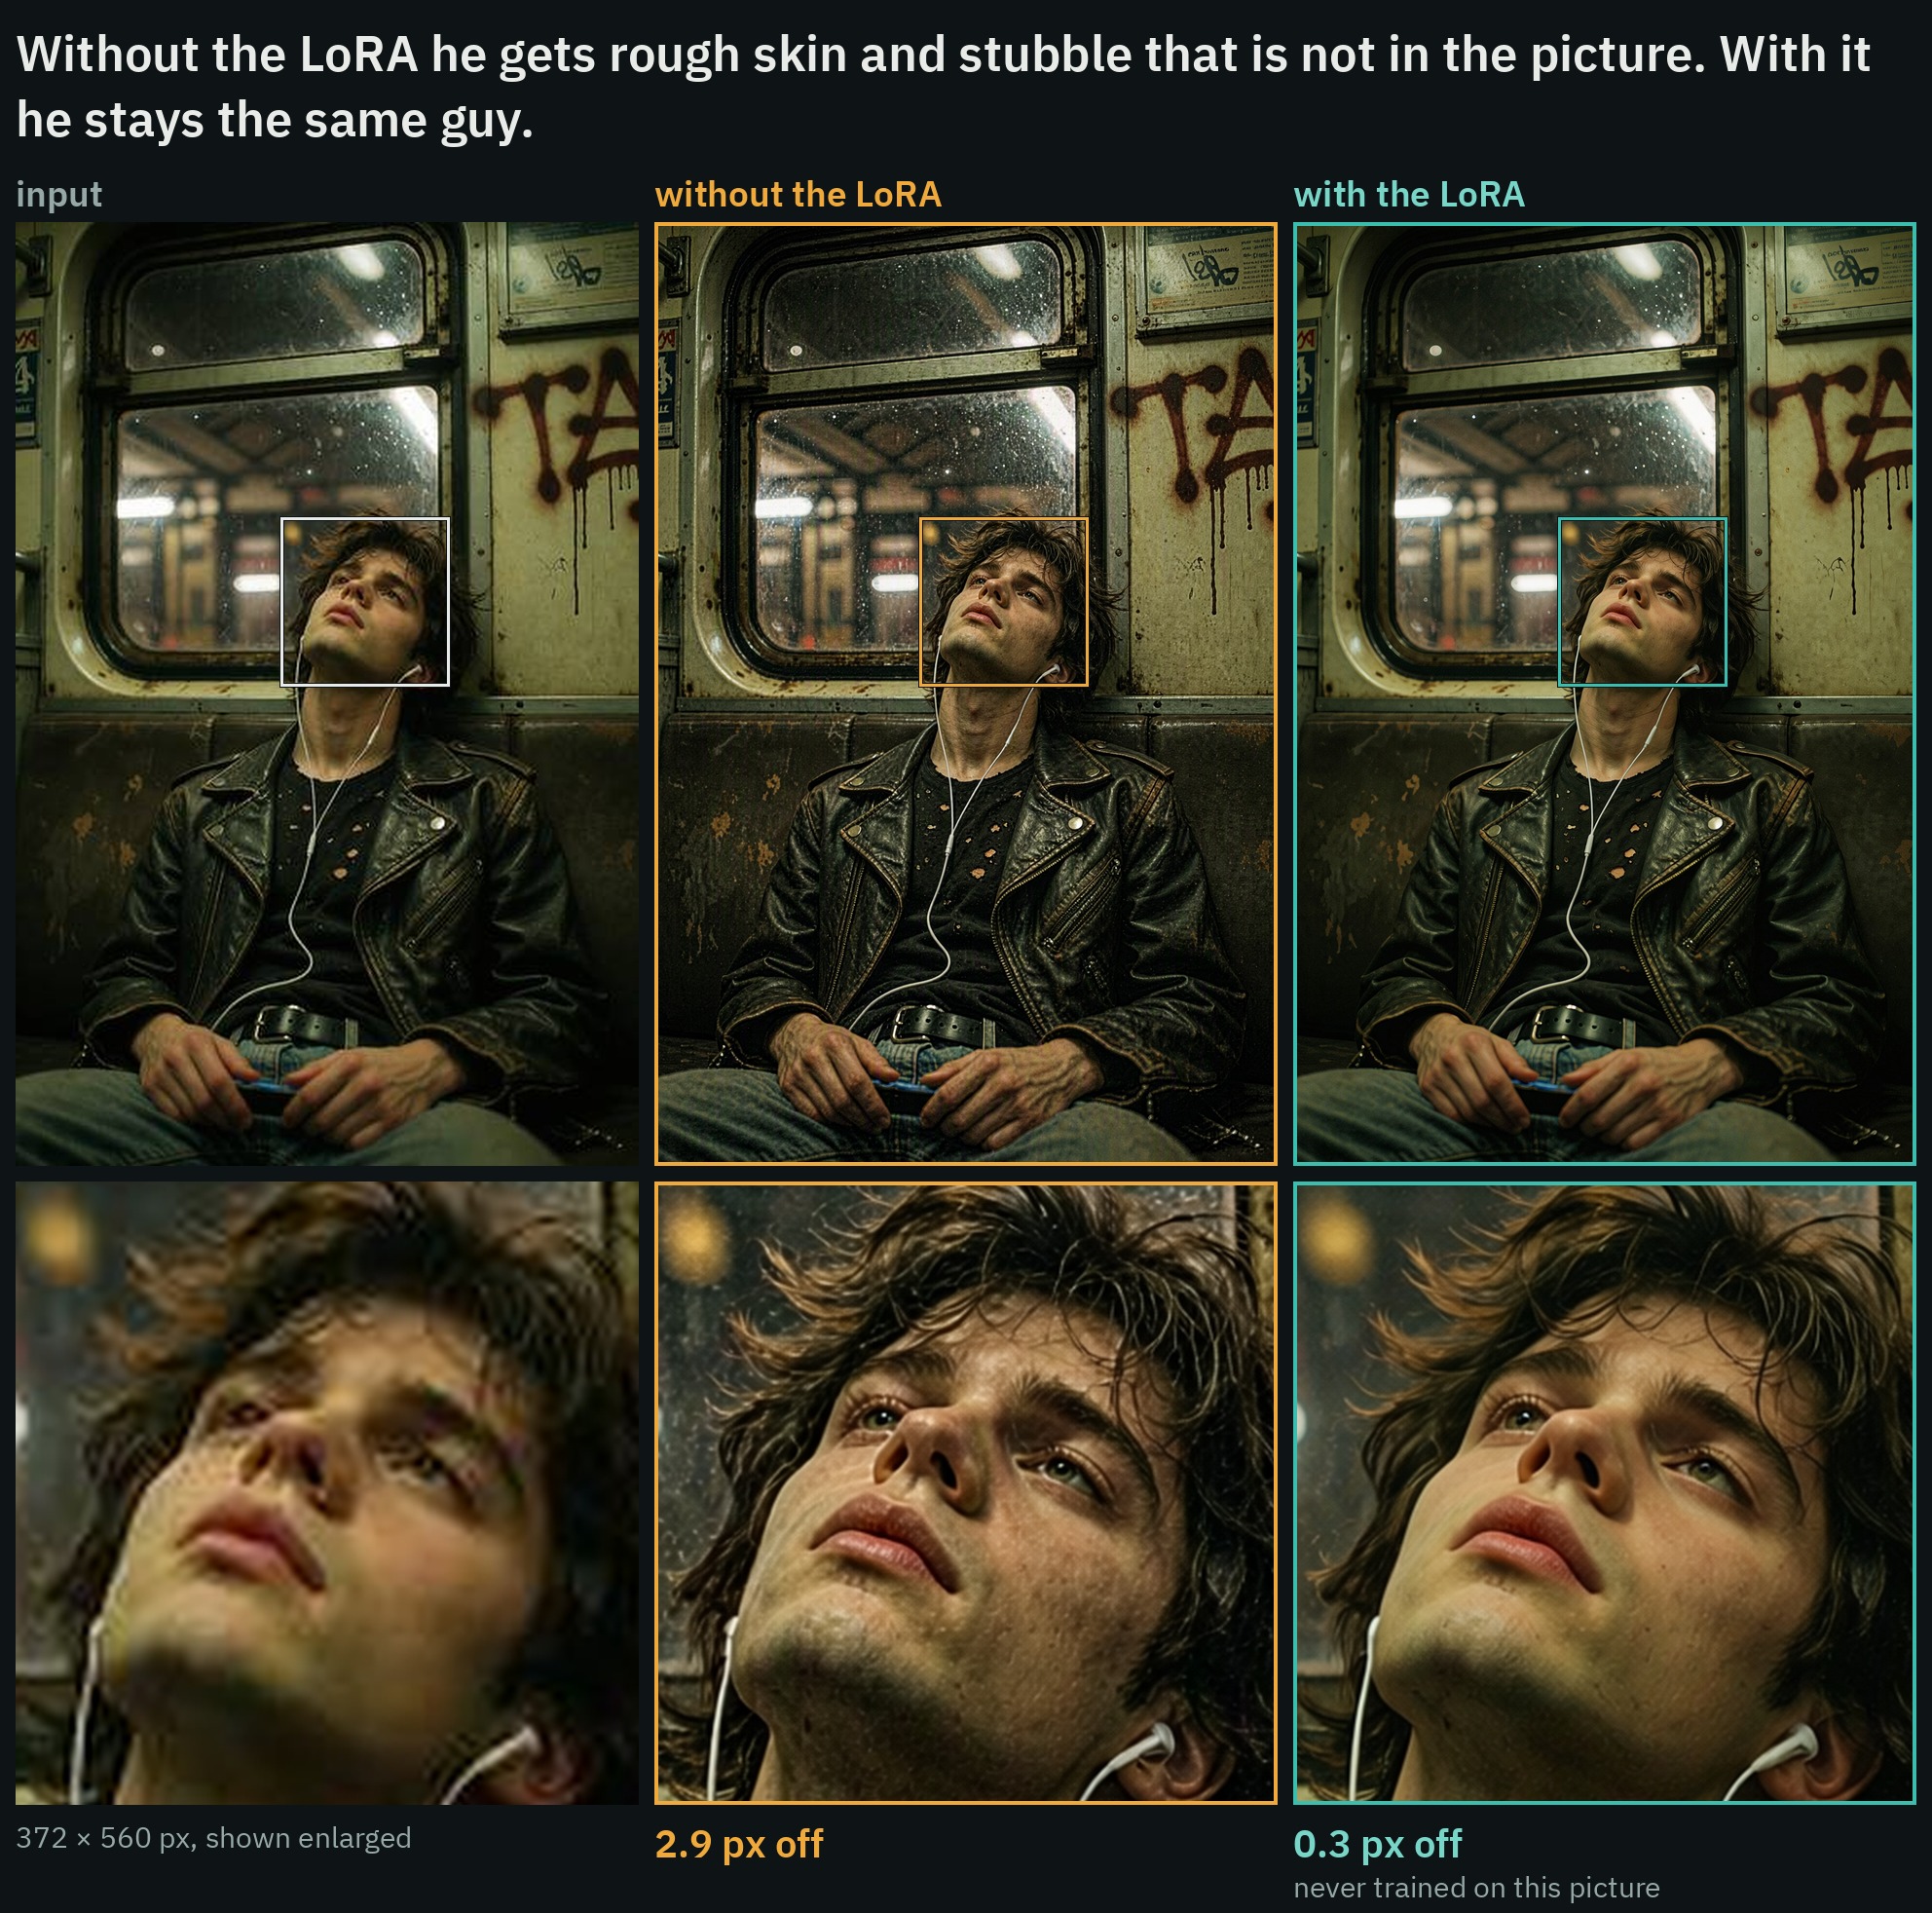
各比較では、小さな入力、LoRA なしの結果、LoRA ありの結果、そしてその下に拡大したマーク部分を示しています。すべて同じプロンプトとシードを使い、リポジトリ付属のワークフローで実行、Viggle Turbo で 8 ステップ、約 2 MP です。「px off」は、入力の縮小元であるフルサイズ画像から結果がどれだけ離れているかを示します。これらの画像はどれもトレーニングセットには含まれていません。
通常の Qwen-Image 2.1 が小さな画像に対して行うこと
Qwen-Image 2.1 はそれ自体が高性能な写真復元ツールですが、その失敗の仕方はぼかしとは正反対です。圧縮された写真や低解像度の写真を拡大するよう指示すると、ディテールを作り上げてしまいます。オリジナルには存在しなかった毛穴、そばかす、無精ひげ、粒子などです。さらに、写真の人物より数歳年を取った顔に描き直してしまいます。また、物の位置も動かします。作者のテストセット全体で、通常の Qwen-Image 2.1 の結果の最もずれた角はフルサイズのオリジナルから 2.35 px ずれていました。これはスクリーン上では小さな値ですが、結果をソースに重ねて戻すことができないほど十分なずれです。
この LoRA は、作り上げられたテクスチャの一部を手放す代わりに、元の画像に留まるよう学習されています。これは復元ではなく描き直しです。細部は依然として作り出されたものですが、その量が少ないだけであり、カードにもそのことが直接書かれています。
- トリガーワードなし。 まず画像を約 2 MP(両辺が 32 で割り切れる値)に拡大し、画像 1 として渡して指示します。
- Strength 1.0: ピントが合っている小さな画像や圧縮された画像に。
- Strength 0.75: Qwen 自身のテクスチャをもう少し残したい場合に。
- Strength 0.5: ぼやけた写真、手ブレした写真、動画のフレームに。
Restore the photo: remove blur, noise and compression artifacts and recover sharp, natural detail, keeping the same composition, people and colors.傷や色あせのあるプリントの場合、カードでは 2 つ目のプロンプトを使用します。これは色も復元します。
Restore the old photo: remove scratches, dust, fading and grain and recover sharp, natural detail and color, keeping the same composition and people.実測結果
作者自身の画像8枚を、長辺512または560 pxに縮小してJPEG品質70で保存し、その後約2 MPに拡大して、同一のシード、LoRA 1.0、CFG 1、euler / simple で復元しました。すべての数値は、モデルが決して見ることのないフルサイズのオリジナルを基準に測定したものです。8ステップの列では Viggle Turbo を使用し、25ステップの列では使用していません:
| ホールドアウトした8枚の画像 | LoRAなし、8ステップ | LoRAあり、8ステップ | LoRAなし、25ステップ | LoRAあり、25ステップ |
|---|---|---|---|---|
| オリジナルとの距離、最悪コーナーの中央値 | 2.35 px | 0.26 px | 1.59 px | 0.15 px |
| 同上、8枚中の最悪値 | 3.83 px | 0.38 px | 3.25 px | 0.26 px |
| オリジナルへの近さ(SSIM、1 = 完全一致) | 0.578 | 0.766 | 0.743 | 0.812 |
| PSNR | 23.2 dB | 28.0 dB | 26.3 dB | 29.3 dB |
| 色と明るさのズレ | 2.05 % | 0.97 % | 1.72 % | 1.04 % |
| 同一の顔(顔認識、1 = 完全一致) | 0.821 | 0.905 | 0.837 | 0.901 |
| 細部、オリジナル比 | 121 % | 78 % | 58 % | 36 % |
細部の行は、このトレードオフを1つの数値で表したものです。100 %を超えるということは、作り出された細部があるという意味です。8ステップの素の Qwen-Image 2.1 はオリジナル以上に粒状感を描き、25ステップではオリジナルのおよそ半分しか描きません。LoRA を使うとどちらもオリジナルより低くなるため、結果はややスムーズに見えます。作者はさらに29枚の画像を同じ8ステップのテストにかけました。LoRAありでは0.28 pxのズレ、LoRAなしでは2.16 px、同一の顔は0.88対0.79、SSIMは0.777対0.611でした。
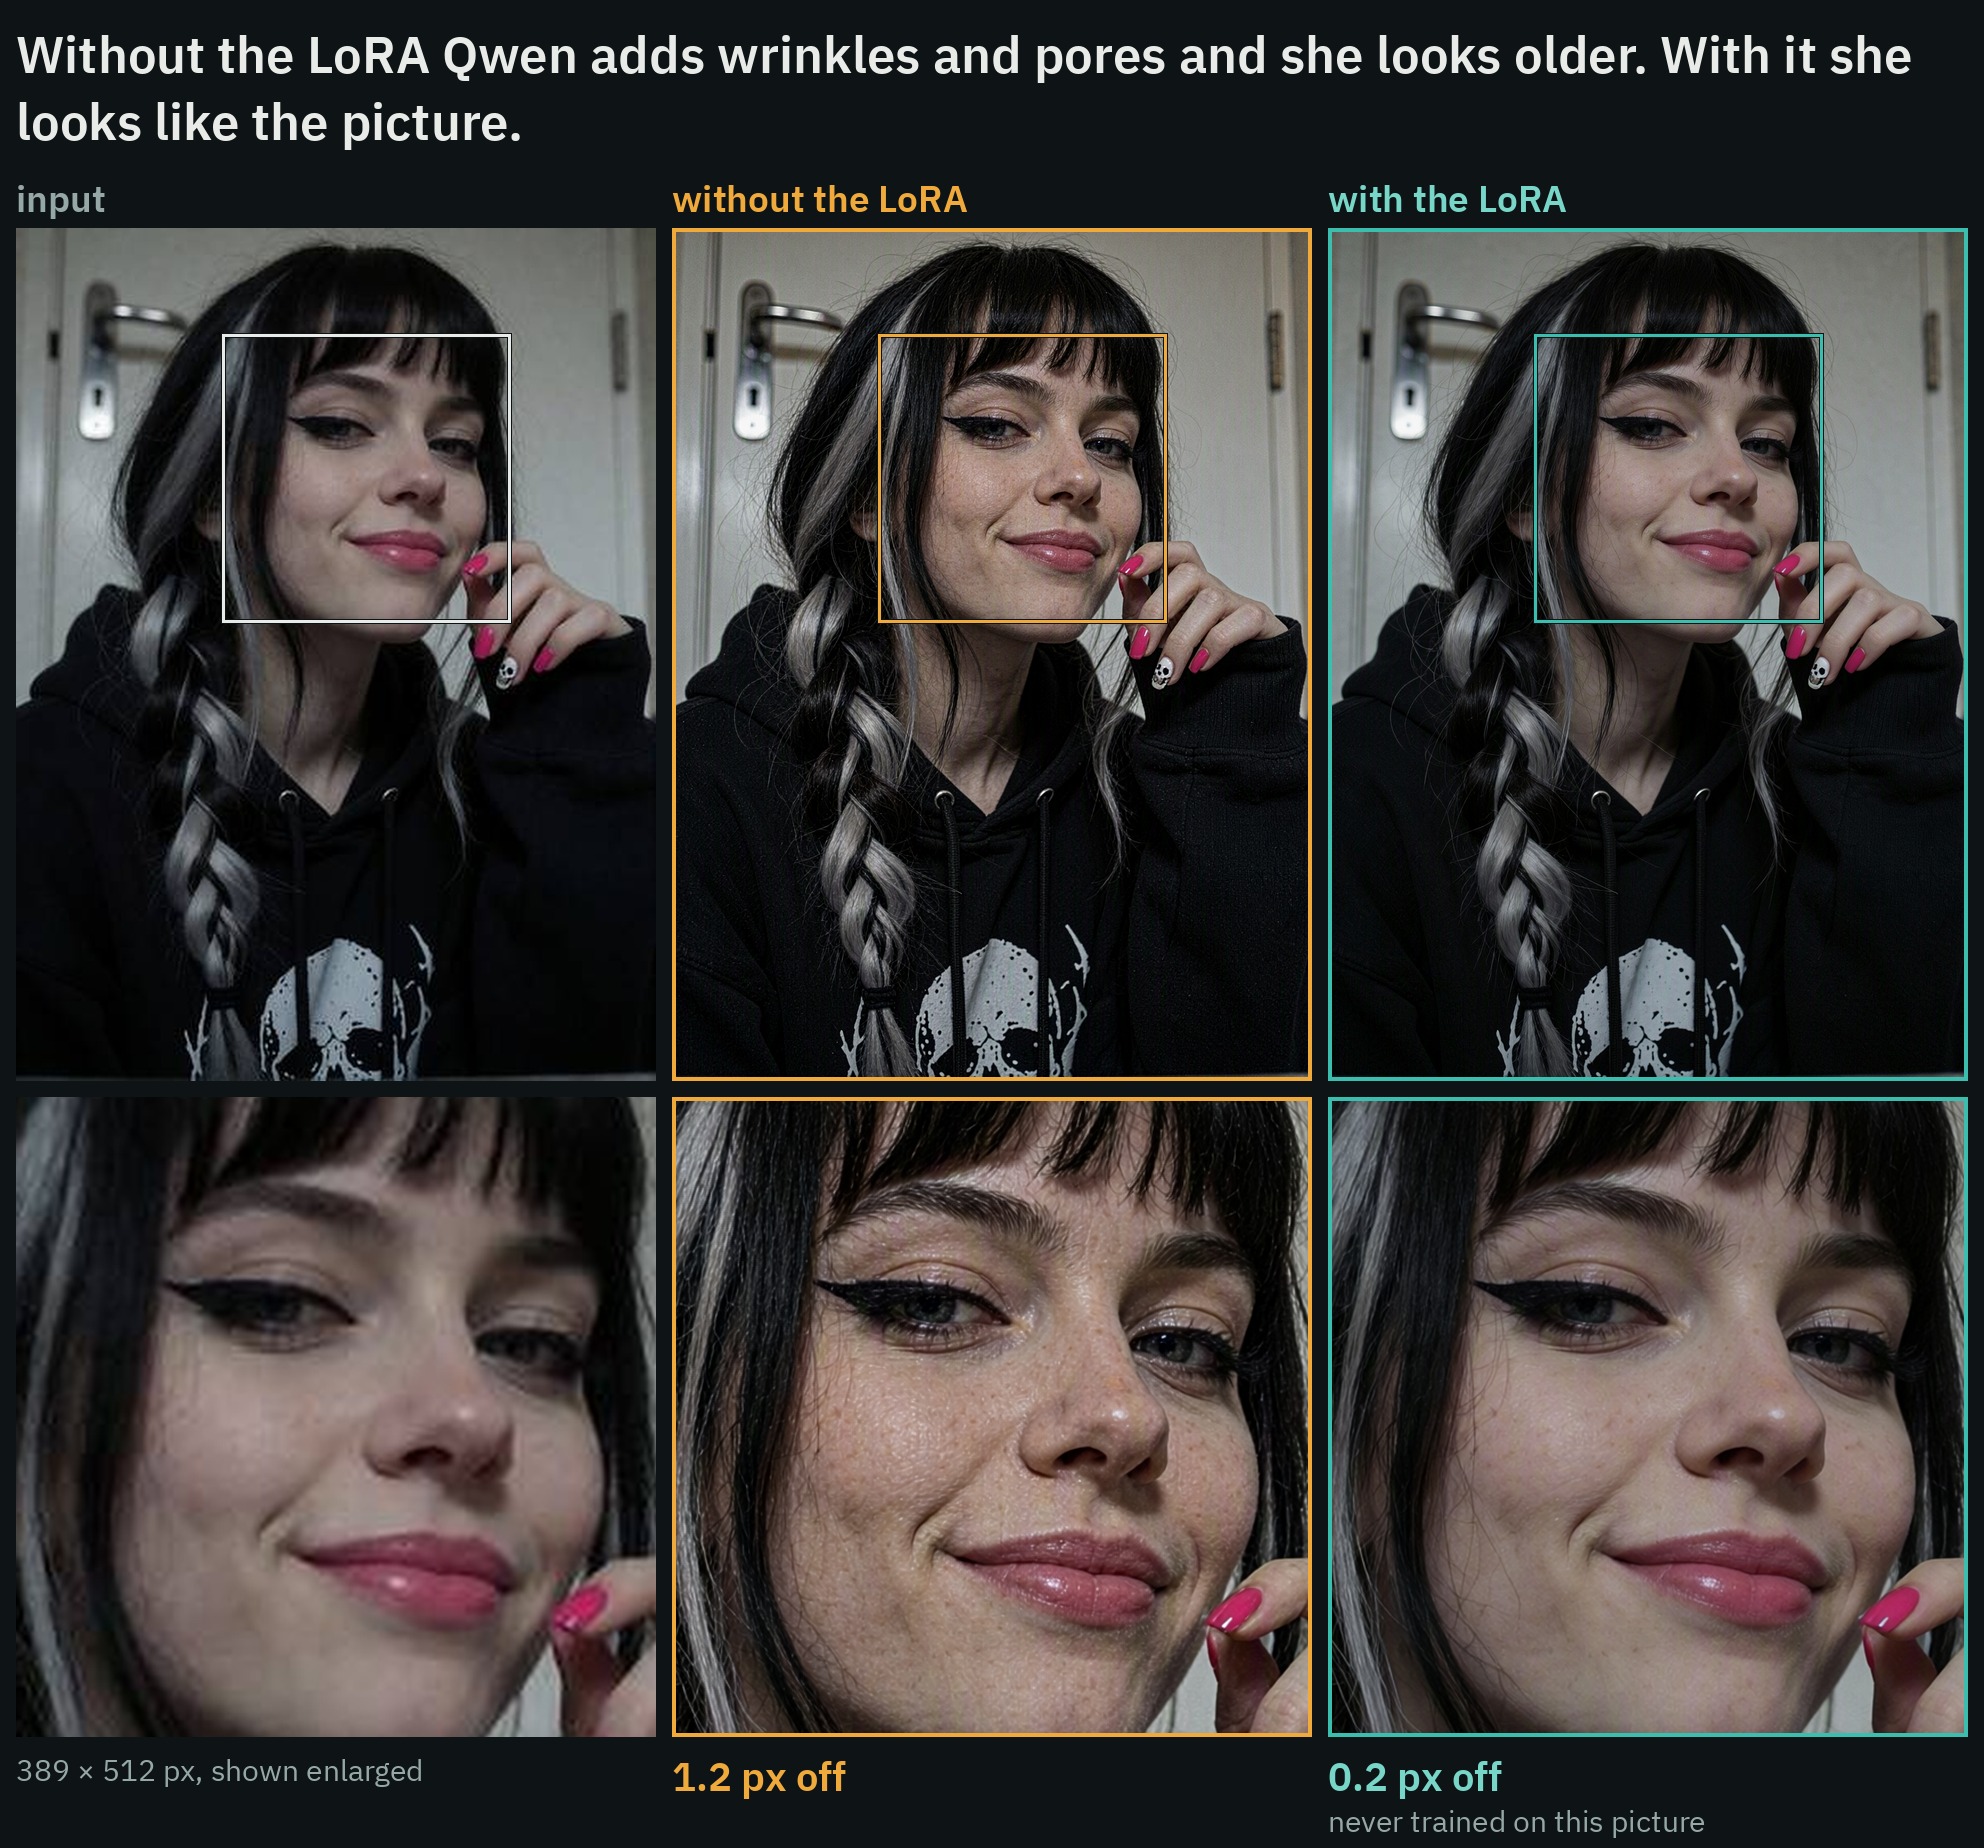
389 pxのJPEGを2 MPに拡大したもの。これらの画像はどれもトレーニングセットには含まれていません。
あらゆる種類のダメージ
このリリースでは、トレーニング用のペアと同じ方法でダメージを与えた57組のホールドアウトペアについても報告しています。通常のリクエストで8ステップ、1パスです。SSIMはクリーンな画像を基準に測定し、「px 誤差」は中央値です。
| ダメージの種類 | 画像数 | SSIM、ダメージ入力 | SSIM、LoRAなし | SSIM、LoRAあり | px 誤差、LoRAなし | px 誤差、LoRAあり |
|---|---|---|---|---|---|---|
| 小さいWeb画像 | 15 | 0.772 | 0.524 | 0.716 | 2.53 | 0.31 |
| スマホの平滑化 | 5 | 0.836 | 0.565 | 0.857 | 2.65 | 0.17 |
| 動画の静止画 | 5 | 0.771 | 0.578 | 0.745 | 2.77 | 0.50 |
| 保存と再保存 | 5 | 0.816 | 0.560 | 0.794 | 2.21 | 0.24 |
| ぼかしとノイズ | 5 | 0.496 | 0.521 | 0.678 | 2.48 | 0.24 |
| 低解像度JPEG | 5 | 0.777 | 0.531 | 0.763 | 3.16 | 0.23 |
| 重度の混合 | 5 | 0.735 | 0.646 | 0.746 | 1.28 | 0.25 |
| 古いプリント | 4 | 0.551 | 0.437 | 0.749 | 2.46 | 0.19 |
| バンディング | 4 | 0.915 | 0.463 | 0.843 | 2.34 | 0.17 |
| 低解像度PNG | 4 | 0.873 | 0.636 | 0.847 | 3.39 | 0.15 |
| 全体 | 57 | 0.756 | 0.544 | 0.762 | 2.70 | 0.23 |
LoRAを使うと、57組すべてで結果がクリーンな画像に近づき、57組すべてで変化量も小さくなりました。いくつかの種類では、ダメージを受けた画像自体がどの復元結果よりも高いスコアになります。ぼやけた画像は平均的にクリーンな画像に近いためです。
古いプリントについては、4つのホールドアウト例で個別の数値が示されています。復元前は色と明るさがクリーンな画像から15%ずれており、通常のリクエストによる復元後は7%、古い写真用リクエストでは4%のずれになりました。傷、ほこり、粒子はどちらのリクエストでも除去されました。モデルが見たことのない種類の退色は残ることがあります。別の退色を使った2回目のテストでは、傷は除去されましたが、退色した色は残りました。
strength はダイヤル
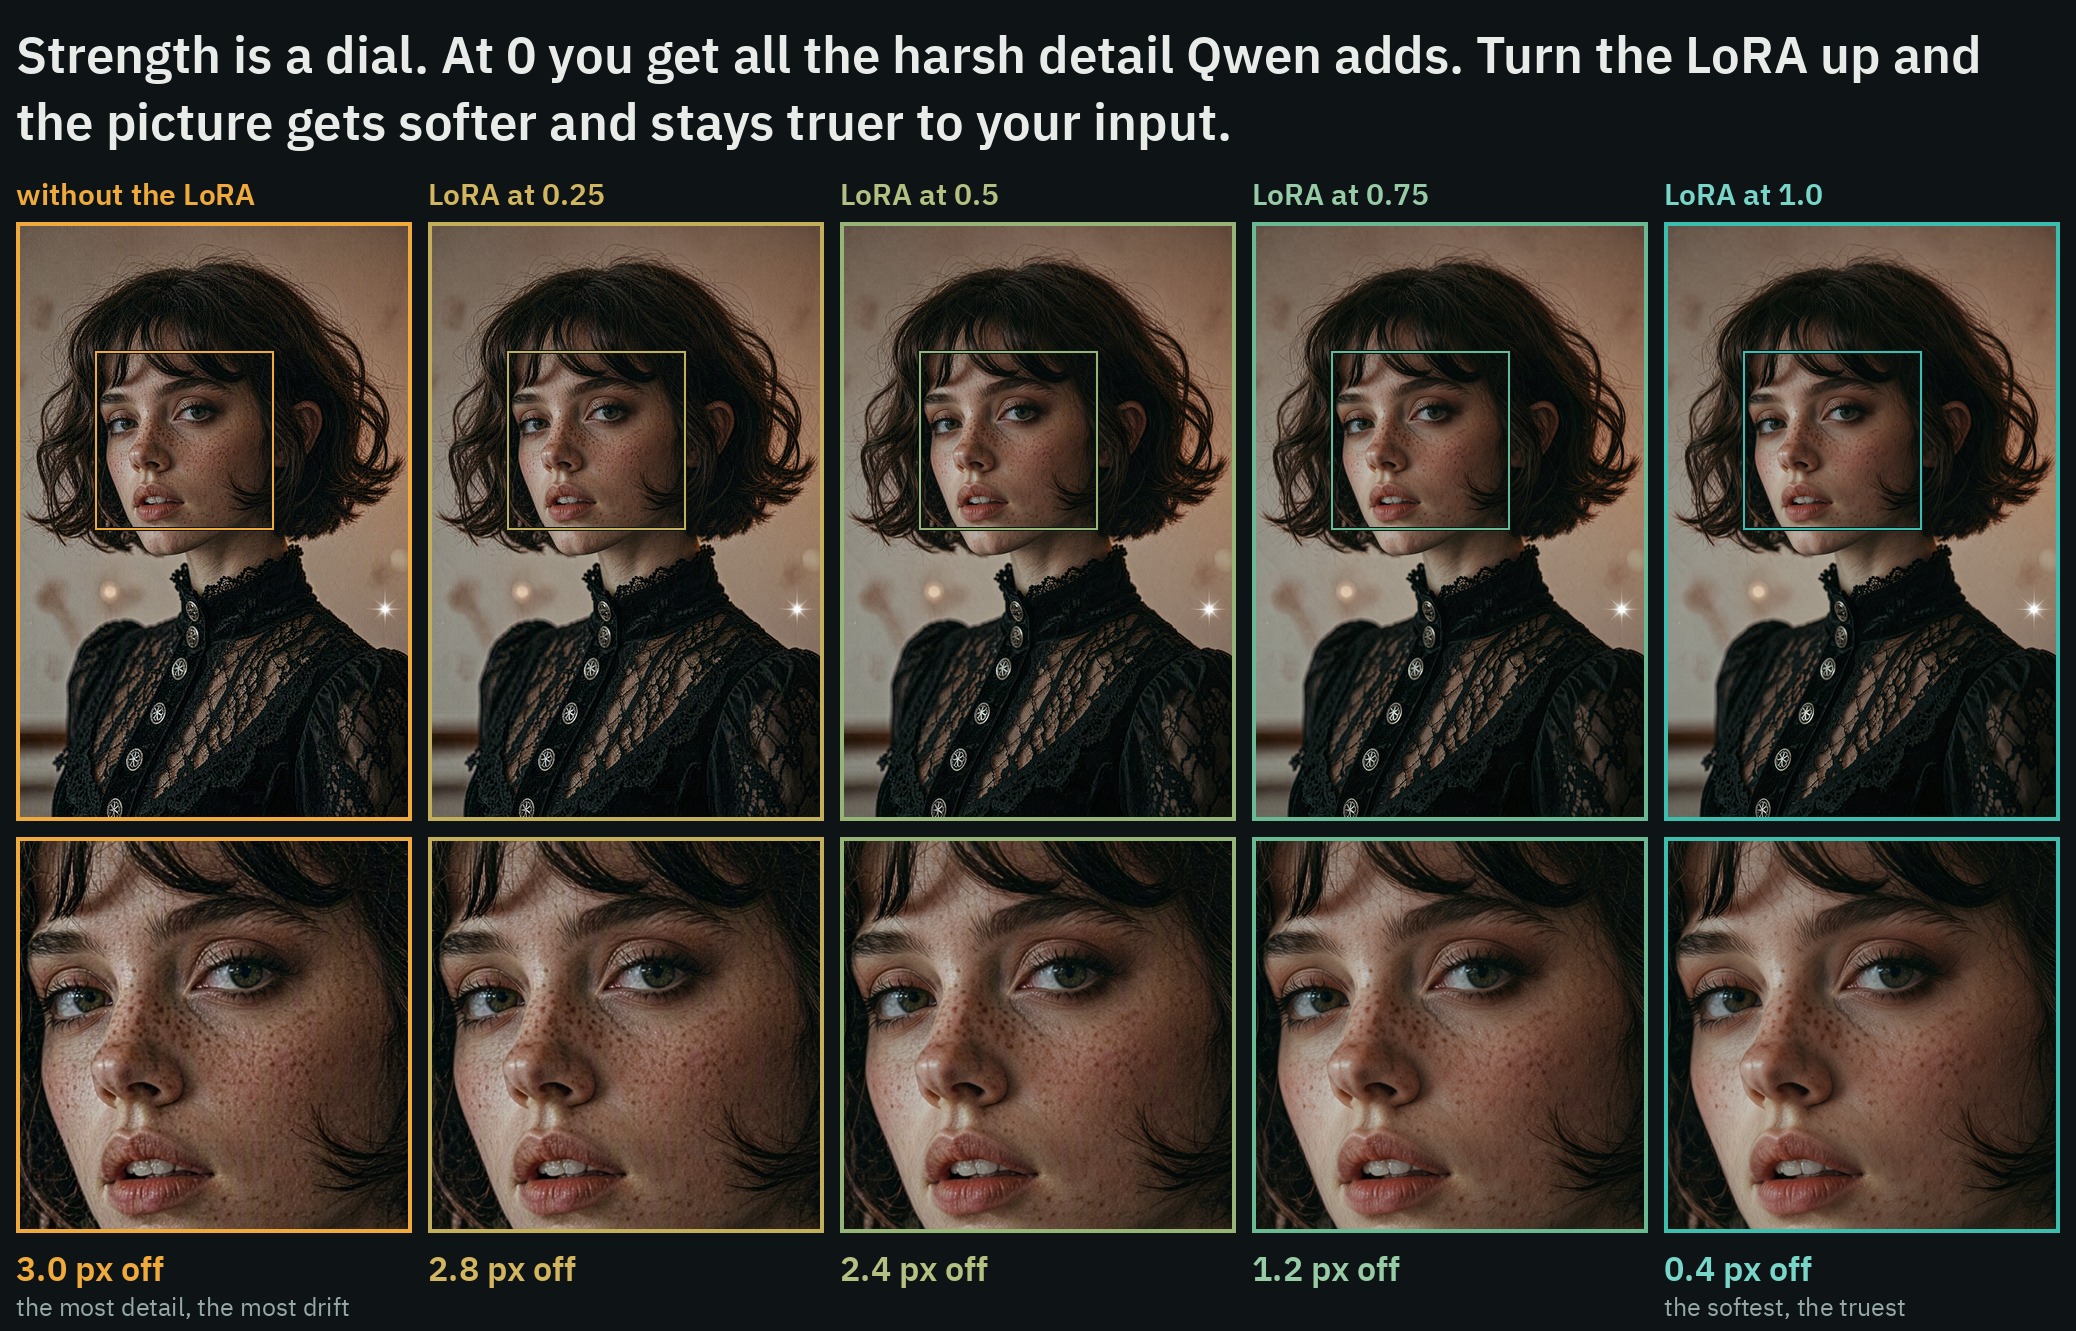
29 枚の画像セットでは、スケール全体が素の Qwen(0)から最も忠実な結果(1.0)まで広がっている:
| strength | オフ / 0.5 / 0.75 / 1.0 |
|---|---|
| オリジナルからの距離 | 2.16 px / 1.31 px / 0.37 px / 0.28 px |
| 同じ顔 | 0.794 / 0.858 / 0.875 / 0.880 |
| 色と明るさの変化 | 1.88 % / 1.26 % / 1.05 % / 0.94 % |
| 細部の量(オリジナル比) | 102 % / 81 % / 77 % / 72 % |
ぼやけた写真では、このダイヤルが最も重要になる。作者は 26 枚の実際の低解像度写真(古い自撮り写真やスマートフォンの写真)を 1.0、0.75、0.5 で実行した。最もぼやけた 6 枚では、1.0 はソフトな仕上がりになり、0.75 はほとんど効果がなく、0.5 はシャープな結果になった。残りの 20 枚では 3 つの設定すべてが機能し、1.0 が最も滑らかだった。ソフトな写真をタイル単位で 8 MP に拡大した場合も、その方法を試した 3 枚では 1.0 でシャープな結果が得られた。
この LoRA は写真でトレーニングされており、イラストでも効果を保つ。6 枚のテスト用イラスト(アニメ、文字入りのポスター、水彩、3D カートゥーン、マンガ、油絵)では、スタイルと文字を保持した: SSIM は LoRA なしの 0.491 に対して 0.714、ズレはなしの 2.65 px に対して 0.27 px だった。
他のツールとの比較
このカードでは、このリリースを、同じジョブのために見つけられた他のツールと、同じ29枚の画像、同じ測定方法、すべて1.0で実行して比較しています。すべてが同じ目的で作られているわけではありません。詳細を追加するために作られたものもあれば、このLoRAは画像に忠実であり続けるために作られています。そのため、この表が答える問いは1つ、結果がどれだけオリジナルに近いままか、です。
| 29枚の小さな画像 | オリジナルからのズレ | 同じ顔 | 色と明るさの変化 | SSIM |
|---|---|---|---|---|
| Qwen Image 2.1 単体 | 2.16 px | 0.79 | 1.88 % | 0.611 |
| SeedVR2 (3B)、ComfyUI 標準のノード | 0.42 px | 0.82 | 0.44 % | 0.771 |
| Deblur anything | 0.39 px | 0.85 | 1.42 % | 0.702 |
| Detail Enhancer、同じグラフ内 | 2.07 px | 0.76 | 2.94 % | 0.673 |
| Detail Enhancer、独自のワークフロー、25ステップ | 12.45 px | 0.71 | 4.16 % | 0.590 |
| このLoRA | 0.28 px | 0.88 | 0.94 % | 0.777 |
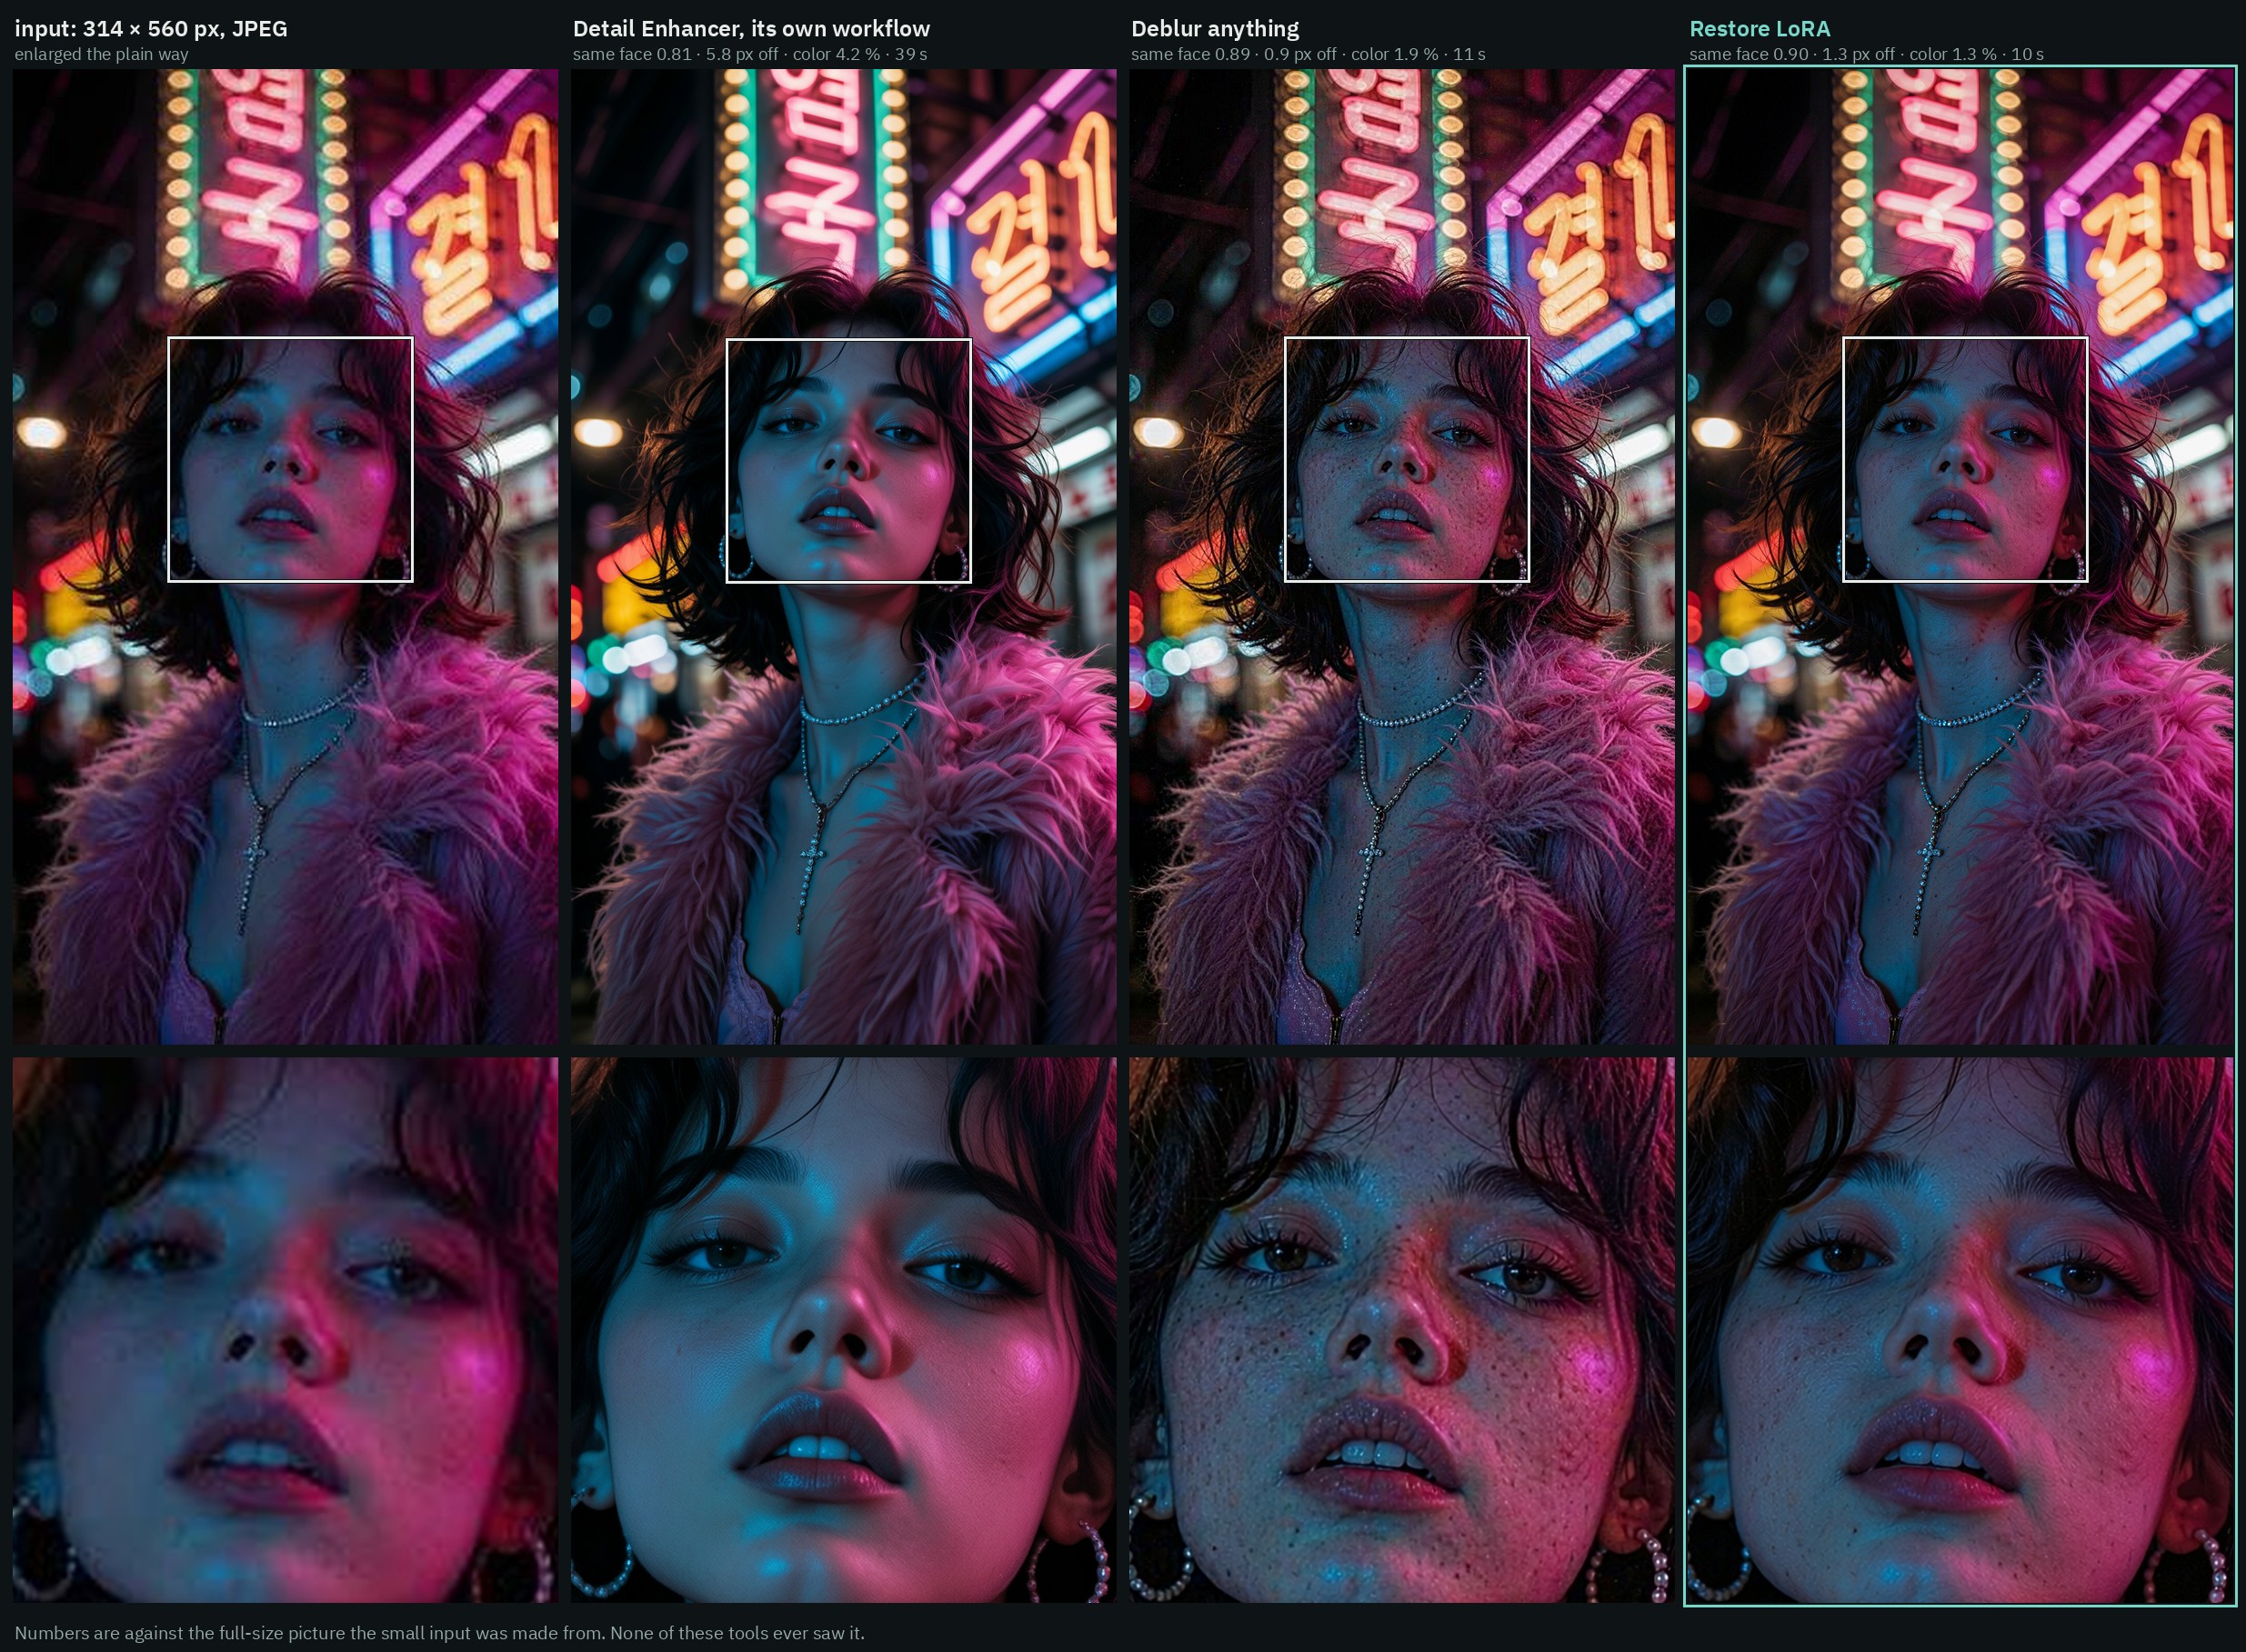
SSIM では、この LoRA は 29 枚すべての画像で Detail Enhancer よりもオリジナルに近いままでした(Detail Enhancer が独自のワークフローを実行した場合は 29 枚中 28 枚)。Deblur anything よりも近く、SeedVR2 よりも 29 枚中 18 枚で近い結果でした。顔の保持は、Detail Enhancer に対しては 28 枚中 28 枚、Deblur anything に対しては 28 枚中 26 枚、SeedVR2 に対しては 28 枚中 27 枚で優れていました。SeedVR2 は圧倒的に最速で、約 3 秒対 11 秒、そして色の保持が最も優れています。
どのファイルを使うか
| ファイル | 備考 |
|---|---|
qwen-image-2.1-restore.safetensors | step 1,500、まずはこちらから。 作者のテスト画像では2つのうち最も近い結果が得られます。肌は少しスムーズに仕上がります。 |
qwen-image-2.1-restore-1250.safetensors | step 1,250。より細かいディテールを描画し、ノイズの多いスマホ写真でも肌のテクスチャをより多く保持します。元画像への再現度は少し低めです。 |
どちらも rank 32 で ComfyUI のキー命名規則を使用しているため、変換なしで Comfy-Org Qwen-Image 2.1 の重みにロードできます。
ComfyUI での実行
このアダプターはモデルのみの LoRA なので、復元自体にカスタムノードは必要ありません。.safetensors ファイルを ComfyUI/models/loras/ に配置し、モデルローダーの後に LoraLoaderModelOnly ノードを強度 1.0 で追加します。次に Qwen-Image 2.1 に小さな画像を image 1 として渡し、上記のリクエストをプロンプトとして指定します。カード自体の設定は、Viggle Turbo を使う場合は CFG 1 で 8 ステップ、使わない場合は 25 ステップです。
すぐに使えるワークフローがリポジトリの workflows/ フォルダーに同梱されています。これは作者の ComfyUI-AusBoss ノードで構築されており、彼の以前のリリースでも使われているものと同じノードパックです。
制限事項
- これは復元ではなく描き直しです。細部は合わせて作り込まれるため、素の Qwen-Image 2.1 のほうがより多くを描画します。
- 元の画像にとどまることが最大の目的であるため、新しいコンテンツを必要とする結果は得られません。
- ぼやけた入力を最大強度で適用すると、ソフトな仕上がりになります。0.5 まで下げるか、タイル単位で拡大してください。
- 数値は作者自身のテスト画像と、比較セットの一部で Turbo なしの 25 steps に基づいています。
- 2 MP を超える結果については、作者は Civitai 上の自身のタイル式アップスケールワークフローと組み合わせています。
入手方法
- LoRA weights: ausboss/Qwen-Image-2.1-Restore-LoRA
- Per-picture numbers: comparison_numbers.csv
- Base model repack: Comfy-Org/Qwen-Image-2.1
- Author's node pack: ausboss/ComfyUI-AusBoss
コメント
GitHubでサインインしてディスカッションに参加しましょう。