Qwen-Image 2.1 Outfit Swap LoRA: ComfyUIでフレームを維持したまま衣装を交換
Qwen-Image 2.1 向けのコミュニティ製 LoRA を使えば、元の画像の構図、顔、背景を保ったまま服だけを着せ替えできます。ComfyUI ワークフロー付き。
上段: 入れ替え結果。同じリクエストと同じシード。下段: 黄色で示された、描き直されたピクセル。LoRA なしでは顔、ウィンドウ、壁が浮かび上がり、ありではコートだけが異なります。この人物もこのコートもトレーニングセットには含まれていません。
素の Qwen-Image 2.1 が失敗する点
Qwen-Image 2.1 の編集はすべて新規生成なので、衣装の差し替えでは服だけでなく構図まで再構成されます。作者は素の Qwen-Image 2.1 で 47 回の差し替えを実行し、そのすべてを目視で判定しました。使えたのは 24 回で、残りの 23 回には何らかの問題がありました。多くの場合、問題は衣装そのものではありませんでした。
- 衣装全体をフレームに収めるためにカメラが引いた
- 脚が写っていないショットにパンツが押し込まれた
- 新しい服に合わせて体やポーズが描き直された
- あるいは全体が数ピクセルずれただけ
人物画像と比較すると、素の結果は最もずれが大きい角で約 3.4 px ずれていました。わずかな差ですが、結果をオリジナルに重ねて戻せないことを意味します。顔は少し柔らかく描き直され、何も指示していない部分でも背景が塗り直されます。コントロールネットでポーズを固定すればシーンはそのまま維持できましたが、およそ 5 回に 1 回は衣装の適用に失敗したため、この方法は採用されませんでした。
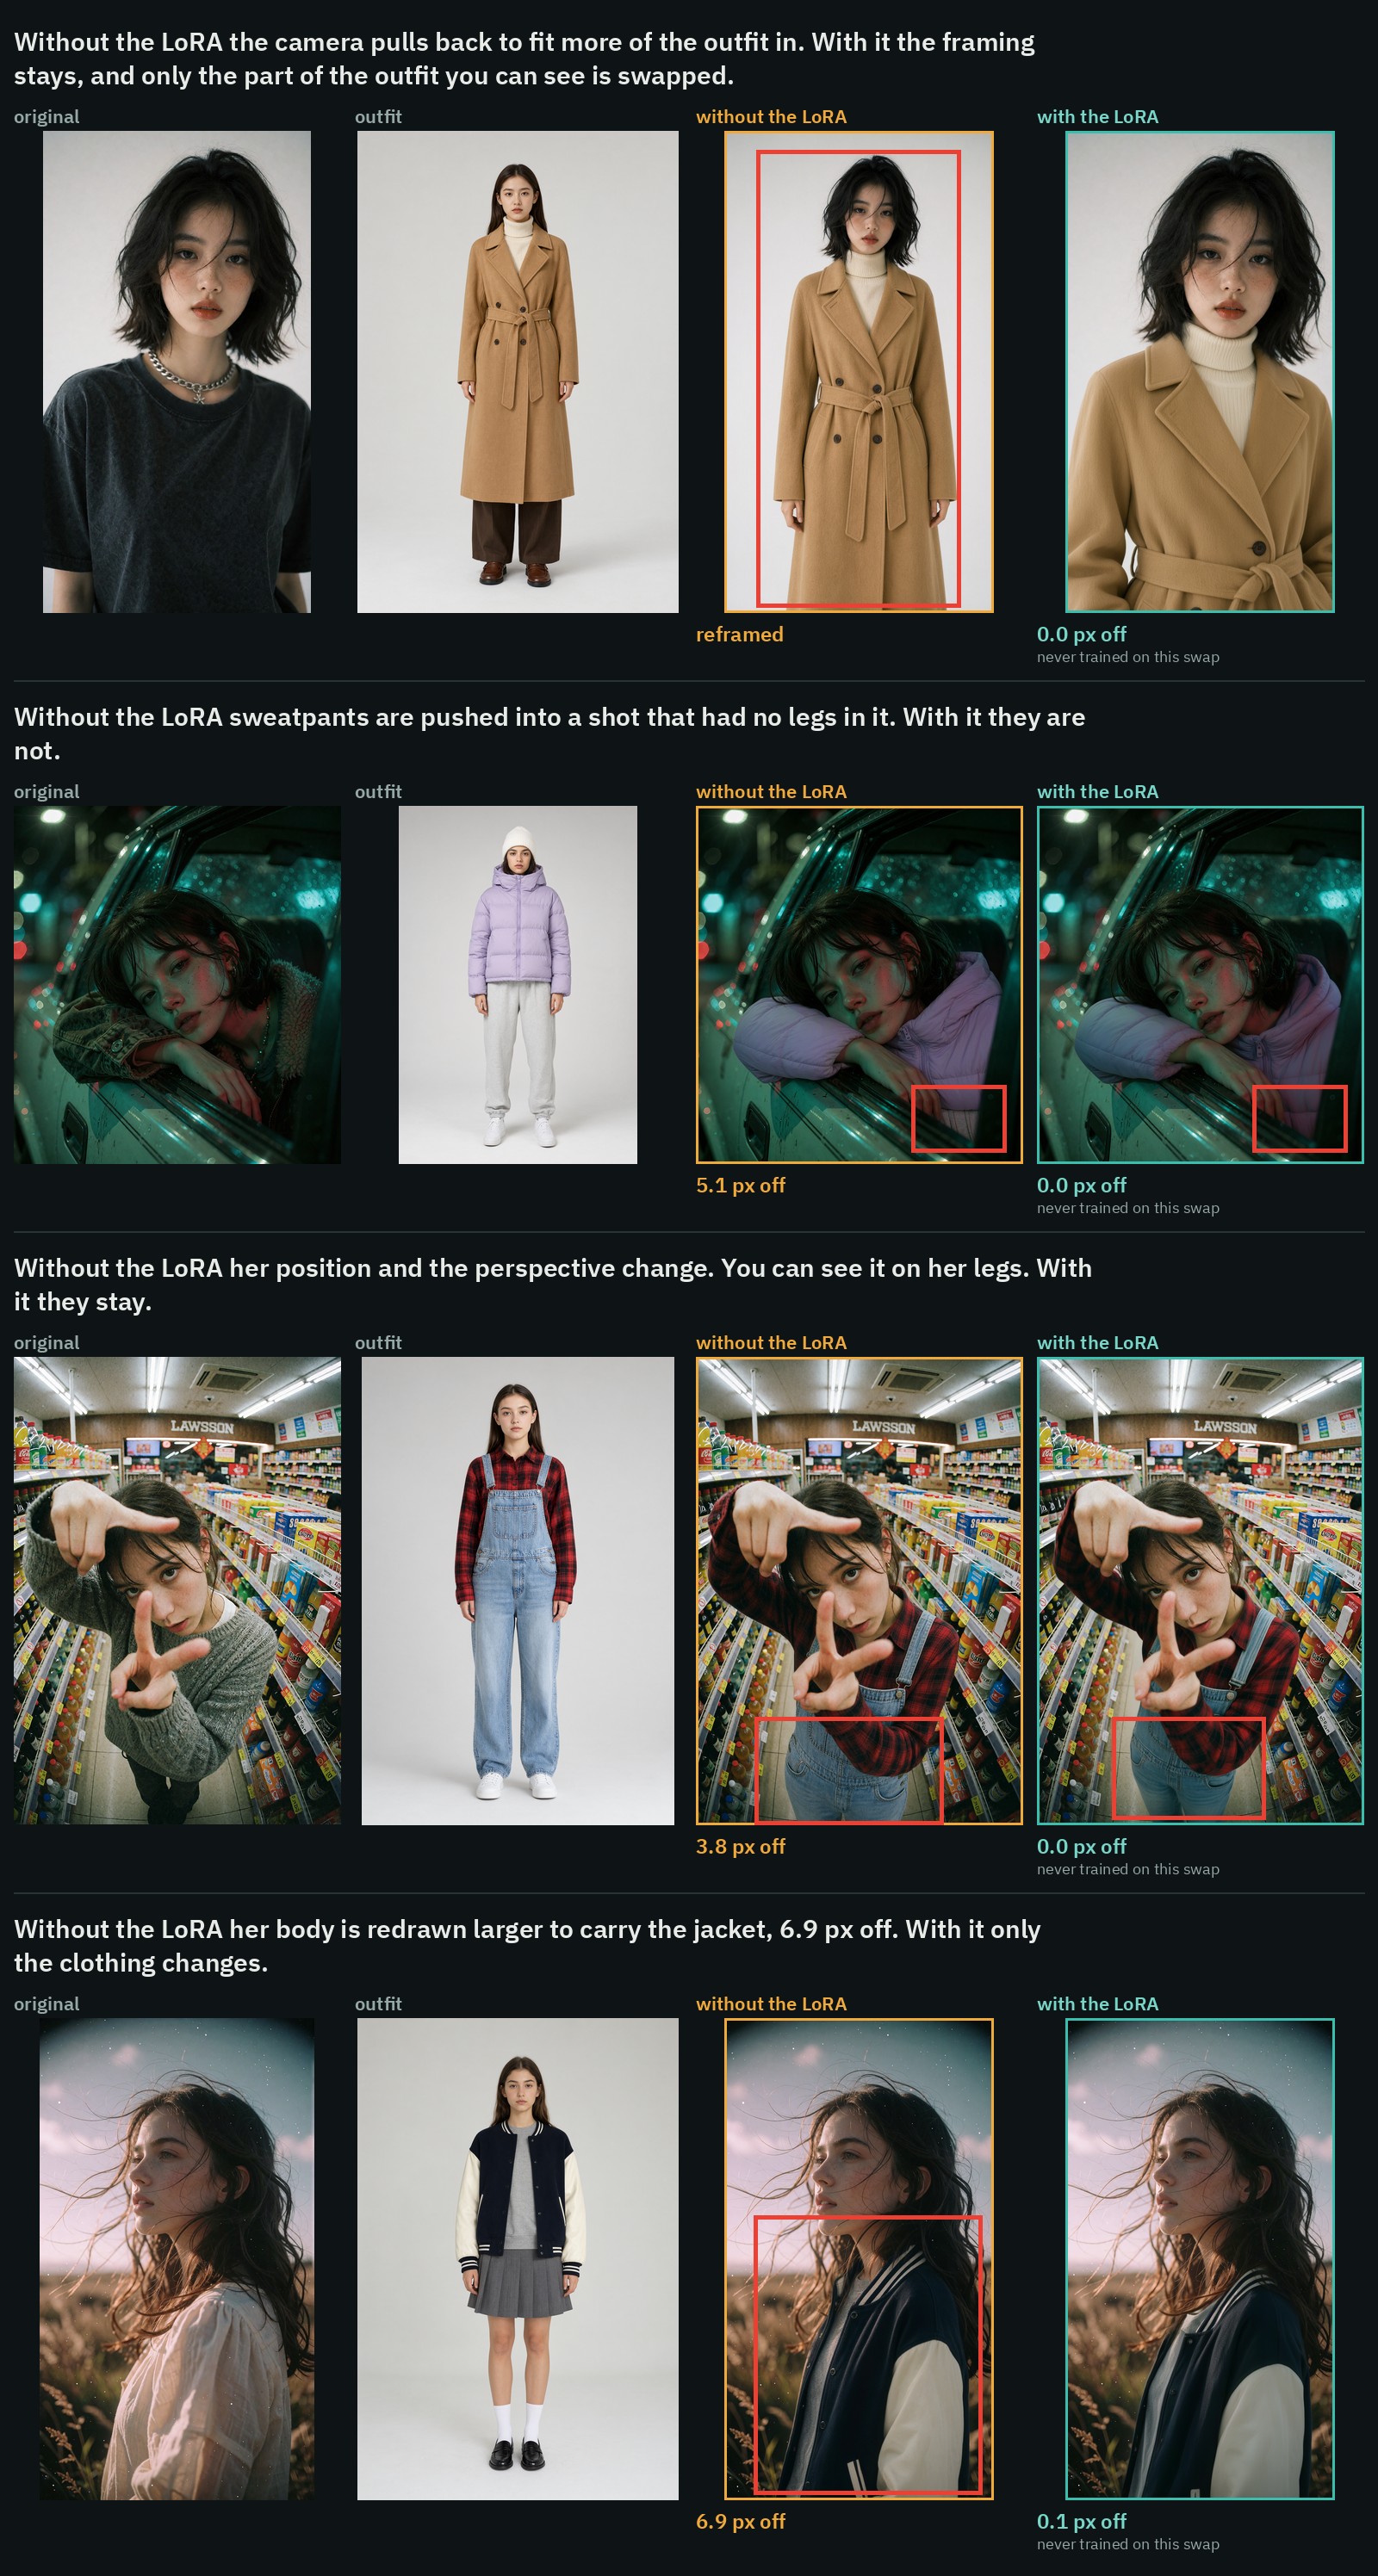
47 回の差し替えのうち 4 例。LoRA なしと LoRA ありで同じワークフローと同じシードを使用。いずれもトレーニングセットには含まれていません。
実測された保持性能
LoRAが学習していない16件のスワップを、すべて同じワークフローで、約2 MP、同じシード、25 steps、CFG 1、euler / simple、adapter 1.0で実行しました。「Off」は、結果の最もずれた角が人物画像からどれだけ離れているかを示します。顔と背景の数値は、結果を人物画像に位置合わせしたうえで測定しているため、ずれではなく描き直しを数えています。
| 16件のホールドアウトスワップ | LoRAなし | step 1,000 | step 1,250 | step 1,500 |
|---|---|---|---|---|
| 最もずれた角, 中央値 | 3.6 px | 0.1 px | 0.1 px | 0.1 px |
| 最もずれた角, 16件中最悪 | 7.0 px | 0.2 px | 0.2 px | 0.2 px |
| 目立って変化した顔のピクセル | 14.1 % | 1.7 % | 1.8 % | 2.0 % |
| 顔, 人物画像に対するPSNR | 29.8 dB | 37.8 dB | 37.7 dB | 37.1 dB |
| 目立って変化した背景のピクセル | 10.8 % | 0.9 % | 0.9 % | 1.2 % |
| 背景, PSNR | 27.6 dB | 40.5 dB | 40.4 dB | 40.0 dB |
強度も重要です。step 500 では、0.5 で 1.8 px のずれだったのに対し、1.0 では 0.1 px でした。つまり強度を半分にすると、ずれもおよそ半分になります。step 500 以降は、数値上はどのステップでも画像を同じように保持します。各ステップの違いは、新しい衣装が覆わない服に何が起こるかという点に現れます。
参考までに、上記の4つの単純な比較は、LoRAなしでは 4.8、7.1、5.2、7.2 px のずれで、LoRAありでは 0.1、0.0、0.0、0.1 px のずれでした。
元の服はどうなるのか
素のQwen-Image 2.1では、新しい服装が覆わない部分に元の服が残りがちです。ビキニの下にブーツ、スカートの下に破れたジーンズなどがその例です。その大半を決めるのはstepです。2つの着せ替え、それぞれ3シード、プレーンなリクエストでの結果は次のとおりです。
| 新しいスカートの下のジーンズが消えた | ビキニでブーツが消えた | |
|---|---|---|
| LoRAなし | 3回中0回 | 3回中0回 |
| step 500 | 3回中0回 | 3回中0回 |
| step 1,000 | 3回中2回 | 3回中2回 |
| step 1,250 | 3回中0回 | 3回中0回 |
リクエストの末尾に一文を加えると、step 1,000ではさらに制御できます。Replace everything they wear. は水着の下のタイツを脱がせ(靴は残りました)、Keep their own shoes and legwear. はプレーンなリクエストでは消えていたブーツを残しました。どちらの文もトレーニングのキャプションには含まれていなかったため、これはLoRAが画像の残りの部分を保ったまま、ベースモデルが指示に耳を傾けているということです。step 1,250と1,500では、同じ文を加えてもほとんど、あるいはまったく違いが生じませんでした。これも、このリリースがstep 1,000を推奨しているもう一つの理由です。配布されているワークフローでは、編集可能なボックス内に Replace everything they wear. がデフォルトで追加されています。
どのファイルを使うか
| ファイル | 備考 |
|---|---|
qwen-image-2.1-outfit-swap.safetensors | step 1,000、まずはここから。 古い衣装を部分的に残してしまうことが最も少なく、多くの場合で完全に消し去ってくれます。 |
qwen-image-2.1-outfit-swap-1250.safetensors | step 1,250。画像の保持性能はほぼ同じです。元から着ているもの(ブーツ、スカートの下のジーンズなど)をより多く残します。 |
qwen-image-2.1-outfit-swap-1500.safetensors | step 1,500、学習の最終地点です。保持性能は同じですが、顔と背景の変化がやや大きくなります。 |
3つとも rank 32 で、ComfyUI のキー命名規則を使用しているため、変換なしで Comfy-Org の Qwen-Image 2.1 の重みに読み込めます。
ComfyUIでの実行
このアダプターはモデル専用のLoRAなので、着せ替え自体にカスタムノードは不要です。リクエストは1文で記述し、人物をimage 1、衣装をimage 2とします:
Dress the person in image 1 in the <outfit, in a few words> shown in image 2. Keep their face, hair, hands, pose and the background exactly the same.2枚の画像を使う任意のQwen-Image 2.1編集グラフに追加するには:
.safetensorsファイルをComfyUI/models/loras/に配置し、モデルローダーの直後にLoraLoaderModelOnlyノードを追加して、strengthを1.0に設定します。- Text Encode Qwen Image 2.1ノードを使い、人物を
image_1、衣装をimage_2、resolutionを0に設定し、リクエストをプロンプトとして指定します。 - エンコーダーの
latent出力をKSamplerでサンプリングします。25ステップ、CFG 1、euler/simple、denoise 1です。 - VAE Decodeでデコードし、続いてSplit Image with Alpha(アルファで画像を分割)を実行します。Qwen-Image 2.1のVAEはRGBAでデコードするためです。
すぐに使えるワークフローがリポジトリに同梱されています。これは作者のComfyUI-AusBossノード(2.5.1以降)で構築されており、ComfyUI 0.38以降が必要です。カードには、同等のノードであれば何でも構わないと記されています。
同じ着せ替えをLoRAなしとLoRAありで並べて比較した実行例。モデルカードより。
さらに比較
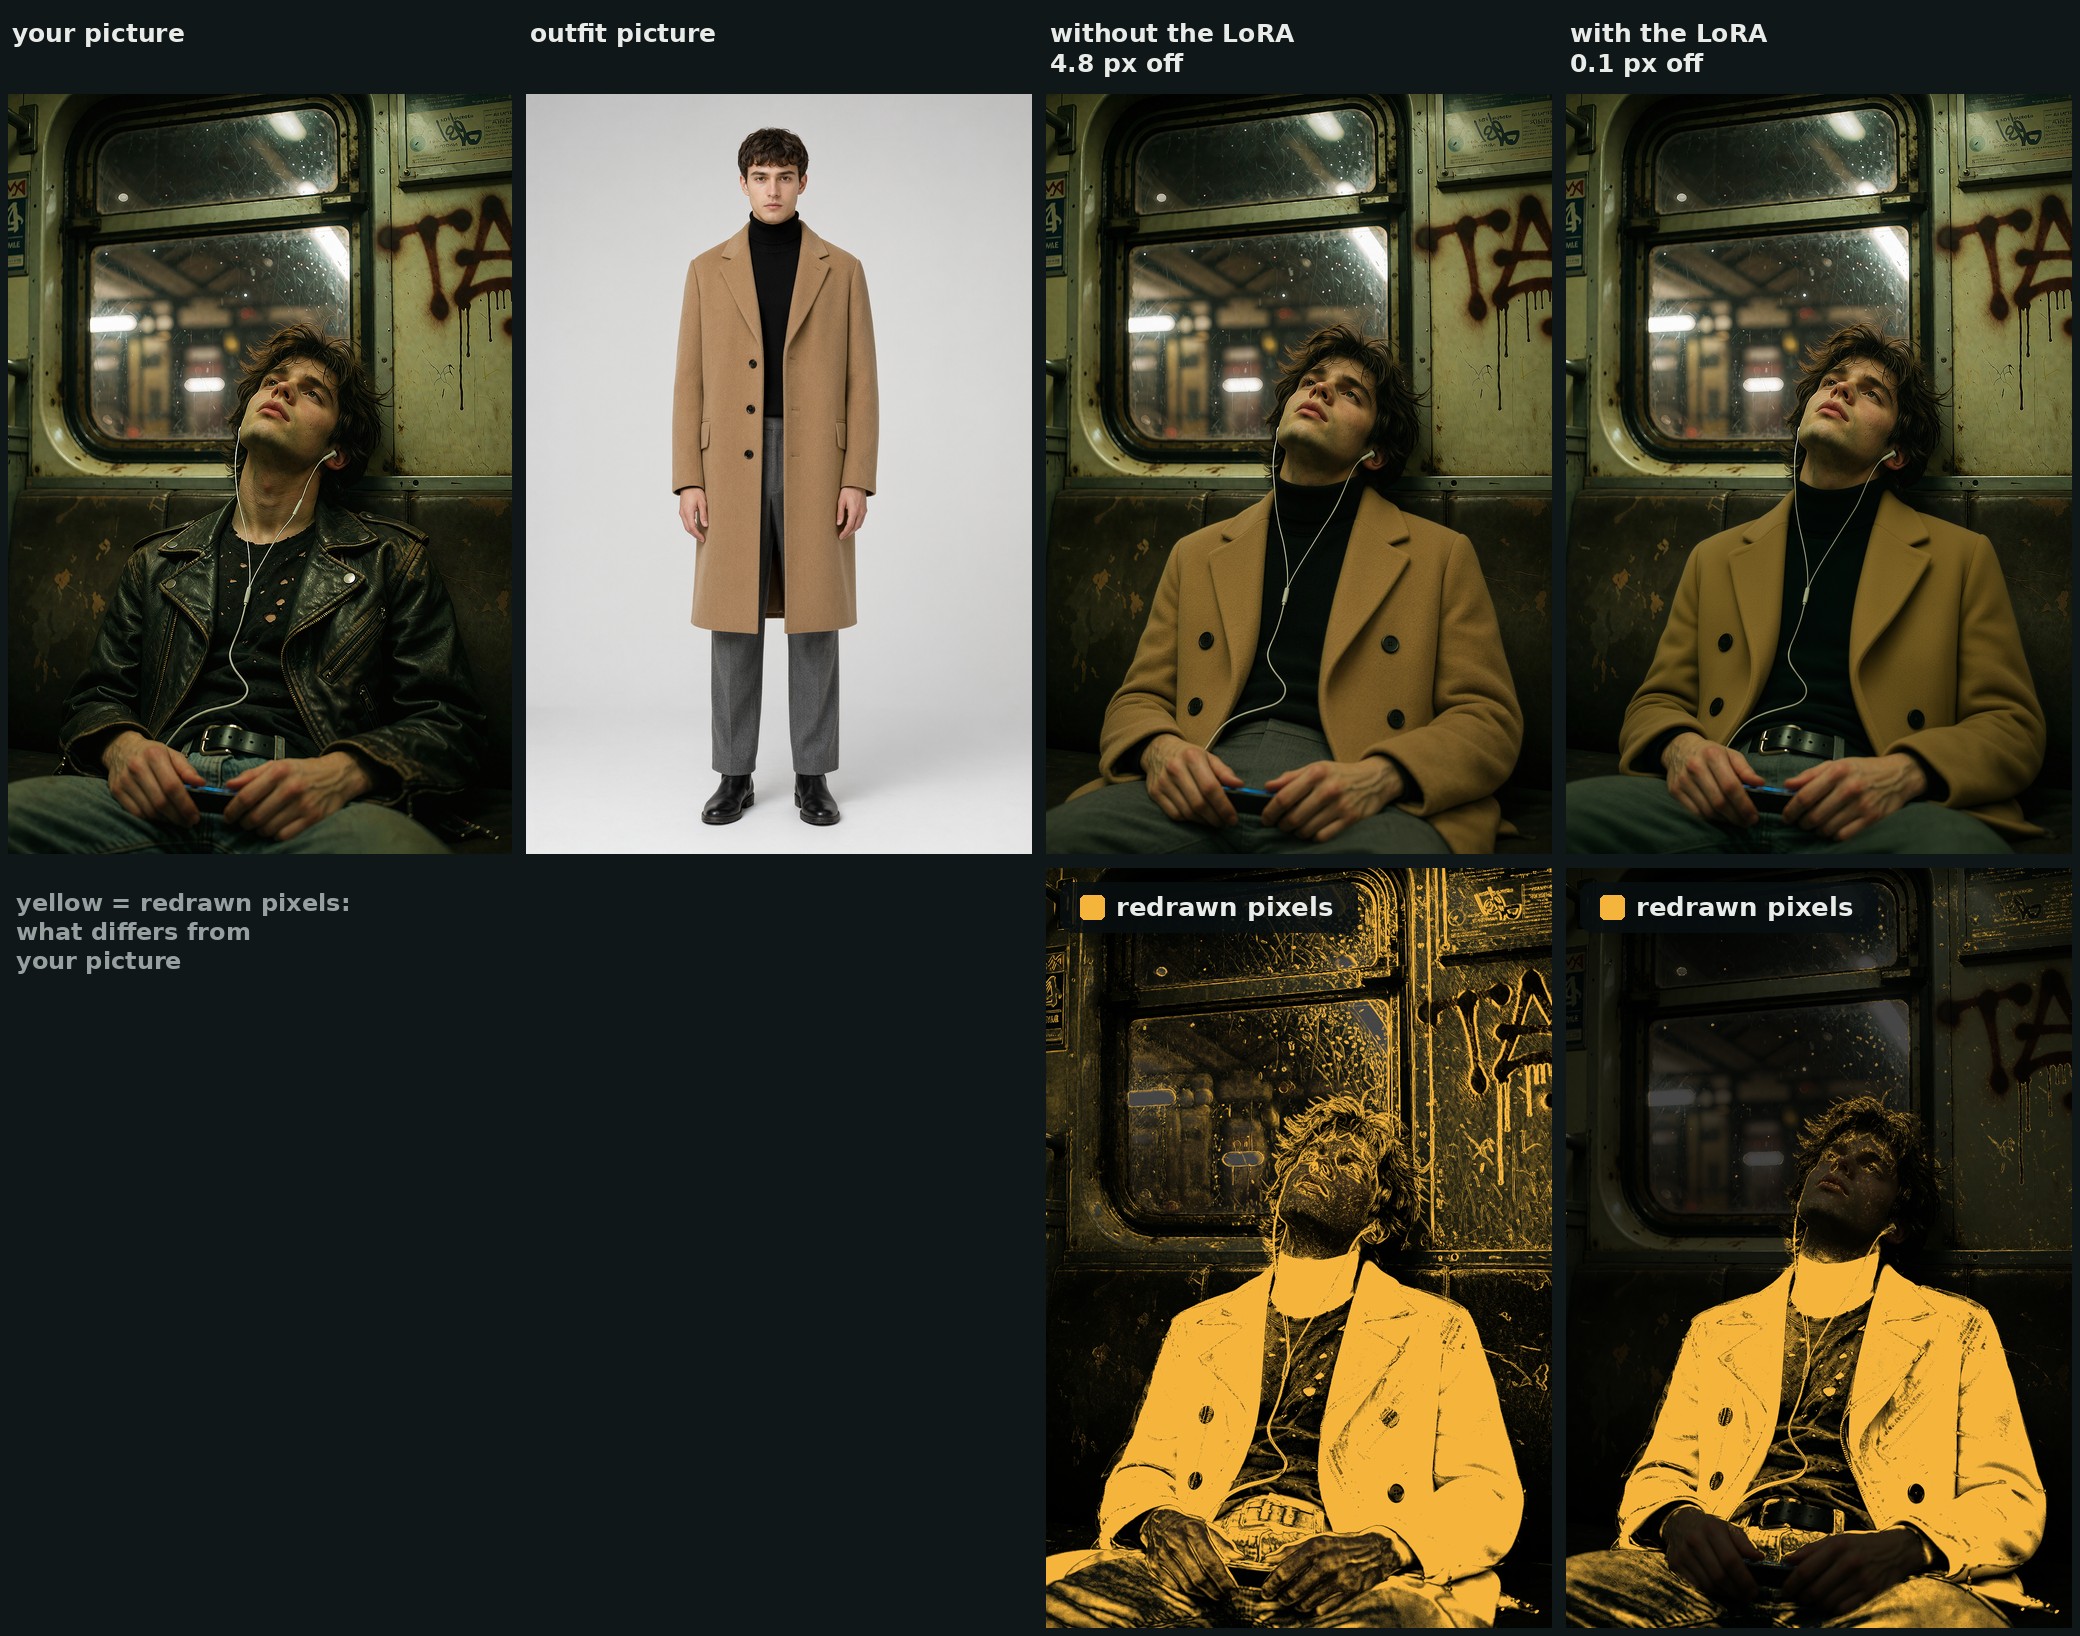
雨の中での同じ比較。この人物はトレーニングセットに含まれていません。
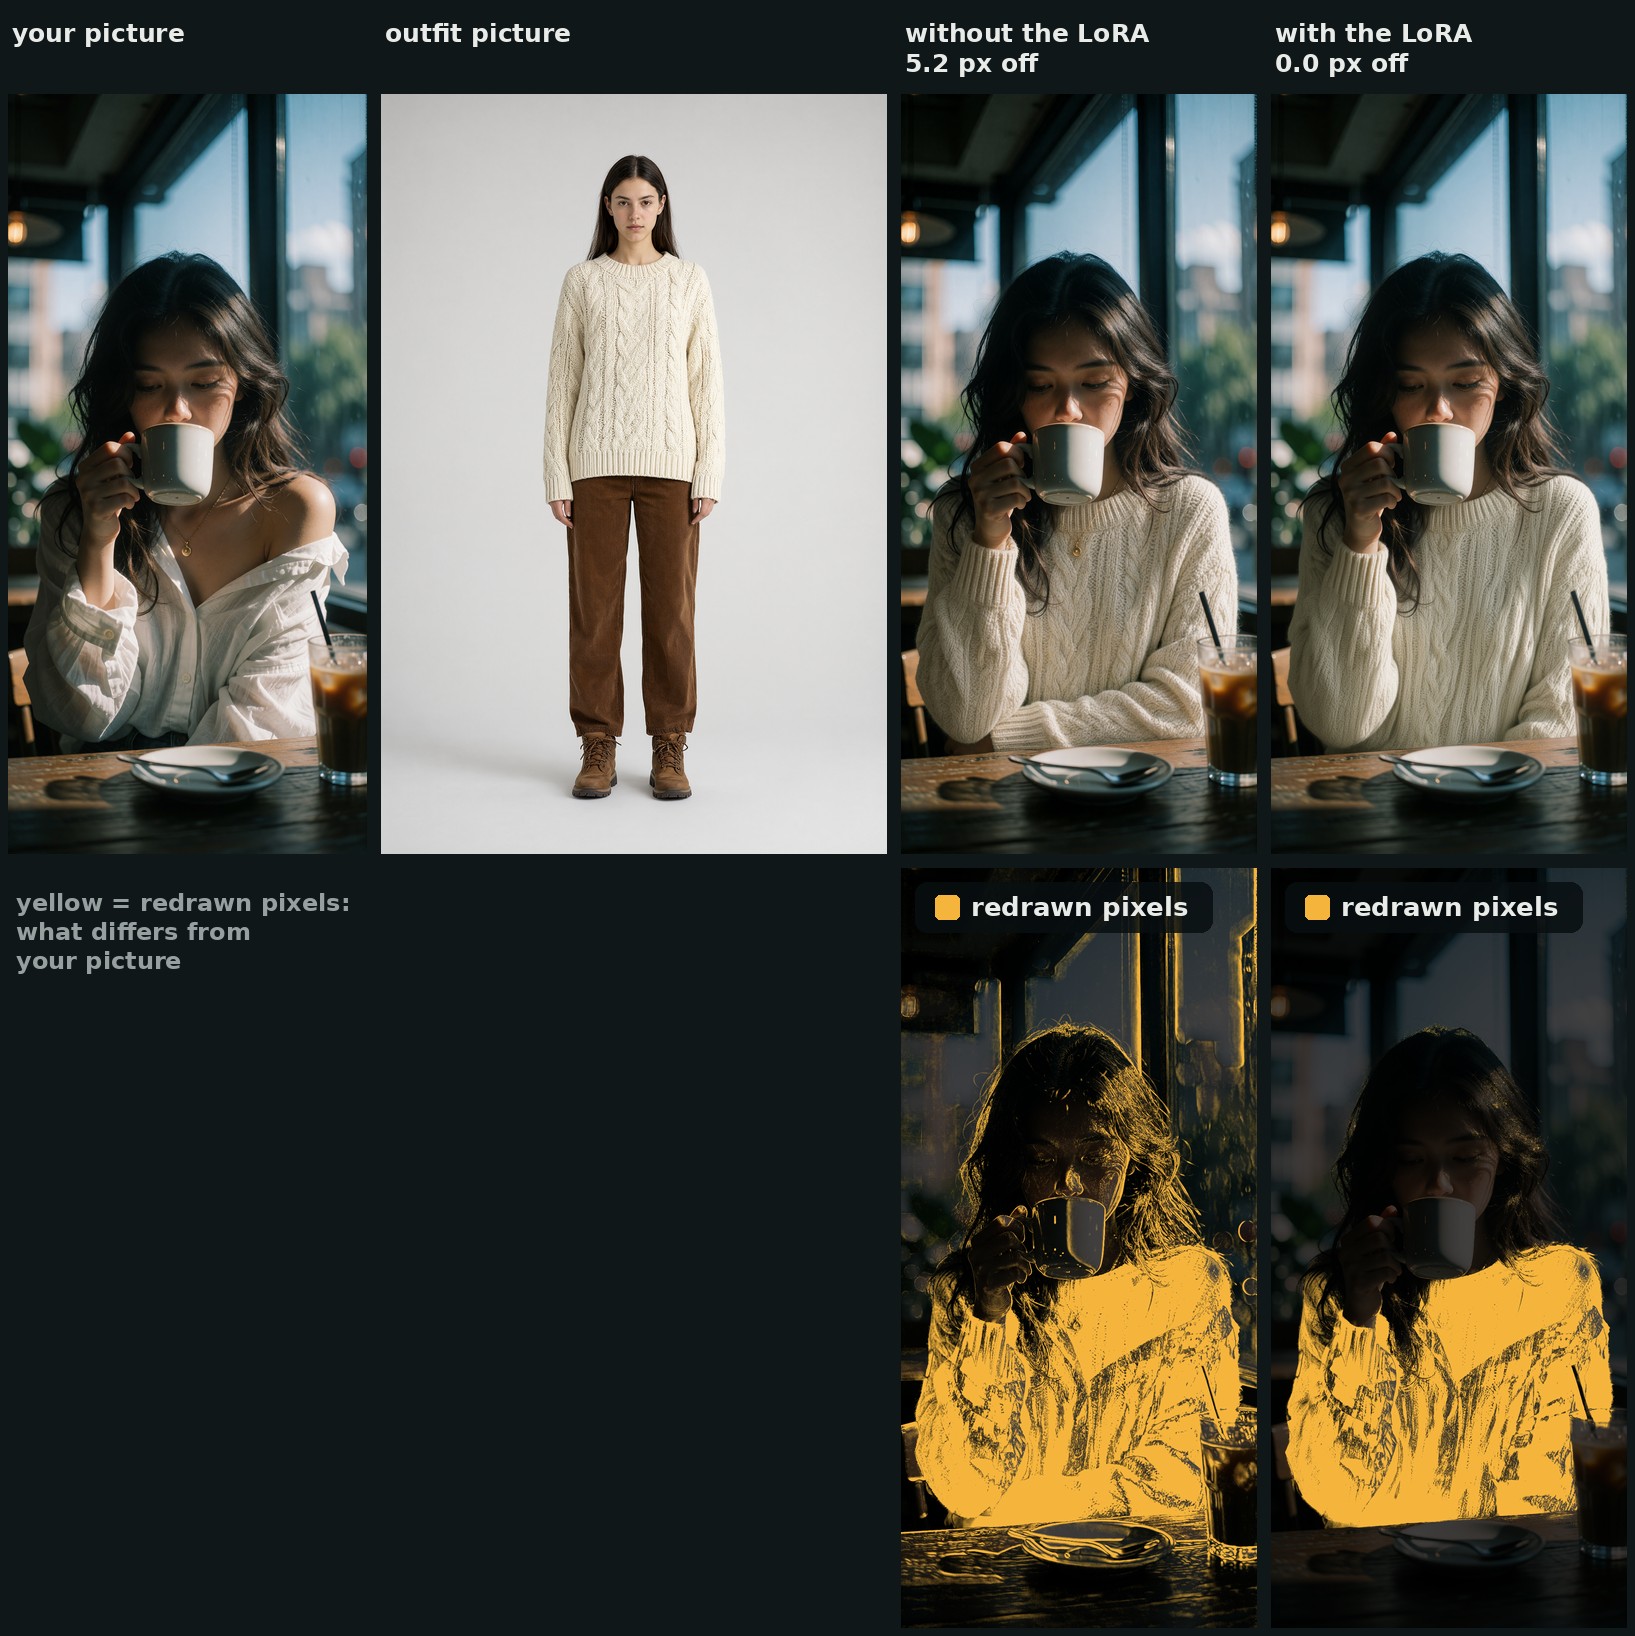
この人物もトレーニングセットに含まれていません。
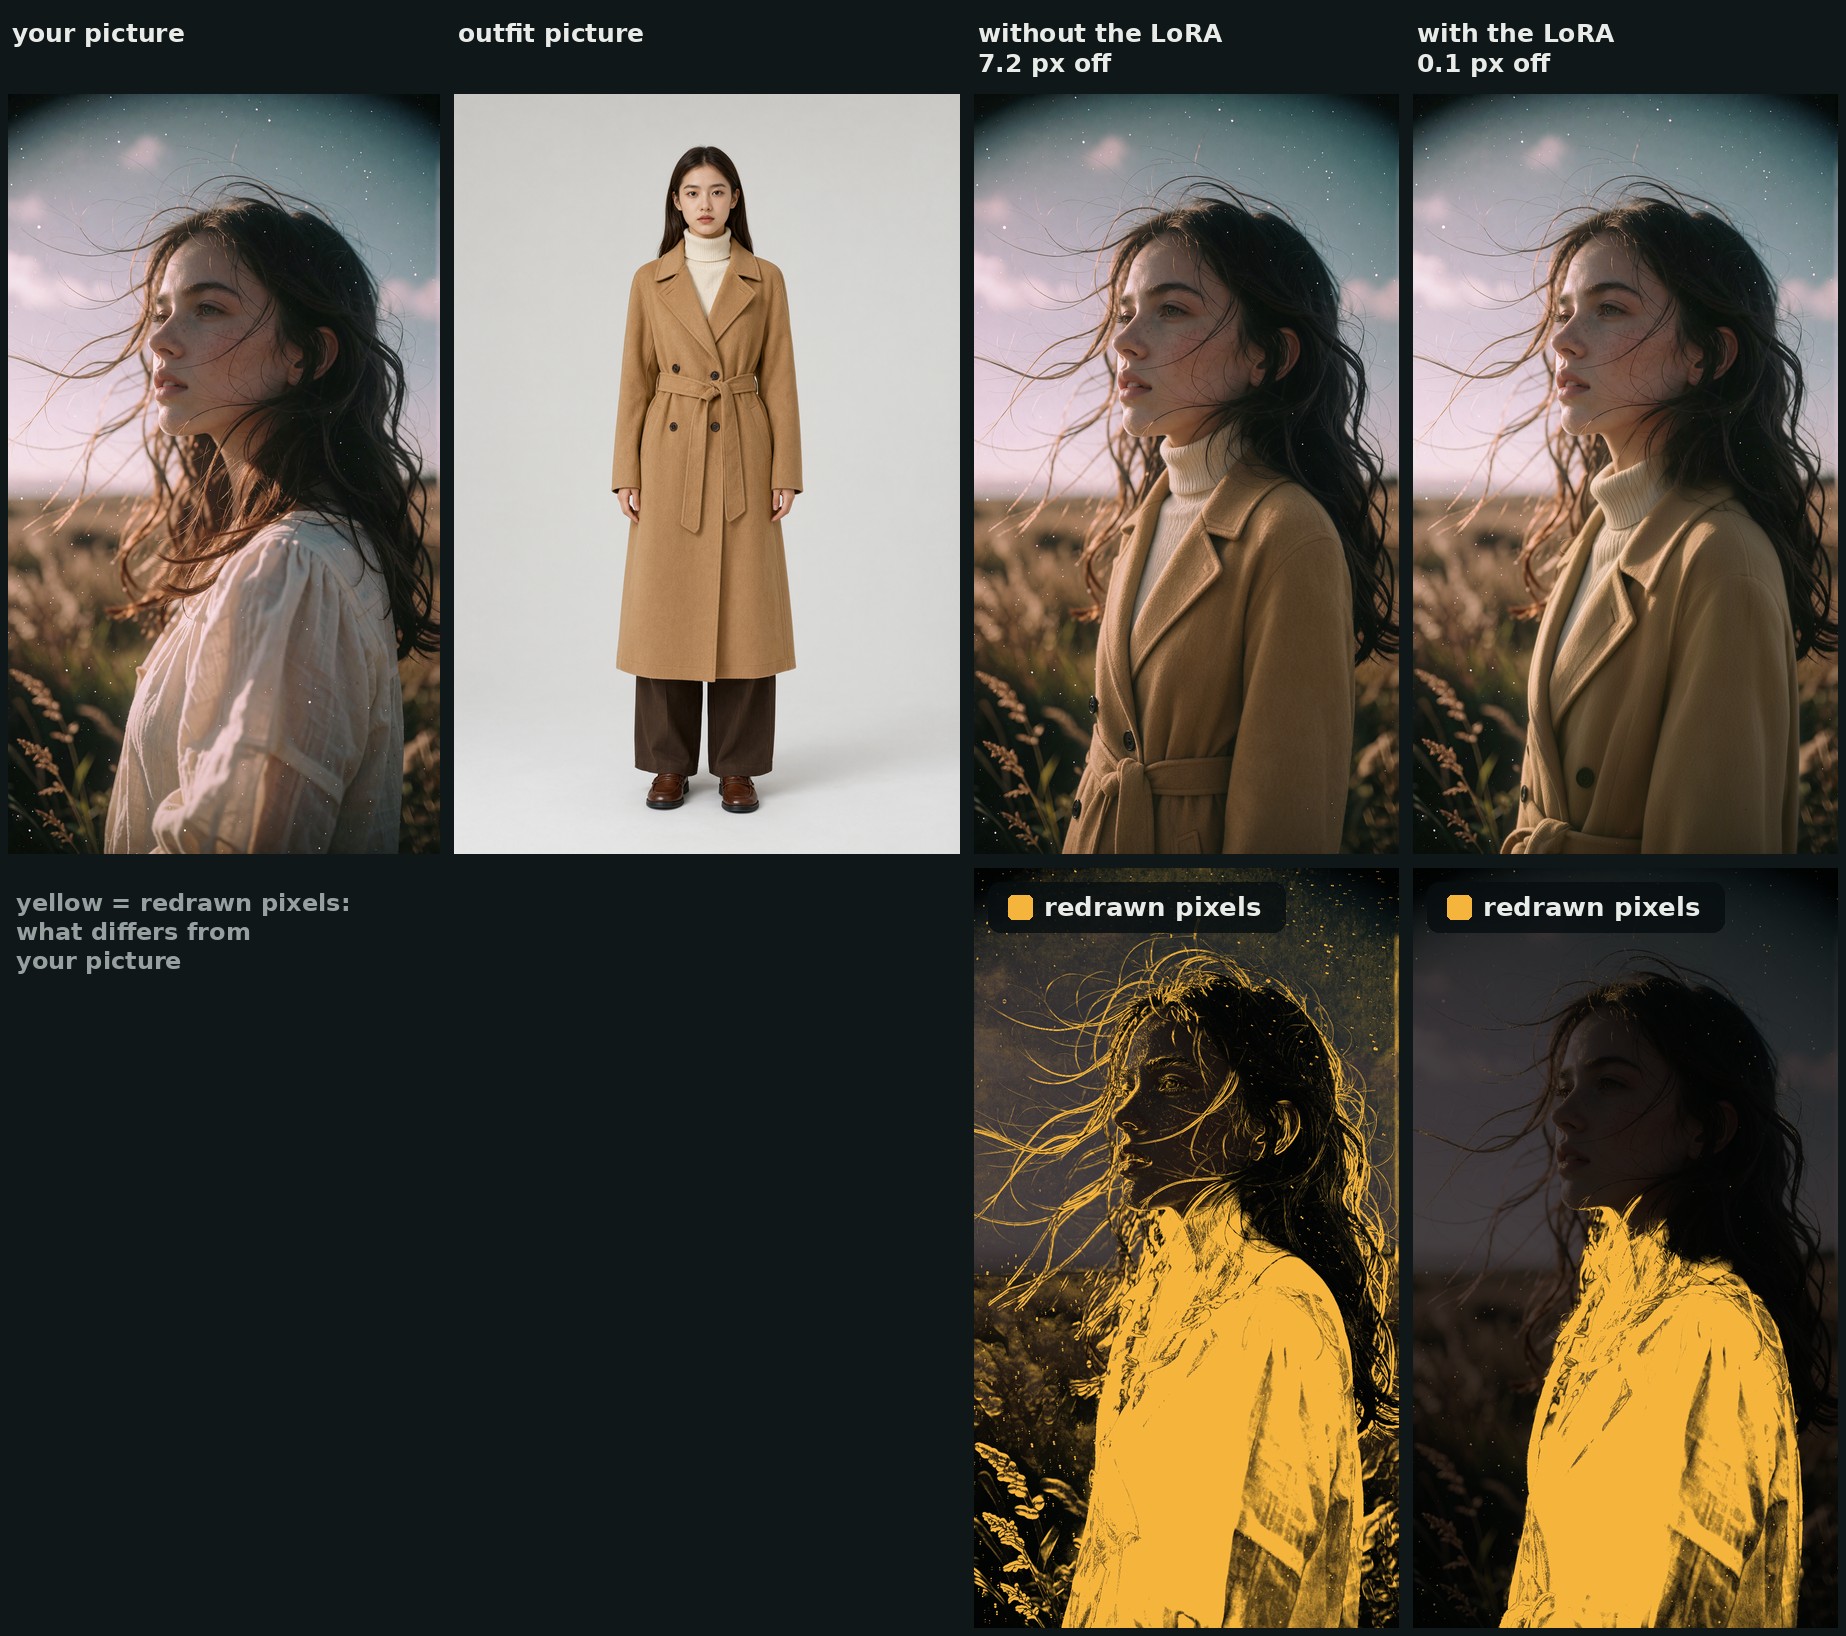
LoRAはこの人物の着せ替えをトレーニングしておらず、このコートもトレーニングセットに含まれていません。
トレーニング方法
データセットは実際の Qwen-Image 2.1 のスワップから構築し、すべてのトレーニングターゲットがソースのフレーム上に収まるように補正しています。生のスワップは良いターゲットではありません。位置ズレ、ぼやけた顔、塗り直された背景を抱えており、それでトレーニングした LoRA はそうした特徴を学習してしまいます。各結果は人物画像へピクセル単位で(リサンプリングせずに)戻し、スワップから持ってくるのは服だけです。顔、髪、手、背景は再び人物画像自身のピクセルになります。66 個のトレーニングターゲットのうち、40 個は作者の以前の Consistency LoRA を有効にして作成したスワップ由来、26 個は通常のスワップ由来です。22 個はピクセル単位の移動が必要で、ターゲットの中央値ではピクセルの 27 % をスワップから取得しています。
- 66 組のトレーニングペア。45 人の異なる人物と 31 着の異なる衣装(着用、平置き、商品撮影)を使用し、4 組はテスト用に保留しています。
- トレーニング: ostris/ai-toolkit を Comfy-Org INT8 ConvRot ベースで
arch: qwen_image_2として使用。各サンプルに 2 つの参照(人物と衣装)、キャプションは dropout 0。Rank 32、アルファ 32、AdamW8bit、lr 1e-4、バッチ 1、shiftタイムステップ、250 ステップごとにチェックポイントを保存しつつ 1,500 ステップ。RTX PRO 6000 1 基で 1 ステップあたり約 4.5 秒。
トレーナーのある細かい仕様が 1 回の実行を無駄にし、その内容はリポジトリの RESEARCH.md にまとめられています。AI-Toolkit はトレーニングターゲットを拡大縮小とクロップによってサイズバケットに合わせますが、参照画像は全体を読み込んで 32 px グリッドに押し込みます。画像の形状がバケットの形状でない場合、両者は一致しなくなります。resolution: 1024 では、1056 x 1888 のペアは 768 x 1344 になり、ターゲットは高さの 2 % を失い、代わりに参照が 2 % 押し縮められます。最初の実行は loss の上では問題なくトレーニングし、すべての画像を 1.6 % 縦長にする LoRA を生成しました。修正はトレーナー側ではなくエクスポート側にあります。揃える必要のあるターゲットと参照を同じサイズで書き出し、両辺を 32 の倍数にします。
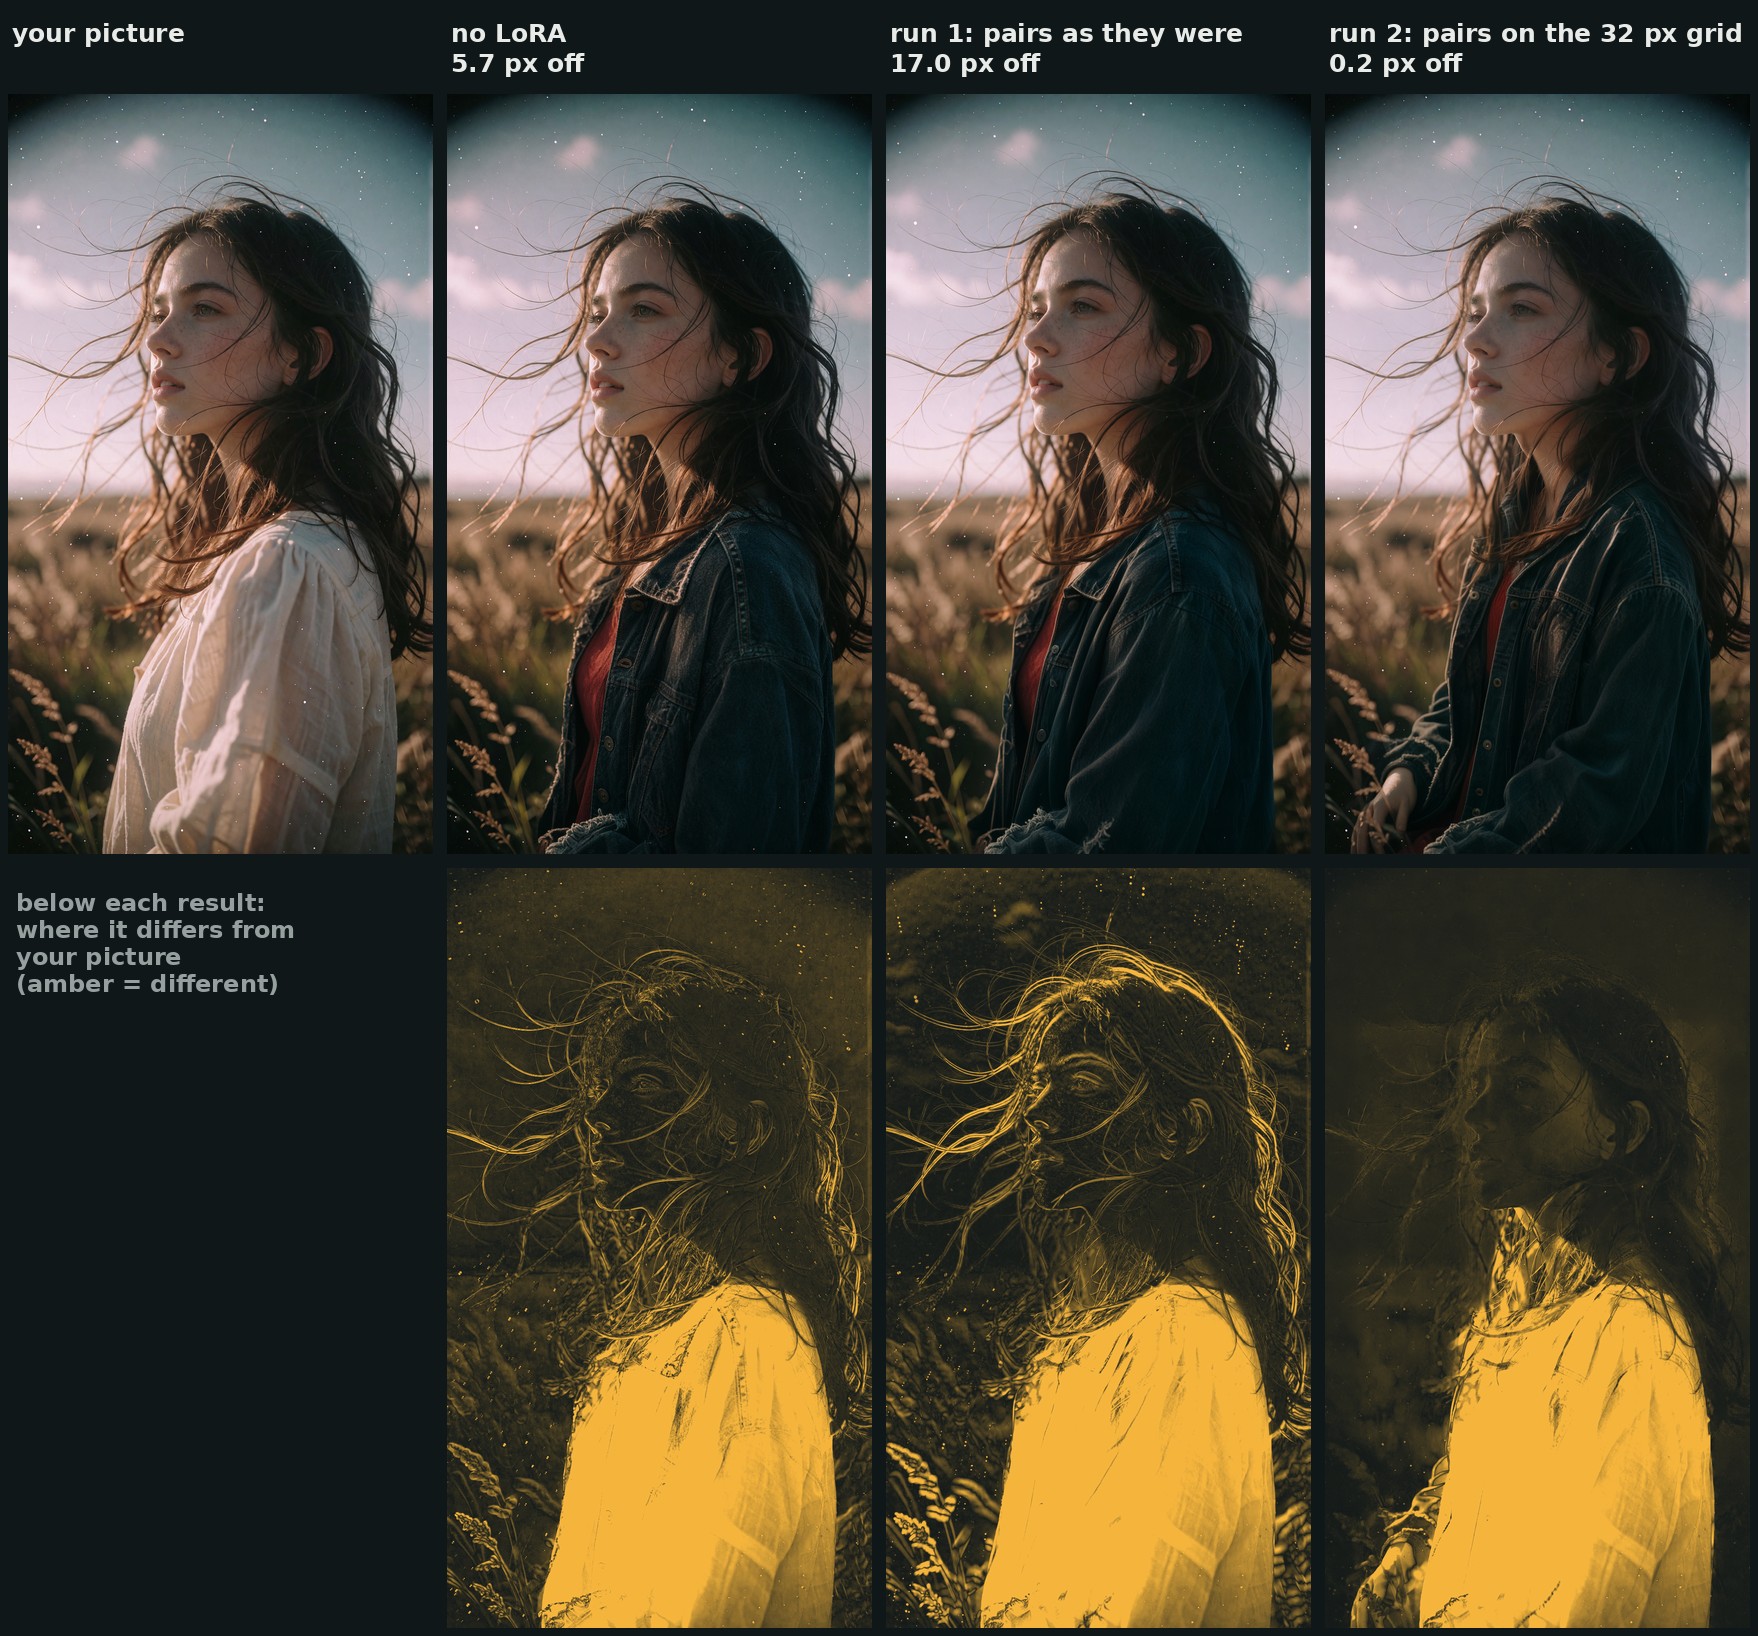
250 ステップ時点で、最初の実行は画像を引き伸ばしているため、すべてがオリジナルと異なります。修正後の実行ではそうなっていません。
制限事項
このカードは、今回のリリースがどれほど限定的かを率直に述べている。
- 素の Qwen-Image 2.1 よりも衣装を上手く描けるわけではない。ボタン、ベルト、柄はどのみち同じように出力されるし、素の Qwen のほうが衣装をより多くコピーしてしまうこともある。上の最初の比較では、素の Qwen はパンツまで入れ替えてしまったが、LoRA は元のジーンズとベルトを維持した。
- 元からあったものを保持するため、ポーズも保持される。別のポーズを必要とする衣装に変えることはできない。
- 靴が最も手強い部分である。
Replace everything they wear.を指定しても、3回のテストのうち1回では靴が残ってしまった。 - 初期のチェックポイント(step 250)では、1回の入れ替えで画像に存在しない手が描かれた。step 500〜1,500 では16回中いずれも発生しなかったが、確認したのは16回だけである。
- 約 1 MP で学習し、約 2 MP、25 steps、CFG 1 でテスト。
- Viggle Turbo LoRA を 8 steps で使っても構図は保持される(5回の入れ替えで 0.05〜0.24 px)。ただし無地の生地は少しざらつくことがある。
- 衣服の上に重なっているものは、古い衣装と一緒に消えてしまったり、新しい衣装の上で不自然に乗ってしまったりする。ジャケットの上を通っていたイヤホンケーブルは取り除かれ、新しいジャケットの上ではハンドバッグのストラップが不自然に見えた。
入手方法
- LoRA ウェイト: ausboss/Qwen-Image-2.1-Outfit-Swap-Consistency-LoRA
- ベースモデルの再パッケージ: Comfy-Org/Qwen-Image-2.1
- 作者のノードパック: ausboss/ComfyUI-AusBoss
コメント
GitHubでサインインしてディスカッションに参加しましょう。