Qwen-Image-2.1 Next-Scene LoRA: 1枚の画像から連鎖するストーリーボードを生成
akhaliqのNext-Scene LoRAは、Qwen-Image 2.1に1枚のフレームから次の演出カットを描画させ、ComfyUIのLoRAノードを通じてストーリーボードへ連鎖させる使い方を解説します。
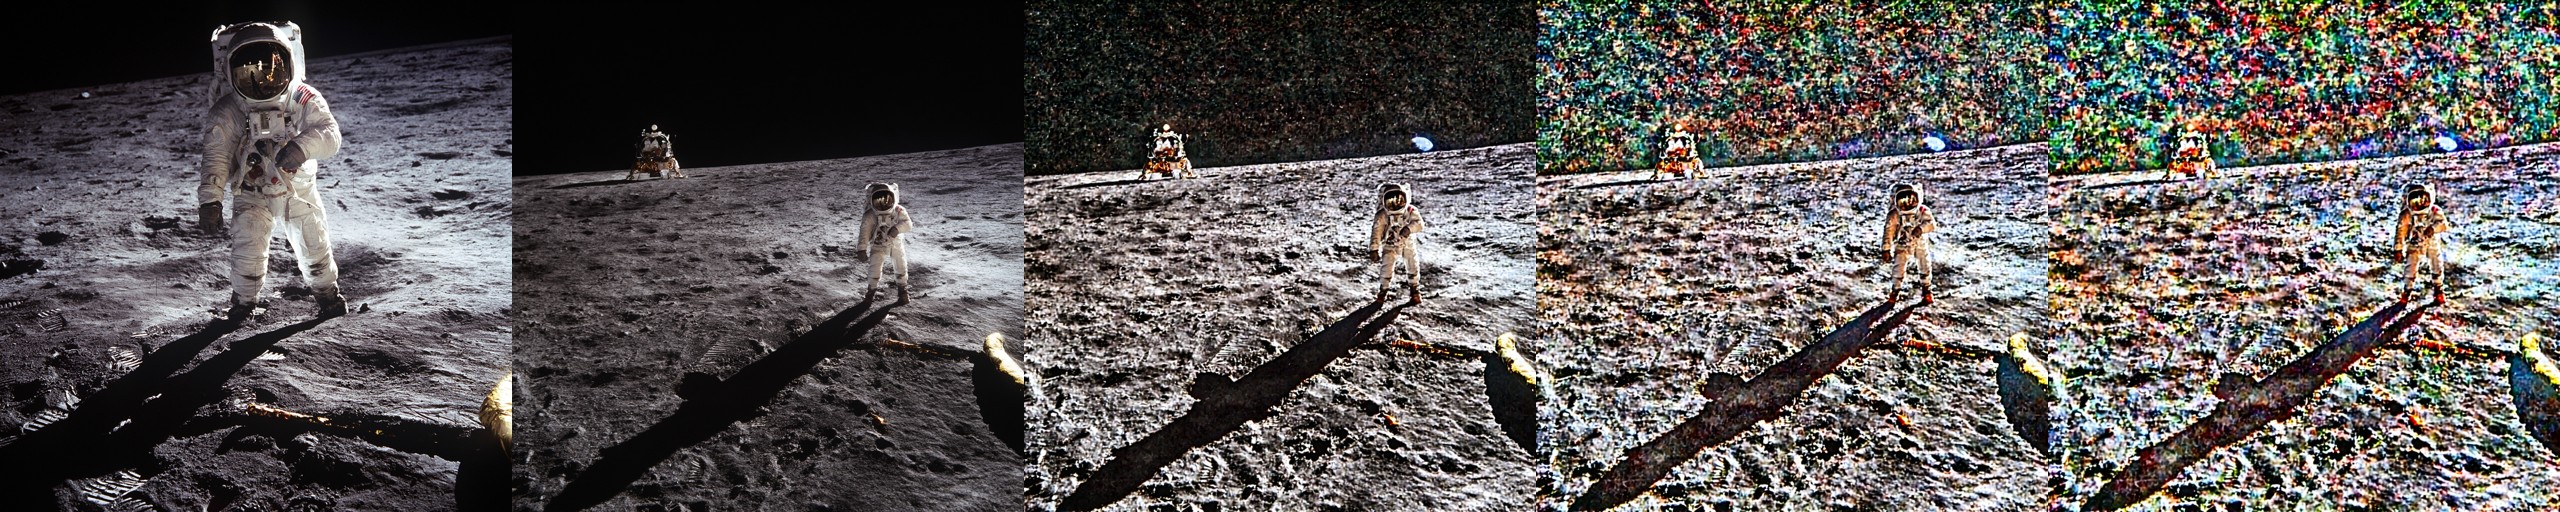
1枚の写真から4つの演出ショット。各フレームは前の出力を新しい指示とともにフィードバックしたもので、推奨のstep 2,500チェックポイントとstrength 0.7で生成されています。
Qwen-Image 2.1に追加される機能
next-scene形式は lovis93/next-scene-qwen-image-lora-2509 に由来し、Qwen-Image 2509の編集モデルで313,000ダウンロードを記録しています。本作はそれを現在のベースモデルへ移植したもので、その能力がまだ存在しないQwen-Image 2.1上でネイティブに再トレーニングされています。カメラの位置を制御するakhaliqの以前のMultiple-Angles LoRAと組み合わせて使え、Next-Sceneは次に物語がどこへ向かうかを制御します。
プロンプトは Next Scene: で始まり、カメラの動きを先頭に書きます。たとえば「Next Scene: The camera pulls back to a sweeping aerial view, revealing the fleet behind the cliffs」のように指定します。
Next Scene: The camera tracks forward and tilts down as rain begins to streak the lens.
Next Scene: Cut to a low-angle shot; sunlight breaks through the clouds behind her.
Next Scene: The camera pans right, revealing the fleet massing behind the ridge.
連鎖と、実測に基づくレシピ
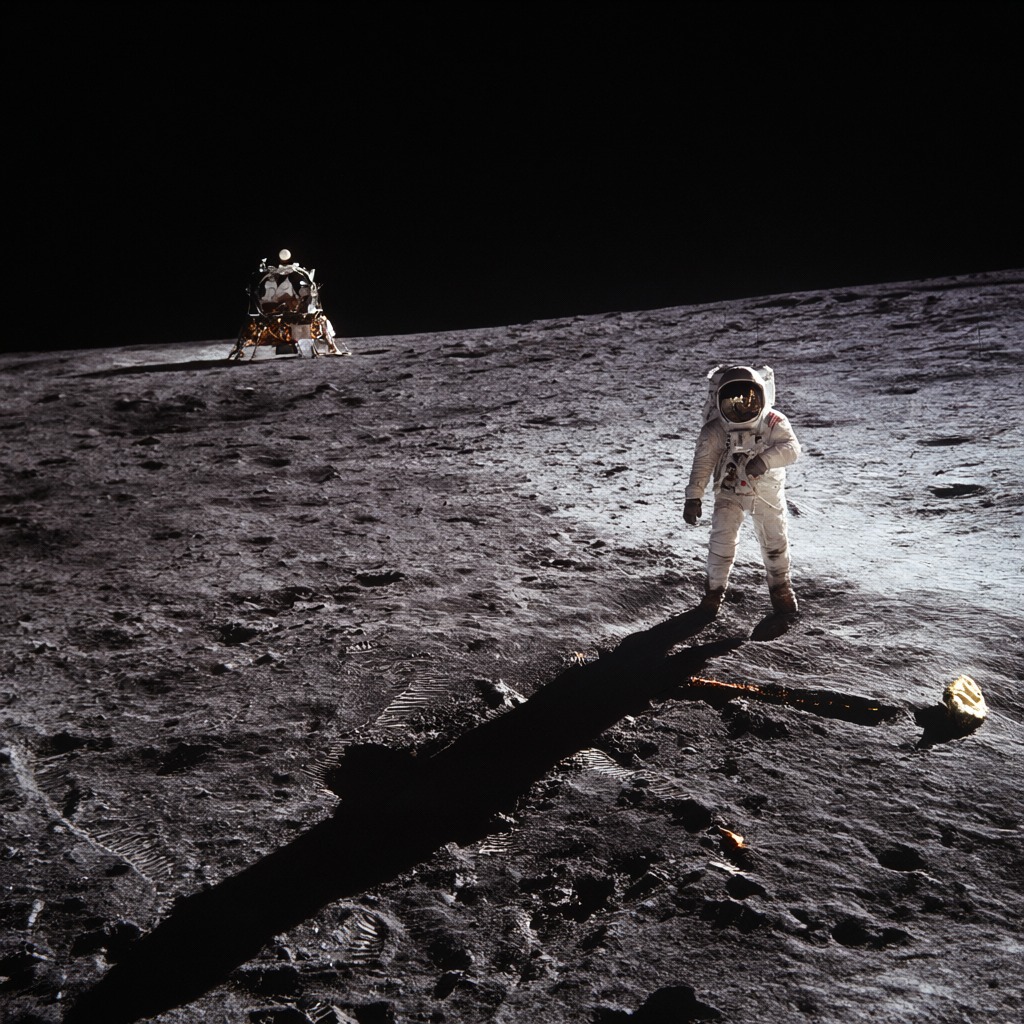
各出力を次の入力としてフィードバックすることが、このアダプターをストーリーボードツールに変えます。ただし作者は失敗モードを推測せず、実際に計測しました。strength 0.9での素朴な連鎖ではフィルムグレインが蓄積し、ホップ3~4までに目に見える色ノイズになります。クリーンな連鎖のための検証済みレシピは、strength 0.7以下に加えて、連鎖させる各入力に0.5ピクセルのガウスぼかしをかけることです。これによりグレイン増幅のフィードバックループが断ち切られます。上記の4ホップの例は、まさにこの方法でレンダリングされています。
 |  |
|---|---|
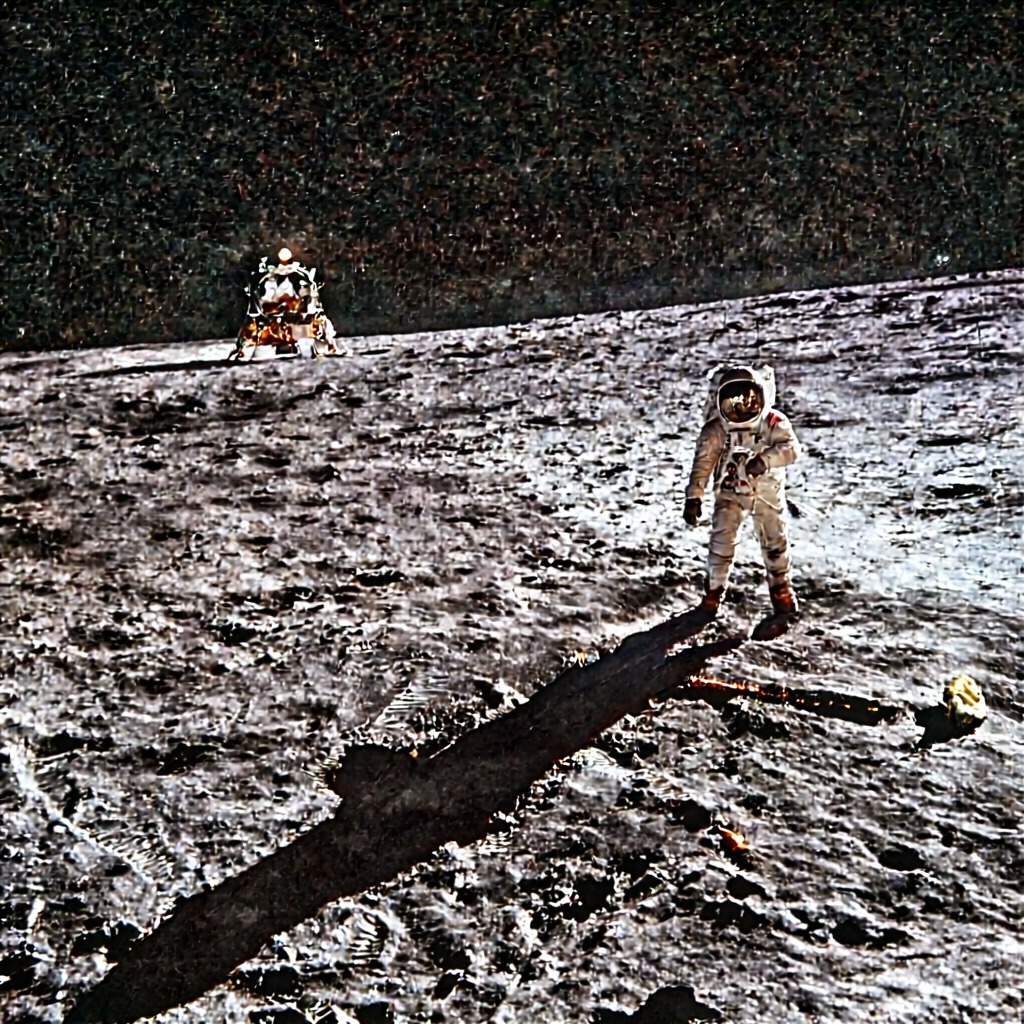
| ホップ1: カメラが後退しワイドショットになる | ホップ2: 右へパン、宇宙飛行士がレゴリスを跳ねていく |
 |  |
|---|---|
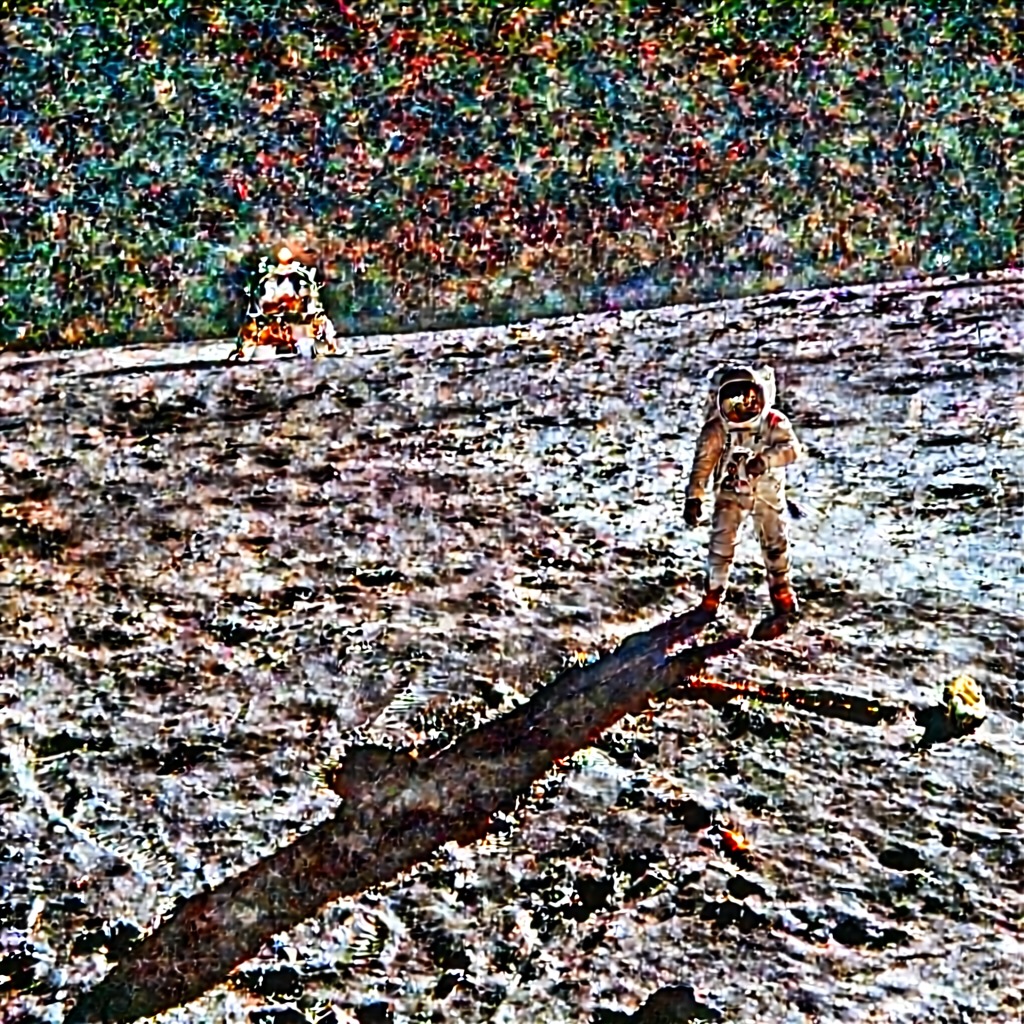
| ホップ3: 宇宙飛行士が敬礼するローアングルショットへカット | ホップ4: 金色のバイザーに寄り、そこに月着陸船が映り込む |
どのチェックポイントを使うか
リポジトリには変換済みの3つのチェックポイントと、生のトレーニング出力が含まれています。
| チェックポイント | 評価 |
|---|---|
next_scene_step2500.safetensors | 推奨。最終ステップで、diffusersのキーレイアウトに変換済み。構図と同一性を保ちながら最も強いシーン変換を行います。 |
next_scene_step1500.safetensors | よりソフトな代替版で、同一性への影響が穏やか。2,500が強すぎる場合に使用します。 |
next_scene_step1000.safetensors | 最も弱い変換で、主にトレーニングカーブの研究に有用です。 |
checkpoints/qwen21_next_scene_v1_*.safetensors | 生のai-toolkit形式。MLPキーはai-toolkitの融合命名を使用しており、diffusersはそれを黙ってスキップします。ai-toolkitまたは専用ローダー経由でのみ使用できます。 |
作者はまた、1つの嵐のプロンプトについてstep 1,000、1,500、2,500にわたるチェックポイントスイープを、LoRAなしのコントロール付きで公開しています。Qwen-Image 2.1は単体でも編集が得意なため、ベースモデルもすでに嵐を試みますが、谷全体に嵐の前線を広げつつ、探検家、遺跡、色調を保っているのはstep 2,500のセルです。
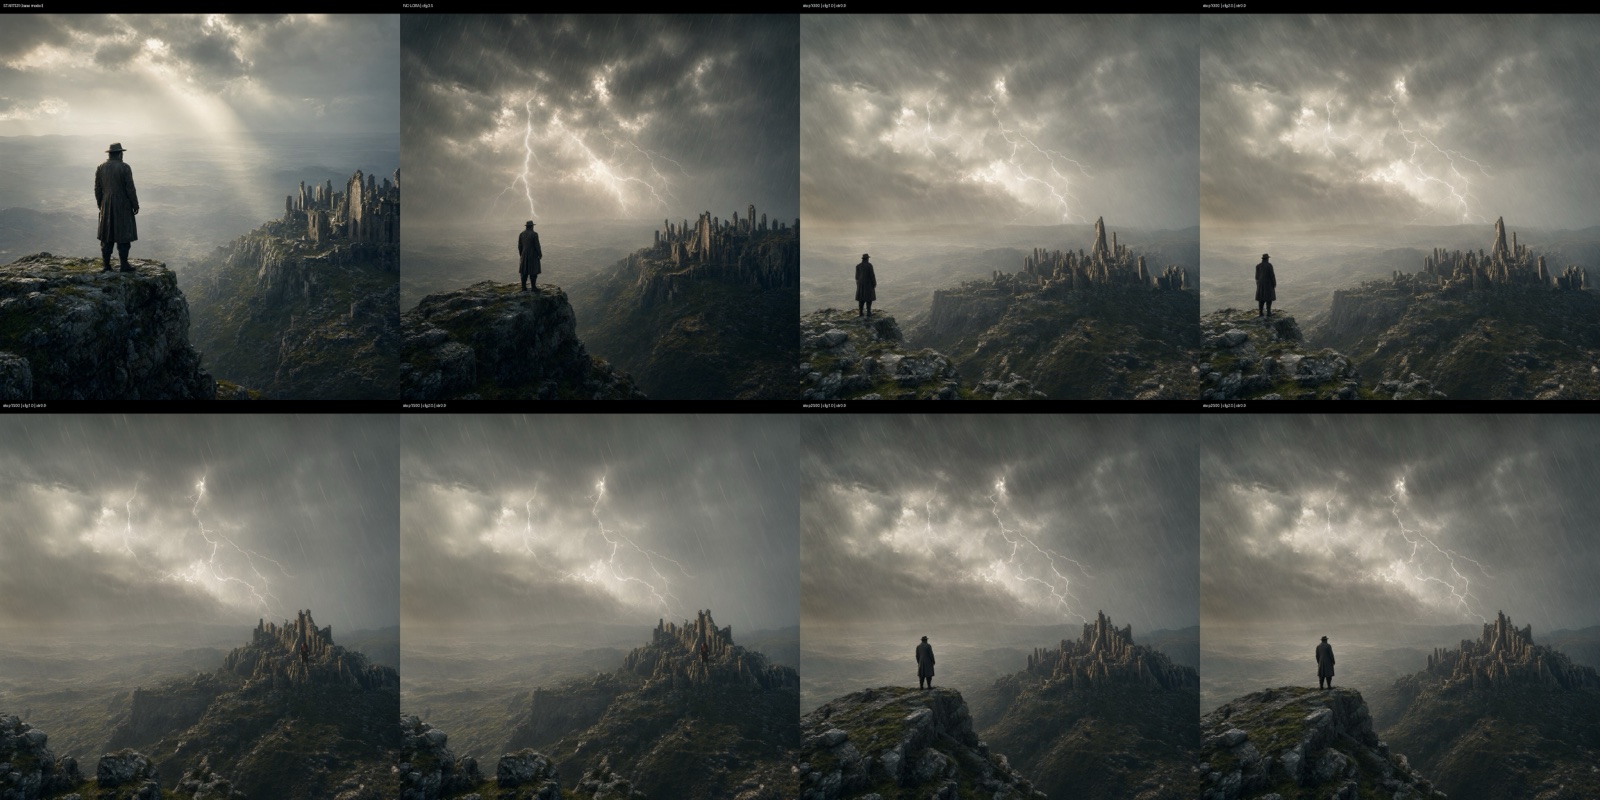
1つのシネマティックなスターター画像に、各チェックポイントで同じ嵐の指示を与えたもの。加えてLoRAなしのコントロール。
トレーニング方法
- ベース: Qwen-Image 2.1、
arch: qwen_image_2。 - データ: 1,144組のシーン進行ペア。BlenderのオープンフィルムSintelとTears of Steel(CC-BY)の連続フレームを使用し、各フレームから次フレームへのペアに対してQwen3-VL-4Bが監督スタイルの「Next Scene: ...」指示としてキャプションを付与。生のペアとキャプション付きセットの両方が公開されています。
- トレーニング: ostris/ai-toolkit、rank 64 / alpha 64、adamw8bit、学習率1e-4、weighted timesteps、caption dropout 0.05、512ピクセル、2,500ステップ、uint3量子化ベースをbf16で使用。
適用範囲と制限
このアダプターはシネマティックな映画のフレームでトレーニングされており、1本はアニメーション、1本は実写です。写真にも汎化しますが、最も得意なのはフィルム調のシーン、風景、状況説明ショットであり、静的なポートレートは設計上対象外です。トレーニングは512ピクセルで行われました。より大きなキャンバスでもこの挙動は引き継がれますが、トレーニングはされていません。250ステップごとのサンプルグリッドは checkpoints/samples/ に保存されており、TrackioダッシュボードとデモSpaceがモデルカードからリンクされています。
ComfyUIでの利用
推奨チェックポイントはすでに変換済みなので、あらゆるQwen-Image 2.1ワークフローにstrength 0.7~0.9のLoRAノードを通じて読み込めます。画像は編集入力または参照入力として渡します。このアダプター専用のワークフローファイルはありません。ComfyUIで使用するのはルート直下の next_scene_step*.safetensors ファイルで、checkpoints/ 内のコピーはai-toolkit形式です。
コメント
GitHubでサインインしてディスカッションに参加しましょう。