Prism: 2Kの動画・音声同時生成を2.5倍のトレーニング速度で実現
復旦大学、Tencent Hunyuan、浙江大学によるPrismは、動的スパースアテンションで2Kの動画・音声同時生成モデルをトレーニング。フルアテンション比2.5倍高速で、プレビューウェイトも公開。
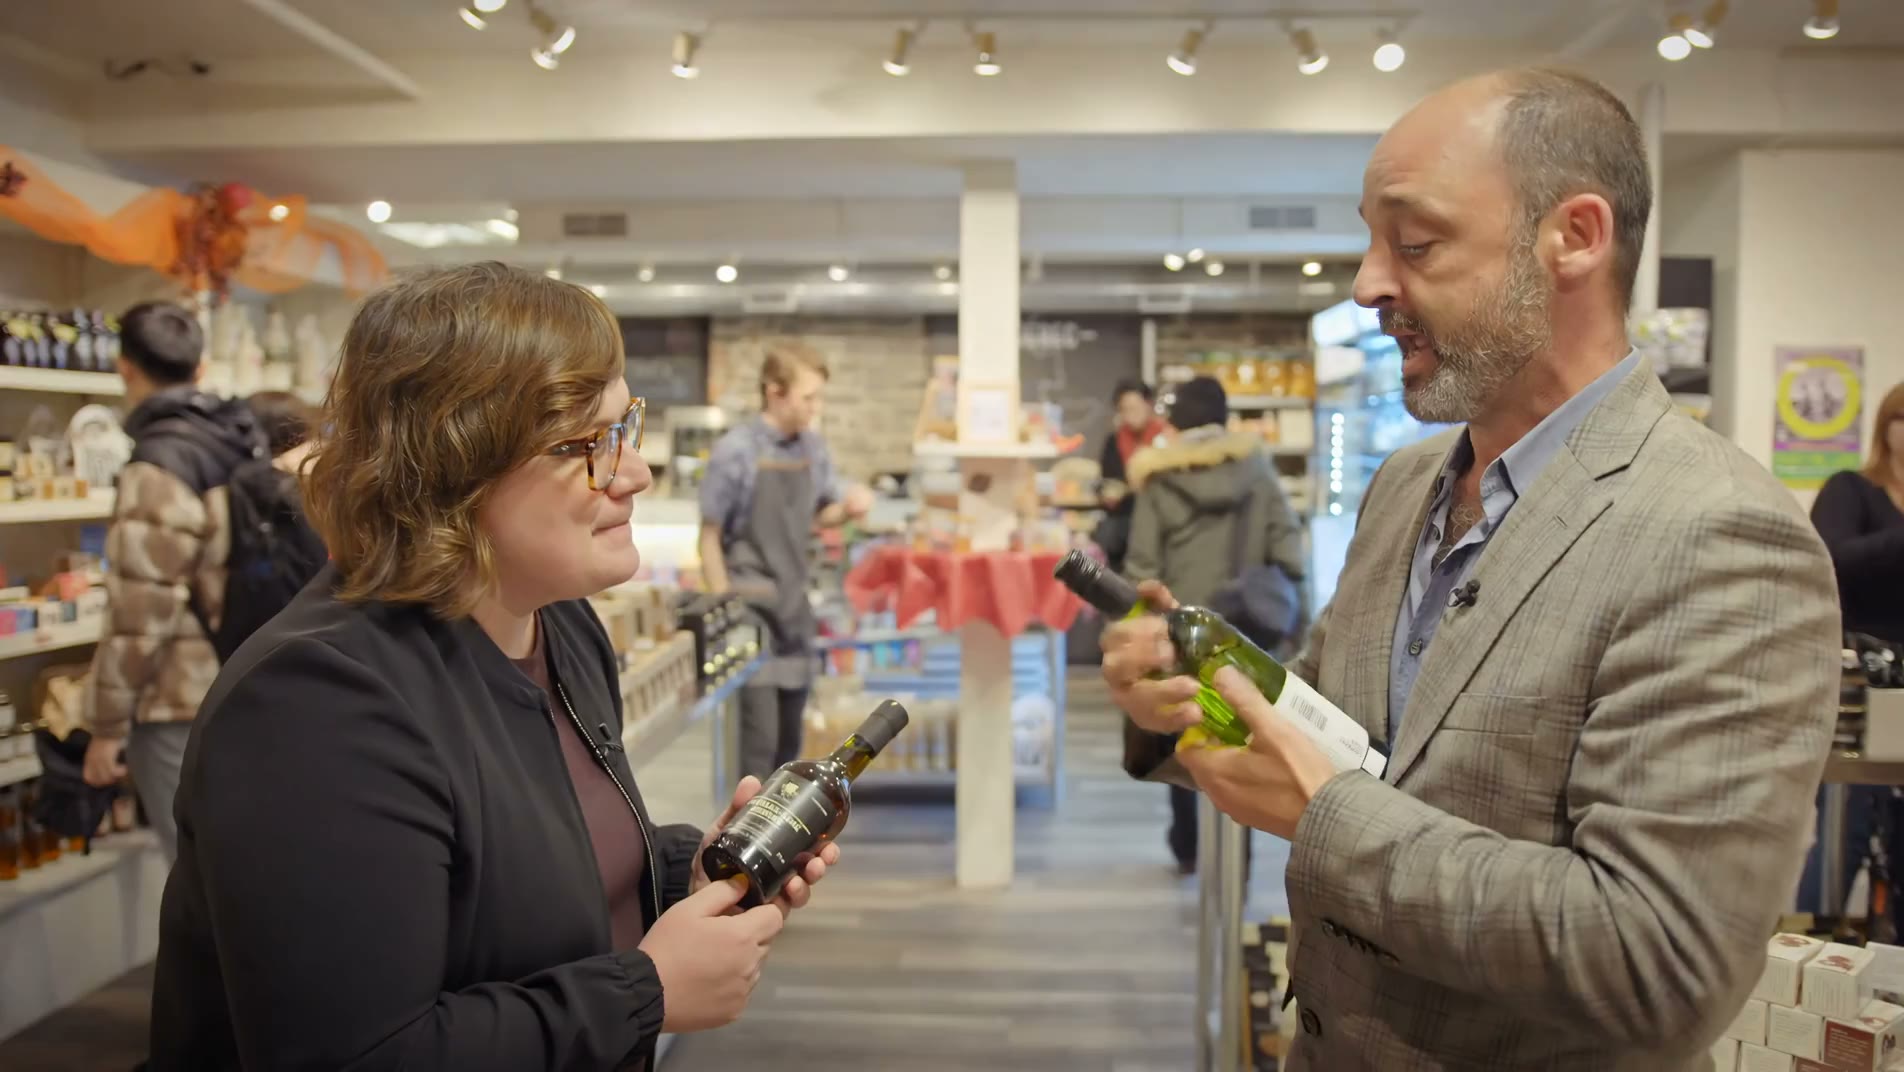
公開されたプレビューチェックポイントによる生成例。
Prismが実現すること
ネイティブな高解像度トレーニングは、動画・音声同時モデルがより細かな視覚的ディテールと鋭い動きを学習するための手法ですが、フルアテンションはシーケンス長に対して二次関数的に増大し、2Kでは冗長なトークン群にアテンションが広がってしまいます。Prismは解像度を維持したまま、アテンションの方を変更します。
この方法は、トークン列を時空間マクロゾーンに整理します。各ゾーンについて、2つの信号から局所的な情報構造を推定します。
- チャンネル次元に沿った動画特徴の分散。これは各方向で視覚コンテンツがどれだけ速く変化するかを示します。
- 音声から動画へのクロスアテンションにおける特徴ノルム。これは音声が各視覚領域にどれだけ強く影響しているかを示します。
これらの信号がゾーンごとのブロック形状を決定します。視覚コンテンツが速く変化する軸や音声と視覚の結合が強い軸ではより細かく分割し、それ以外の場所ではより粗く分割します。狙いは、ブロック内のトークンが意味的に一貫した状態を保つことで、ブロックレベルの特徴が視覚コンテンツと音声・動画の相互作用の両方を担うようにすることです。その後、ハイブリッドなブロック選択戦略(top-kとtop-p CDF閾値の組み合わせ)が、クエリごとのスパース性を設定します。
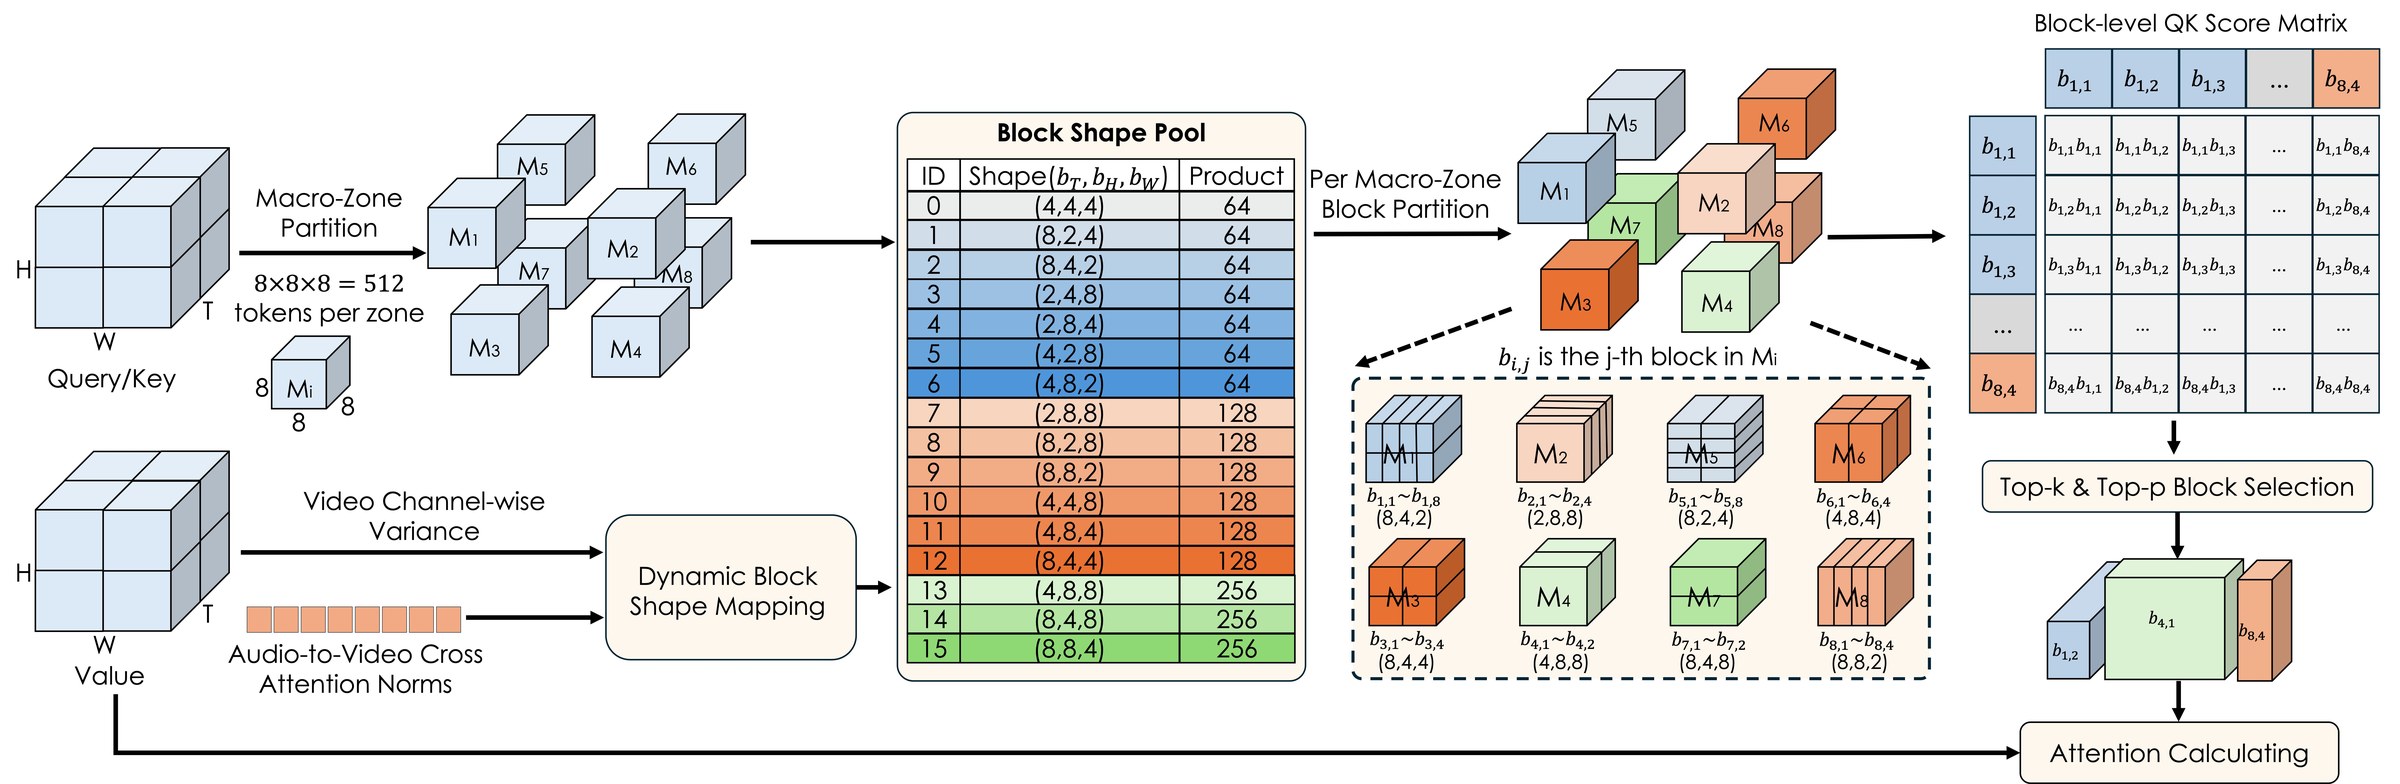
公式モデルカードによるPrismフレームワーク。
公開された内容
プロジェクトは単一のチェックポイントではなく、完全なトレーニングと推論のスタックとして提供されています。
- プレビューチェックポイント。 MOVAアーキテクチャをベースにした
Prism-preview-alpha(安定版)とPrism-preview-beta(モーション)。720p、1080p、2Kでのネイティブな動画・音声同時生成に対応します。 - コード。 潜在抽出とデコードを含むデータ前処理、トレーニング、フルファインチューニングと推論、さらにマルチノード実行用の分散起動スクリプト。
- 報告。 技術報告はarXivにあり、モデルカードとリポジトリからリンクされています。
公開されたプレビューチェックポイントによる生成。
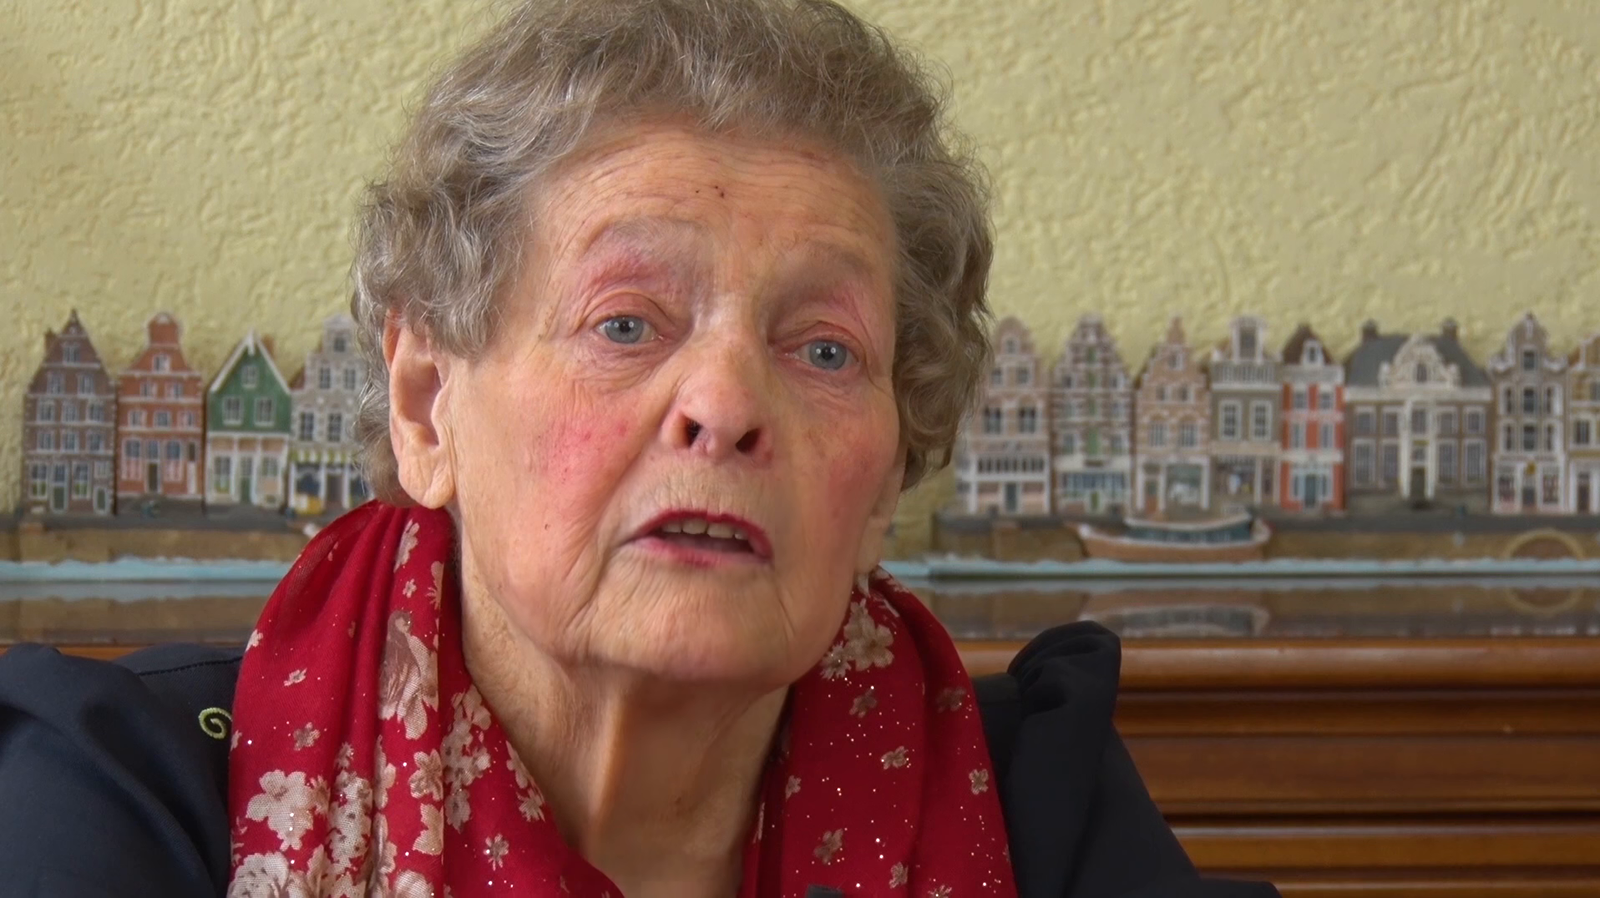
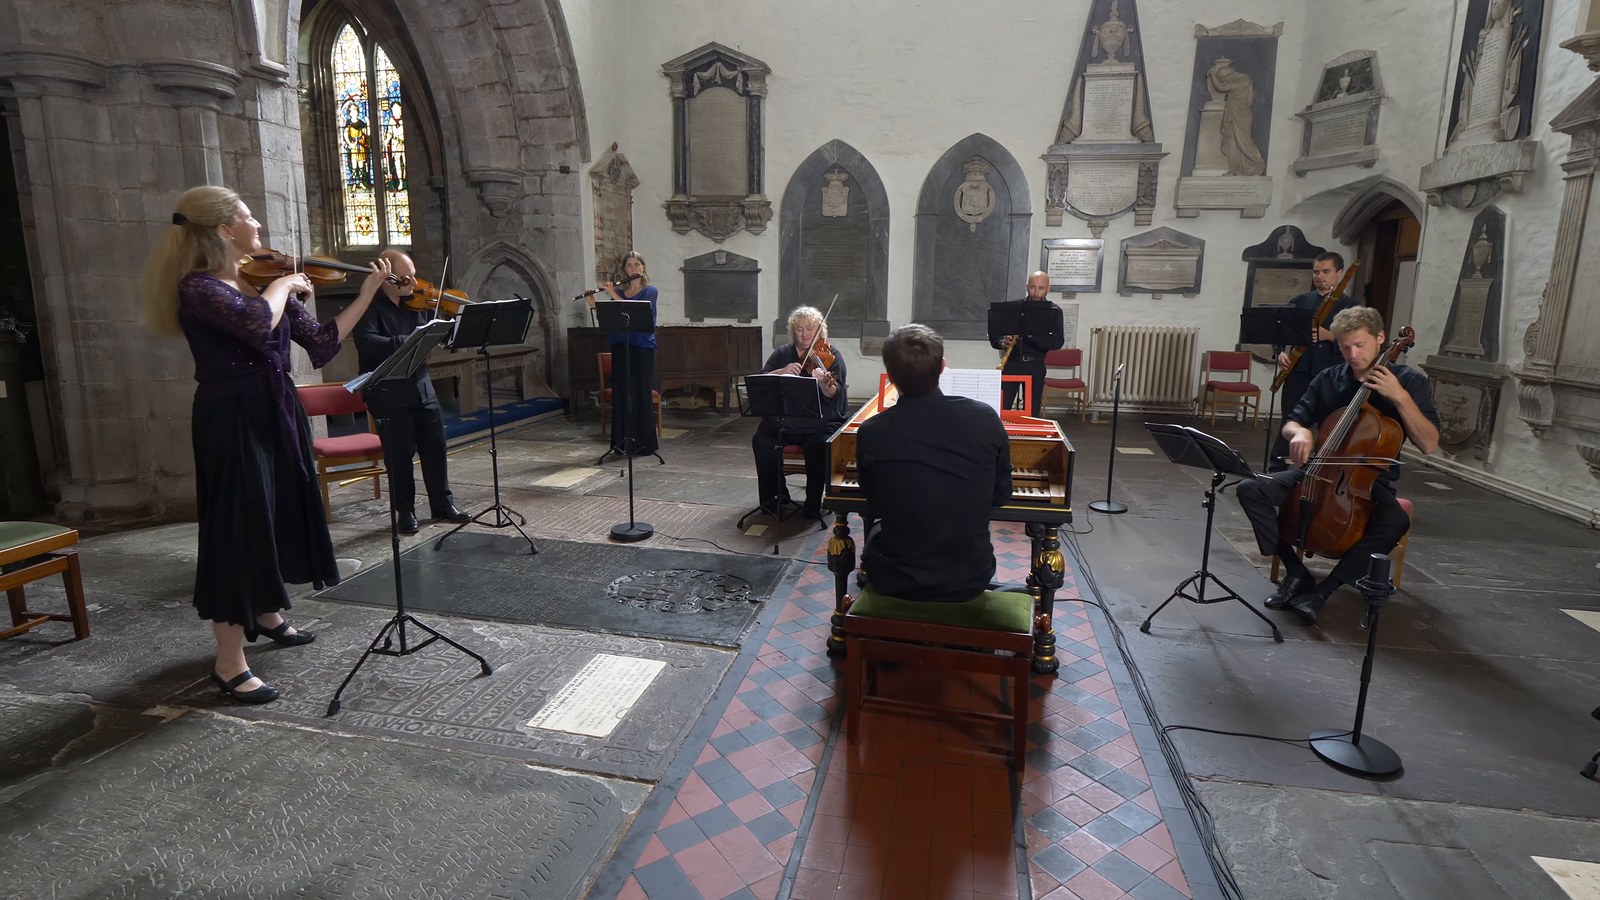
公開されたチェックポイントは、画像から音声・動画を生成するための参照画像による条件付けにも対応しています。
 |  |
|---|---|
| 公式の画像から音声・動画への変換ケース入力 | 公式の画像から音声・動画への変換ケース入力 |
Prism-pro チェックポイントは、プロジェクトのロードマップに残る項目として挙げられており、まだリリースされていません。
入手方法
プレビューウェイトは Hugging Face にあり、コードとスクリプトは Tencent-Hunyuan/Prism、報告は arXiv にあります。推論は現在、プロジェクト独自のPyTorchスクリプトで実行されます。ComfyUIノードやパッケージ化されたComfyUIチェックポイントはまだ存在しないため、ローカルで実行するには公式リポジトリを直接使用することになります。
コメント
GitHubでサインインしてディスカッションに参加しましょう。