FastH3 Trim: 8 GB GPUで動作する枝刈り8ステップMiniMax H3
FastVideoがFastH3 Trimを公開。50ブロックのうち8ブロックを削除した42ブロックのMiniMax H3で、音声付き8ステップ動画を最小8 GBのGPUメモリで実行でき、ComfyUI用の再パッケージファイルも提供されます。
Trimが変えるもの
ベースH3は3つのネットワークで構成されています。Qwen3-VLテキストエンコーダー、動画と音声のlatentをまとめてデノイズする50ブロックのdiffusion transformer、そして2つのVAEです。BF16では137.7 GiBとなり、32 GBのカードには収まりません。FastH3 V2は量子化によってこれを縮小しましたが、Trimはさらにブロックを削除します。
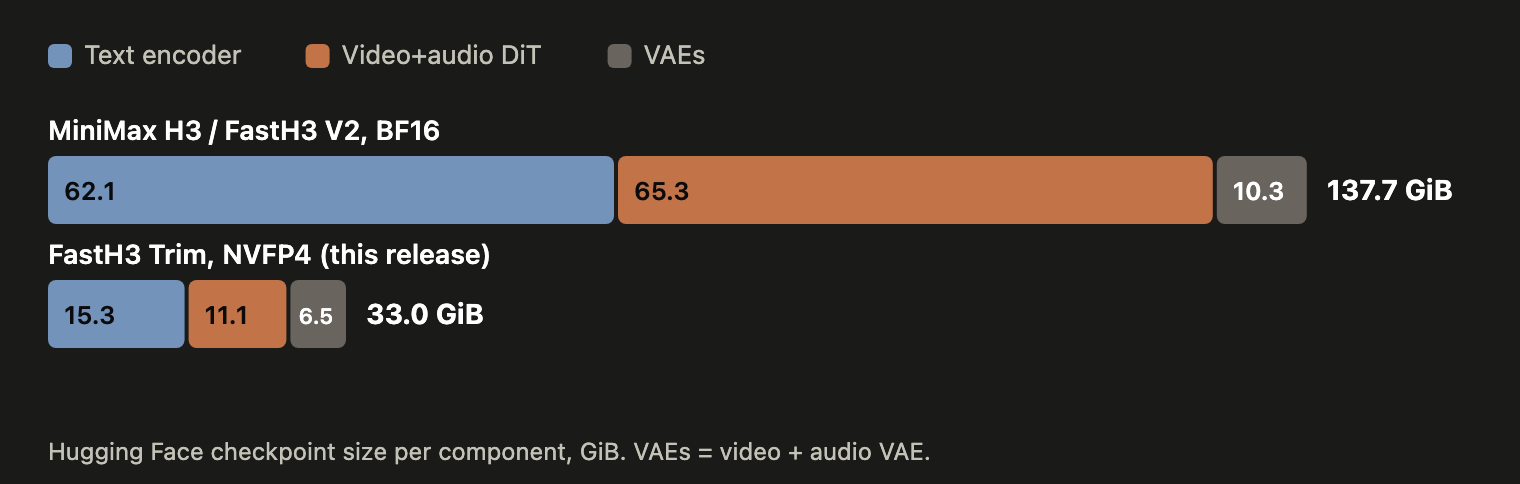
コンポーネント別のcheckpointサイズ。BF16のH3は137.7 GiB、FastH3 TrimのNVFP4リリースは33.0 GiBで、transformerは11.1 GiBです。
- ブロック枝刈り: チームはベースH3から一度に1ブロックずつスキップし、動画と音声の予測がどれだけ変化するかを記録しました。4種類のサンプル(モーション、スピーチ、音楽、サウンドイベント)と3つのノイズレベルの組み合わせで、計600回の計測です。各ブロックは、いずれかの条件で引き起こした最大の変化によってランク付けされたため、動画と音声のどちらかに重要なブロックは保持されます。削除された8ブロックはすべてネットワークの前半にあり、最初と最後のブロックが出力を最も大きく変化させました。
- タイムステップ条件付け: H3は、2,688次元のtime embeddingを6つのmodulation vectorにマッピングするAdaLN projectionを通じて、各ブロックをdiffusion timestepで条件付けします。これらのprojectionは50ブロックでBF16換算24 GiBを占めます。Trimはこれを、共有された1つの2,688→16のbasisと、ブロックごとの小さなprojectionに置き換え、FP16で保存します。BF16では再構成誤差が約1.7倍大きくなるためです。
- トレーニング: 新しい42ブロックモデルは、FastH3 V2の目的関数を用いた8ステップDMD2で直接トレーニングされました。ベースH3が、凍結されたteacherとトレーニング可能なcriticの両方を初期化し、アテンションは80%スパース、サンプラーは999、874、749、624、500、375、250、125のステップで動作します。
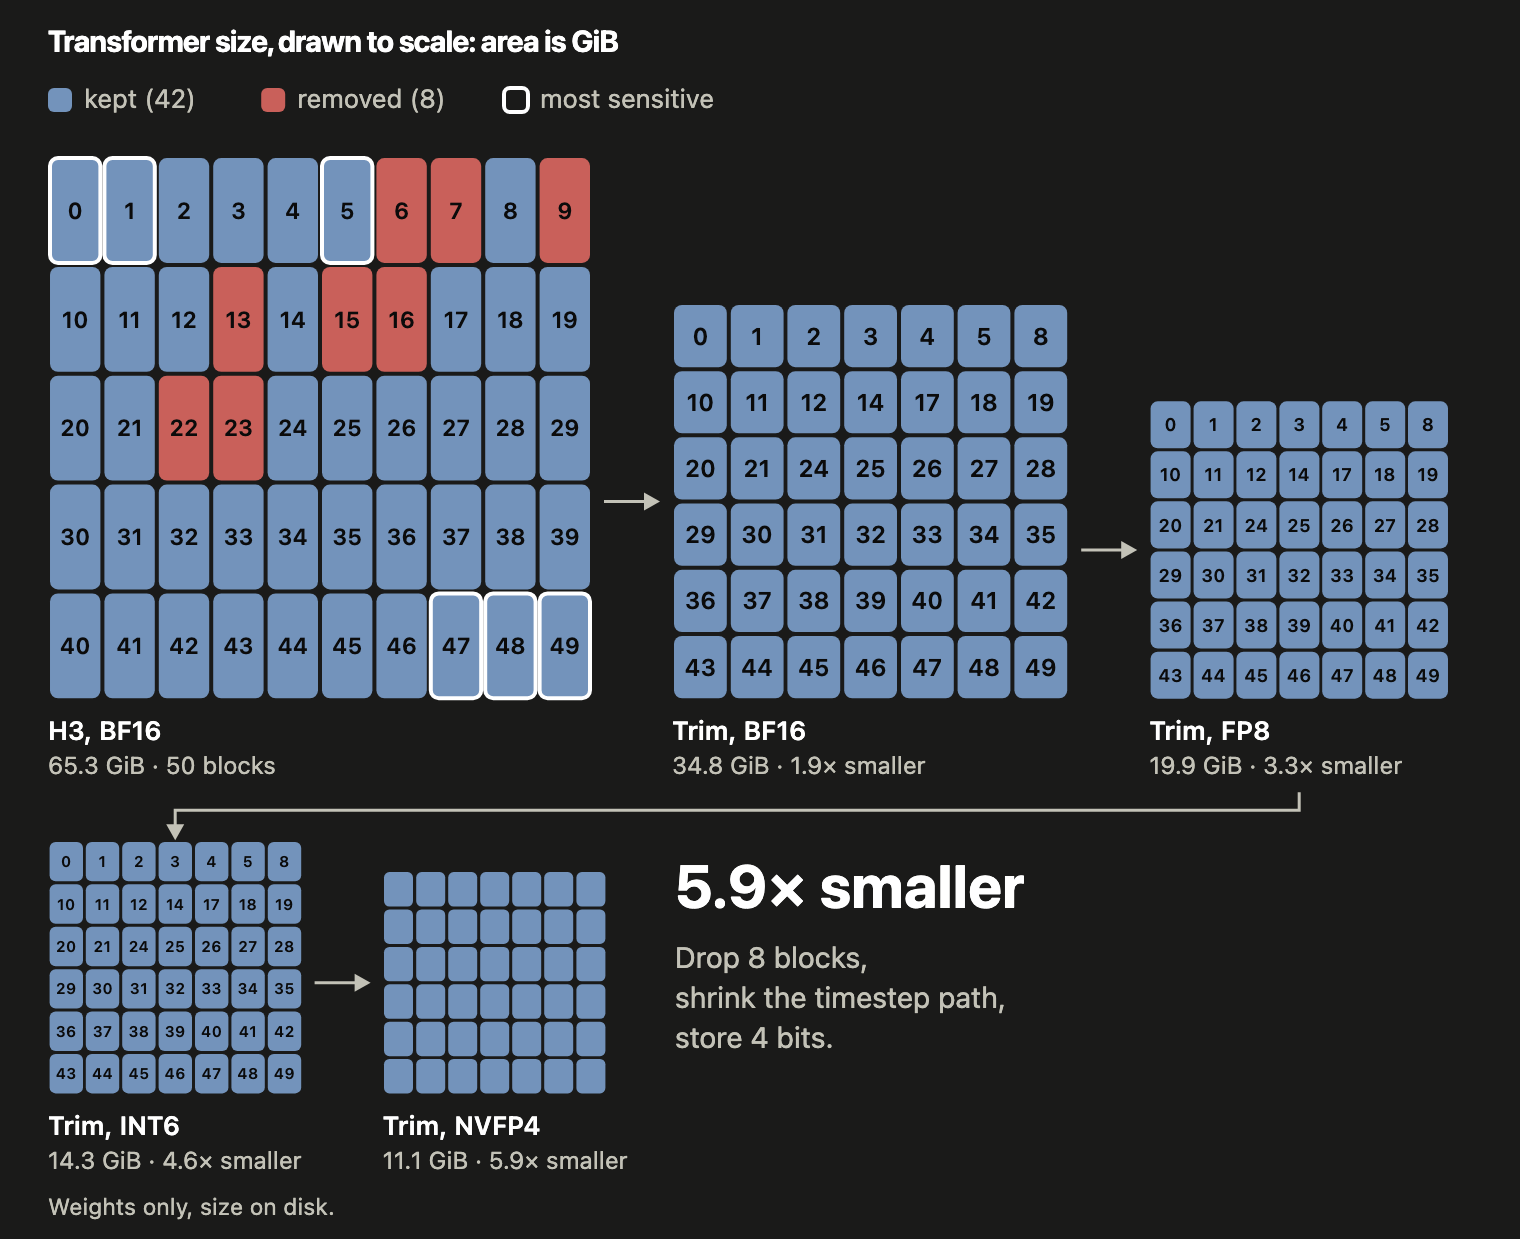
出荷される各フォーマットのFastH3 Trim transformerを縮尺どおりに描いたもの。面積がcheckpointサイズを表します。
ComfyUI用再パッケージの内容
このリリースはFastVideo/FastVideo-FastH3-Trim-ComfyでComfyUI用に再パッケージされています。diffusionモデルファイルを1つと、対応するテキストエンコーダーを選んでください:
| diffusionモデル | サイズ | 推奨環境 |
|---|---|---|
fastvideo_fasth3_trim_8step_nvfp4.safetensors | 11.9 GB | NVIDIA Blackwell: RTX 50シリーズ、RTX PRO 6000、DGX Spark |
fastvideo_fasth3_trim_8step_fp8.safetensors | 19.7 GB | NVIDIA Ada以降: RTX 40シリーズ |
fastvideo_fasth3_trim_8step_int8_convrot.safetensors | 18.9 GB | 最近のNVIDIA GPU全般。テンプレートのデフォルトと一致 |
fastvideo_fasth3_trim_8step_bf16.safetensors | 37.5 GB | 参照品質、または他フォーマットへの変換用 |
リポジトリにはQwen3-VLテキストエンコーダー(BF16、INT8 ConvRot、NVFP4 AWQ)と、MiniMax H3の動画・音声VAEも含まれています。すべてのNVFP4レイヤーは1,000件のプロンプトでキャリブレーションされたactivation scaleを使用しており、Trimには294個のキャリブレーションレイヤーがあります。
ComfyUIでの実行
ComfyUI(0.36.0以降)に付属するFastVideo FastH3: Text to Videoテンプレートを使用し、そのUNETLoaderでTrimのdiffusionモデルを1つ選びます。テンプレートのサンプラー設定はそのまま維持してください: 8ステップ、res_multistep、simple、そしてMiniMaxH3SigmaShiftノードを動画では10、音声では3に設定します。
実行速度
音声付き5秒クリップのエンドツーエンド所要秒数。2つのプロンプトそれぞれで2回実行した中央値です(ブログ記事より):
| マシン | V2 480p | Trim 480p | V2 768p | Trim 768p |
|---|---|---|---|---|
| RTX PRO 6000 96 GB | 13.5 | 12.0 | 36.5 | 32.5 |
| RTX 5090 32 GB | 14.8 | 13.4 | 38.6 | 35.4 |
| RTX 4090 24 GB | 54.6 | 43.9 | 154.6 | 132.8 |
| RTX 4090、16 GB制限 | 79.9 | 72.1 | 153.7 | 139.9 |
| RTX 4090、12 GB制限 | 91.2 | 74.1 | 170.7 | 147.1 |
| RTX 4090、8 GB制限 | - | 82.0 | - | - |
| DGX Spark 128 GB ユニファイド | 141.4 | 125.8 | 340.1 | |
| DGX Spark 2台 | 87.2 | 78.3 | ||
| Mac、M4 Max 36 GB ユニファイド | 925.2 |
8 GB、12 GB、16 GBの行は、同じRTX 4090のGPUメモリを制限したものです。実際にメモリが少ないカードでは、さらに遅くなります。ブログによると、4090ではFP8パスに使用できるFP4テンソルコアがないため、より低速なper-token、per-channelのFP8 matmulを、融合されたper-tensorカーネルと出力スケーリングで回避し、スコア計算のためにqueryとkeyをINT8に量子化しています。
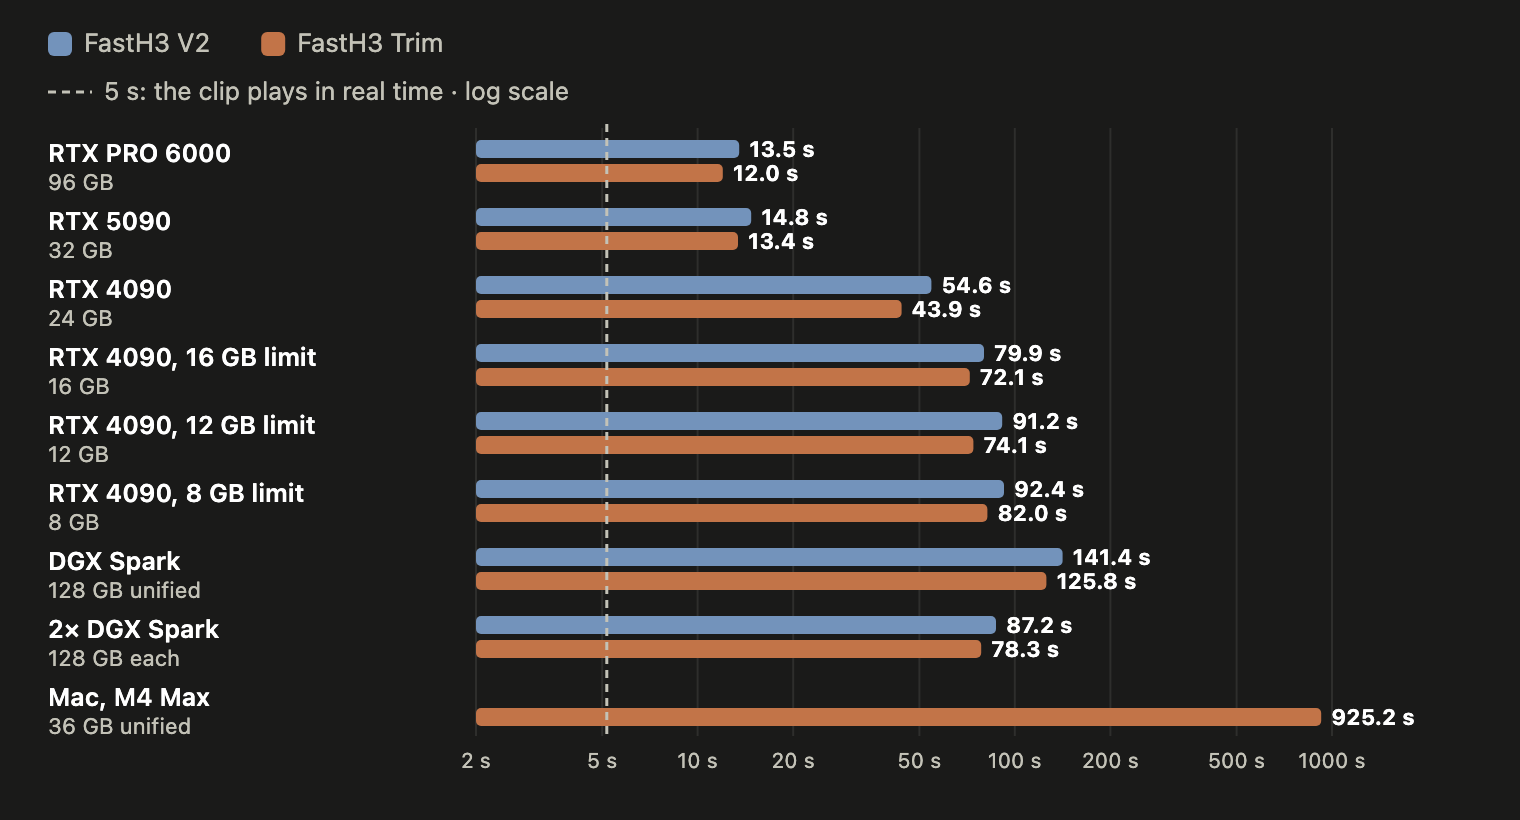
音声付き5秒、832x480クリップのマシン別エンドツーエンド時間。
RTX 5090で同じプロンプトとシードを使用し、まずFastH3 V2、次にFastH3 Trimを実行:
RTX 5090上のFastH3 V2。
同じRTX 5090、同じプロンプトとシードでのFastH3 Trim。
制限事項
- Trimは実験と位置づけられており、品質面のトップではありません。ブログでは、ブロックを削除するとモデルは高速かつ小さくなるが、ある程度品質が犠牲になると述べ、品質を最優先する場合はFastH3 V2を推奨しています。
- 8 GBという数値はTrim専用のNVFP4での値で、メモリを制限したカードでのものです。テストした構成では、V2は12 GBに収まりません。
- Trimは8ステップのFastH3シリーズにのみ存在します。ベースのMiniMax H3モデルは変更されず、そちらは依然としてフル50ブロックのtransformerが必要です。
- ComfyUIでの実行は、ComfyUI 0.36.0以降に付属するFastH3テンプレートに依存します。
入手方法
ComfyUI用再パッケージ: FastVideo/FastVideo-FastH3-Trim-Comfy
ソース重み: FastVideo/FastVideo-FastH3-Trim-8-Step
ブログ記事: FastH3 on Consumer Hardware
コード: hao-ai-lab/FastVideo
品質重視の対応モデル: FastVideo/FastVideo-FastH3-8-Step-V2
ベースモデル: MiniMaxAI/MiniMax-H3
コメント
GitHubでサインインしてディスカッションに参加しましょう。