DMAD: ComfyUI向けMiniMax H3 4ステップ音声動画LoRA
ByteDanceとTexas A&MがDMADを公開。MiniMax H3を4ステップに短縮し音声動画を同時生成するrank-128 LoRAで、KijaiによるComfyUI変換も用意されています。
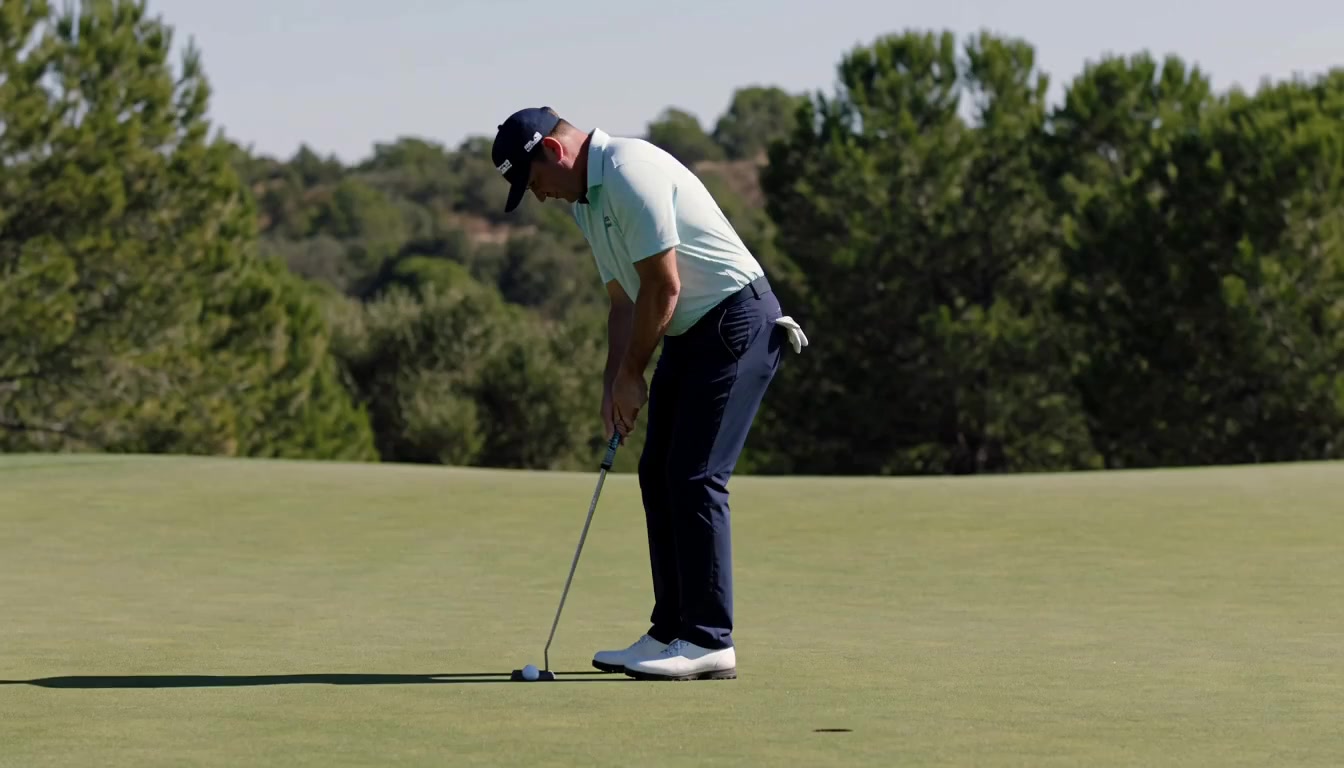 | 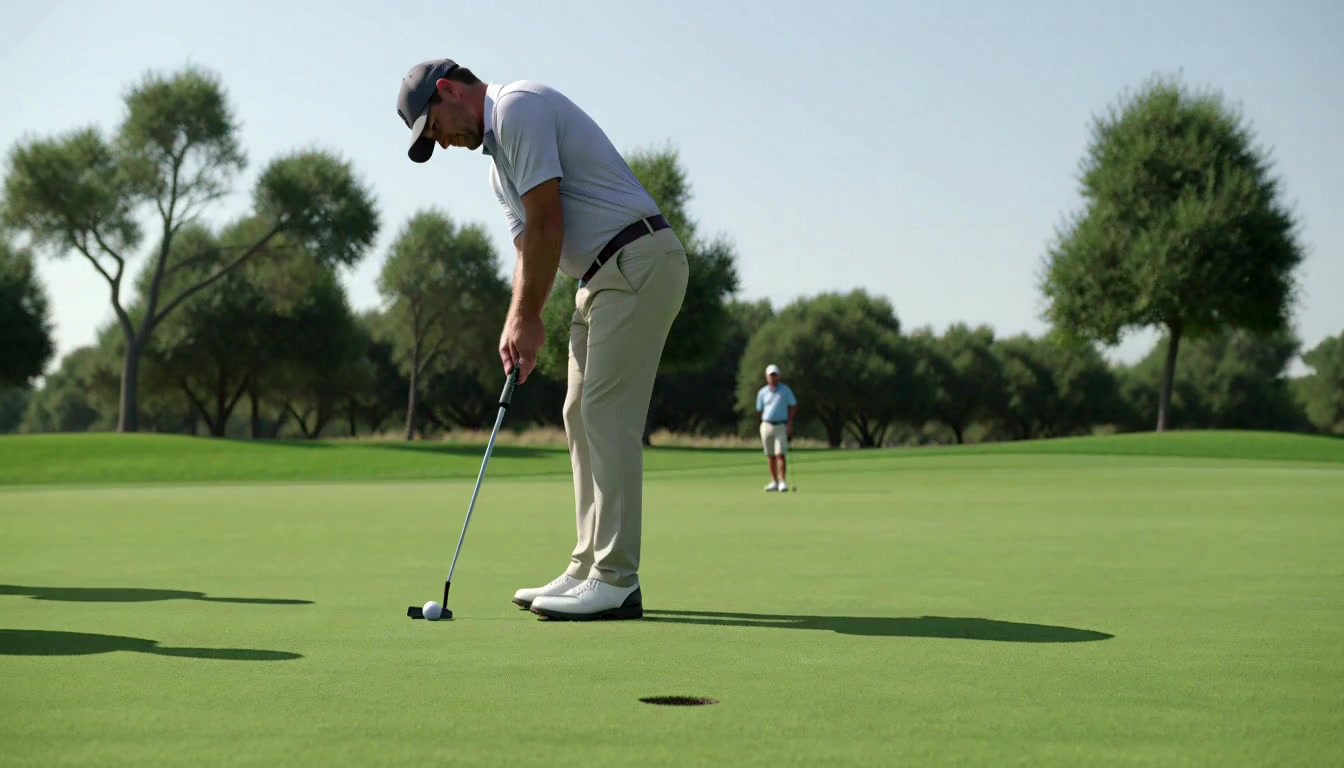 |
|---|---|
| 50ステップのMiniMax H3教師 | 同じプロンプトを4ステップのDMAD生徒で生成したもの |
プロジェクトページのMiniMax H3比較グリッドから対応するフレーム。生徒は構図と被写体を保ちながら、50回ではなく4回のモデル評価で動作します。
DMADが変えるもの
拡散モデルの少ステップ蒸留は通常DMDに従います。つまり、教師と生徒のスコアの差で生徒を訓練するという方法で、これには生徒の変化する分布に適合させた2つ目の拡散モデルを保持する必要があり、メモリと計算コストがかかります。DMADはその補助モデルを取り除きます。
この方法は分布マッチングを分類として捉え直します。2つの識別器ヘッドが1つのバックボーンを共有し、実サンプルと教師サンプルを生徒のサンプルから分離するよう訓練されます。次に識別器のロジットに対するリニア損失が、スコアフィッティングなしで生徒を直接訓練します。論文では、識別器の最適点において、これらの損失がDMDが依拠する分布マッチング勾配を復元することを示しています。これは識別器のロジットと対数密度比を結びつける恒等式を利用しています。
2つ目の要素であるギャップベースの再重み付けは、教師が各ノイズレベルをどれだけ強く監督するかを設定します。固定スケジュールを使う代わりに、実データヘッドの実サンプルと教師サンプル間の経験的ロジットギャップを読み取り、そこから重みを適応させます。
公開された内容
今回のリリースはこの方法のMiniMax H3側です。2つのrank-128 LoRAがH3のテキストから音声動画生成トランスフォーマーに載り、それぞれ約1.4 GBです。
| ファイル | 説明 |
|---|---|
minimax_h3/dmad_minimax_h3_4step_lora_critic.safetensors | 論文のチェックポイント。メイン実行の800イテレーション時点における生徒のEMA |
minimax_h3/dmad_minimax_h3_4step_full_critic.safetensors | クリティックのバックボーンがLoRAで凍結されるのではなく完全に訓練されたバリアント。カードではより高いAVGen-Benchスコアが報告されています |
両方のアダプターは、50個のトランスフォーマーブロックすべてと2個のtoken-refinerブロックのアテンション射影および2つのフィードフォワード層、合計312モジュールにわたり、rank 128とalpha 128を持ちます(Diffusersのキーレイアウト: <module>.lora.down.weight、<module>.lora.up.weight)。safetensorsのメタデータにはrank、alpha、融合ルールが記録されています。
推論は4ステップのテキストから音声動画生成で、time shiftは動画が12、音声が2、MiniMax H3はすでにガイダンス蒸留されているためclassifier-free guidanceはありません。デフォルトの出力は1344x768、124フレーム(24 fpsで約5.2秒)、32 kHzステレオ音声で、生徒が訓練された設定です。
結果
論文では3つのバックボーンでこの方法を報告しています。今回のリリースで公開されたのはMiniMax H3の生徒のみで、SDXL、EDM、Wan2.1の数値は論文自身の実行によるものです。
| バックボーン | 設定 | スコア |
|---|---|---|
| SDXL | 4ステップ、COCO-10K | 14.47 FID |
| Wan2.1-T2V-14B | 4ステップ | 85.15 VBench合計 |
| MiniMax-H3-33B | 4ステップ、音声動画同時 | 総合的な人間選好でDMD2に対して79.1%、rCMに対して84.6%(引き分けを除く) |
アブストラクトではまた、射影識別器を使ったImageNet-64x64での1ステップ生成で1.04 FIDを報告しており、少ステップの生徒がこれらの指標で比較対象の少ステップ手法や多ステップの教師を上回ると述べています。
ComfyUIで動かす
公式リリースはノードではなくDiffusersを対象としています。inference.pyは生徒が訓練されたre-noiseステップルールでサンプリングし、run_diffusers_pipeline.pyはそれらを公式のMiniMaxH3ModularPipelineに組み込みます。ベースモデルは33BのH3トランスフォーマーとそのQwen3-VL-32Bテキストエンコーダーで、コンポーネントは約170 GBあり、参照ではアイドル時のCPUオフロードを併用した80 GB GPU 1基を推奨しています。
ComfyUIでは、変換さえすればアダプターは通常のLoRAです。Kijaiがrankを削減した変換版 minimax_h3_DMAD_4step_full_lora_avg_rank_39_bf16.safetensors を Kijai/MiniMax-H3-experimental で公開しているため、カスタムノードなしでスタンダードなH3 LoRAパスを通じて読み込めます。オリジナルのdiffusersファイルのコミュニティ変換も出回っていますが、2つのチェックポイントとサンプラー設定がカードと一致している必要があるといういつもの注意点があります。
サーフボードに乗ったカワウソ。4ステップのMiniMax H3生徒によって生成されました。動画と音声は同じ4ステップのパスから生成されています。フルのデモリールはYouTubeで。
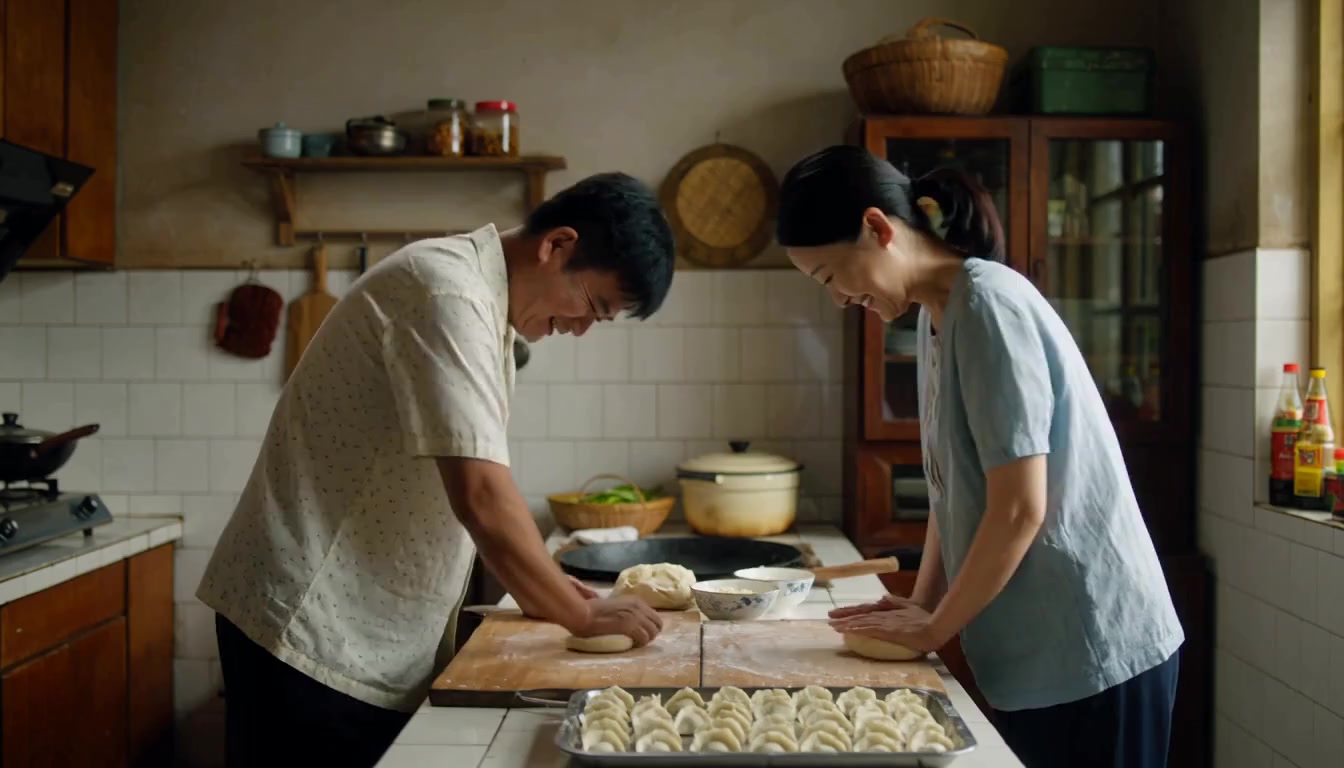 | 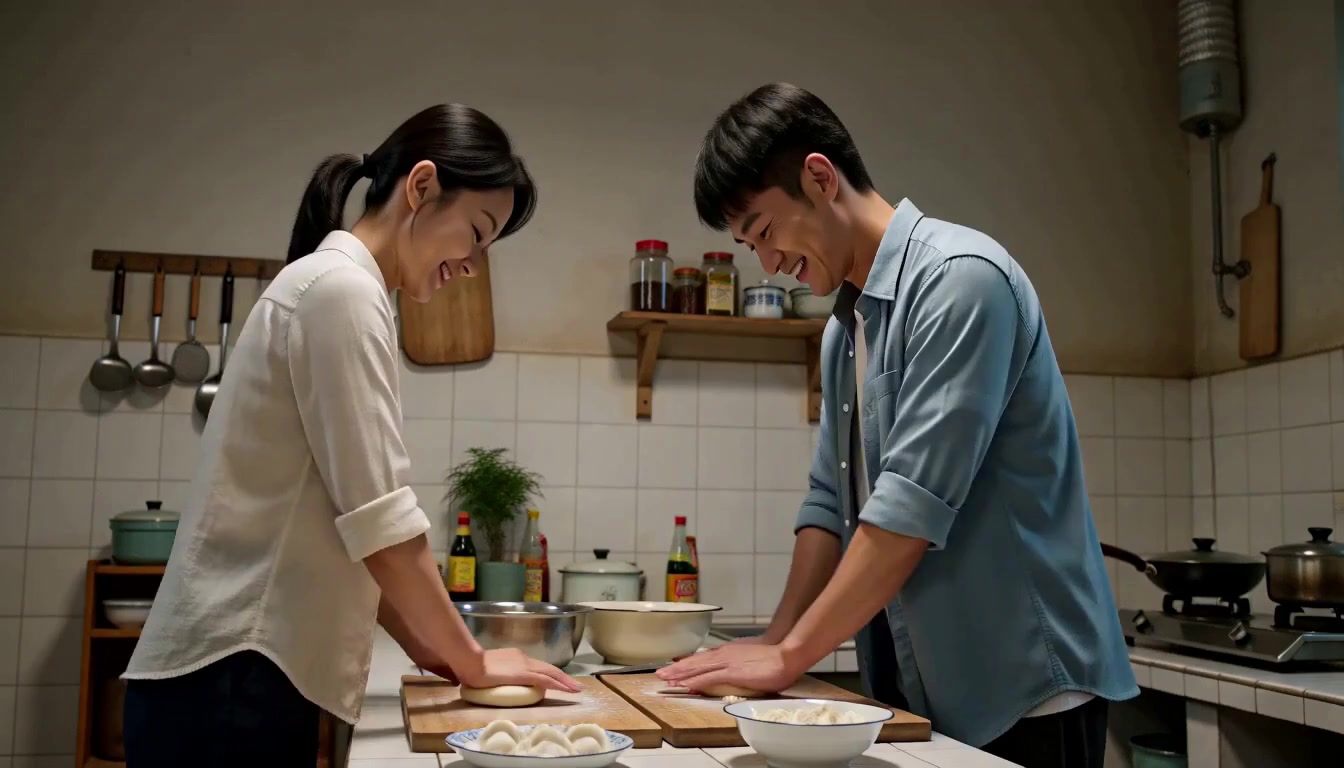 |
|---|---|
| 教師、50ステップ | DMAD生徒、4ステップ |
プロジェクトページのMiniMax H3グリッドからの2つ目の対応ペア。
制限
- 公開された生徒は1344x768、124フレーム、32 kHzステレオ音声で訓練されており、カードではこれを多くの設定の一つではなく動作点として提示しています。
- H3の選好数値は引き分けを除外しており、比較にはこのリリースに含まれない手法が混在しているため、SDXLとWan2.1の直接対決の数値は公開ファイルではなく論文の実行によるものです。
- リリースには公式のノードもワークフローJSONもないため、ComfyUIのサポートはコミュニティの変換に依存しており、そのrank削減とキーレイアウトは論文が評価したものではありません。
- H3のフルスタックは大きく(33Bトランスフォーマーと32Bテキストエンコーダー)、4ステップはサンプリングコストを削減するもので、モデルを保持するためのメモリを削減するものではありません。
入手方法
プロジェクトページ: yzmblog.github.io/projects/DMAD
論文: arXiv 2610.02188
コード: Yzmblog/DMAD
重み: ZhengmingYu/DMAD
デモ動画: YouTube
ComfyUI変換: Kijai/MiniMax-H3-experimental
ベースモデル: MiniMaxAI/MiniMax-H3
コメント
GitHubでサインインしてディスカッションに参加しましょう。