MiniMax H3 X2 Detail VAE: 2-in-1のアップスケールとディテール強化リリース
MiniMax H3向けの実験的な2-in-1リリース。2XビデオVAEと参照ディテール強調ノードを収録し、検証済みのComfyUIワークフローとネガティブな結果についての解説を添えています。
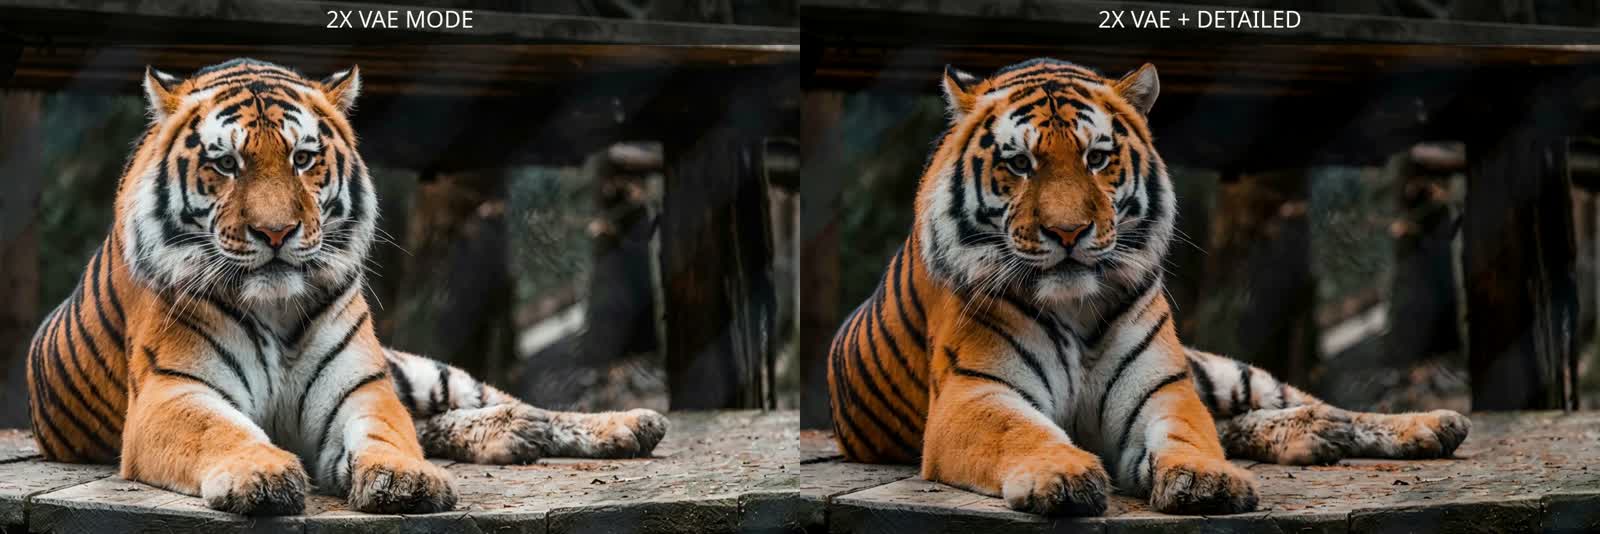
リリースの比較クリップからのフレーム。片側は通常の2X VAEデコード、もう片側は同じ潜在にディテール強調パスを適用したものです。
1つのファイルに2つのツール
このwikiにおけるH3 VAEの取り組みのほとんどは、デコードを より高速にする ことに関するものでした。今回のリリースは逆方向に進み、デコードを よりシャープに できるかを問いかけ、その探求を生き残ったものを公開しています。同じチェックポイント MiniMax-H3-X2-Detail-v1.safetensors が、2つの異なる方法で使われます。
| モード | 入力 | 動作 | カスタムノードが必要か |
|---|---|---|---|
| 2X VAE | H3ビデオ潜在 | パックされた12チャンネル出力とPixelShuffleにより、2倍の空間解像度でデコード | 高速デコードノードのみ必要 |
| ディテールエンハンサー | RGB参照画像 | 参照から動画へ変換する前に、エンコーダの初期タップから追加の空間構造を再構築 | 必要(リリースに含まれる) |
この2つのモードは互換ではありません。2Xパスは生成済み潜在に対して動作し、参照画像は不要です。ディテールパスには既存のRGB画像が必要です。そこで使われる追加情報は、通常の潜在ボトルネック より前 のH3エンコーダから取り出されるからです。
モード1: 2X VAEデコード
チェックポイントを ComfyUI/models/vae/ に置き、スタンダードな Load VAE ノードで選択します。実際のデコードでは、ComfyUIの通常の VAE Decode ノードを、TripleHeadedMonkey/ComfyUI-MiniMaxH3_LatentUpscaler の MiniMax H3 VAE Decode (fast) に置き換えます。これがパックされた出力をフル解像度のRGBに変換するものです。
H3 video latent
   ↓
MiniMax H3 VAE Decode (fast)   ← MiniMax-H3-X2-Detail-v1
   ↓
packed 12-channel X2 decode
   ↓
PixelShuffle ×2
   ↓
2X RGB / video frames
ワークフローには検証済みの開始設定が付属しています: tiling = true、tile_size = 256、tile_overlap = 64、output_device = cpu、temporal_tiling = false。
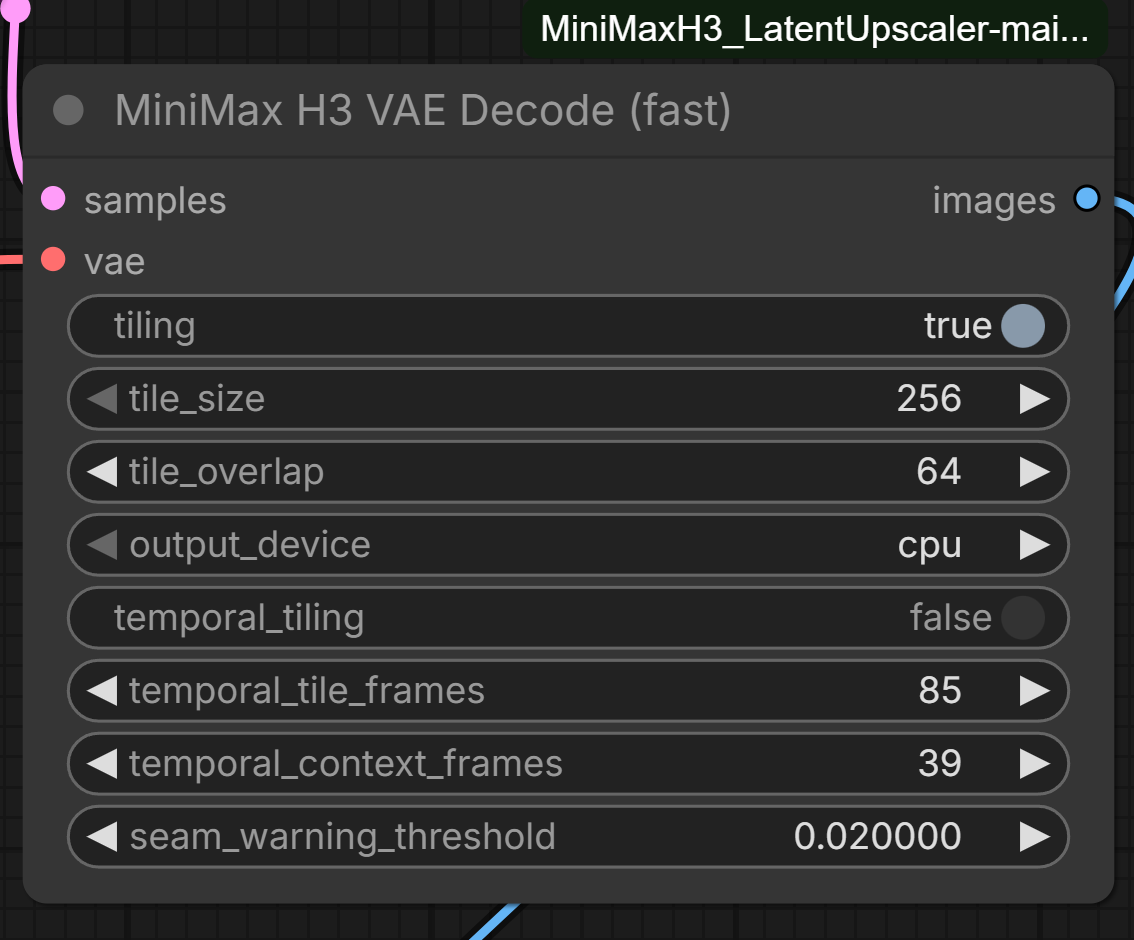
リリースのREADMEに示されている、必須の MiniMax H3 VAE Decode (fast) ノード。
モード2: 参照ディテール強調
画像参照ワークフローでは、同じチェックポイントが MiniMax H3 VAE 2X (Detailed Upscale) の中で2度目に読み込まれます。これは ComfyUI-H3-X2-Detailed.zip として同梱される小さなカスタムノードです。ソース画像と MiniMax H3 リファレンスから動画へ の間に配置し、detail_strength = 1.0 が検証済みのベースラインです。最終的なビデオデコードは、同じX2 VAEを使う MiniMax H3 VAE Decode (fast) を通して実行されます。
サンプルワークフロー
このリリースには、両方の役割を同時に示す2-in-1グラフが含まれています。ディテールノードが参照から動画へ変換する前にRGB参照を強調し、生成されたH3潜在は最後に MiniMax H3 VAE Decode (fast) でデコードされます。
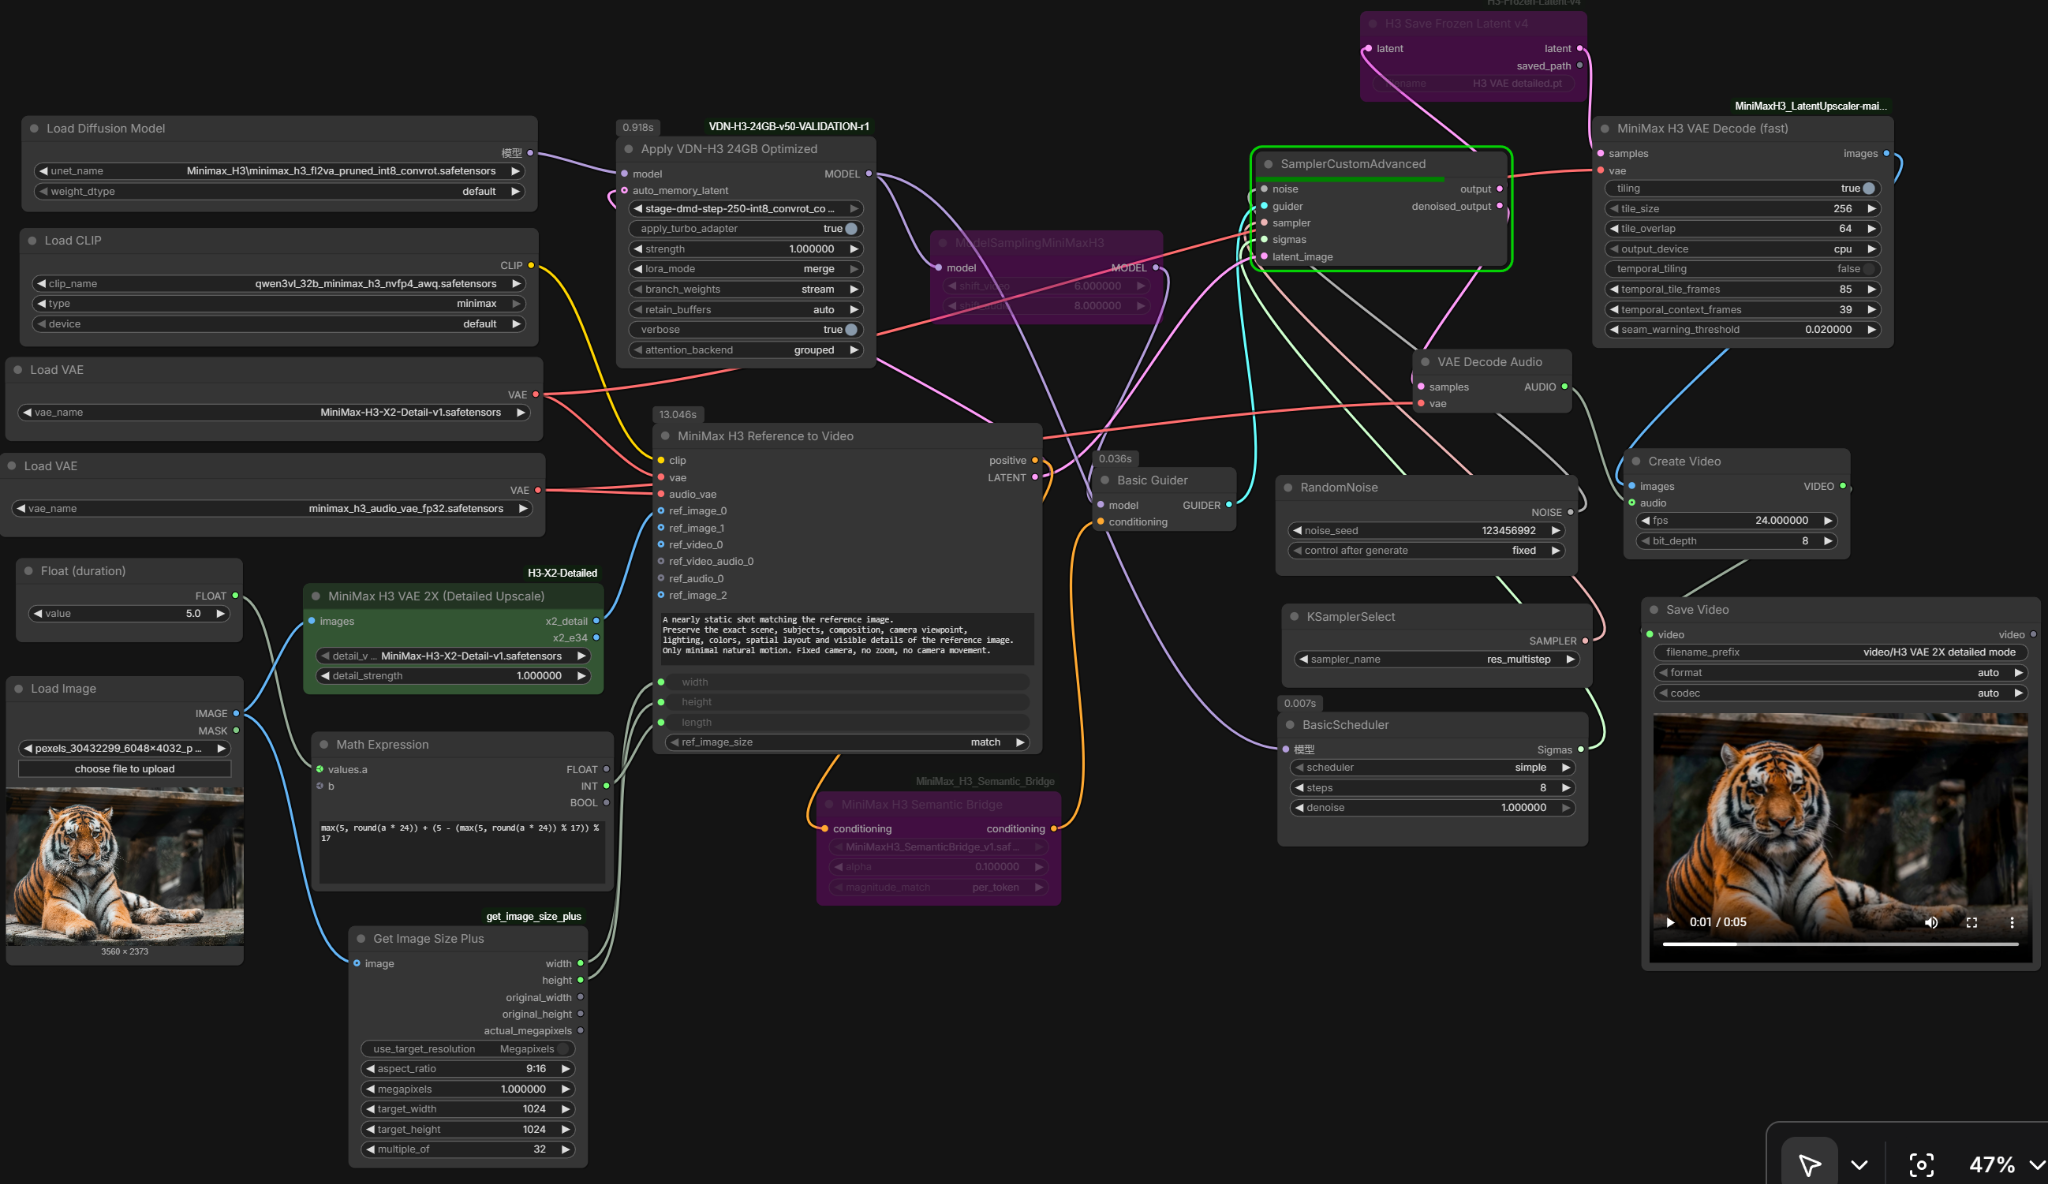
モデルカードに掲載されている、完全な2-in-1ワークフローのスクリーンショット。
直接比較
以下の2つのクリップはどちらも、同じモデルのリリースされた2つのモード を同一の生成設定で実行したものです。左側は2X VAE単体、右側は2X VAEにディテールパスを加えたもので、参照はまずB32ディテールブランチを通して処理されます。
比較01: 2X VAEデコードと、ディテール強調パスを加えた2X VAE。
比較02: 2つ目のクリップで同じ2つのモードを比較。
「HQ VAE」が存在しない理由
その解説は、結果について異例なほど率直です。出発点はすでに動作していたH3 2X VAEでしたが、その大きな出力は比例して多くの実際のディテールを伴うものではありませんでした。そこでプロジェクトは、増えたピクセルに意味を持たせることを目指しました。デコーダ側のブロック、ディテールターゲット損失、潜在の「ディテール方向」、より強力なプログレッシブデコーダはすべて失敗し、そのうちのいくつかは数値的な損失を改善しつつも、エッジのハロー、彫刻画のような構造、あるいは何も見えない結果を生み出しました。
明確に機能した唯一のブランチは、凍結されたH3エンコーダの down.1.block.1 からコンパクトな32チャンネル表現を取り出し、10枚のホールドアウトフレームすべてでRMSE、HP3、勾配メトリクスを改善しました。またそれは 潜在ボトルネック前のオリジナルRGB画像 から得られたものであり、これはH3がテキストから動画への生成中に新しい潜在を生成するときには存在しない情報そのものです。作者の結論は限定的で、率直に述べられています。ディテールの向上はスタンダードな生成済みH3潜在だけからは再現できないため、プロジェクトが目指していたドロップインの潜在専用VAEにはなり得ませんでした。残ったのは実験的な2-in-1ツールであり、解決されたボトルネックではありません。
要件とファイル
MiniMax-H3-X2-Detail-v1.safetensorsは5.2 GBのチェックポイントで、ComfyUI/models/vae/に配置します。- ComfyUI-MiniMaxH3_LatentUpscaler は
MiniMax H3 VAE Decode (fast)を提供し、2Xワークフローに必須です。 ComfyUI-H3-X2-Detailed.zipは、参照パス用のオプションのMiniMax H3 VAE 2X (Detailed Upscale)ノードを追加します。H3_VAE_Detailed_and_2X_VAE_2in1.jsonはサンプルワークフローです。
入手方法
重みとアセット: speach1sdef178/MiniMax-H3-X2-Detail-VAE
ComfyUIファイル: MiniMax-H3-X2-Detail-v1.safetensors(models/vae/ 内)
必須ノードパック: TripleHeadedMonkey/ComfyUI-MiniMaxH3_LatentUpscaler
ベースモデル: MiniMaxAI/MiniMax-H3
コメント
GitHubでサインインしてディスカッションに参加しましょう。