Viggle Turbo v0.3: ComfyUI で Qwen-Image 2.1 を 6 ステップと 9 ステップで生成
Viggle による Qwen-Image 2.1 の蒸留版 v0.3 は 9 ステップモードを追加し、6 ステップでの生成と編集に向けた公式 ComfyUI ノード、ワークフロー、マージ済み単一ファイル重みを同梱しています。
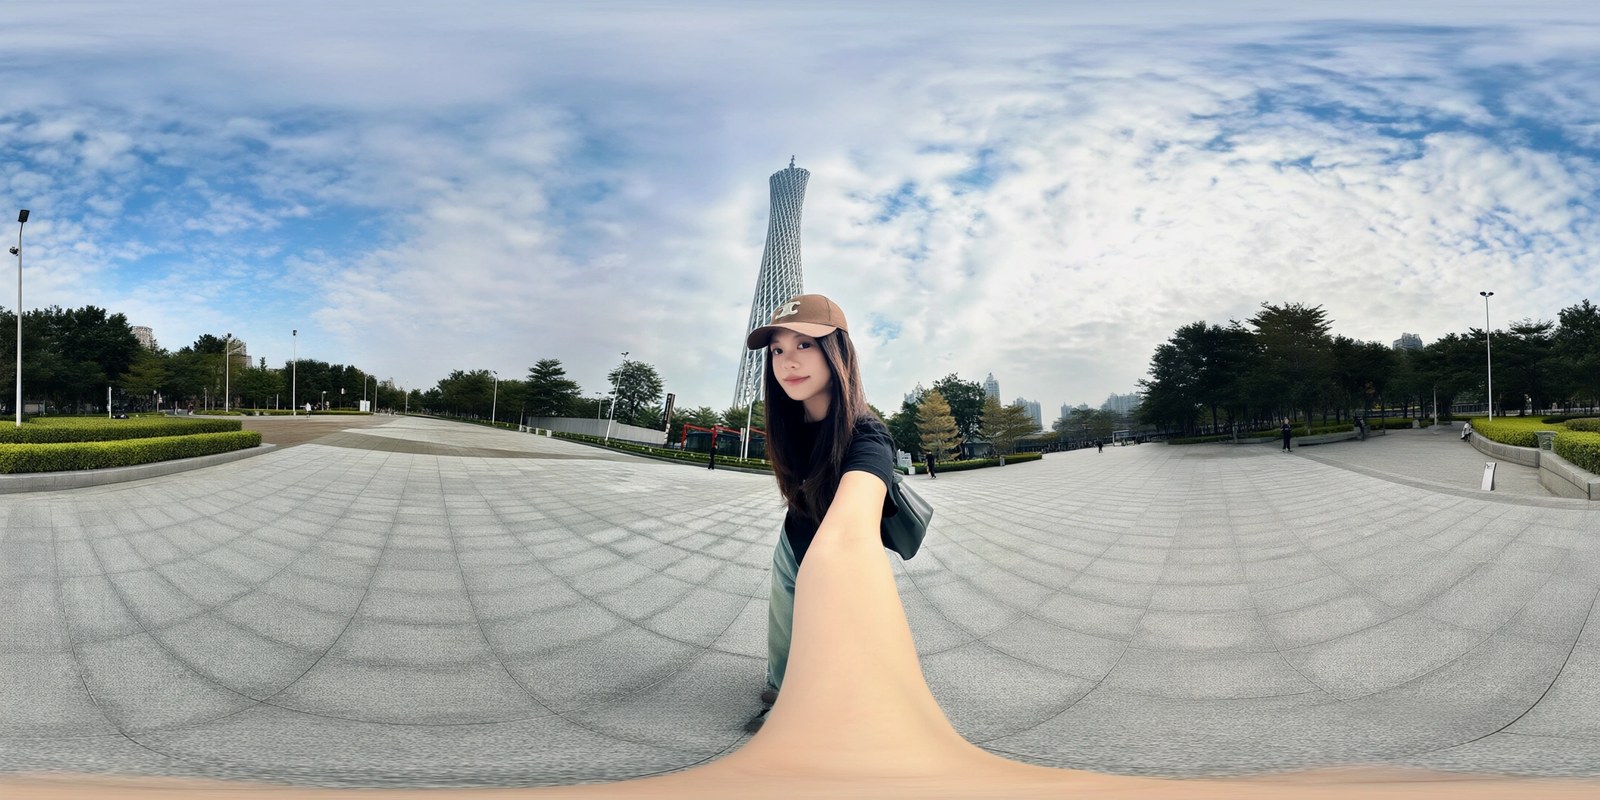
1 枚のパースペクティブ写真から構築した 360 度正距円筒パノラマ。v0.3 が 2176x1088 で 9 ステップにより生成。出典: Viggle のデモ Space の比較タブ。
v0.3 での変更点
蒸留自体は変わっていません。ベースの Qwen-Image 2.1 transformer に対する rank-256 の LoRA で、固定のシグマスケジュール上を true_cfg_scale=1.0 かつネガティブプロンプトなしでサンプリングします。v0.3 は方法ではなくバランスを変えています。
- 6 ステップ、再調整版。 v0.2.1 と比べて粒子感が減り、平坦な面はよりクリーンで、細かいテクスチャは少し柔らかくなっています。Viggle はこれが厳密なアップグレードではないと明言しています。よりくっきりした v0.2.1 の見た目が好みなら、そのアダプターはリポジトリに残っています。
- 新しい 9 ステップモード。 7 回の turbo ステップの後、LoRA をオフに切り替え、未変更のベースモデルが最後の 2 ステップを仕上げます。ディテールはより細かく、レンダリングされた小さな文字が正しく出る頻度も上がります。所要時間は 6 ステップのおよそ 1.4~1.5 倍ですが、それでも 40 ステップのベースより約 3.5 倍高速です。
- 明言された限界。 Viggle は、6 ステップはこの生徒モデルが出せるほぼ限界に近いと書いています。v0.2.1 以降に見つかった改善はどれも何かと引き換えで、くっきりさは粒子感の増加と引き換えに、粒子感の少なさは柔らかい見た目と引き換えに得られています。それ以上はステップ数で品質を買うしかなく、9 ステップモードはまさにそれを行います。
9 ステップモード
9 ステップの経路は、単にスケジュールが長いだけではありません。パイプラインはテキストと参照の K/V を一度計算して再利用します。7 回の turbo ステップがそのキャッシュを埋めるため、LoRA が無効化されてベースが引き継ぐ前の最初のベースモデルステップでは、それを再計算する必要があります。diffusers では、これはステップコールバックと transformer の forward のラッパーを意味し、どちらもモデルカードに示されています。
SIGMAS_9 = [1.0, 0.9583, 0.9167, 0.875, 0.75, 0.5, 0.25, 1 / 6, 1 / 12]6 ステップのスケジュールは低ノイズ側のノード 0.875, 0.75, 0.5, 0.25 を保ち、高ノイズ側にのみステップを追加します。5 ステップは [1, 0.875, 0.75, 0.5, 0.25]、7 ステップは [1, 0.9583, 0.9167, 0.875, 0.75, 0.5, 0.25] です。代わりに低ノイズ側のノードを動かすと結果は柔らかくなり、シグマリストなしで単なるステップ数を渡しても機能しません。
9 ステップは現在 diffusers とデモ Space でのみ 動作します。ComfyUI のワークフローは 6 ステップのスケジュールを実装しています。
公式 ComfyUI サポート
これは v0.2 にはなかった部分です。今回のリリースには、モデルリポジトリの comfyui/ フォルダーに ComfyUI 移植版が含まれ、Qwen-Image 2.1 をネイティブサポートする ComfyUI 0.37.0 に対してテストされています。
viggle_turbo.pyは 2 つのノードを追加します。ComfyUI/custom_nodes/にコピーして再起動してください。Viggle Turbo Sigmasは、パイプラインの解像度依存のシフトを伴う 6 ステップのスケジュールを提供します。Kサンプラーのスケジューラーではなく euler とBasicGuiderと組み合わせて使用し、CFG なし、ネガティブプロンプトなしで使います。Viggle Turbo LoRA (unmerged)は diffusers と同じように実行時にアダプターを適用します。標準の LoRA ローダーはこれを重みにマージしてしまい、Viggle の計測では bf16 でこのアダプターの更新の約 30 パーセントが失われ、int8 ではノイズが加わります。unmerged ノードは 1 ステップあたり 10~25 パーセント余分に時間がかかります。- テキストから画像へおよび編集用のワークフローに加え、マージ済み単一ファイル重み用と GGUF 用のバリアントもあります。
int8 のデフォルト、r128 LoRA、プロンプトエンハンサーを有効にした状態で、ワークフローのピークは 1248x832 で約 26 GB の VRAM に達します。モデルカードはまた、ComfyUI 移植版はほとんどが AI コーディングアシスタントによって書かれたため、粗い部分があるのは想定内であり、修正は歓迎されると述べています。
マージ済み単一ファイル transformer
LoRA をまったく読み込みたくない場合、v0.3 は rank-256 アダプターを fp32 でマージし一度だけ量子化したベース transformer も同梱しています。ファイルは models/diffusion_models/ に置きます。GGUF 版には ComfyUI-GGUF が必要で、どの経路でもカスタムノードの Viggle Turbo Sigmas が必要です。この方法では 6 ステップモードのみが利用できます。
| フォーマット | サイズ | ComfyUI ローダー | LPIPS v0.3 | LPIPS v0.2.1 |
|---|---|---|---|---|
| GGUF Q8_0 | 7.7 GB | Unet Loader (GGUF) | 0.051 | 0.054 |
| int8、Comfy-Org convrot レシピ | 7.3 GB | Load Diffusion Model | 0.057 | 0.060 |
| GGUF Q6_K | 6.0 GB | Unet Loader (GGUF) | 0.055 | 0.067 |
| fp8 e4m3fn、weight-only | 7.3 GB | Load Diffusion Model | 0.068 | 0.070 |
| GGUF Q5_K_M | 5.1 GB | Unet Loader (GGUF) | 0.076 | 0.083 |
| GGUF Q4_K_M | 4.3 GB | Unet Loader (GGUF) | 0.100 | 0.118 |
| int8 と r128 LoRA(LoRA ワークフロー) | 8.0 GB | Load Diffusion Model | 0.041 | 0.044 |
LPIPS は、rank-256 LoRA を実行する diffusers に対する Viggle の平均 VGG 距離で、同じプロンプト、入力、シード、ノイズを用いた 96 件のホールドアウトリクエストで測定したものです。値が低いほど近いことを示します。目安として、LoRA を読み込まない状態で ComfyUI と diffusers は約 0.03~0.04 異なります。
マージ済み重みは LoRA 経路に近いものの、同一ではありません。96 件のうちおよそ 8 件で、マージ済み int8 または Q8_0 ビルドは異なる構図や服装になり、LoRA ワークフローでは 3~5 件です。Q4_K_M は 96 件中 23~29 件と明らかに大きくずれ、Viggle はより大きなものがメモリに収まらない場合にのみ推奨しています。
40 ステップのベースと 6・9 ステップの比較
以下の例は Viggle 自身のデモ Space の比較タブからのものです。すべての列で同じプロンプト、入力、シード、ノイズを使用しています。
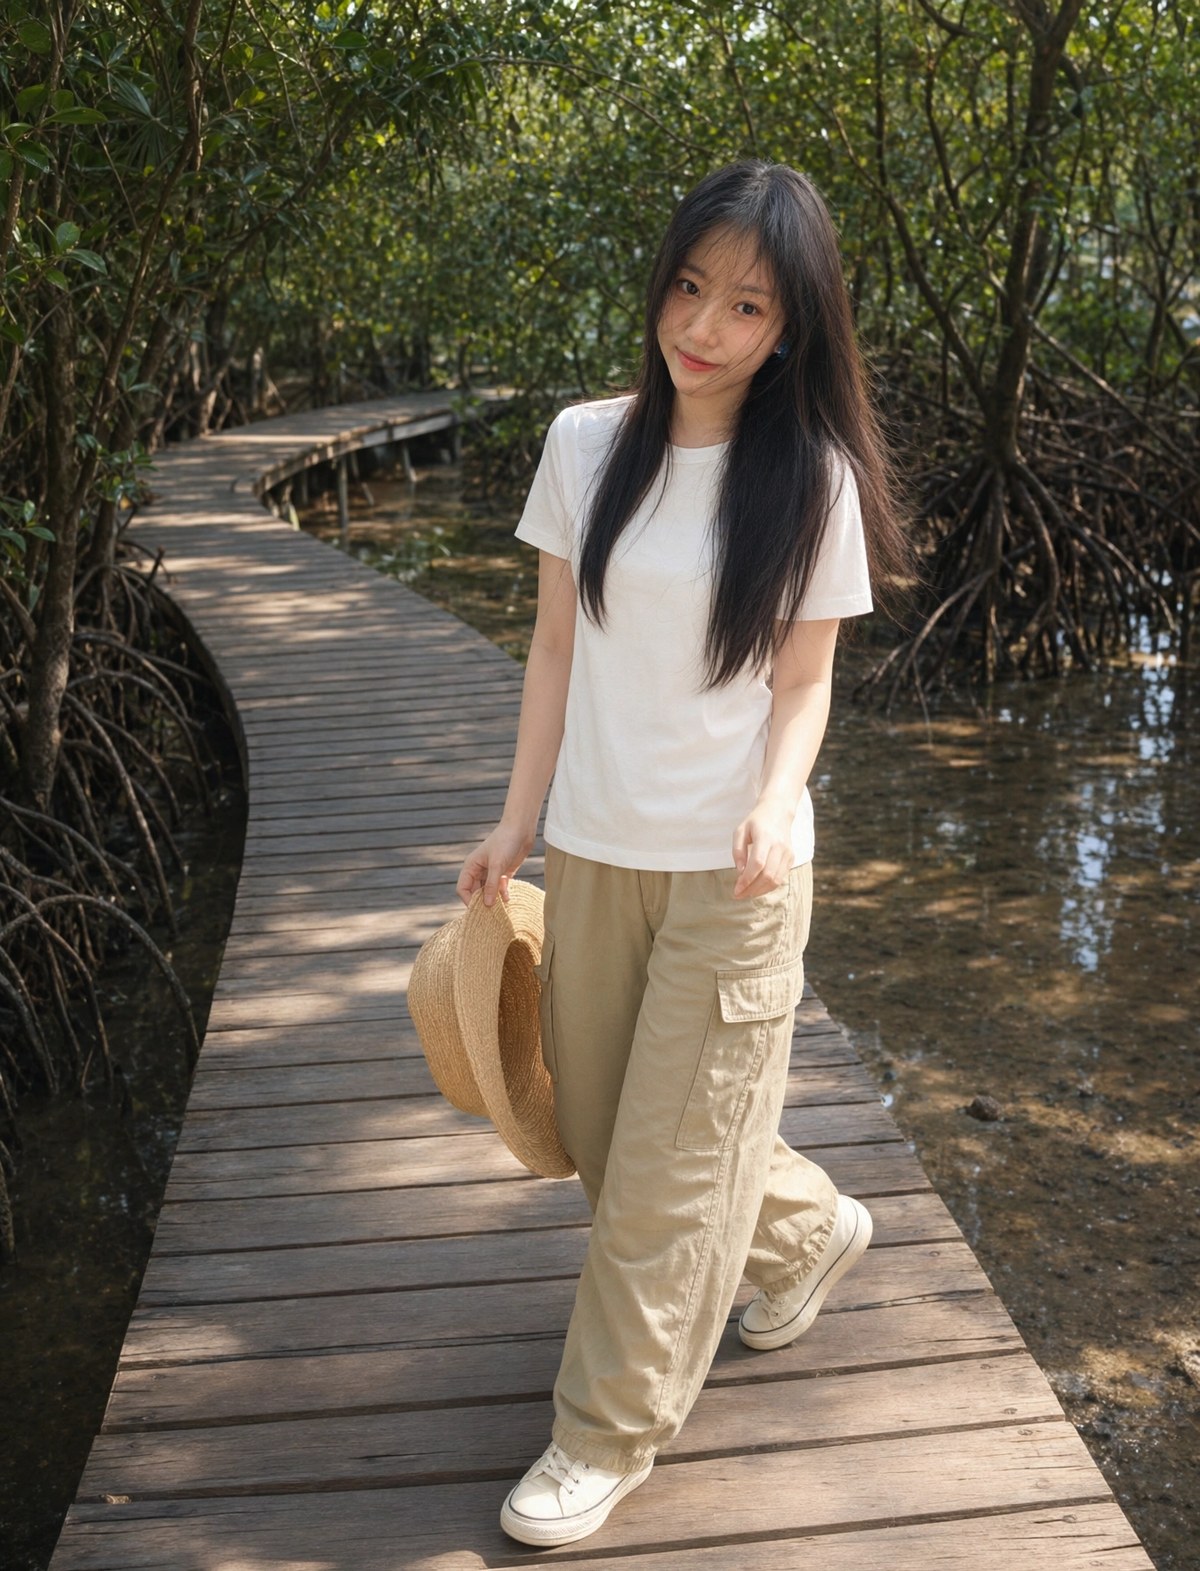 | 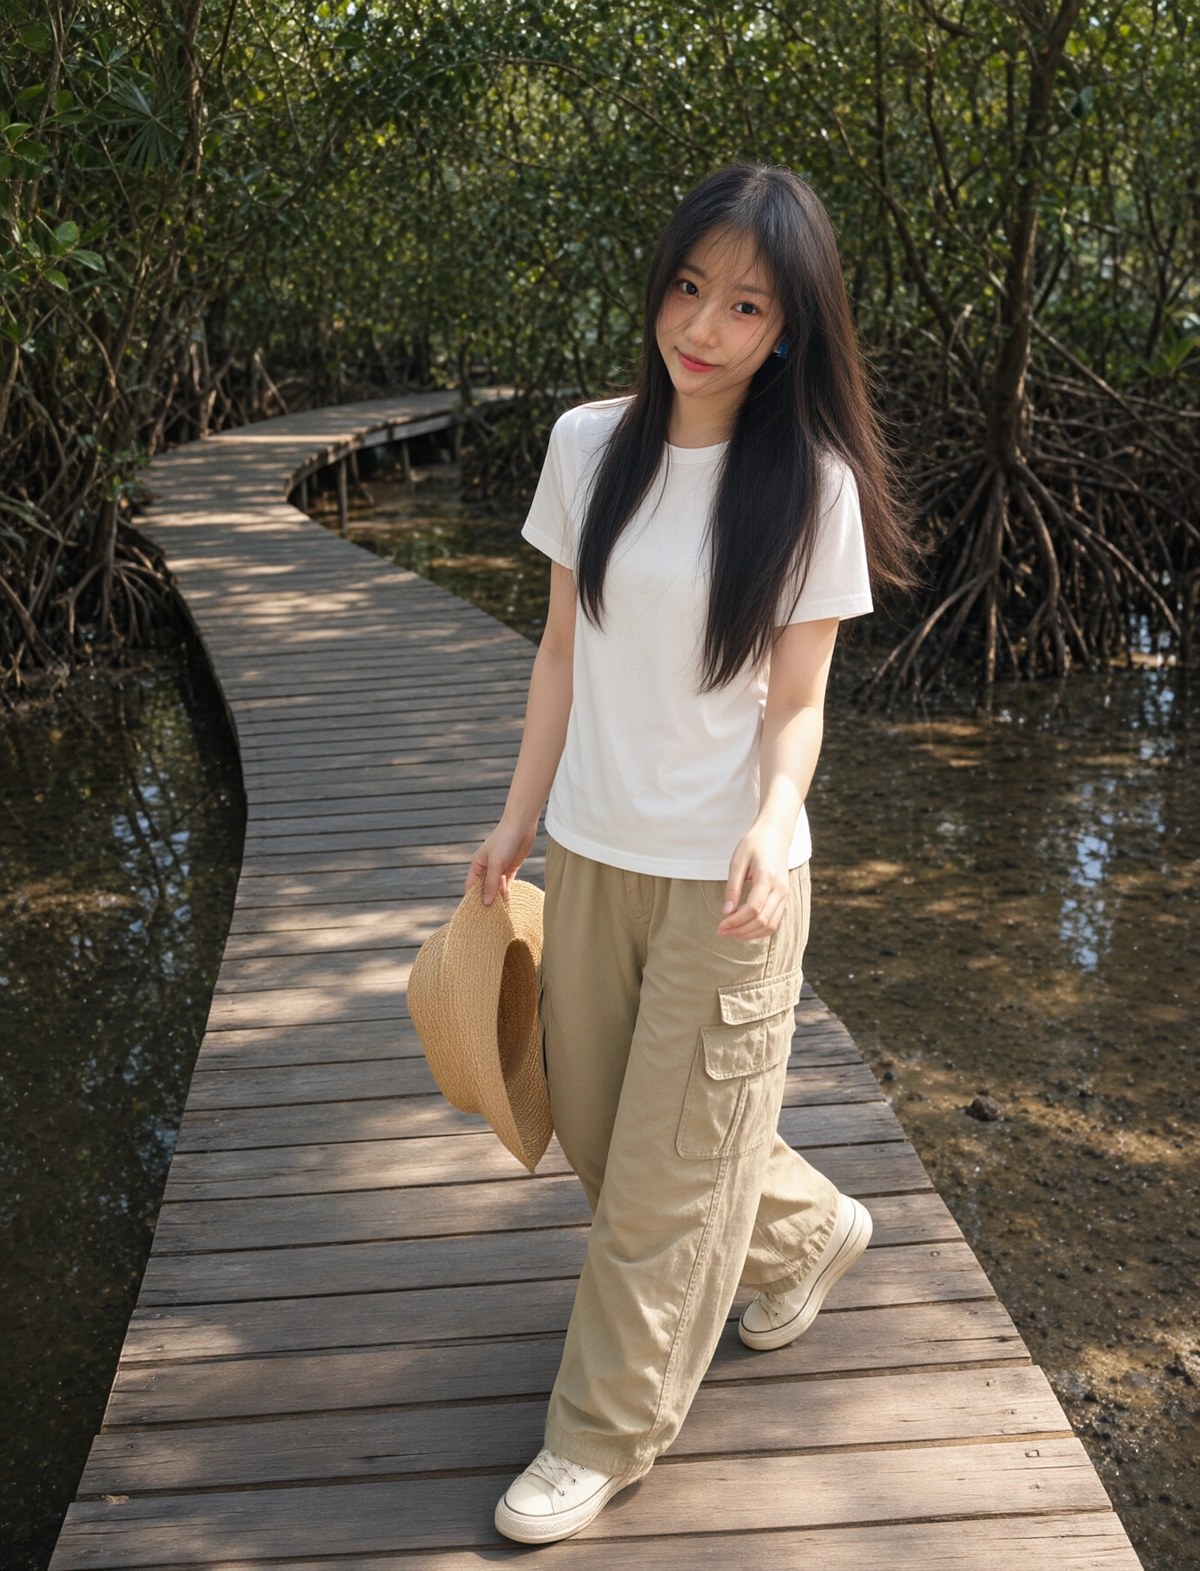 | 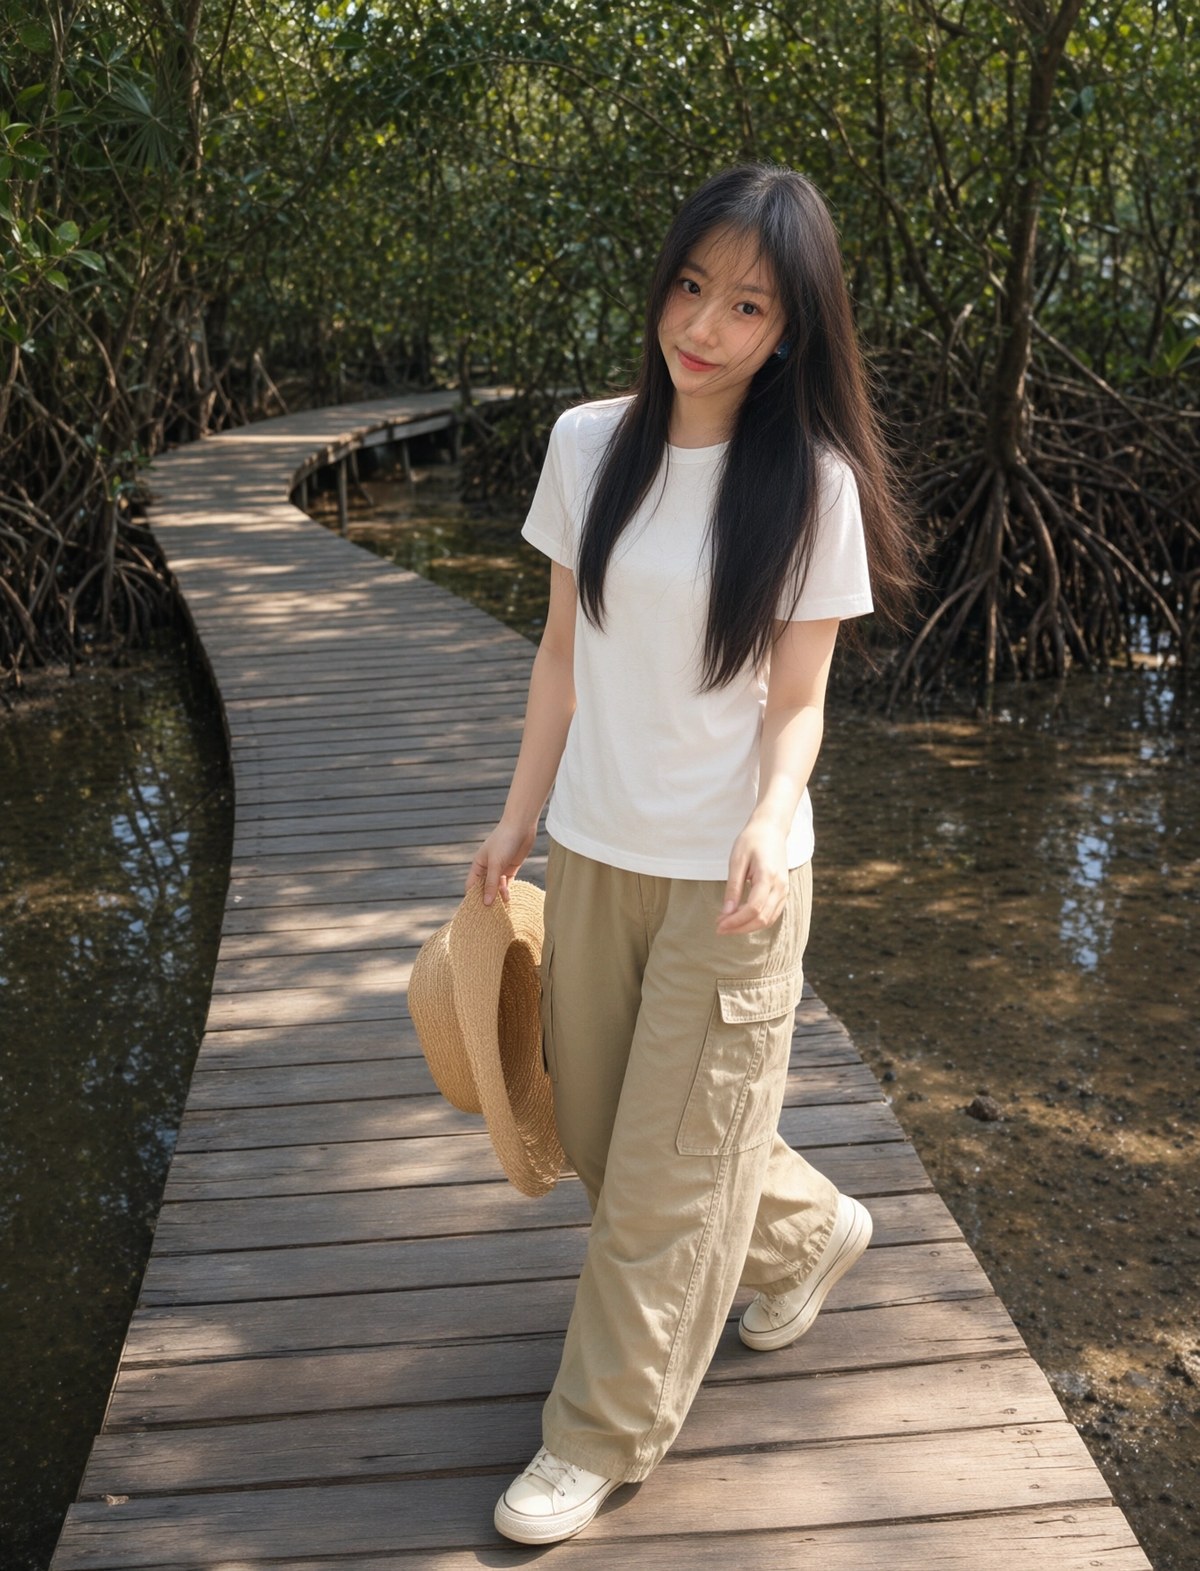 |
|---|---|---|
| ベースモデル、40 ステップ | v0.3、6 ステップ | v0.3、9 ステップ |
マングローブの遊歩道のシーンに持ち込んだキャラクター参照、1344x1760。6 ステップの結果は 2 つの turbo 列のうち最もクリーンです。9 ステップは細かいテクスチャの一部を取り戻します。
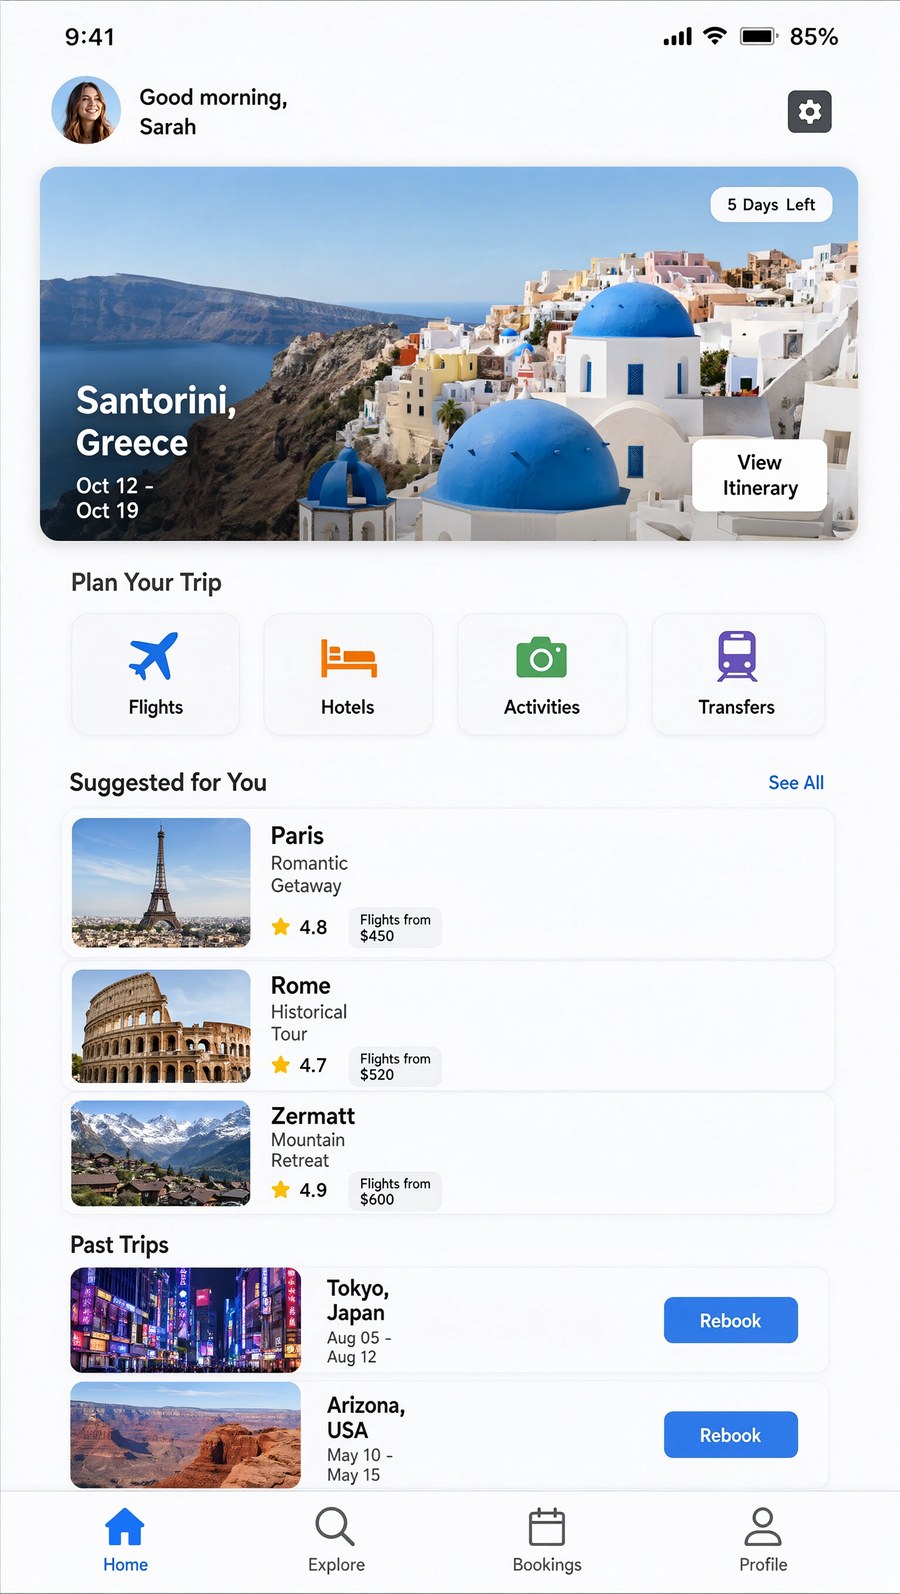
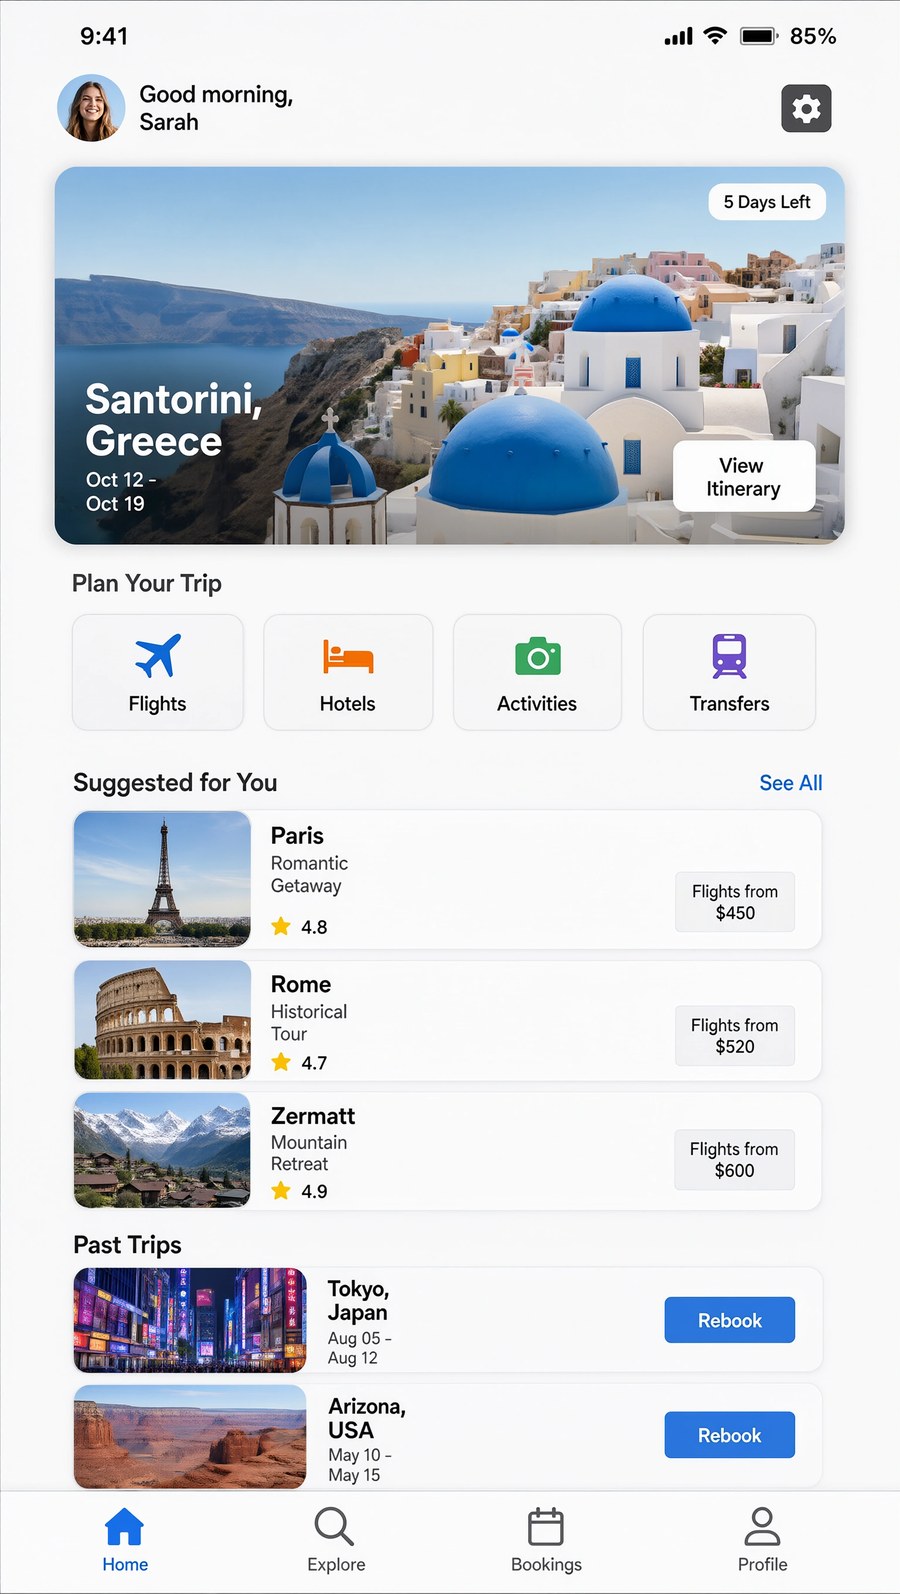
9 ステップモードは、6 ステップの生徒モデルが依然としてベースモデルに劣る 2 つの点、すなわち密なレンダリングテキストと細部を対象としています。1536x2720 の、小さな UI テキストが多い垂直のアプリスクリーンショットは妥当なストレステストであり、比較タブでもこれが実行されています。
 |  |
|---|---|
| ベースモデル、40 ステップ | v0.3、9 ステップ |
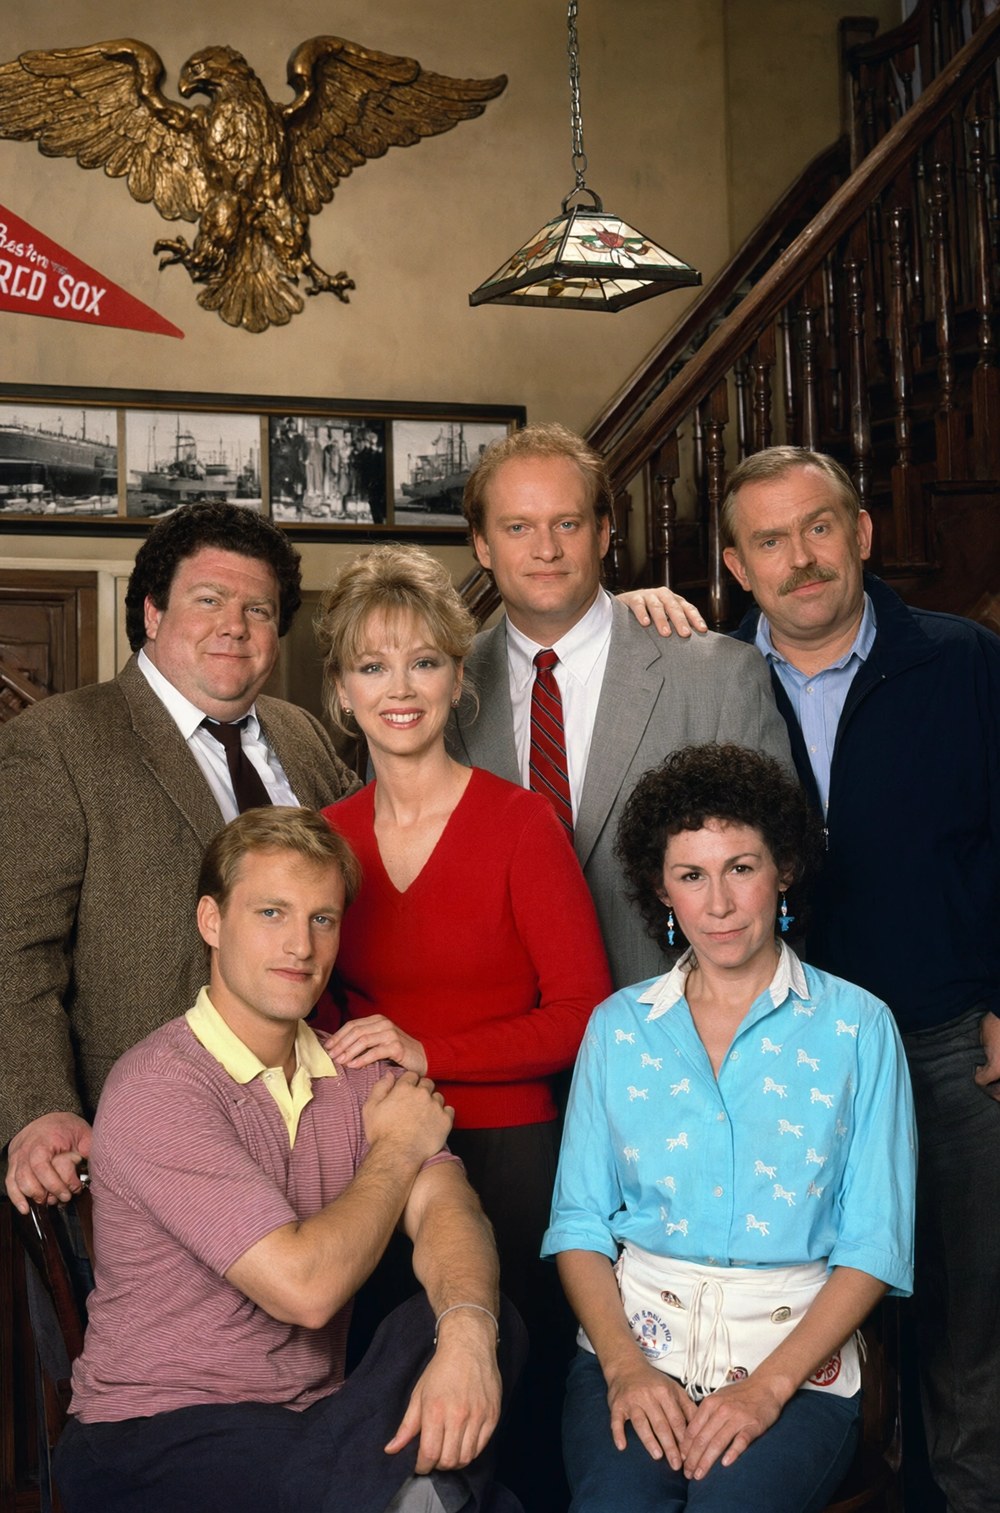
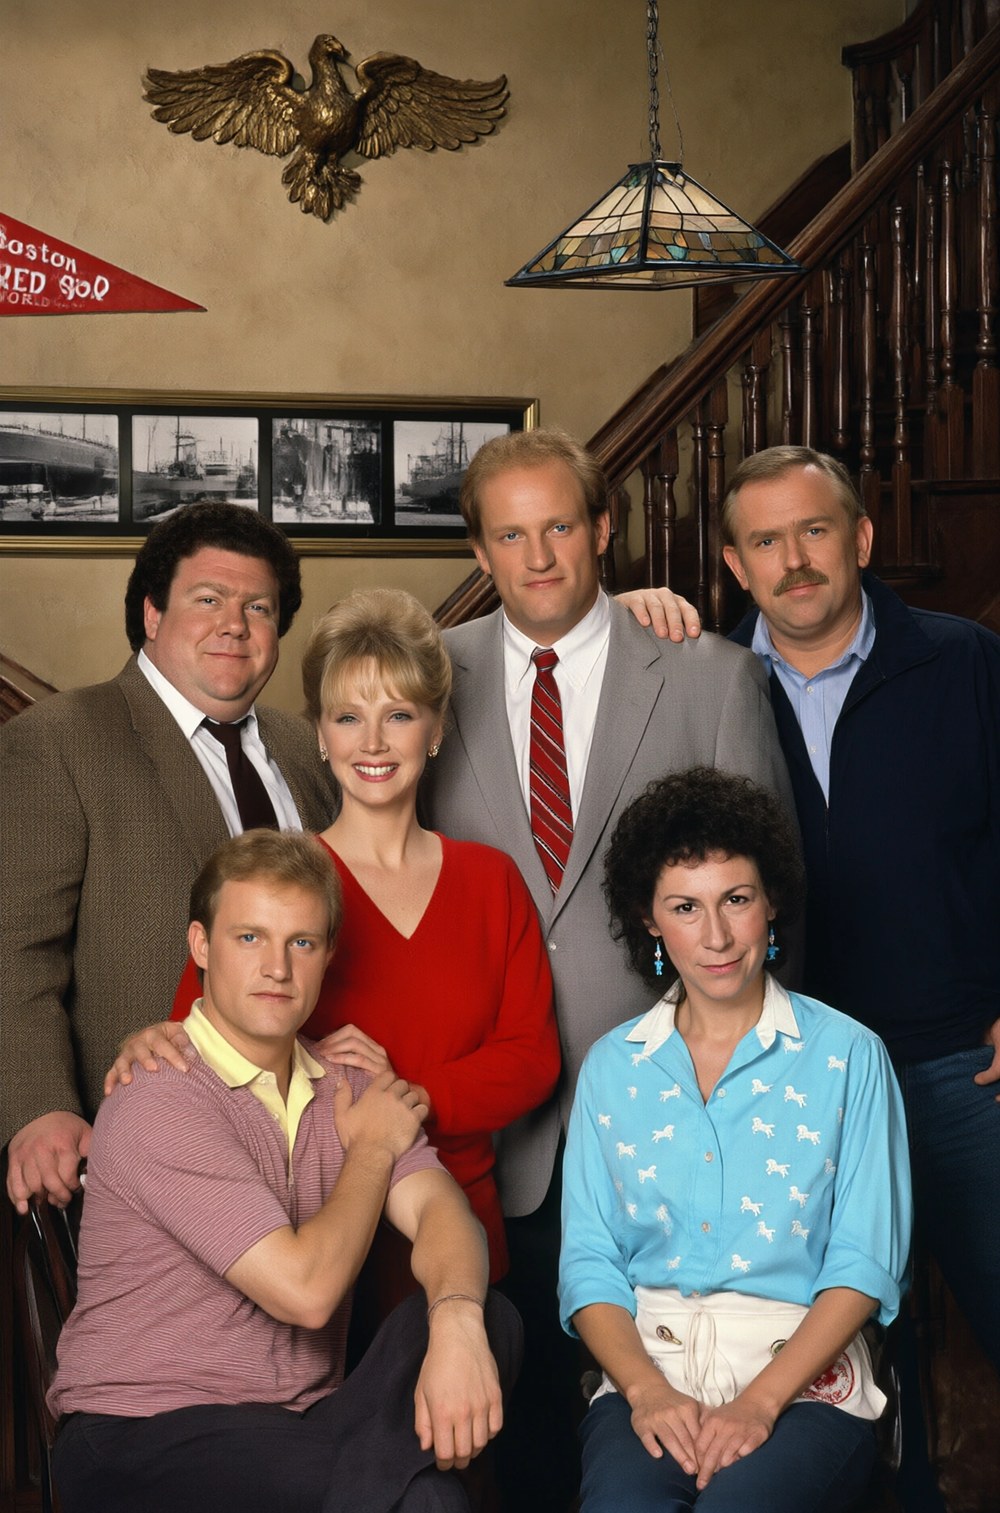
この蒸留版は diffusers で最大 3 枚の参照画像でも動作し、以下の 6 枚の画像による集合ポートレートはその経路を試しています。6 人の人物、1 つのプロンプト、1 つのバー内装です。
 |  |
|---|---|
| ベースモデル、40 ステップ | v0.3、6 ステップ |
速度
同じ比較の、デモ Space で報告されている画像あたりの秒数:
| ケース | 解像度 | ベース、40 ステップ | v0.3、6 ステップ | v0.3、9 ステップ |
|---|---|---|---|---|
| 参照からのポートレート | 1344x1760 | 14.0 s | 2.9 s | 4.0 s |
| 6 参照の集合ポートレート | 1248x1888 | 25.8 s | 5.9 s | 8.8 s |
| 密なアプリスクリーンショット | 1536x2720 | 26.9 s | 4.9 s | 6.8 s |
| 360 度パノラマ | 2176x1088 | 14.3 s | 2.9 s | 4.1 s |
まだできないこと
モデルカードは残りのギャップについて異例なほど率直です。複雑な編集は依然として生徒モデルが劣る領域です。複数参照の構図、顔の入れ替え、人物の同一性を保つ指示では、人物が重複したりゴーストのように二重に現れたり、同一性がずれたりすることがあります。小さな文字や長いレンダリングテキストはベースモデルより頻繁に崩れ、9 ステップはそれを改善はしても解決はしません。色は数パーセント彩度が低くなります。2K 出力、RGBA 出力、マスク誘導の編集、3 枚を超える参照を使った編集は比較タブで目視確認されているだけで、ベンチマークは主張されていません。
コメント
GitHubでサインインしてディスカッションに参加しましょう。