MiniMax H3 TRT VAE: ComfyUIでH3デコードを1.7倍高速化
MiniMax H3動画VAEをTensorRTエンジンにコンパイルするComfyUIノードパック。VAEエンコードとデコードの時間を最大1.7倍削減し、低VRAM向けのw4a16デコーダーも備えます。
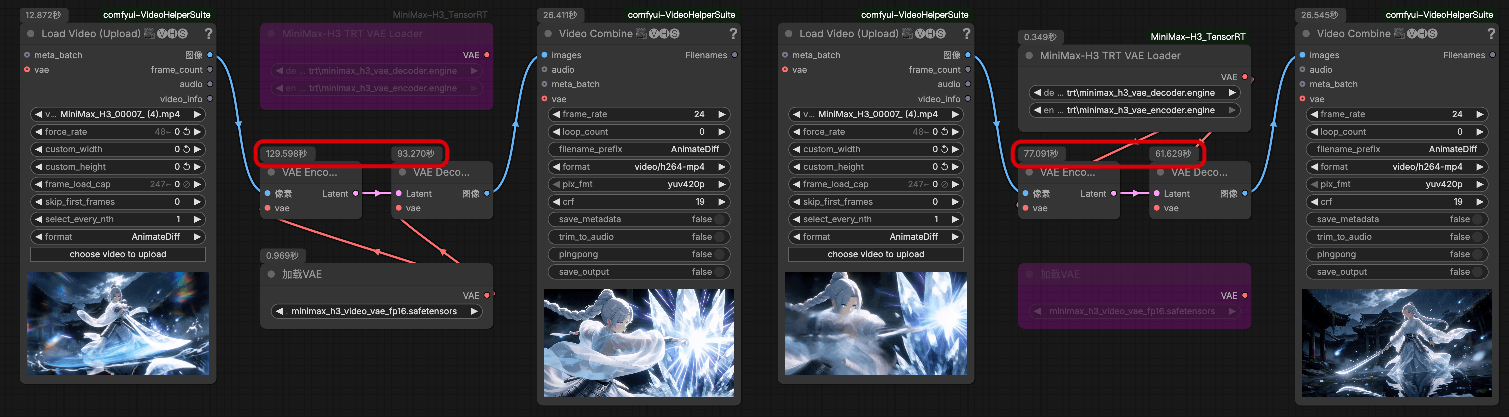
プロジェクトのREADMEからのプレビュー: ComfyUIグラフ内のTRT VAEコンパイルノードとロードノード。
VAEデコードはH3の実行ごとに必ず発生する固定コストです。公式のComfyUIカーネルはPyTorch側でこのコストを削減しましたが、このノードは別のルートを取り、VAEをコンパイル済みのTensorRTエンジンに引き渡します。
このノードの機能
このパックには2つのノードと、エンジンに至るONNXルートが含まれています。
- MiniMax-H3 TRT VAE CompilerはONNXエンコーダーとデコーダーを受け取り、TensorRTエンジンをビルドします。これは1回だけの手順で、コンパイル済みエンジンはその後再利用されます。
- MiniMax-H3 TRT VAE Loaderはコンパイル済みエンジンをロードし、通常のVAEの代わりに使用できるようにします。
重みはHugging FaceでONNXファイルとして公開されており、ComfyUI/models/vaeに配置します。このパックには、ComfyUIの外でエンジンをビルドするためのスタンドアロンのcompile.pyも含まれており、コンパイル手順でUIをブロックしたくない場合に便利です。
セットアップ
| 手順 | 操作 |
|---|---|
| 1 | ComfyUI/custom_nodesにgit clone https://github.com/lihaoyun6/ComfyUI-H3VAE_TRTしてrequirements.txtをインストール |
| 2 | ONNXエンコーダーとデコーダーをダウンロードしてComfyUI/models/vaeに配置 |
| 3 | MiniMax-H3 TRT VAE Compilerを一度実行してエンジンをビルド |
| 4 | ワークフローのVAEをMiniMax-H3 TRT VAE Loaderに切り替え |
ONNXリポジトリにはw4a16_awqデコーダーバリアントも含まれており、GPUのVRAMが12GB以上ない場合にREADMEが推奨しています。
イシュートラッカーからの注意点
コンパイル前にリポジトリの問題を読んでおく価値があります。TensorRTのビルドはインストール済みのスタックに敏感だからです。
- エンジンのコンパイルは遅い。ある報告では1回のビルドで5時間以上かかったと測定されているため、最初のコンパイルはセッションの途中ではなく事前に行うのが最善です。
- TensorRTとCUDAのバージョンを揃える必要があります。TensorRT 11.2とCUDA 13.0に関する未解決の報告があり、別の構成では
IBuilder::buildSerializedNetworkのAPI利用エラーも報告されています。 - コンパイル済みエンコーダーが最初、最後、参照フレームに残したグリッドパターンが報告され、9月上旬に修正されました。そのため現在の
mainからのビルドではこの問題を回避できます。
入手先
ノードパックとONNXの重みはどちらも公開されています。
ノードパック: lihaoyun6/ComfyUI-H3VAE_TRT
ONNXの重み: lihaoyun6/MiniMax-H3-VAE-ONNX
ベースモデル: MiniMaxAI/MiniMax-H3
このパックにはサンプルワークフローは同梱されていません。コンパイラとローダーは、スタンダードなVAEノードの代わりに既存のH3グラフに組み込みます。
コメント
GitHubでサインインしてディスカッションに参加しましょう。