MiniMax H3 FaceSwap LoRA で任意の参照動画の人物を顔ごと置き換える
MiniMax H3 Ref2VA 向けの UntMods 製 FaceSwap LoRA は、参照動画の人物のアイデンティティを参照画像の顔に置き換えます。すぐに使える ComfyUI ワークフローも付属します。
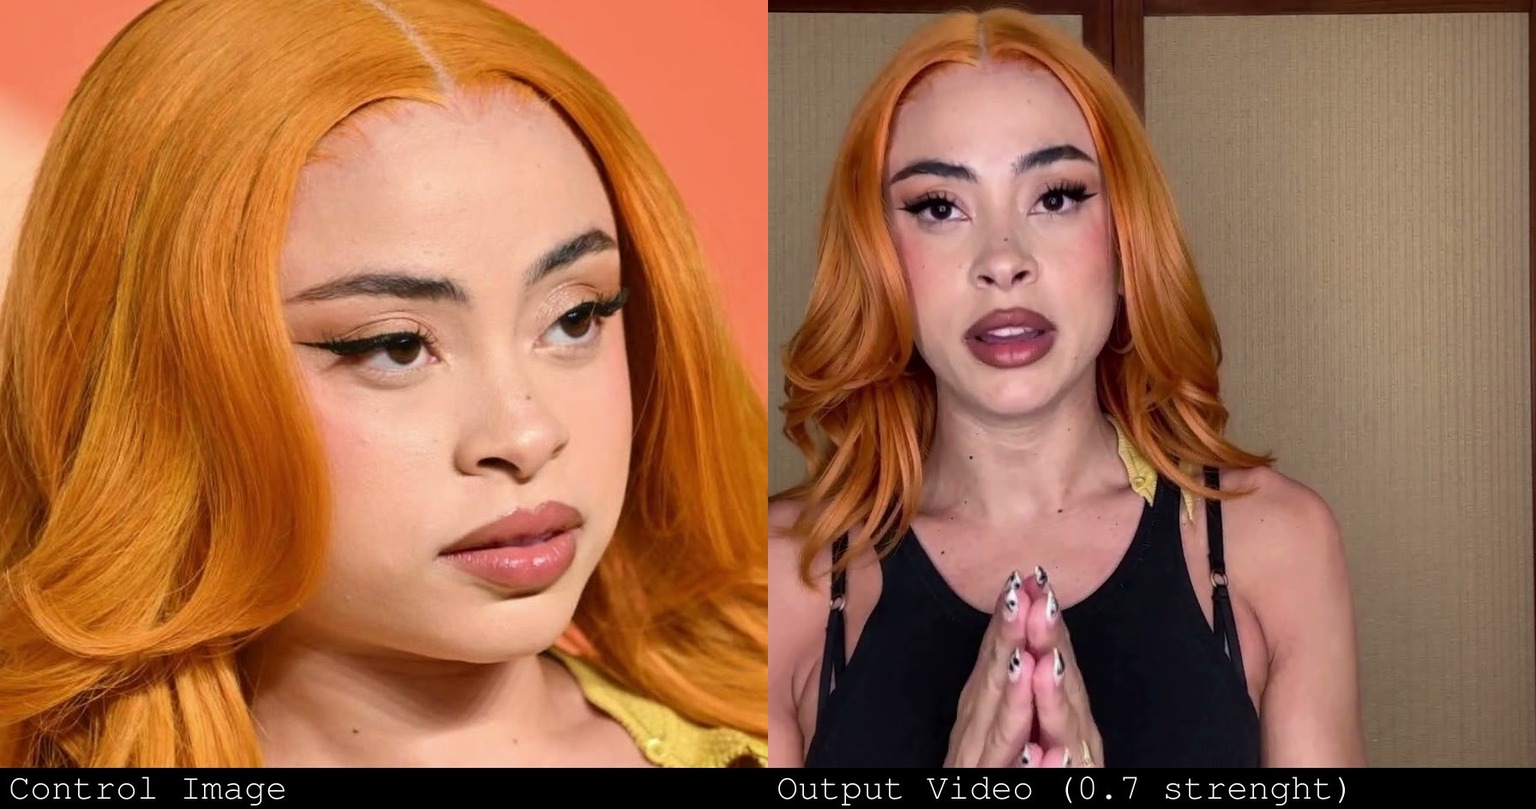
左: 新しいアイデンティティを供給するコントロール画像。右: それを使って生成された出力クリップの1フレーム。
LoRA が変えるもの
MiniMax H3 での顔の置き換えは、通常、参照画像スタック全体を学習済みの挙動から強制的に外すことを意味します。ref2va バリアントはすでに参照画像を受け付けますが、それは人物を上書きするためではなく、外観、服装、シーンを誘導するために使われます。このアダプターはその役割を顔だけに絞り込みます。保持したいクリップと、新しいアイデンティティの参照画像を1枚以上入力し、トリガーワード Faceswap を1つ書くだけで、サンプラーがいつスワップを適用すべきかを判断します。
モデルカードからの実用的な詳細:
ref2va向けに学習済み。fl2vaブランチではなく、参照から動画と音声への H3 重みの上に適用されます。- トリガーワードは1つ、
Faceswap、強度は 1.0。 - プルーニング済みアダプター。 作者のしきい値を下回るブロックは safetensors ファイルから削除されており、ダウンロードサイズが 63 MB に抑えられ、作者いわく「LoRA のアーティファクトが減り、学習済みベースと同一の強度」になるそうです。
- 複数の参照が可能。 付属のワークフローには参照画像ローダーが3つ含まれており、このノードは「単一または複数の参照画像で動作する」と記されています。
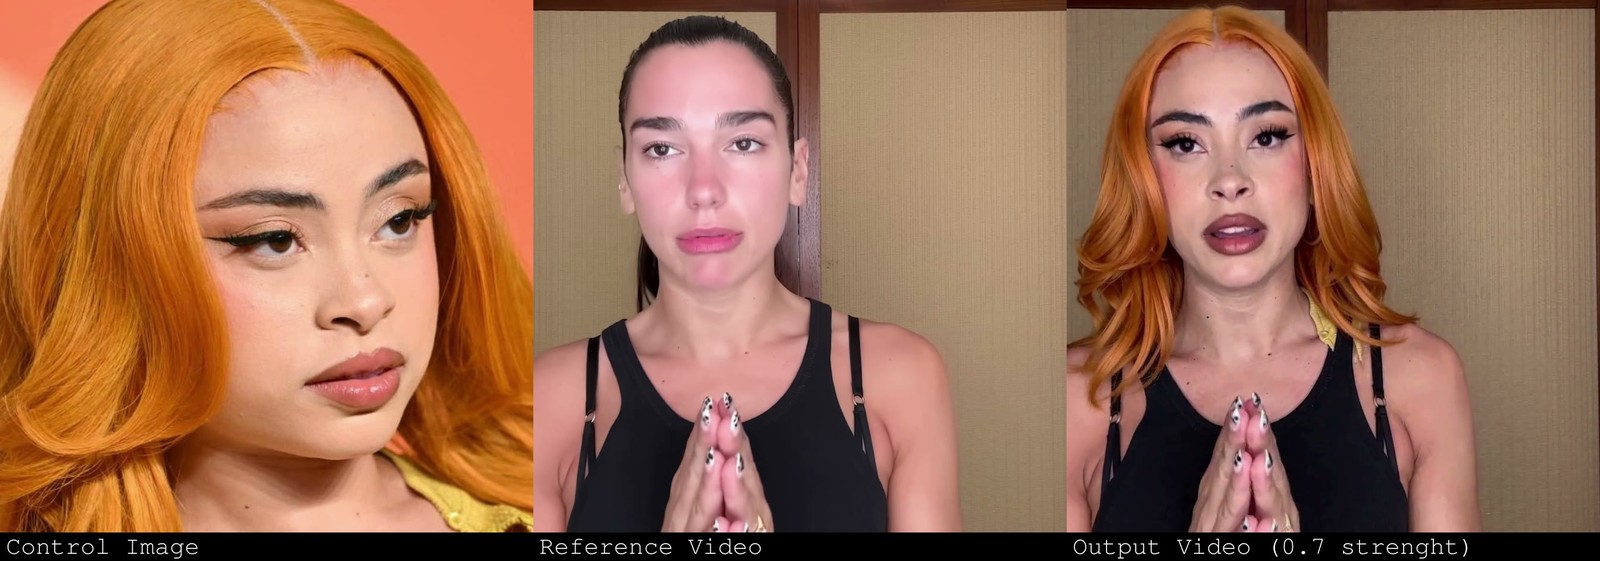
公開されているデモクリップは、ラベルが焼き込まれた3パネル比較です。左がコントロール画像、中央が参照動画、右が置き換え後の出力です。
ComfyUI での実行
リポジトリには SS_FaceSwap_MiniMax REF2V.json が含まれています。これは作者自身の CRT-Nodes パックと、動画の読み込みと多重化のための ComfyUI-VideoHelperSuite を基盤としたフロントエンド形式のワークフローです:
CRT-Nodes(ComfyUI Manager ではCRT-Nodesとして入手可能)とComfyUI-VideoHelperSuiteをインストールし、ComfyUI を再起動します。- モデルリポジトリから
SS_FaceSwap_MiniMax_H3_REF2VA.safetensorsをComfyUI/models/loras/MiniMaxH3/SS_FaceSwap/にダウンロードします。これはワークフローが想定しているパスです。 - ワークフローを開き、VHS の動画ローダーにソースクリップを、参照画像ローダーに新しいアイデンティティを読み込み、プロンプトに
Faceswapを入れます。
サンプルワークフローでは、LoRA は LoraLoaderModelOnly を介して強度 1.0 で接続され、その隣の2つ目のスロットには 8ステップの Ref2VA turbo LoRA が入っているため、デモクリップは高速化されたステップ数でレンダリングされます。そのサンプラーは R2V モードの CRT MiniMaxH3UnifiedSampler で、パックの「Balanced (recommended)」プリセットを使用しています。モデルとともに公開された比較クリップには 0.7 strength とラベル付けされています。checkpoint、テキストエンコーダー、VAE のスロットは、プルーニング済みの int8 convrot ref2va ベース、nvfp4 Qwen3-VL 32B テキストエンコーダー、そして H3 の個別の int8 動画 VAE と fp32 音声 VAE を指しています。
トリガーワードは条件付けの半分にすぎません。このアダプターは参照画像からアイデンティティを取り出すように学習されているため、クリップ自体の被写体は動き、タイミング、フレーミング、音声を保ったまま、顔だけが置き換えられます。
モデルカードの例
転送されるアイデンティティは人間でなくてもかまいません。公開されている2つ目の比較では、黒猫が顔を供給し、その結果がソースクリップのプレゼンターに重なっています:
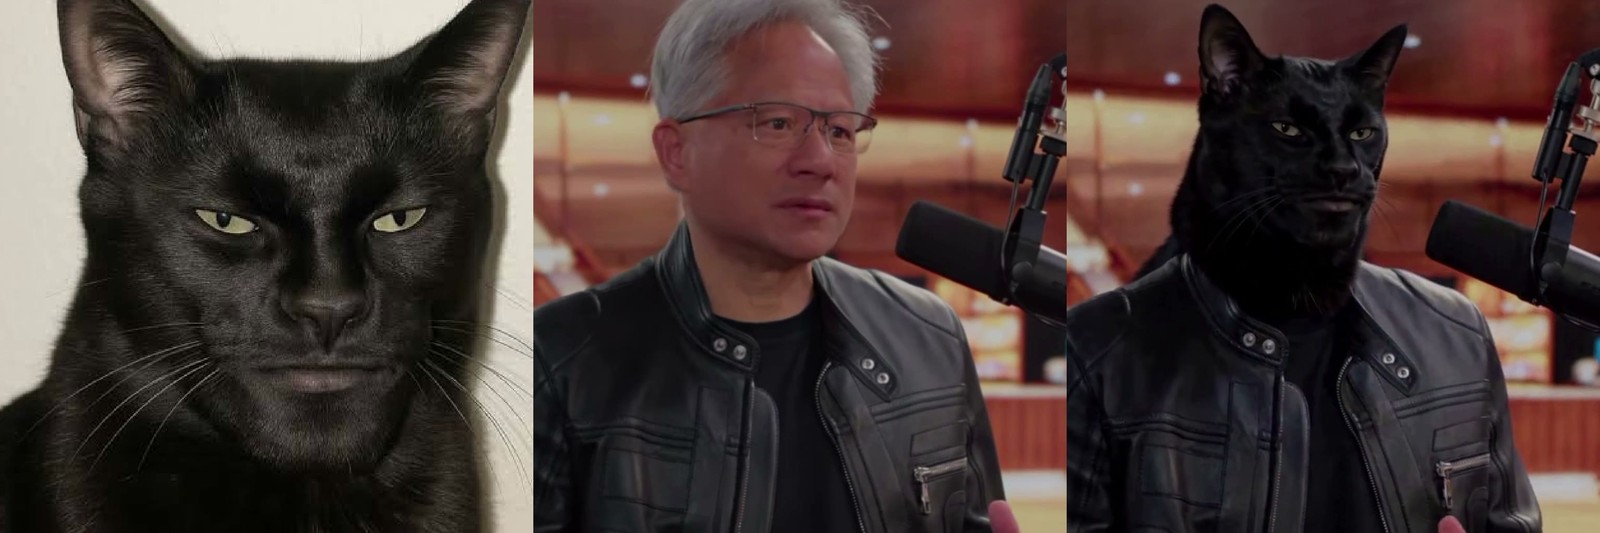
左がコントロール画像、中央が参照動画、右が出力です。
コントロール画像、参照動画、そして強度 0.7 での出力。音声はソースクリップのものが保持されています。
同じパイプラインを使って、猫のアイデンティティをスタジオのプレゼンターに移した例。
入手方法
- モデルカードと重み: UntMods/FaceSwap_MiniMaxH3_REF2VA
- ワークフロー JSON:
SS_FaceSwap_MiniMax REF2V.json - ノードパック: PGCRT/CRT-Nodes
このリンクは Banodoco の #minimax_h3_chatter で9月19日に共有され、モデルカードは最初の数日で55件以上のいいねを集めています。公開されているデモは作者自身のクリップであり、執筆時点で第三者のテスト結果は出ていません。
コメント
GitHubでサインインしてディスカッションに参加しましょう。