ComfyUI-VOSR2: ワンステップのVOSR 2.0アップスケーラーをComfyUIで利用可能に
VOSR 2.0用のコミュニティノード。Qwen-Image VAEとDINOv2条件付けを備えたワンステップ1.4B超解像モデルで、重みの自動ダウンロードとタイルによる4倍アップスケーリングに対応します。
VOSR 2.0とは
VOSR 2.0は、3つの固定された要素から構成されるワンステップ超解像モデルです。LightningDiTバックボーン、潜在空間としての Qwen-Image 2D VAE、条件付け用の DINOv2-L ビジョンエンコーダーです。従来のリサイズとシャープ化の処理ではなく生成的であるため、低解像度入力に文字通り存在しない構造(文字の字形、顔の特徴、建物の輪郭など)を再構築できます。
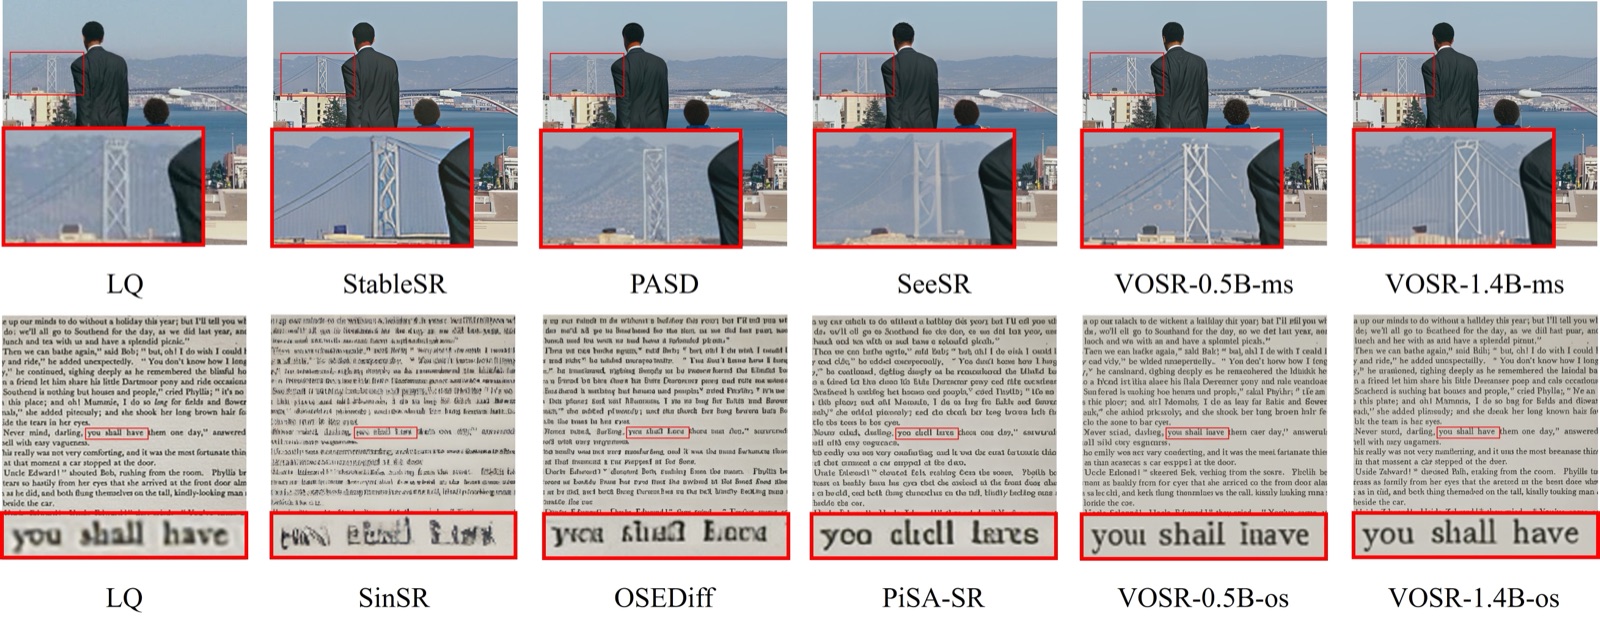
モデルカードによる比較: 細かい構造と小さなテキストのケースで、論文がVOSR 2.0を最も強力と位置づけています。
これらの要素は1つの学習済みセットに属するため、ノードパッケージはそれらを バンドル として扱います。DiTは学習時に対応したQwen 2D VAEでしか動作せず、ビジョンエンコーダーも同様にマッチングされています。差し替え可能な個別のVAEやエンコーダーの入力はありません。
2つのノード
どちらのノードも image/upscaling/VOSR2 以下にあります。
| ノード | クラス | 役割 |
|---|---|---|
| VOSR 2.0 Model Loader | VOSR2ModelLoader | バンドルフォルダーを読み込み VOSR2_MODEL を返すため、キューに入れた画像ごとに重みを再構築しません |
| VOSR 2.0 Upscale | VOSR2Upscale | 画像バッチに対してワンステップ超解像を実行します |
アップスケールノードは、upscale 倍率(デフォルト4、上限なし)、潜在ノイズ用の seed(バッチ項目 i は seed + i を使用)、バイキュービックのターゲットに対して後処理を行う color_alignment モード(wavelet、adain、none)、そしてDiTとVAEそれぞれのタイル制御を受け取ります。
512pxを超える場合、タイルは任意ではない
ジョブをキューに入れる前に読む価値があるのがこの点です。VOSR 2.0は最大 512 px でネイティブに学習されているため、アップスケール後の出力が512x512を超える場合は必ず tile_size(ドキュメント記載値は512)を設定する必要があり、そうしないと品質が低下します。1024 pxを大きく超える出力では、vae_tile_size も1024程度に設定してください。そうしないと画像全体のVAEデコードでメモリ不足になる可能性が高いです。
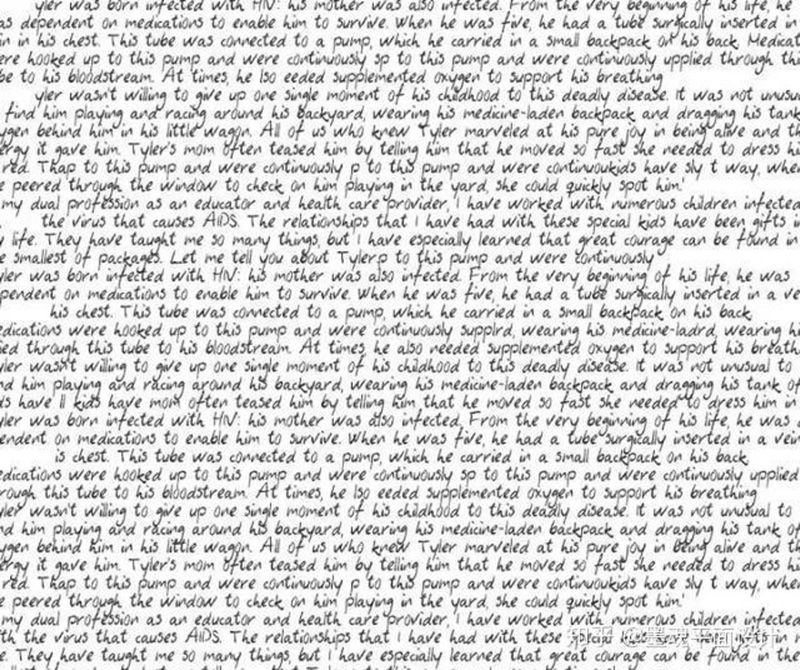 | 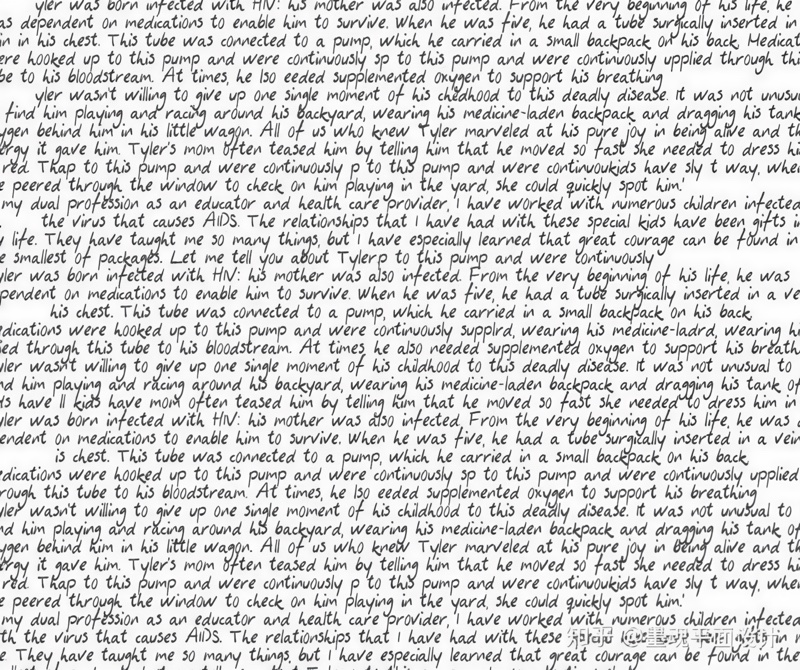 |
|---|---|
| 小さな文字を含む低解像度入力 | VOSR 2.0の出力 |
ローダーは何かを構築する前に args.json を固定のVOSR 2.0アーキテクチャと照合して検証するため、互換性のないcheckpointは部分的に読み込まれるのではなく、明確なメッセージとともに失敗します。models/vosr2/ 以下に置かれ、args.json を含むバンドルフォルダーはどれもモデルのドロップダウンに表示されますが、自動でダウンロードされるのは VOSR2 のみです。
ワークフロー
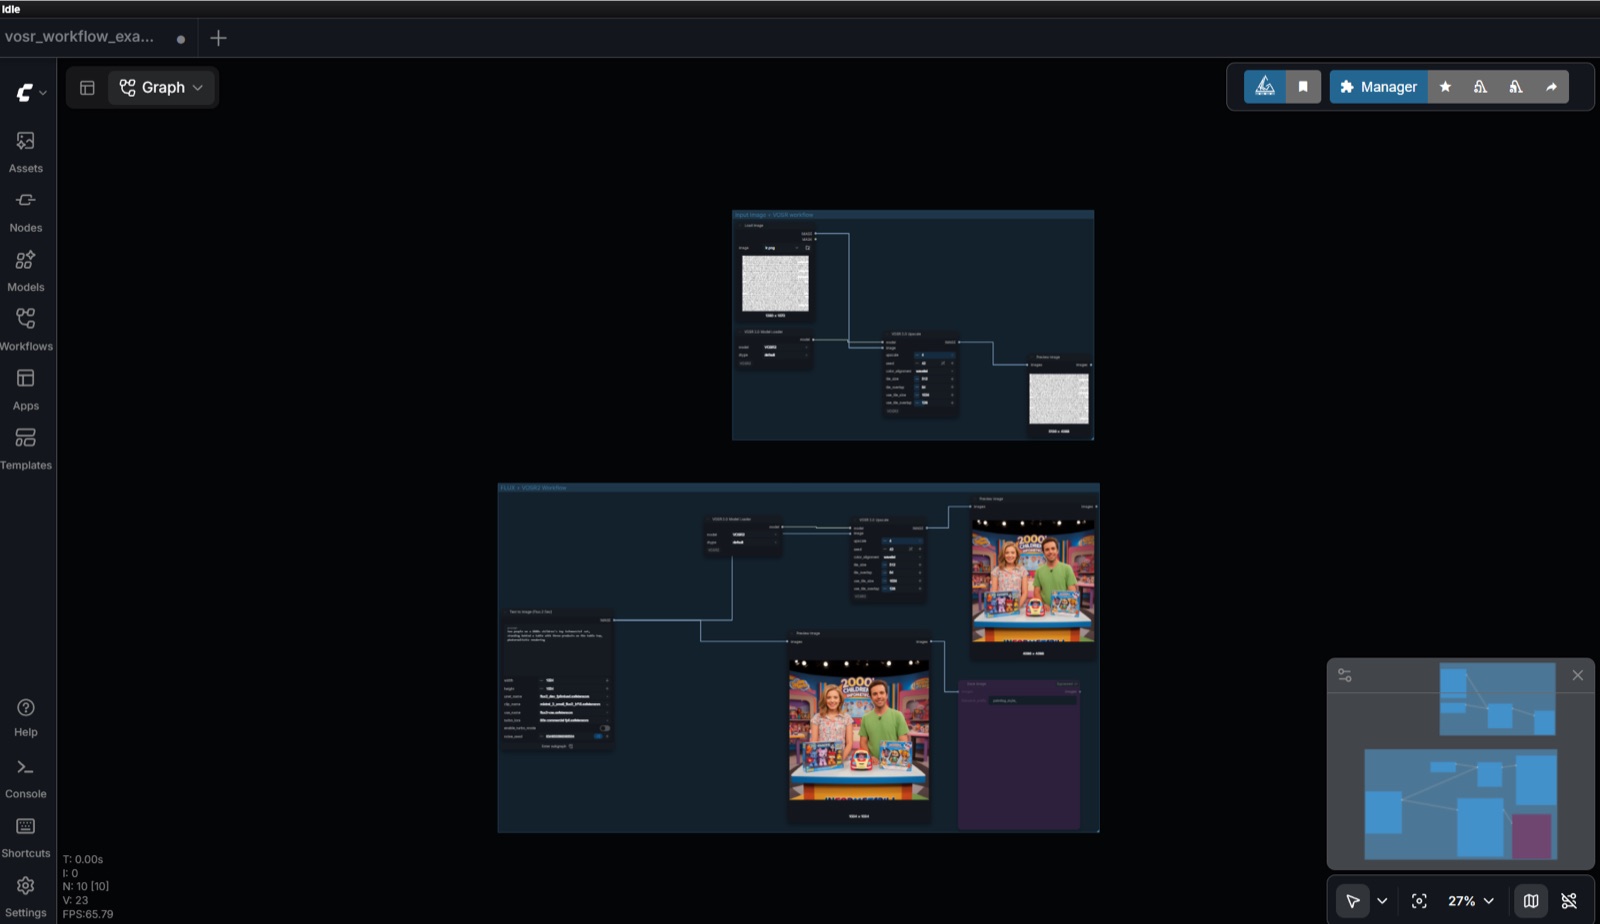
ワークフロー例: ローダーとアップスケールのペアを2組使い、読み込み済みバンドルを画像ごとの処理パスから切り離しています。
入手方法
ylchen333/ComfyUI-VOSR2 を ComfyUI/custom_nodes にクローンして再起動します。最新のPyTorchを備えたComfyUIが必要で、パッケージはそれを事前にチェックするため、古い環境ではノードリストから消えるのではなく、明確なエラーが1つ記録されます。
初回実行時、ローダーは不足している要素をピン留めされた CSWRY/VOSR リポジトリから models/vosr2/VOSR2/ バンドルにダウンロードし、以降はダウンロードをスキップします。そのリポジトリ内のDINOv2-Lファイルは生のPyTorch pickleです。ローダーは自動的にsafetensorsへ変換し、オフラインインストール向けの手動変換手順はREADMEに記載されています。
コメント
GitHubでサインインしてディスカッションに参加しましょう。