Anima-Light-Lavender: 長い自然言語プロンプト向けのAnimaポストトレイン
Anima-Light-LavenderはAnima-Base v1.0のポストトレインで、512トークンの自然言語キャプションを読み取り、BF16とMXFP8の重みを提供し、ComfyUIにそのまま導入できます。
Anima-Base v1.0はDanbooru形式のタグをネイティブ入力とします。Anima-Light-Lavenderは逆方向に進みます。長い自然言語のimage_descriptionフィールドを持つ構造化キャプションでトレーニングされており、このリリースは512トークン規模の説明の理解に焦点を当てています。トレーニングセットは約170万枚のDanbooru画像で、その注釈付けとフィルタリングは、アノテーション・フィルタリング・選好判定の各モデルを既製品ではなくすべて作者自身がトレーニングしたデータパイプラインによって行われています。
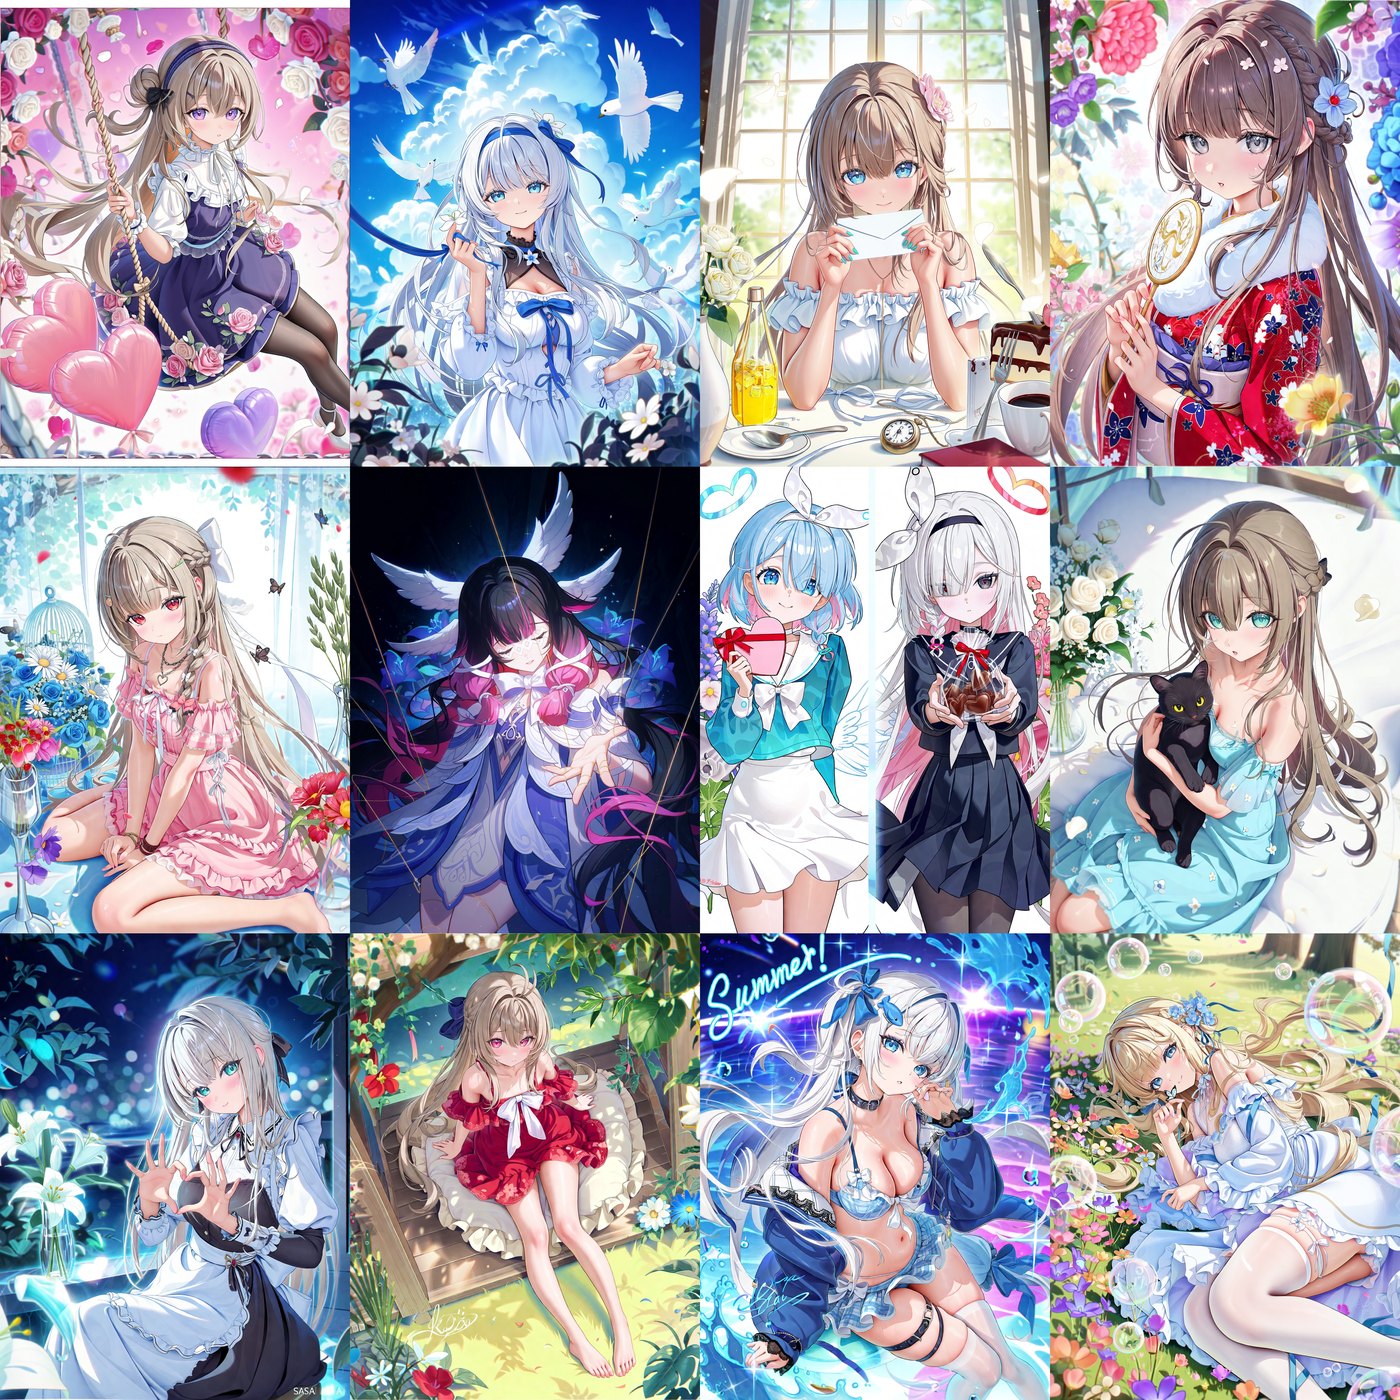
このモデルはアニメイラスト、キャラクター、スタイライズドアートを対象とし、タグの羅列ではなく説明的な文章によって駆動されます。
変更された点と、変更されていない点
| Anima-Light-Lavender | |
|---|---|
| ベースモデル | Anima-Base v1.0(anima-base-v1.0.safetensors) |
| アーキテクチャ | 変更なし: 約2Bパラメータ、28層DiT、レイヤー追加なし、蒸留なし |
| テキストエンコーダ | Qwen3-0.6B(qwen_3_06b_base.safetensors) |
| VAE | Qwen-Image VAE(qwen_image_vae.safetensors) |
| 重み | anima-light-lavender.safetensors(BF16)と anima-light-lavender_mxfp8.safetensors(MXFP8、推論が高速) |
| トレーニングの焦点 | 512トークン規模の自然言語による説明、およびより高品質なデータ |
レイヤー数、パラメータ数、ファイル構成がベースモデルと一致しているため、既存のAnimaワークフローはチェックポイントを差し替えるだけで済みます。
ComfyUIへのインストール
- 重みファイルを1つ
ComfyUI/models/diffusion_models/に配置します。BF16版かMXFP8版のどちらか一方を選び、両方は入れないでください。 - 現在のAnima環境のテキストエンコーダとVAEを再利用します。
qwen_3_06b_base.safetensorsをComfyUI/models/text_encoders/に、qwen_image_vae.safetensorsをComfyUI/models/vae/に置きます。 - コンパニオンノードをインストールします。
ComfyUI/custom_nodes/内でgit clone https://github.com/aa0525/comfyui-zako-pe.gitを実行し、ComfyUIを再起動します。
comfyui-zako-peパックは2つのノードを追加します。構造化キャプションを組み立てる Danbooru Caption JSON と、OpenAI互換サーバーを呼び出してタグ形式の image_description を自然言語に展開する Danbooru Prompt Extend (OpenAI) です。コンパニオンモデル zako-pe(ZAKO-V0.1)は、その展開をローカルで処理するために設計されています。
このリリースには2つのワークフローが含まれており、どちらもJSONをComfyUIのキャンバスにドラッグするだけで読み込めます:
どちらもデフォルトでMXFP8の重みを使用します。代わりにBF16ファイルをインストールした場合は、Load Diffusion Model(拡散モデルを読み込む)ノードでチェックポイントを切り替えてください。
構造化キャプションを使ったプロンプト作成
モデルは固定フィールドのキャプションでトレーニングされており、説明は文章として記述されます:
{
  "year": 2025,
  "preference_level": "best",
  "artist": [...],
  "copyright": [...],
  "character": [...],
  "image_description": "...",
  "extra_tags": [...]
}| フィールド | 目的 |
|---|---|
year | 年のアンカー、デフォルトは 2025 |
preference_level | normal、high、very_high、best(デフォルトは best) |
artist | アーティストとスタイルのタグ |
copyright | シリーズまたはフランチャイズのタグ |
character | キャラクターのタグ |
image_description | 画像の内容を、詳細な自然言語の文章として記述 |
extra_tags | 補足のコンテンツタグ |
長い文章を書くのが好みでない場合、基本ワークフローはタグを受け付け、プロンプト展開ノードにそれらを書き換えさせます。作者自身が挙げているもう一つの方法は、画像を説明して残りをモデルに任せるというものです。このリリースでは、品質ワードやネガティブプロンプトなしでも結果がクリーンに保たれることが報告されています。
推奨設定
| パラメータ | 値 |
|---|---|
| サンプラー | euler |
| スケジューラ | simple |
| ステップ数 | 25 |
| CFG | 4.0 |
| 解像度 | 約1280×1280 |
| ネガティブプロンプト | 空のまま |
トレーニングの詳細
トレーニングはBF16で実行され、MLPとアテンションの行列積にはMXFP8 GEMMを使用し、バッチサイズは1024、ピーク学習率は4e-5でした。MLPとアテンションの2DパラメータはMuon(momentum 0.95、match_rms_adamw)で更新され、残りのパラメータはAdamW(β 0.9 / 0.95、ε 1e-8)のままでした。キャプションのpreference_level階層は、約300万サンプルでトレーニングされた選好モデルに由来し、トレーニングデータは2025年11月末までのものを対象としています。
コメント
GitHubでサインインしてディスカッションに参加しましょう。