Fizgig v6 RefMods: MiniMax H3向けのトレーニング不要なキャラクター参照
Fizgig v6.0はMiniMax H3向けのRefModを作成できます。参照写真を1つの小さなファイルにまとめ、モデル自体に対してチューニングし、ComfyUIより前にRefMod Studioでプレビューできます。
Fizgig v6.0が昨日公開され、LoRAとファインチューニングのトレーナーに加えて新しい機能が登場しました: MiniMax H3向けRefModです。RefModは参照写真やクリップのフォルダーを1つの小さなファイルにまとめたもので、ComfyUI-MiniMaxH3ModノードがLoRAのように読み込み、H3の参照パスに渡します。トレーニング実行は不要、ファイルは数分で完成し、基本タイプならキャプションも要りません。
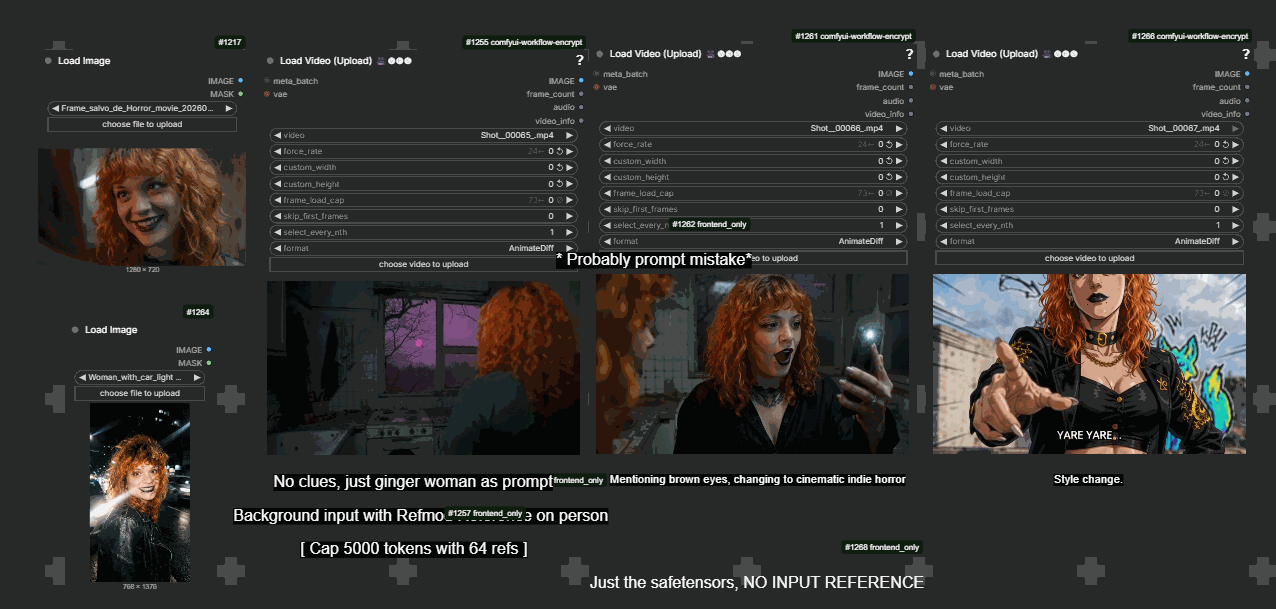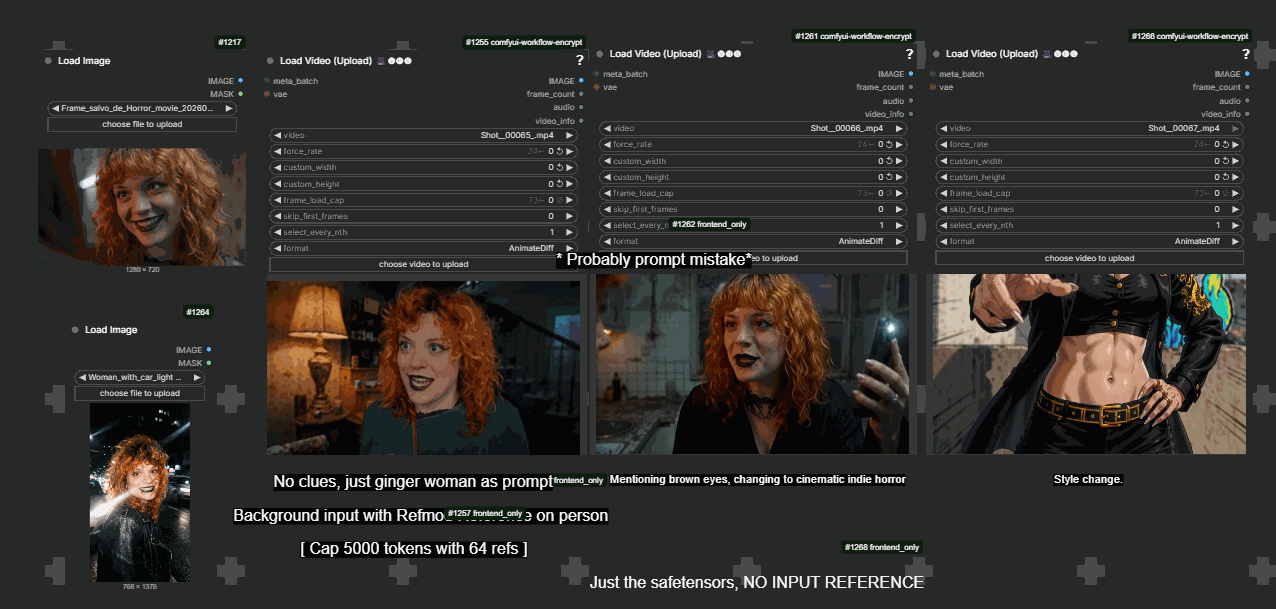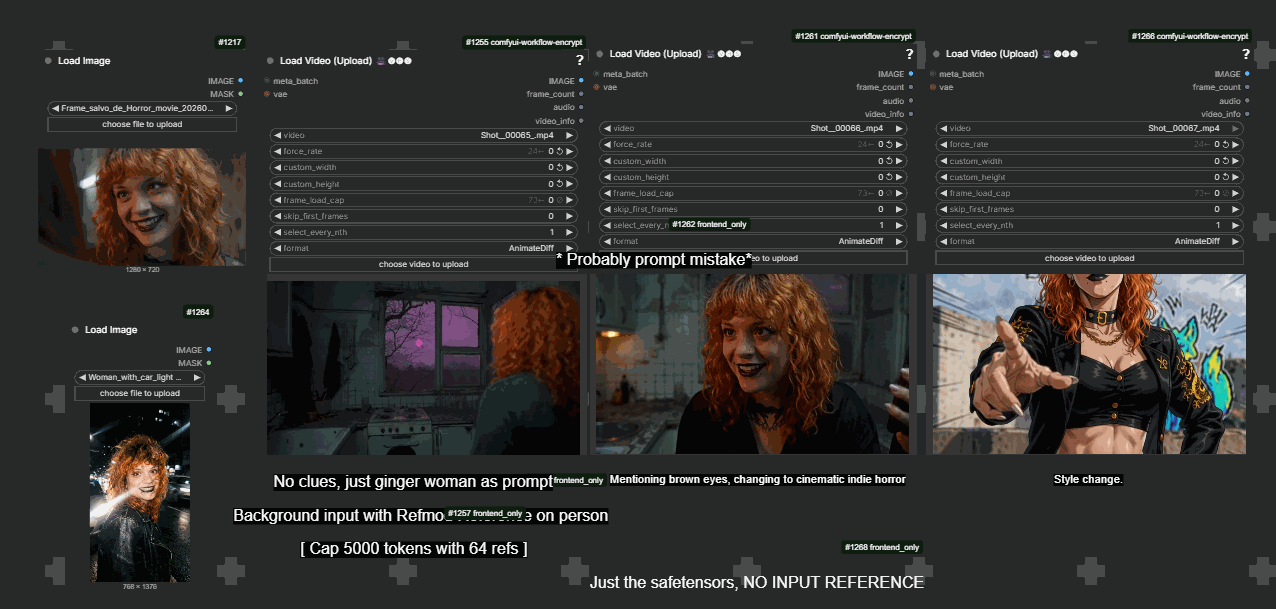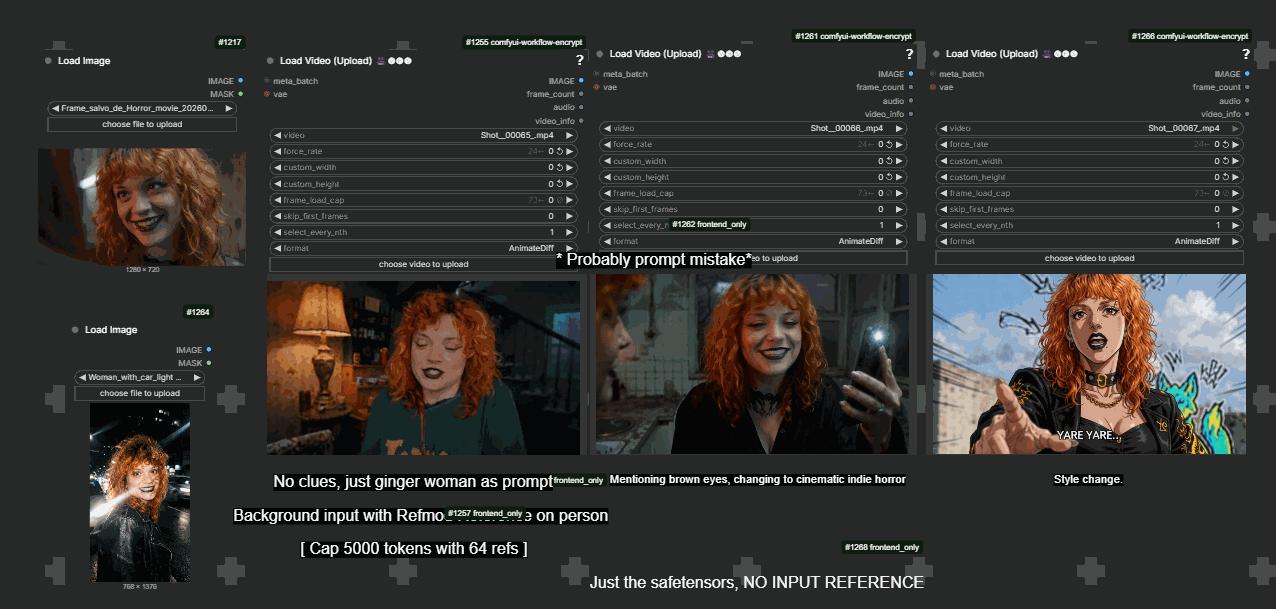
プロジェクトのサンプルギャラリーより、MiniMaxH3Modノード経由でComfyUI内で生成されたアイデンティティRefMod。
RefModとは
RefMod形式自体はコミュニティのノードパックComfyUI-MiniMaxH3Mod by @Luisacaotica(199スター)で生まれ、@malcolmreyによるmodライブラリとガイドがあります。参照画像や動画を小さな潜在トークンに圧縮し、H3の参照パスに沿って運ばれる仕組みです。毎回同じ写真を画像スロットに詰め込む代わりに、1つのファイルを読み込むだけです。Fizgig v6は、他のどの製作者も持っていなかったものを追加しました。写真を単純にエンコードするだけでなく、RefModをH3自体に対してチューニングできるのです。
Fizgig v6で追加されたもの
- 人物とスタイル向けの5つのプリセット: コミュニティレシピ(8枚の写真を1 MPで単純エンコード、ノードパック自体のエクストラクターが作るものと同一)、Fizgig recipe lite(16枚の写真を0.5 MPで、モデルに対してチューニング)、Fizgig recipe(同じ内容を1 MPで行い、よりシャープな結果に)、さらに人物ではなく見た目向けのスタイルプリセット。
- モデル・イン・ザ・ループのチューニング: チューニング済みプリセットは作成中にファイルをH3ベースに対して実行します。作者によれば、写真に写っていなかったショットでもより良い汎化と、よりクリーンでシャープな出力が得られます。
- RefMod Studioタブ: ComfyUIを開く前に、Fizgig内でmodとベースモデルをA/B比較できます。
- モーションおよび音声modとしてのクリップ: パックのギズモツールで準備した動画クリップはモーション参照になり、音声modはフォルダーのサウンドをビジュアルと一緒に運べます。
- ドロップイン互換: 出力フォルダーをComfyUIの
models/refmodsに一度指定すれば、すべてのmodが既存のMiniMaxH3Modノードで読み込まれます。ref2vaとfl2vaの両ワークフローで動作します。
RefModsとLoRAの比較
作者自身がリリーススレッドで述べた位置づけ: RefModは素早く小さく作れますが、LoRAほど概念について多くを知ることはできず、汎化も劣ります。トレードオフはスピードです。LoRAはトレーニング実行が必要ですが、RefModは数分で完成し、参照と似たショットでのキャラクター一貫性であれば品質差は小さくなります。最大限の類似性と汎化にはLoRAが依然として最強で、Fizgig v6は完全なH3とKrea 2のLoRAトレーナーを変更なく維持しています。
入手方法
Fizgig v6.0.1はGitHubにあります。ComfyUIではファイルを読み込むためにMiniMaxH3Modノードパックが必要で、作者のRefMods - 使い方は...?ガイドが写真からmodを読み込むまでの流れ全体を説明しています。
コメント
GitHubでサインインしてディスカッションに参加しましょう。