LoRA de 4 pasos para MOSS-Image con destilación eDMD
Un LoRA rank-64 para ComfyUI ejecuta MOSS-Image-SFT en 4 pasos con CFG 1 en lugar de 50 con CFG 3, con una textura fina medida por encima del profesor de 50 pasos.
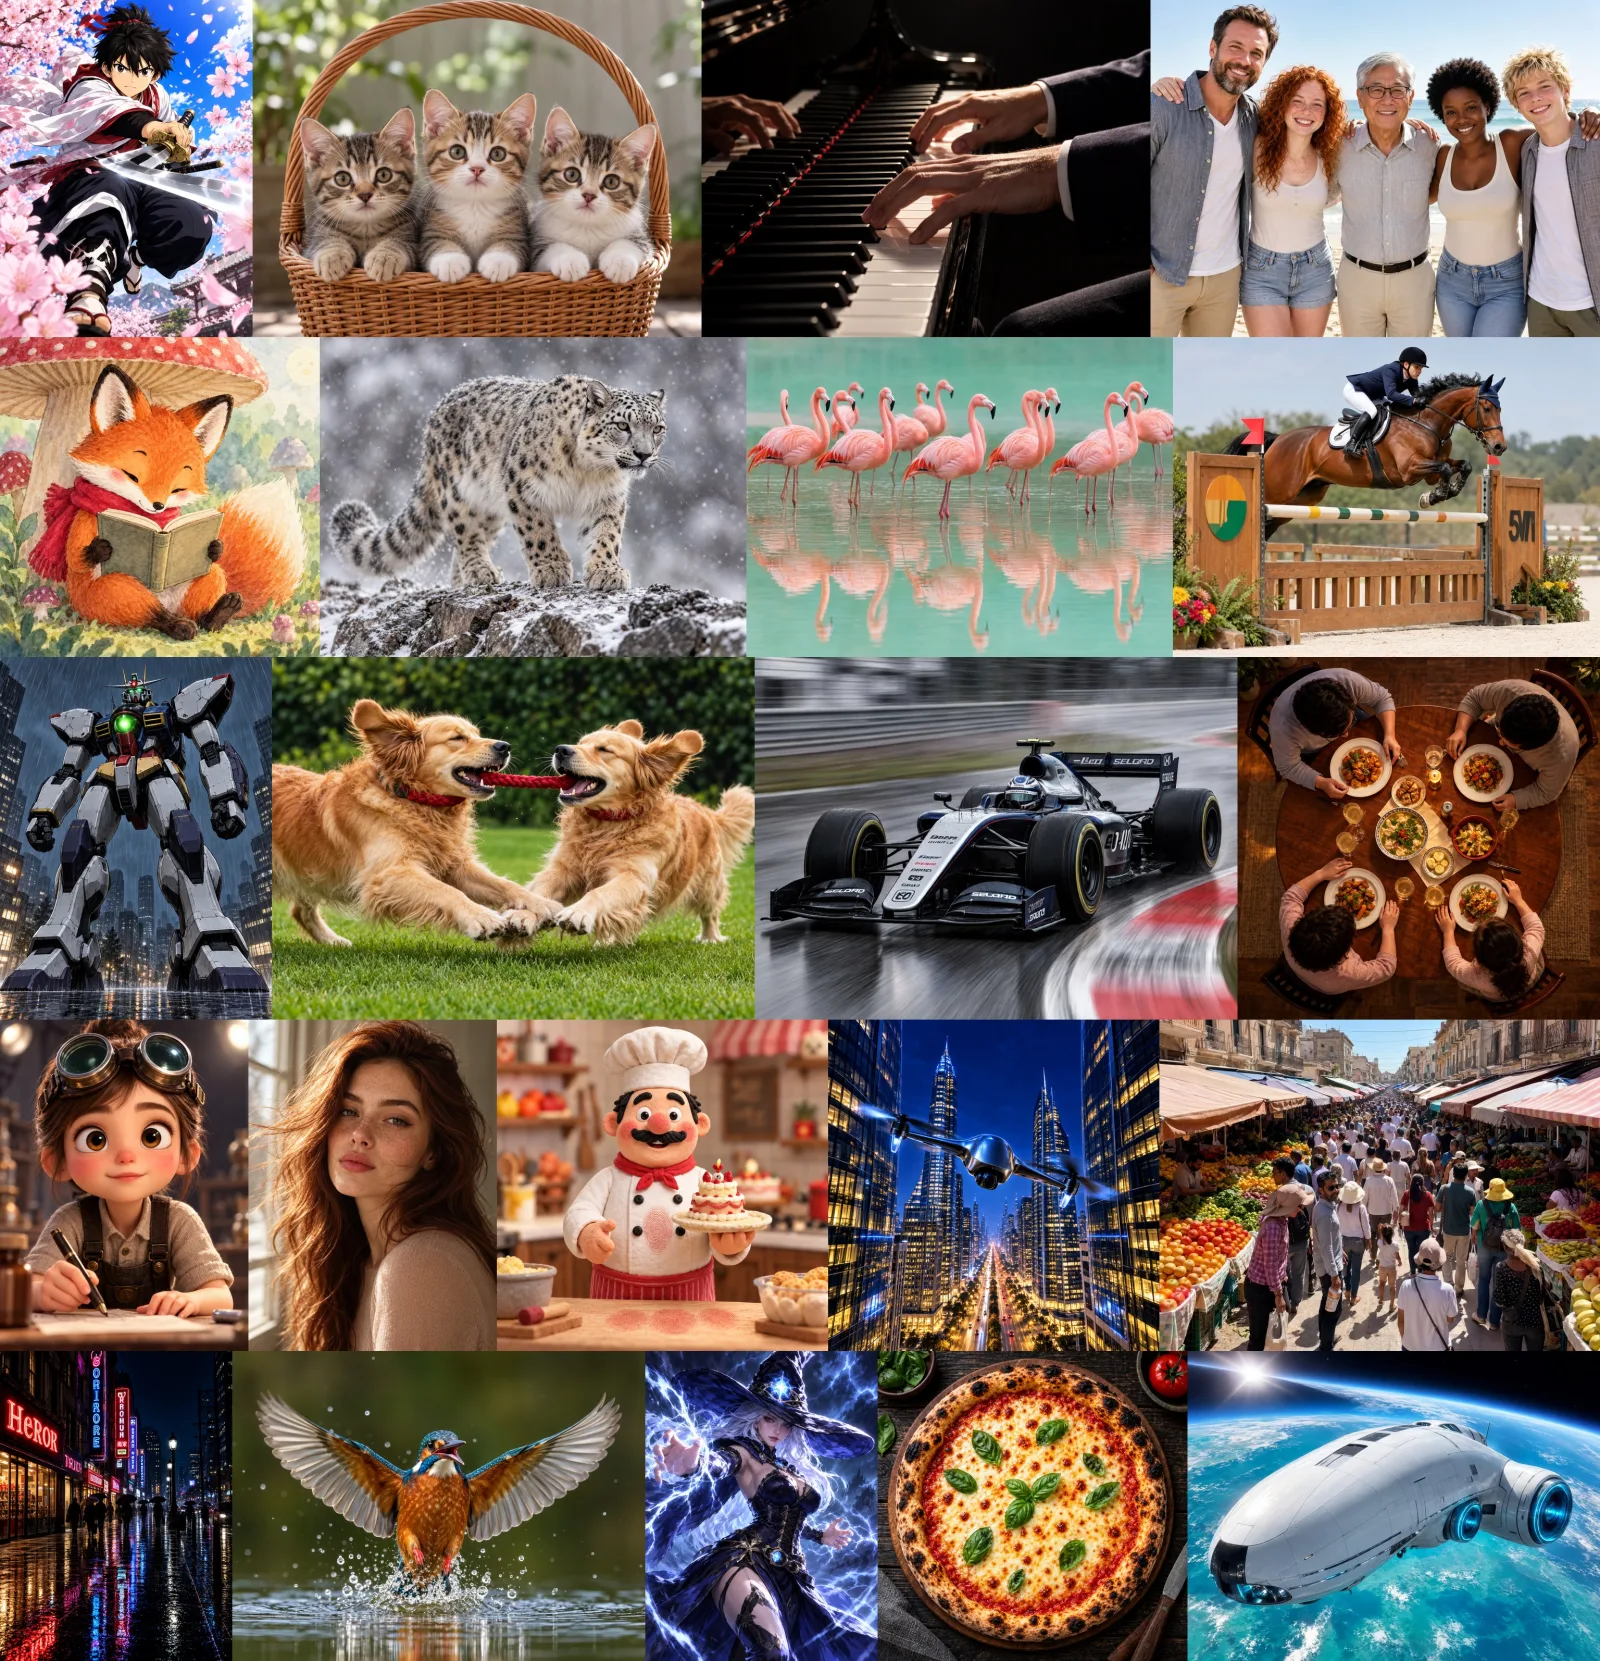
22 prompts de prueba renderizados por el LoRA en 4 pasos. Fuente: lvladikov
Qué cuestan y qué conservan los 4 pasos
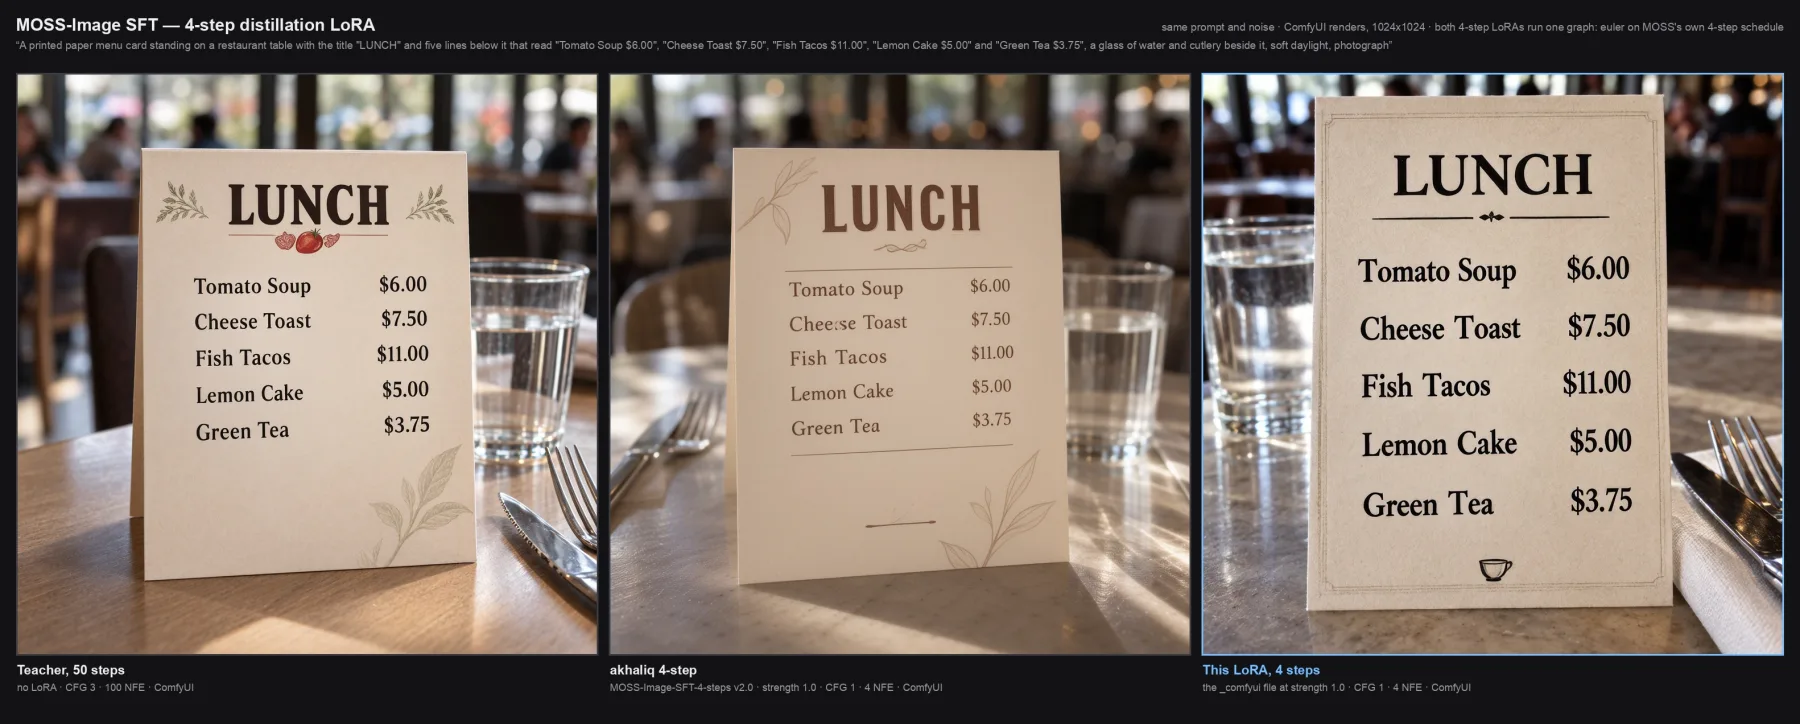
Según las mediciones del propio autor, 22 imágenes a 1024² tardan 26,6 s en lugar de 387,3 s (tiempo de GPU facturado en Comfy Cloud), y la textura fina promedia 1,22× la del profesor de 50 pasos, porque el entrenamiento mezcla imágenes del profesor con unas 8.000 fotografías recortadas y descritas. El renderizado de texto es la segunda afirmación: 14 de 15 prompts de texto salen con todas las cadenas solicitadas correctas, frente a 12 del LoRA de 4 pasos de akhaliq.
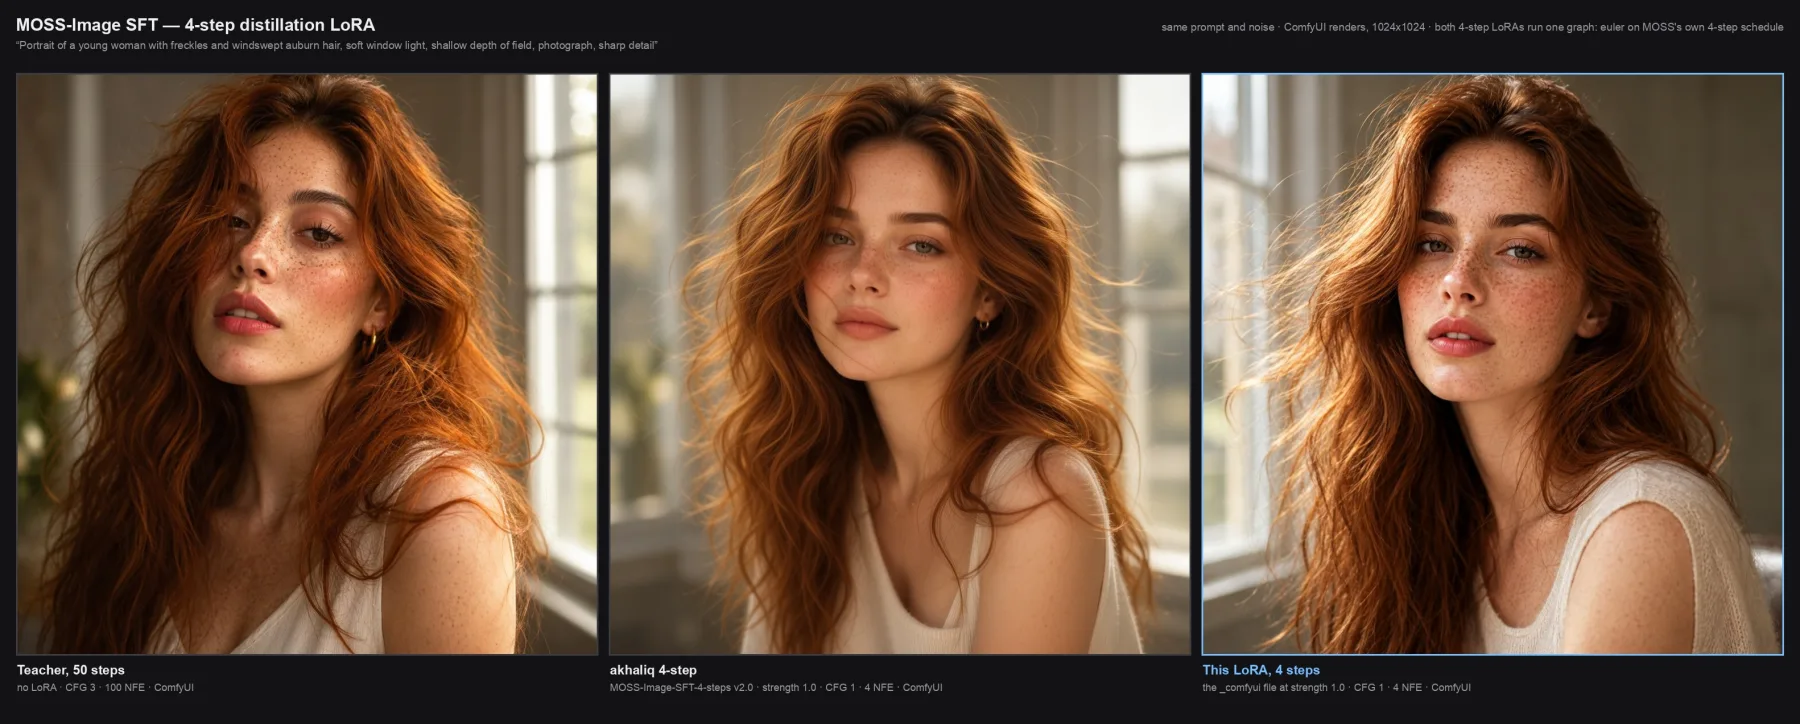
Estos son los números del autor. Existe una verificación independiente: un usuario comparó nueve LoRAs turbo de MOSS con la línea base de 50 pasos en textura de pintura clásica (craquelado, trama del lienzo, grano del papel) y eligió este como el más cercano a la línea base, por delante de los candidatos de 12 pasos.
 |
|---|
| Un prompt, un ruido inicial: profesor de 50 pasos · akhaliq 4 pasos · este LoRA. Fuente: lvladikov |
Dónde es más débil
El LoRA se entrena mediante coincidencia de distribuciones con un crítico de punto final (eDMD) más destilación adversaria latente (LADD), no copiando la salida del profesor. Los estilos pintados suaves y el detalle fotográfico denso quedan por debajo del profesor: la prueba de acuarela es 0,66× su textura fina, el retrato y una multitud de mercado, de 0,80 a 0,85.
Los primeros informes coinciden: el flujo de trabajo de edición en 4 pasos funciona y el prompting de layout se mantiene, pero los rostros fotorrealistas son más débiles, y un usuario observa extremidades faltantes de forma ocasional. Otro lo califica como "a la par de los LoRAs más recientes de lodestones" en lugar de una victoria clara.
 |
|---|
| Un menú con cinco líneas impresas y precios: profesor · akhaliq 4 pasos · este LoRA. Fuente: lvladikov |
Ejecútalo en ComfyUI
Usa el archivo _comfyui, no el simple: ComfyUI suma el LoRA a los pesos bf16 y redondea el resultado, por lo que el archivo ComfyUI distribuido lleva un factor medido de 1,18 en sus valores alfa. Cárgalo con fuerza 1.0, 4 pasos, CFG 1, y no añadas la omisión de capas ni las configuraciones de prompt negativo del profesor de 50 pasos.
| Archivo | Carpeta |
|---|---|
moss_sft_4step_rank_64_lora_comfyui.safetensors | ComfyUI/models/loras/ |
moss_image_sft_bf16.safetensors | ComfyUI/models/diffusion_models/ |
qwen3.5_9b_w4a8_gptq.safetensors | ComfyUI/models/text_encoders/ |
flux2-vae_small.safetensors | ComfyUI/models/vae/ |
Los tres archivos base provienen de Comfy-Org/MOSS-Image. El LoRA se entrenó con 12 resoluciones, desde 768×512 y 512×768 hasta 1824×1024 y 1024×1824, por lo que otras relaciones de aspecto quedan fuera de su conjunto de entrenamiento.
Disponibilidad
- LoRA y ocho flujos de trabajo: lvladikov/MOSS-SFT-Distill-4step-LoRA. Texto a imagen, layout a imagen, edición de imagen y upscale PiD 4×, cada uno para ComfyUI local y Comfy Cloud.
- Modelo base: OpenMOSS-Team/MOSS-Image-SFT, reempaquetado para ComfyUI en Comfy-Org/MOSS-Image.
- Opciones anteriores de 4 pasos: akhaliq/MOSS-Image-SFT-4-steps, tratadas junto con los adaptadores basados en DMAD en LoRAs de pocos pasos para MOSS-Image.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.