Direct3D-V3: refinamiento de malla voxel sin latente en ComfyUI
Direct3D-V3 refina una malla 3D tosca con difusión voxel sin latente en lugar de un VAE, y un paquete de nodos de la comunidad para ComfyUI ya lo ejecuta en GPUs Windows.
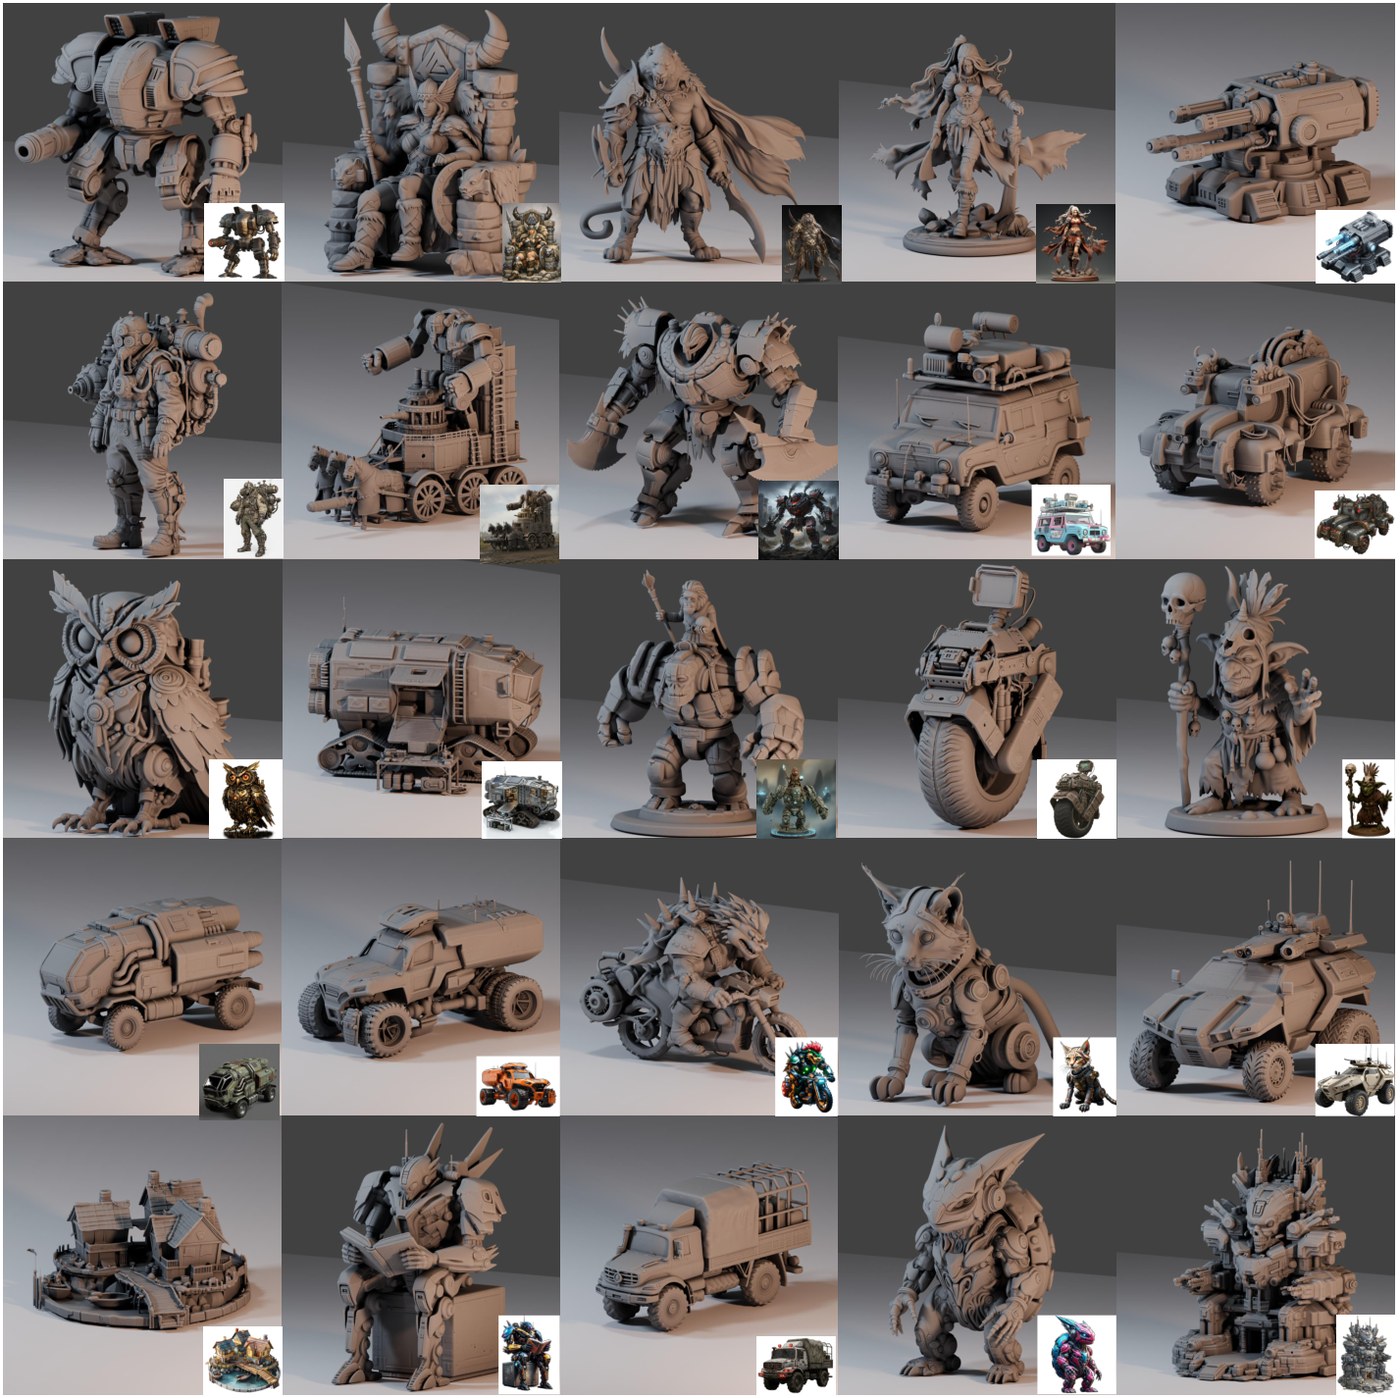
Mallas generadas y detalle de superficie, de los resultados adicionales del artículo.
Qué hace
Introdúcele una malla tosca en la misma orientación que tu imagen de referencia, y refina la forma: ranuras, biseles, estructuras finas y aristas marcadas que la etapa tosca había suavizado. La regularización implícita de variedad mantiene las superficies cerradas. La malla se simplifica a 2M de triángulos por defecto (target_faces) y se exporta como GLB.
El argumento del artículo es que todo stack de imagen a 3D construido sobre difusión latente descarta geometría fina dos veces: una cuando el VAE comprime la forma, y otra porque el VAE se entrena para reconstrucción mientras que el generador se entrena para coincidencia de distribuciones. Direct3D-V3 prescinde del VAE y modela directamente cuadrículas de vóxeles SDF en bruto con un transformer de difusión, añadiendo regularización de variedad sobre vóxeles vecinos más una tarea auxiliar de predicción de cámara para que la imagen de acondicionamiento se alinee con la geometría generada.
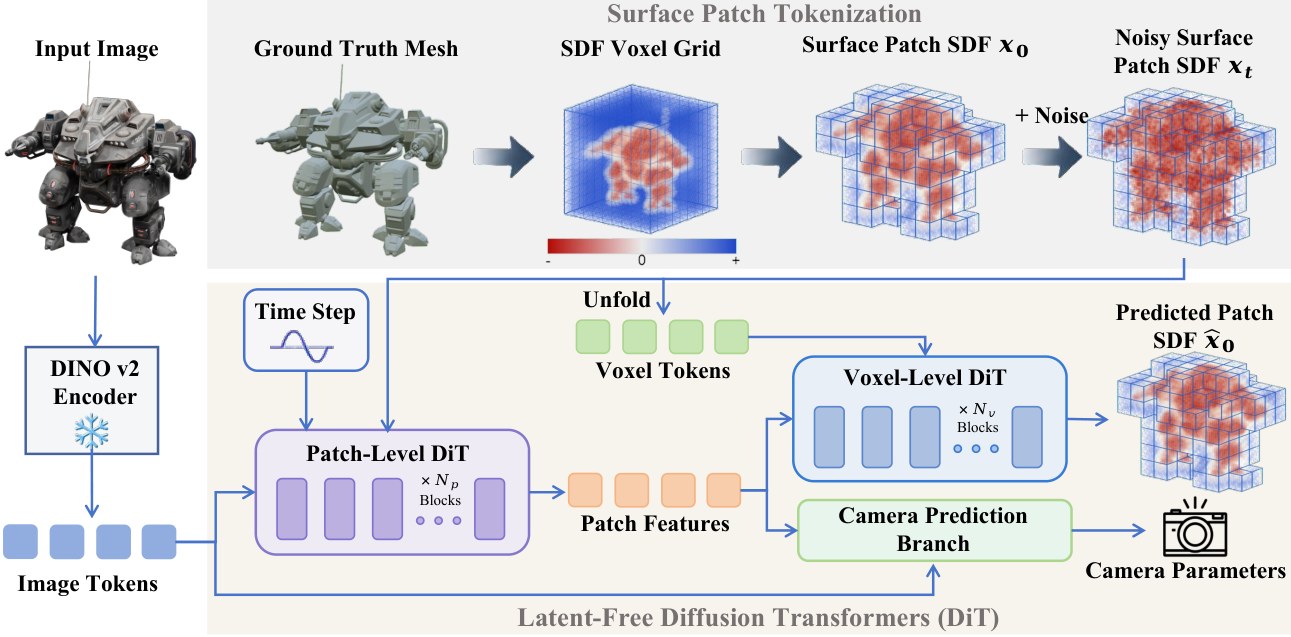
El entrenamiento y el muestreo ocurren sobre la propia cuadrícula de vóxeles; las mallas salen mediante Marching Cubes.
Se incluyen tres checkpoints: 512, 1024 y 1536. Pueden ejecutarse en cascada o en una sola etapa, y los valores de referencia para empezar son 15 pasos y CFG 4 en 512 y 1024.
Ejecútalo en ComfyUI
- Descarga una de las compilaciones para Windows de Direct3D-V3_Comfyui_Nodes (cu128 para Python 3.12 y PyTorch 2.8, cu130 para Python 3.13 y PyTorch 2.12.1) y extrae la carpeta en
ComfyUI/custom_nodes. - Solicita acceso a DINOv3 ViT-H+ en Hugging Face. El nodo lo usa como codificador de imagen, y la instalación pide un token de lectura.
- Ejecuta
setup.cmden la carpeta del nodo. Crea un entorno Python privado.runtime, descarga PyTorch, DINOv3 y el checkpoint 1536. Es de esperar reservar varios GB de disco. - Añade Direct3D-V3 Clean | Mesh File Path y Refine (Mesh File, Low VRAM), conecta la ruta de la malla, la imagen de referencia y una máscara de primer plano, y luego empieza con
resolution = 1536ystage_mode = single_stage.
Ambas compilaciones de nodos son autocontenidas: sin CUDA Toolkit ni Visual Studio, voxelizadores precompilados para las series RTX 20 a 50, y ComfyUI mantiene su propio Python y PyTorch. La atención usa efficient por defecto; cudnn_fp16 es más rápido en FP16 pero cambia el redondeo, así que fija la semilla al comparar exportaciones.
Lo que ven los probadores
- MostAadTech, que creó el paquete de nodos, ejecutó la etapa 1536 con 114.832 parches de vóxeles a 6.008 MiB de VRAM reservada máxima y finalizó un dragón completo en 9 min 56 s con el preset cuDNN, con cero reducción.
- Una segunda ejecución reportó 4,15M de vértices / 8,3M de triángulos con el prompt completándose en 325 s.
- Kijai midió aproximadamente 4,9 GB de pico de activaciones a unos 100k tokens, de los cuales unos 2 GB son tokens skip que permanecen residentes.
- El pipeline completo realista es más largo que el refinador por sí solo: malla tosca de Pixal3D o TRELLIS.2, un mapa de normales de Qwen-Image-2.1, después Direct3D-V3 y luego texturizado con UltraTex.
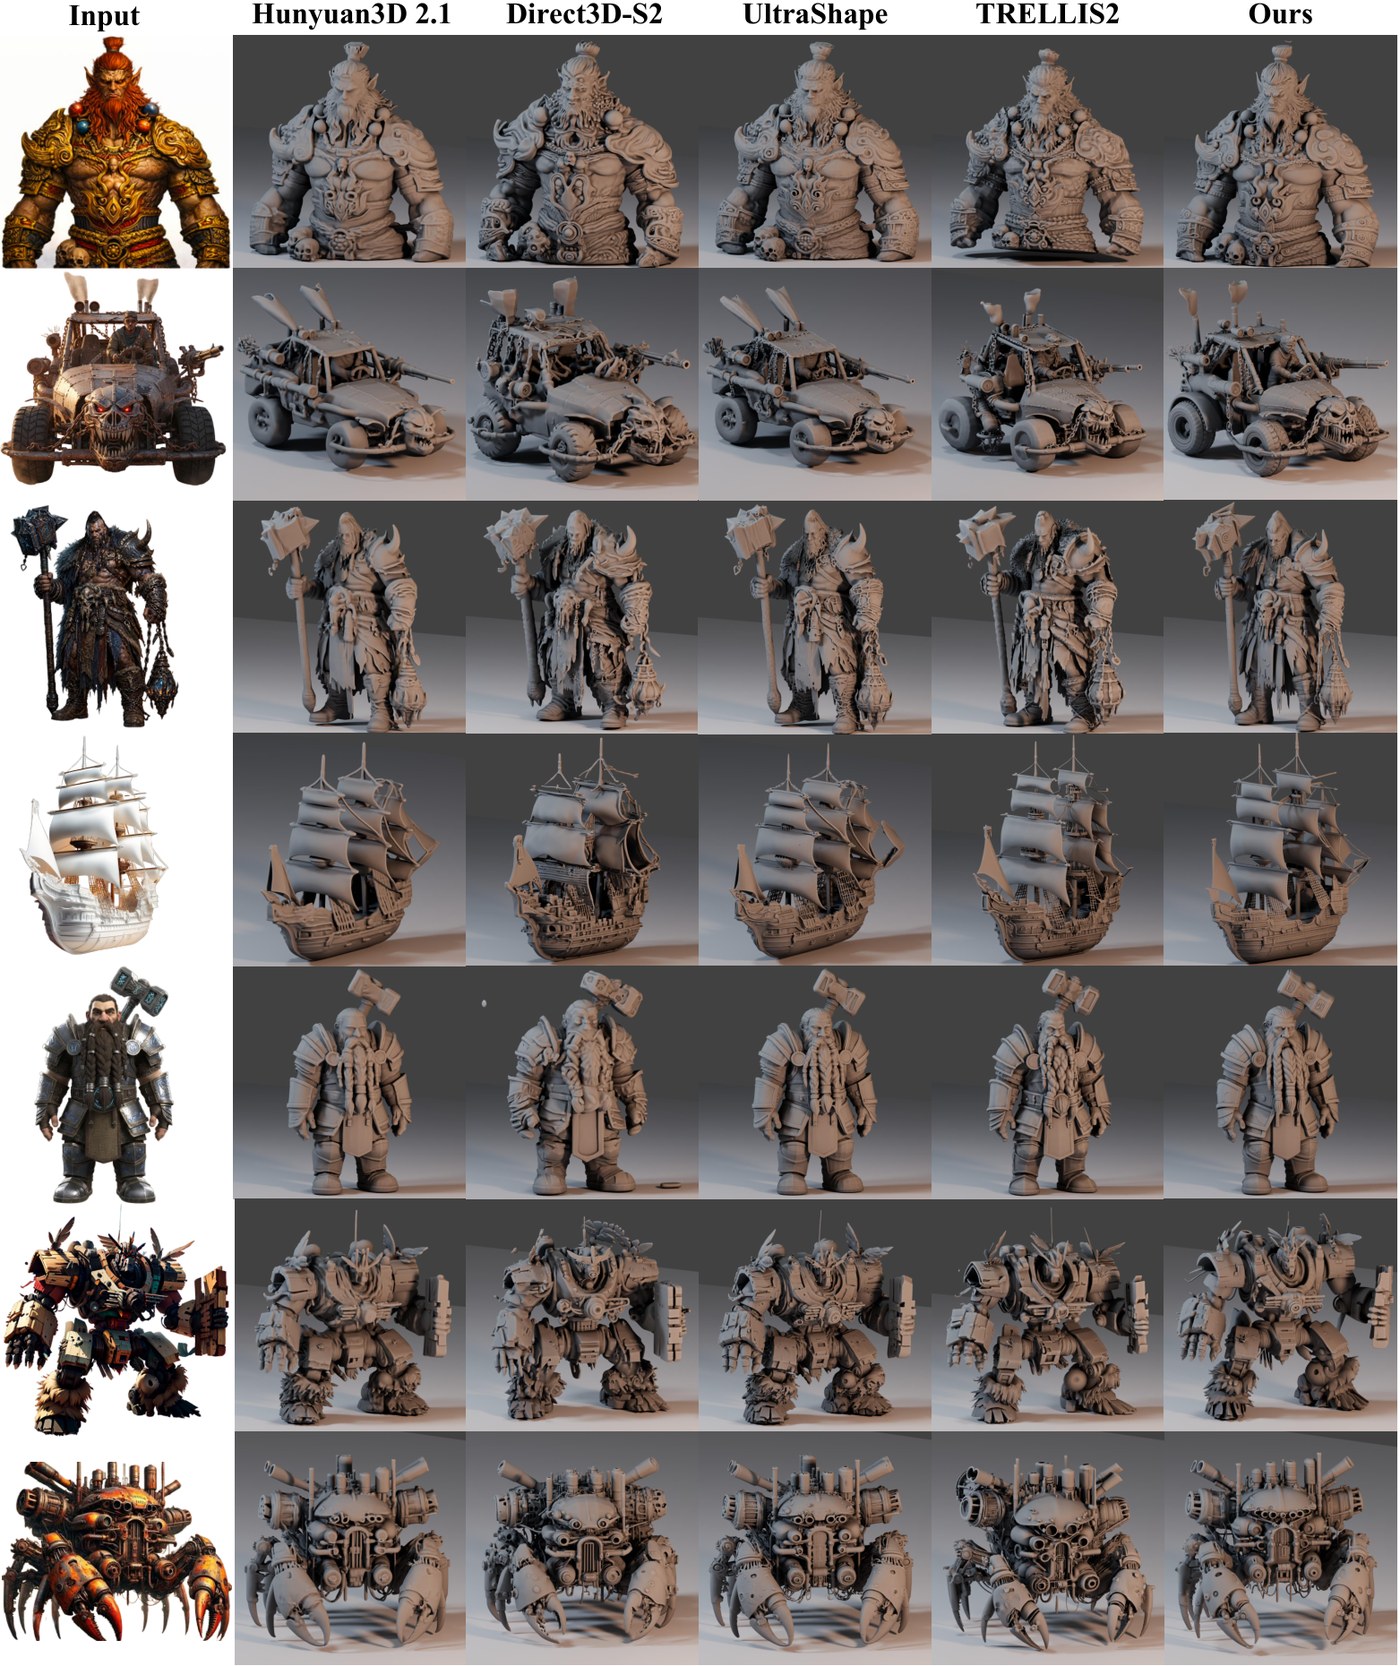
Comparación cualitativa con otros métodos de imagen a 3D de código abierto, del artículo.
Antes de empezar
- No hay etapa tosca en esta publicación. Los autores remiten a Hunyuan3D-2.1 o UltraShape-1.0 para la malla inicial; sus propios modelos toscos siguen en la lista de pendientes.
- La imagen de referencia importa más de lo habitual. Un mapa de normales de superficie o un render en arcilla blanca da un detalle notablemente más fino que una imagen RGB texturizada. El repositorio sugiere ChatGPT (GPT Image 2.5) o Lotus-2 para esa conversión, y Qwen-Image-2.1 funciona como opción sin coste.
- Los pesos publicados son más nuevos que el artículo. Los autores afirman que los checkpoints publicados usan cuatro capas de DINOv3, el optimizador Muon y producen superficies más finas que el modelo evaluado en el artículo, por lo que las cifras del artículo subestiman la salida actual.
- El código de texturizado y de entrenamiento aún no está disponible. Solo el refinamiento de malla está en esta publicación, así que la textura viene de un modelo aparte.
Consíguelo
- Pesos: wushuang98/Direct3D-V3 (checkpoints de etapa 512, 1024 y 1536)
- Código oficial, demo de Gradio y ejemplos de inferencia: DreamTechAI/Direct3D-V3
- Artículo: SIGGRAPH Asia 2026, arXiv 2611.26511 con resultados en la página del proyecto
- Adaptador de ComfyUI (Windows): Mstafa-awad/Direct3D-V3_Comfyui_Nodes
Comentarios
Inicia sesión con GitHub para unirte a la conversación.