ComfyUI añade el nodo Video Deflicker para upscales por fotograma
El núcleo de ComfyUI ya incluye el nodo Video Deflicker de Kijai: elimina el parpadeo del vídeo procesado fotograma a fotograma con un flujo RAFT nativo 2,3 veces más rápido.
El núcleo de ComfyUI incorporó un nodo Video Deflicker: le pasas fotogramas que parpadean tras un procesamiento fotograma a fotograma, como un upscale frame by frame, y empuja cada fotograma hacia sus vecinos sin perder su propio detalle. Llegó mediante la PR #17754 de Kijai, fusionada el 15 de noviembre. El único archivo adicional que necesitas es el checkpoint RAFT-large de torchvision en ComfyUI/models/optical_flow/.
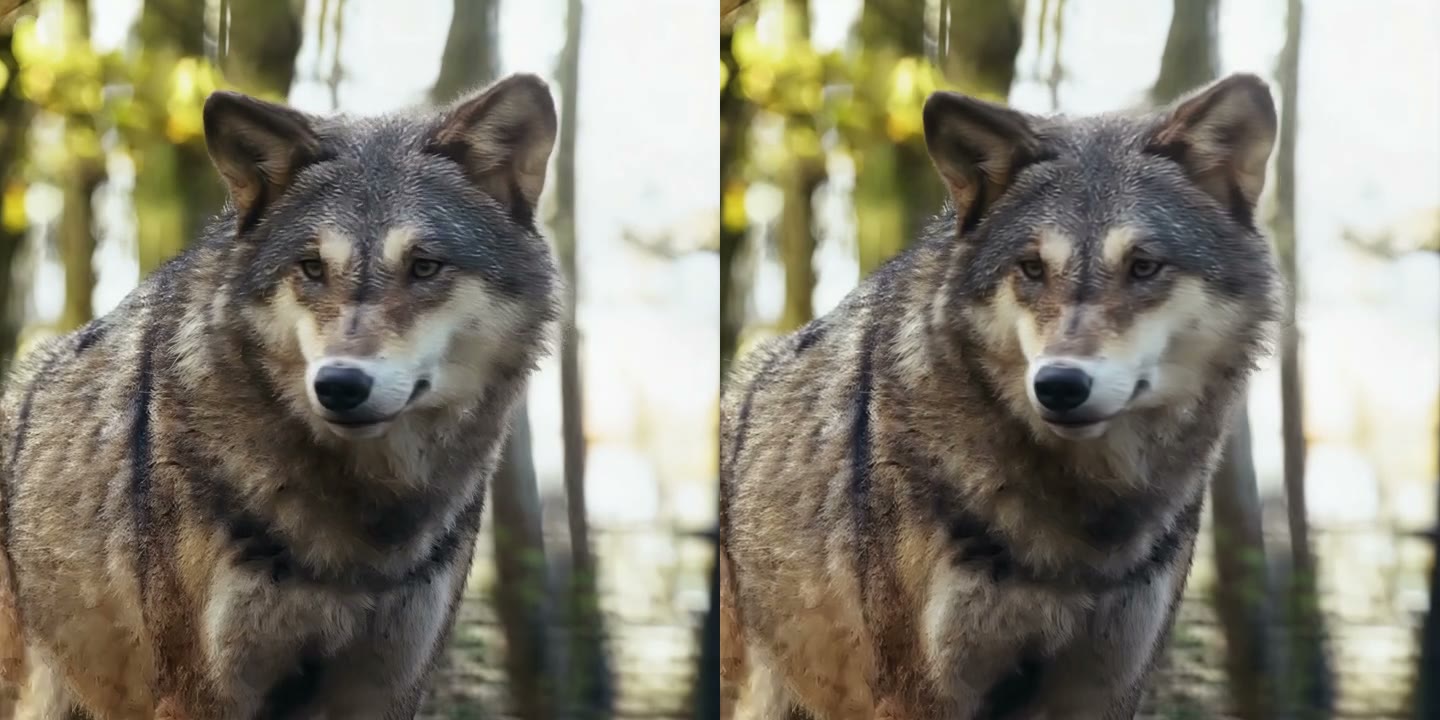
Izquierda: un clip procesado fotograma a fotograma. Derecha: el mismo clip después de Video Deflicker. Fuente: Comfy-Org/ComfyUI #17754
Ambos clips uno al lado del otro, 53 fotogramas cada uno, recodificados a 720 px por panel.
Qué corrige
- Upscales y ediciones fotograma a fotograma, donde cada fotograma se procesa por separado y las pequeñas diferencias entre ellos se perciben como parpadeo.
- Pasar la fuente limpia como
guidees lo que hace que funcione bien: el nodo lee el movimiento de esos fotogramas estables en lugar de los que parpadean. Sin una guía, usa los fotogramas de entrada y elimina menos. - Los cambios reales se conservan.
thresholdmarca como genuinas las diferencias respecto al vecino compensado en movimiento, de modo que un corte o un gesto rápido no se difuminan.
Cómo ejecutarlo
- Descarga
raft_large.pth(torchvision RAFT-large, 21 MB) desde download.pytorch.org enComfyUI/models/optical_flow/. ComfyUI nunca descarga los pesos de flujo óptico por sí solo. - Añade Cargar modelo de flujo óptico, selecciona
raft_large.pth. - Añade Video Deflicker (categoría
video) y conecta el modelo de flujo, los fotogramas con parpadeo y los fotogramas de la fuente limpia aguide.
| Entrada | Valor predeterminado | Qué hace |
|---|---|---|
optical_flow | requerido | RAFT-large de Cargar modelo de flujo óptico |
images | requerido | los fotogramas con parpadeo |
guide | images | fotogramas estables de los que leer el movimiento, a cualquier resolución |
strength | 1.0 | con qué fuerza sigue cada fotograma a sus vecinos; un valor más alto suaviza más el detalle fino |
direction | bidireccional | promedia un paso hacia delante y uno hacia atrás; forward tarda la mitad del tiempo |
threshold | 0.1 | los cambios por encima de este valor se mantienen nítidos; 0 suaviza todos los cambios por igual |
El flujo se calcula internamente como máximo a 768x768, así que una guía 4K se reduce para la estimación de movimiento y solo el cálculo final se ejecuta a resolución completa.
RAFT más rápido en el núcleo
La misma PR reemplazó raft_large de torchvision por una implementación nativa: redes en fp16 con correlación en fp32, y el bucle de actualización se ejecuta como un grafo CUDA bajo VRAM dinámica. Es aproximadamente 2.3 veces más rápido que la versión de torchvision a 1024x576. Los nodos VOID warped-noise ahora también lo usan.
Disponibilidad
El nodo está en la rama principal desde la fusión del 15 de noviembre. La última versión etiquetada, v0.45.0 (10 de noviembre), es anterior, así que usa una compilación nocturna hasta la próxima versión.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.