LongCat Video Avatar 1.6 mantiene el avatar hablando más de 10 minutos
LongCat Video Avatar 1.6 de Meituan convierte una foto y audio en vídeo de avatar con sincronización labial de más de diez minutos, con ruta de 8 pasos y pesos INT8.
Fotogramas de los clips de vista previa de 1.6: un retrato más una pista de audio.
Qué cambió en 1.6
| Área | 1.6 |
|---|---|
| Movimiento de labios y boca | menos formas de boca tensas o demasiado rojas, menos parpadeo en la zona de la boca |
| Clips largos | se reduce la acumulación de error autoregresivo, por lo que los vídeos pueden superar los 10 minutos manteniendo la identidad y la estructura corporal |
| Velocidad | optimizaciones de la pipeline de extremo a extremo y de la ejecución por fotograma, sin un modelo nuevo que aprender |
| Despliegue | DiT INT8 opcional de solo pesos, más un flag FP8 para Transformer Engine |
1.6 se ejecuta sobre la misma arquitectura base que 1.5 y conserva la pila de dos adaptadores: un LoRA DMD para las primeras pasadas y un LoRA OPSD para el resto, mezclados paso a paso. Con la configuración predeterminada de 8 pasos, los cuatro primeros usan solo DMD y los cuatro últimos solo OPSD; sube --mix_steps o --mix_alpha para dar más influencia a DMD al principio.
Míralo en acción
Una prueba de continuación de la model card, donde el clip sigue avanzando en lugar de degradarse.
Más allá del habla: el modelo también genera canto y actuación solo a partir del audio.
Cómo se compara
Meituan realizó una arena con 33.051 votos humanos por pares sobre 15 emparejamientos de modelos. 1.6 termina segundo por detrás de OmniHuman-2.0, y su margen sobre 1.5 es pequeño: 16 Elo.
| Puesto | Modelo | Elo de la arena |
|---|---|---|
| 1 | OmniHuman-2.0 (cerrado) | 1236.7 |
| 2 | LongCat-Video-Avatar 1.6 (abierto) | 1068.1 |
| 3 | LongCat-Video-Avatar 1.5 (abierto) | 1051.8 |
| 4 | HeyGen (cerrado) | 906.4 |
| 5 | OmniHuman-1.5 (cerrado) | 880.6 |
| 6 | Kling Avatar 2.0 (cerrado) | 854.7 |
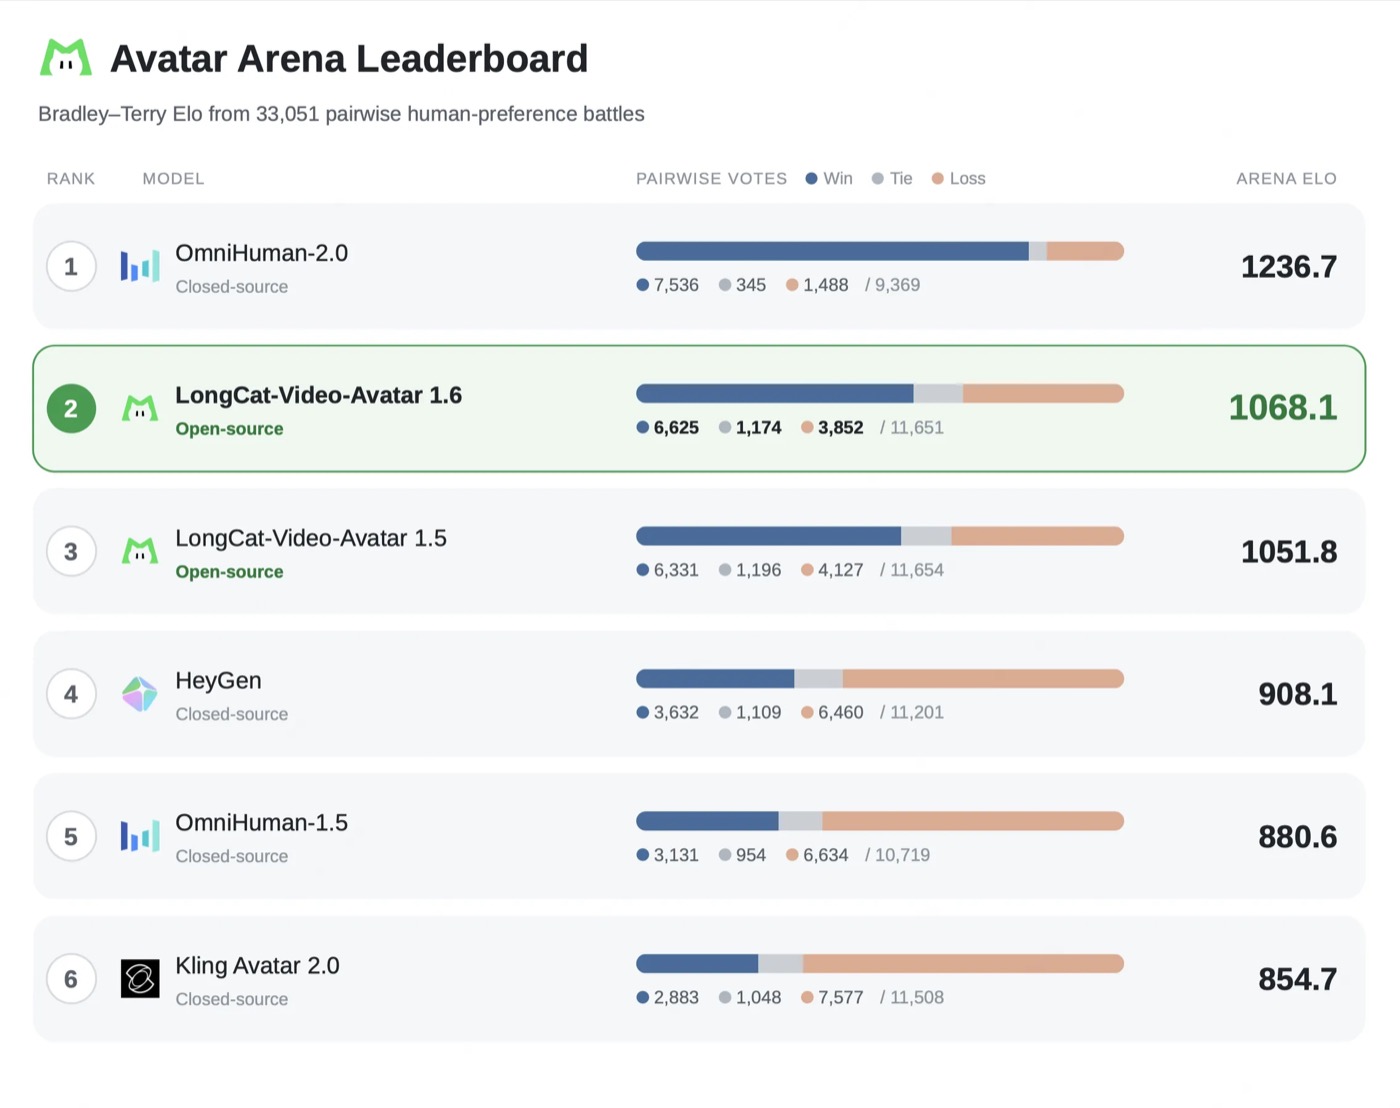
La tabla de clasificación tal como se publicó en la model card de 1.6.
Misma entrada, tres sistemas, un fotograma cada uno:
| LongCat-Video-Avatar 1.6 | OmniHuman-2.0 | HeyGen |
|---|---|---|
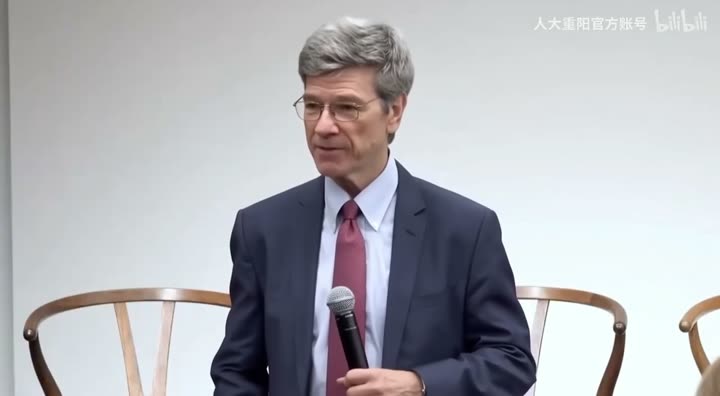 | 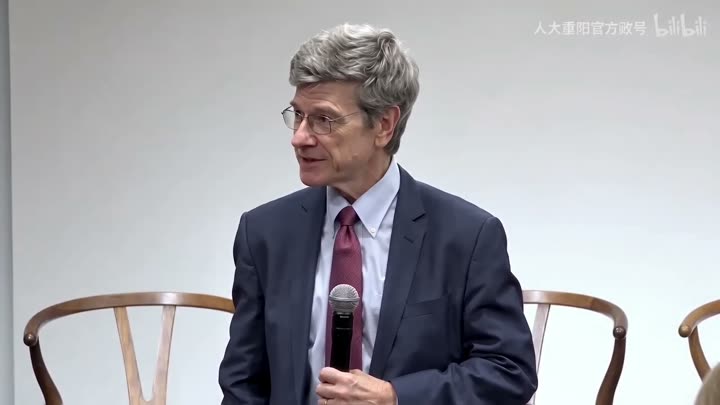 |  |
Lo que hace falta para ejecutarlo
- El DiT en BF16 ocupa unos 30 GB repartidos en seis fragmentos; el DiT INT8 opcional lo reduce a unos 15 GB.
- Los dos LoRA pesan 2,35 GB cada uno, y el repositorio incluye su codificador de audio Whisper-large-v3 y un separador vocal.
- Los comandos de demostración oficiales usan
torchrunsobre dos GPU con paralelismo de contexto. Con más de dos GPU se obtiene un espacio de trabajo All-to-All medianteLONGCAT_A2A_WORKSPACE=1. - No combines
--use_int8con--use_fp8. FP8 necesita Transformer Engine, y--compile_ditpaga un coste de trazado en la primera ejecución de cada forma de entrada.
Estado en ComfyUI
El soporte en ComfyUI sigue deteniéndose en 1.5. El paquete de la comunidad ComfyUI-LongCat-Avatar (★43) no se ha actualizado para el nuevo checkpoint, así que todavía no hay una ruta de nodos para 1.6. Hasta que aparezca una, 1.6 se ejecuta mediante la pipeline oficial de Python.
Disponibilidad
- Pesos: meituan-longcat/LongCat-Video-Avatar-1.6
- Página del proyecto con vídeos comparativos completos: LongCat-Video-Avatar 1.6
- Código de inferencia y Technical Report: meituan-longcat/LongCat-Video
Comentarios
Inicia sesión con GitHub para unirte a la conversación.