ComfyUI v0.45.0 duplica la velocidad de generación de texto de Qwen3.x
ComfyUI v0.45.0 reescribe la generación de texto de Qwen3.x: Qwen3.5 9B en una RTX 5090 pasa de 106 a 219 tokens por segundo, con MTP de árbol adaptativo y atención INT8.
La mejora de prompts, el subtitulado de imágenes y la escritura de historias en ComfyUI son todas generación de texto, así que obtienen la aceleración gratis. Lo único que hay que configurar es la opción mtp del nodo Generate Text, que permanece en auto por defecto.
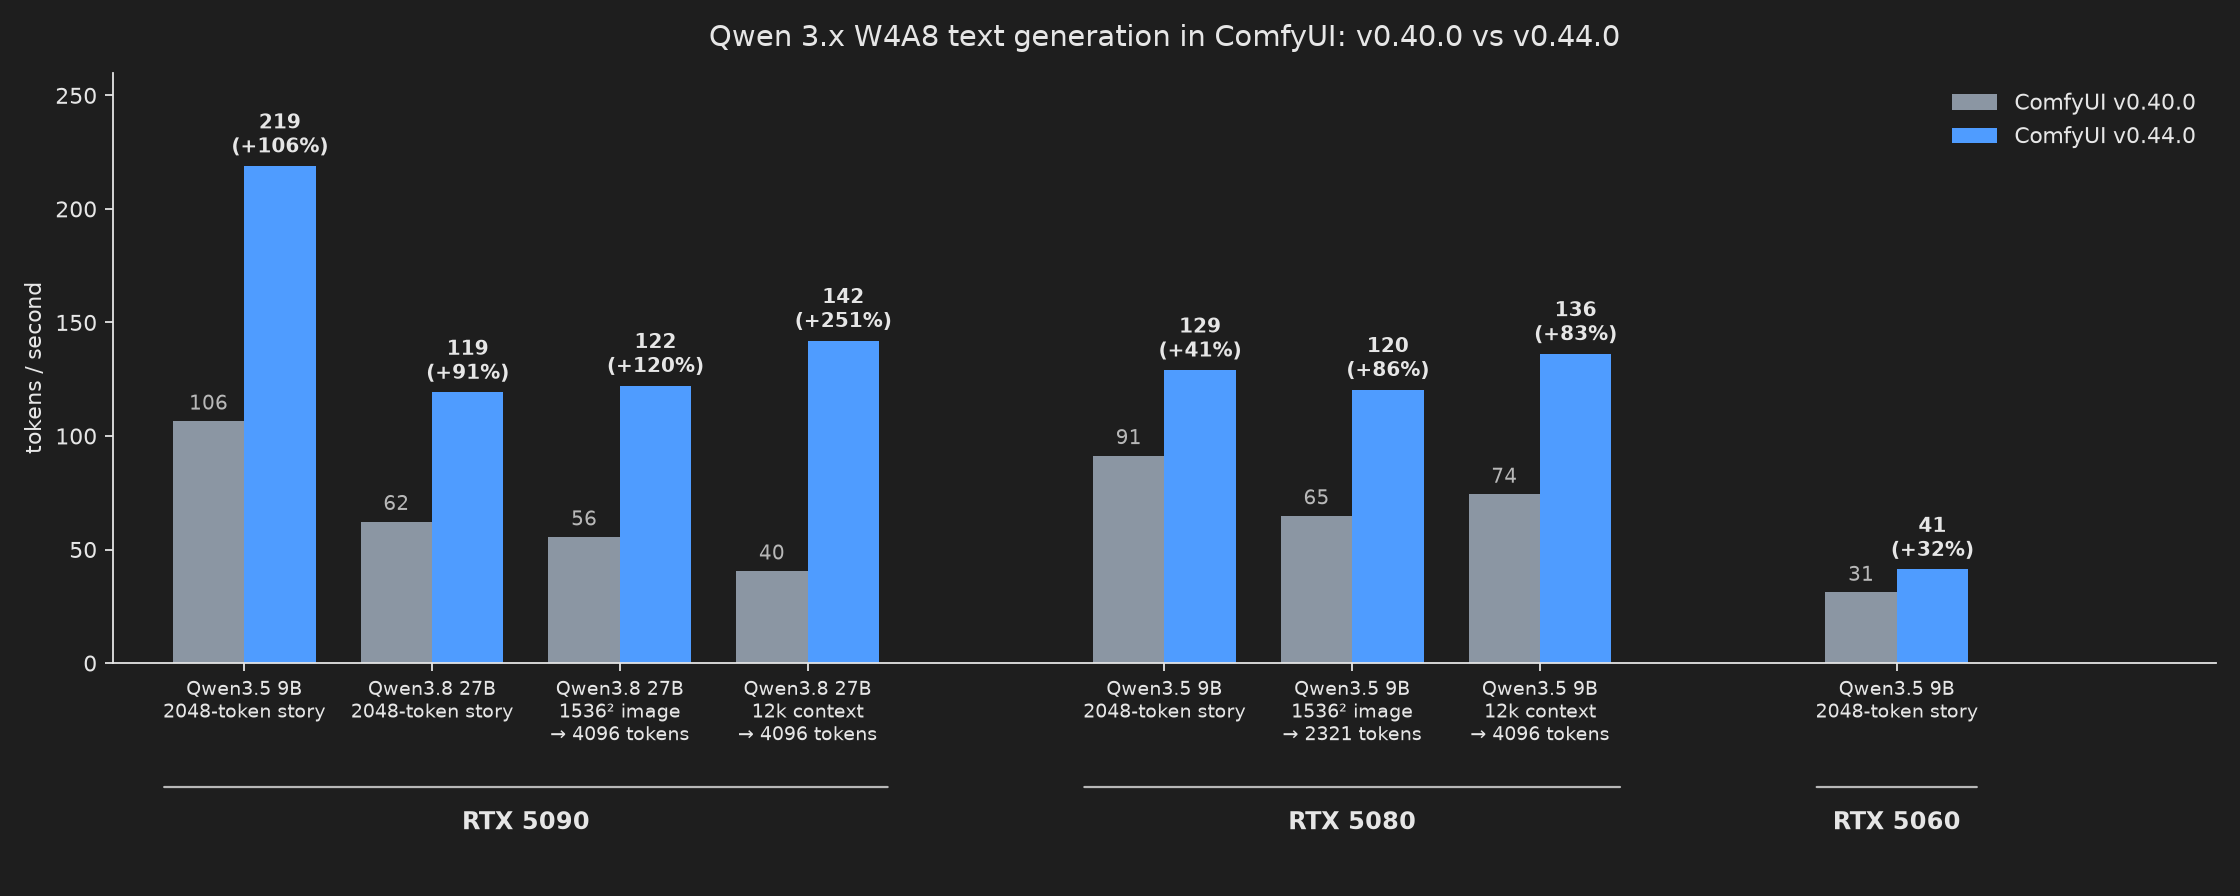
Del artículo de ingeniería de Comfy-Org que anuncia la reescritura.
Tasas de tokens medidas
| Checkpoint | GPU | Antes | v0.45.0 |
|---|---|---|---|
| Qwen3.5 9B | RTX 5090 | 106 tok/s | 219 tok/s |
| Qwen3.5 9B | RTX 5080 | 91 tok/s | 129 tok/s |
| Qwen3.8 27B, describiendo una imagen de 1536×1536 | RTX 5090 | 55 tok/s | 122 tok/s |
Qwen3.8 27B W4A8 alcanzó 137 tokens por segundo en una RTX 5090 mientras describía una imagen de 1500×1500 y escribía una historia.
Qué cambió
- Kernel de matriz-vector: los pesos W4A8 y W6A8 ahora están entrelazados con sus escalas por grupo en el orden en que los lee el kernel, de modo que cada bloque de hilos transmite una secuencia contigua en lugar de saltar entre dos tensores. La reorganización ocurre una vez por carga del modelo, en VRAM, sin costo extra de RAM o VRAM.
- MTP de árbol adaptativo: la cabeza de predicción multi-token ya no redacta una sola cadena de conjeturas. Mantiene los tokens finalistas como hermanos, verifica hasta ocho filas en una pasada y replanifica la forma del árbol cada 32 pasos. El código, las listas y los prompts reutilizados en la salida recompensan la profundidad; la escritura creativa recompensa la amplitud.
- Atención de Comfy-Kitchen: atención INT8 más soporte de caché KV para la ruta de atención del LLM, lo que reduce el uso de VRAM de la caché KV y acelera el prefill en prompts largos y prompts de sistema.
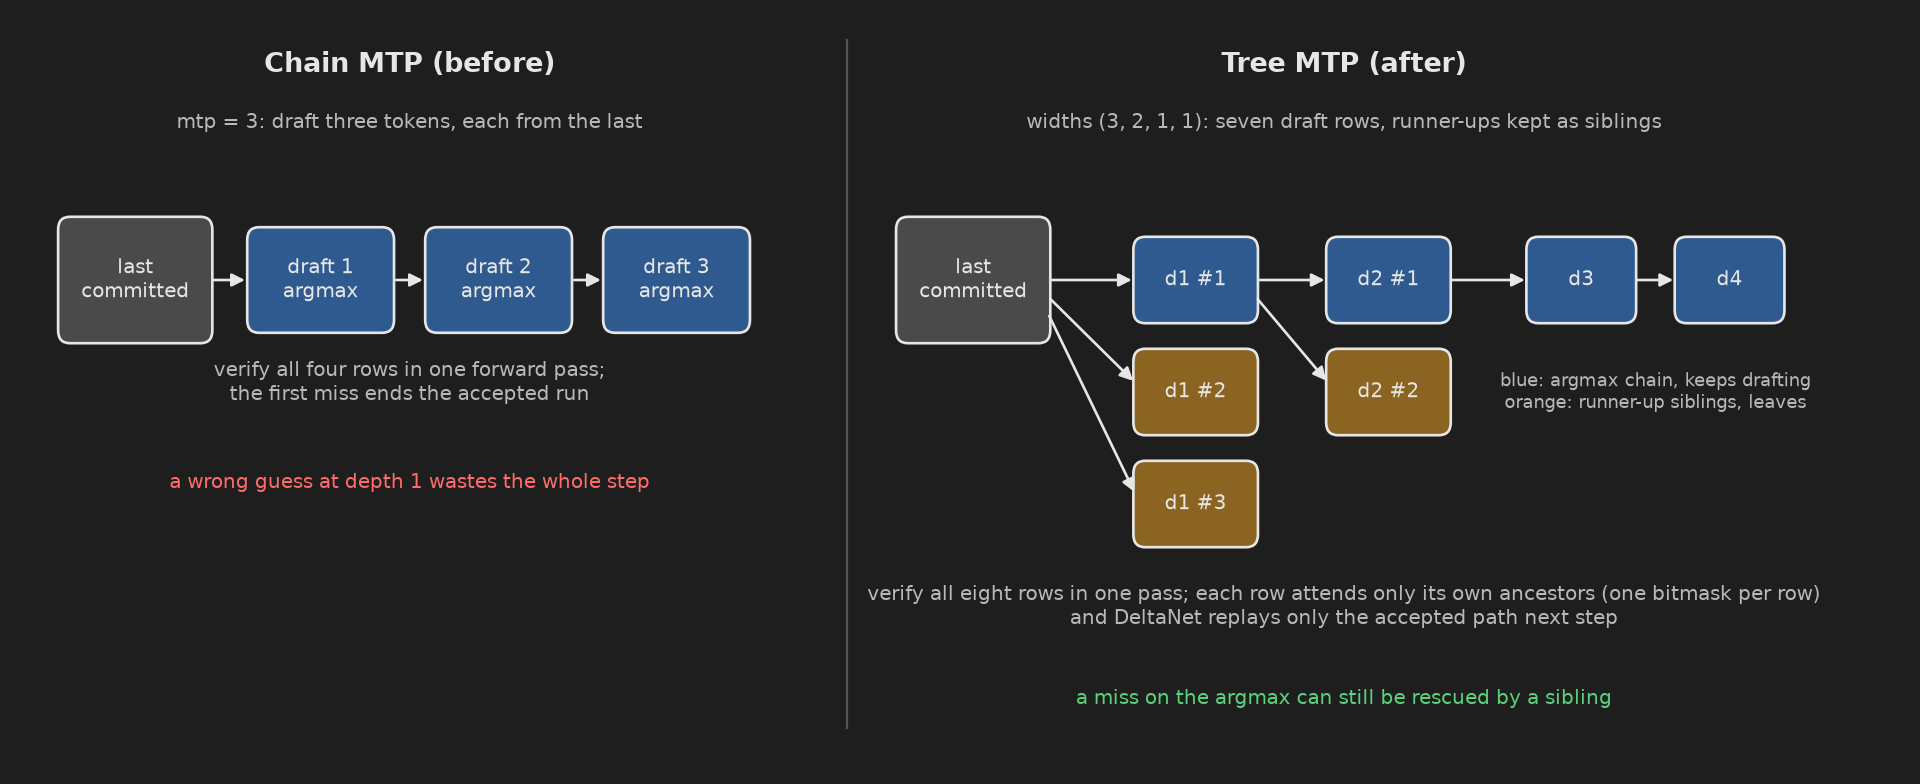
MTP en cadena redacta una ruta; MTP de árbol mantiene los tokens finalistas como hermanos y los verifica juntos.
Cómo activarlo
- Actualiza a ComfyUI v0.45.0 o posterior.
- Carga un checkpoint de Qwen3.x y ejecútalo a través del nodo
Generate Text. - Deja
mtpenauto. Los valores fijados2a5todavía fijan la profundidad del borrador, y los modostree*fijan tanto la amplitud como la profundidad. - Opcional: inicia ComfyUI con
--use-ck-attentionpara la atención de Comfy-Kitchen. Esto requiere una compilación de Comfy Kitchen que incluya soporte de atención.
Todo lo anterior funciona en GPUs NVIDIA y AMD, en Windows y Linux, y los contextos más largos que antes se quedaban sin memoria ahora caben. Un detalle del tooltip del nodo: la salida de MTP sigue distribuida correctamente pero difiere de la salida sin MTP para la misma semilla.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.