PAN 2: el modelo del mundo 29B de MBZUAI, ya en ComfyUI
MBZUAI IFM publica PAN 2, un modelo del mundo de 29B que simula 20 segundos de vídeo en 704x1248, con nodo de la comunidad para ComfyUI y pesos fp8.
PAN 2 es un modelo del mundo de 29B del Institute of Foundation Models de MBZUAI. Describe una acción en texto, opcionalmente pásale un fotograma inicial y simula lo que ocurre a continuación en un solo clip de hasta 20 segundos a 704x1248 y 24 fps. Se anunció el 10 de noviembre con los pesos, el código de inferencia y las configuraciones de entrenamiento ya en el repositorio, y un nodo de la comunidad para ComfyUI apareció al día siguiente.
Un fotograma del clip de demostración oficial. Fuente: IFM/PAN2
26 segundos de la demostración oficial, recodificados a 1280x720. Fuente: IFM/PAN2
Cómo funciona
Dos modelos se turnan. Un LLM congelado, llamado razonador conceptual, reescribe tu petición como una descripción estructurada del estado del mundo: eventos con rangos de tiempo, acciones vinculadas a actores, movimientos de cámara. El MMDiT de 29B predice después los latentes de vídeo que rellenan el detalle que la descripción deja abierto, y un VAE estándar de Wan 2.2 los decodifica.
El codificador de texto es Qwen3.5-9B y permanece congelado, así que lo que ajustas es el prompt, no el modelo.
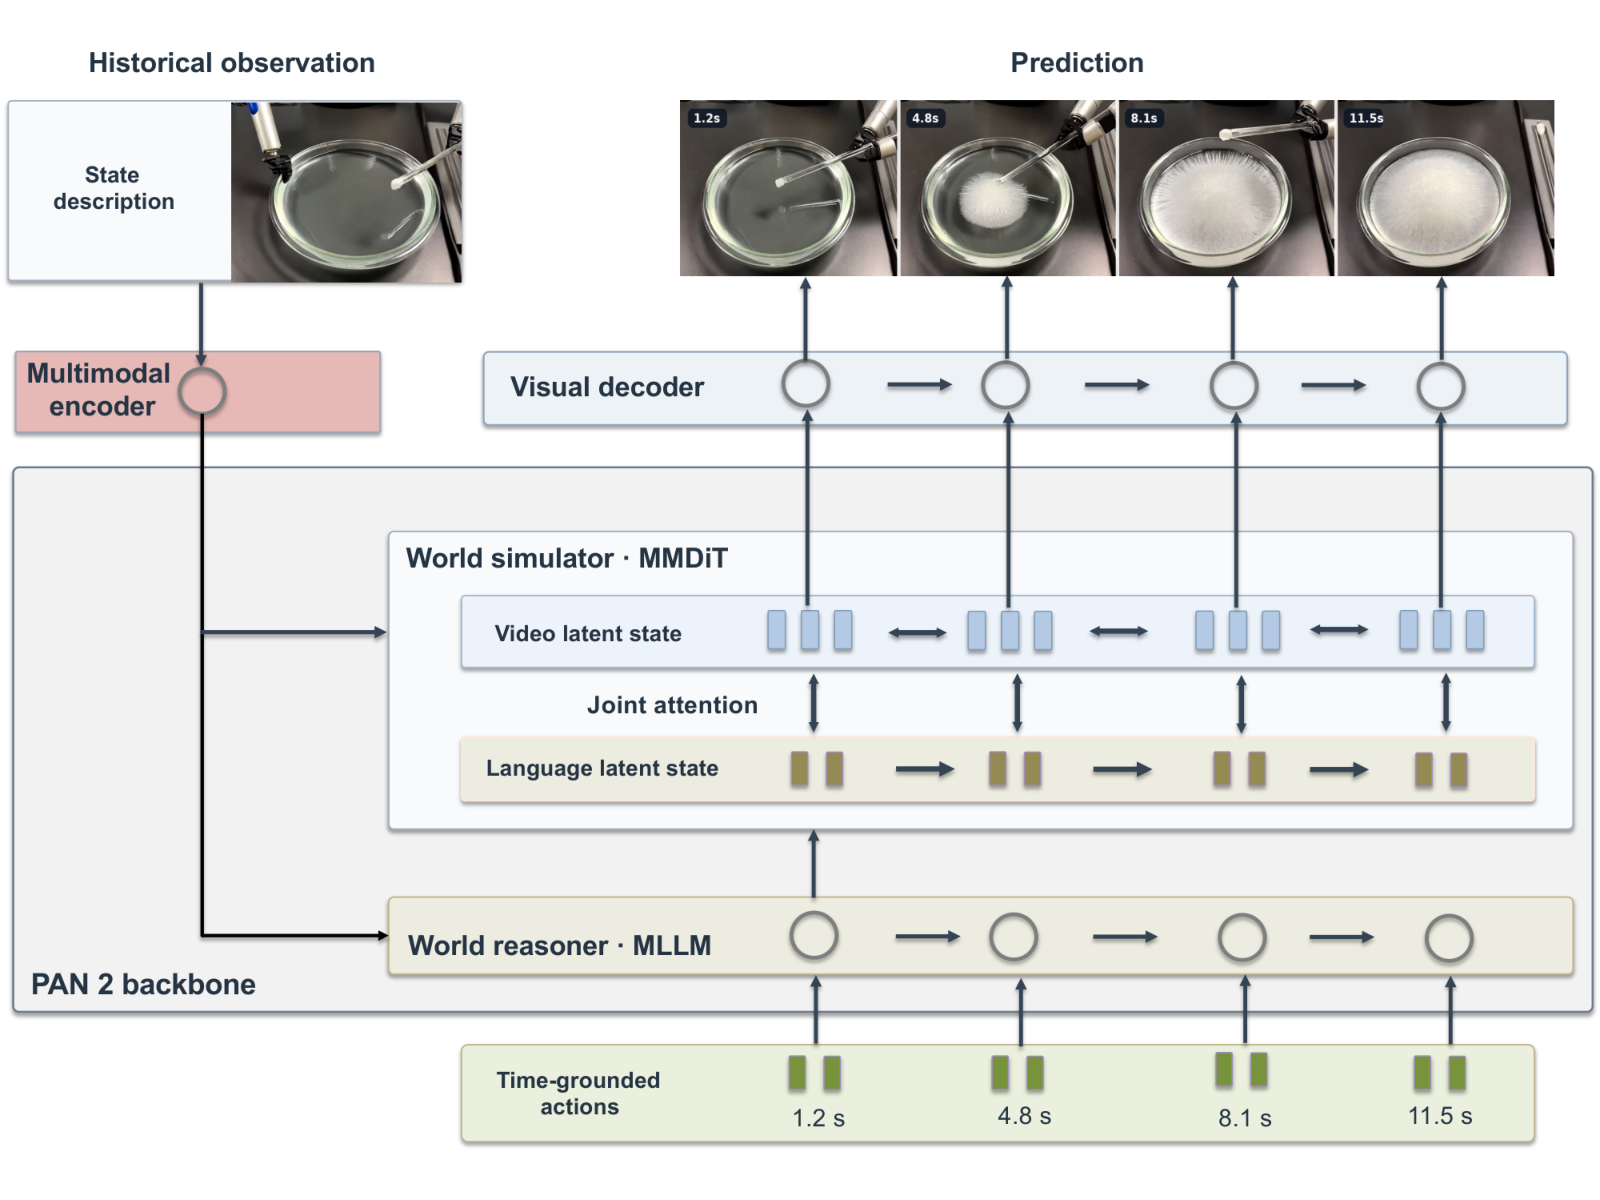
Los dos backbones junto con el codificador y el decodificador congelados. Fuente: IFM/PAN2
En ComfyUI
Todavía no hay nodos oficiales, pero ComfyUI-PAN2 es un port funcional publicado el 11 de noviembre: PyTorch puro con SDPA, por lo que también funciona en Windows. Carga directamente los pesos con el formato de diffusers.
- Modelo de difusión:
transformer/en bf16 desde IFM/PAN2, o el repack fp8 de la comunidad de 33,7 GB zombothe26/pan2-fp8. - VAE: el VAE estándar de Wan 2.2 en ComfyUI.
- Codificador de texto:
Qwen/Qwen3.5-9B. - Gráfico:
PAN2 Model LoaderyPAN2 Prompt Builderalimentan aPAN2 Text Encode (Qwen3.5), y despuésPAN2 Samplerpasa a la Decodificación VAE y Crear video del núcleo a 24 fps.
Los valores por defecto coinciden con los oficiales: 50 pasos, CFG 2.5, shift 9, 704x1248, 241 fotogramas. El autor del nodo midió un clip coherente de 448x256, 13 fotogramas y 16 pasos en unos 65 s con una 5090 y 129 s con una 4090, manteniendo los pesos en RAM e intercambiando 44 bloques a la GPU de uno en uno.
El formato del prompt no es opcional aquí. PAN 2 se entrenó con descripciones estructuradas, y un prompt de una sola línea con un negativo vacío produce clips sobreexpuestos y pastosos. Usa el PAN2 Prompt Builder incluido para escribir los campos de escena, evento, sujeto, iluminación, punto de vista y estilo antes del muestreo.
Qué mide el informe
El informe técnico evalúa seis capacidades de simulación y planes de varios pasos, y después tres benchmarks públicos: Physics-IQ Verified para imagen a vídeo, PhyGround y RBench. Un estudio humano a ciegas añade 1.400 comparaciones por pares sobre 140 prompts, puntuadas como Elo.
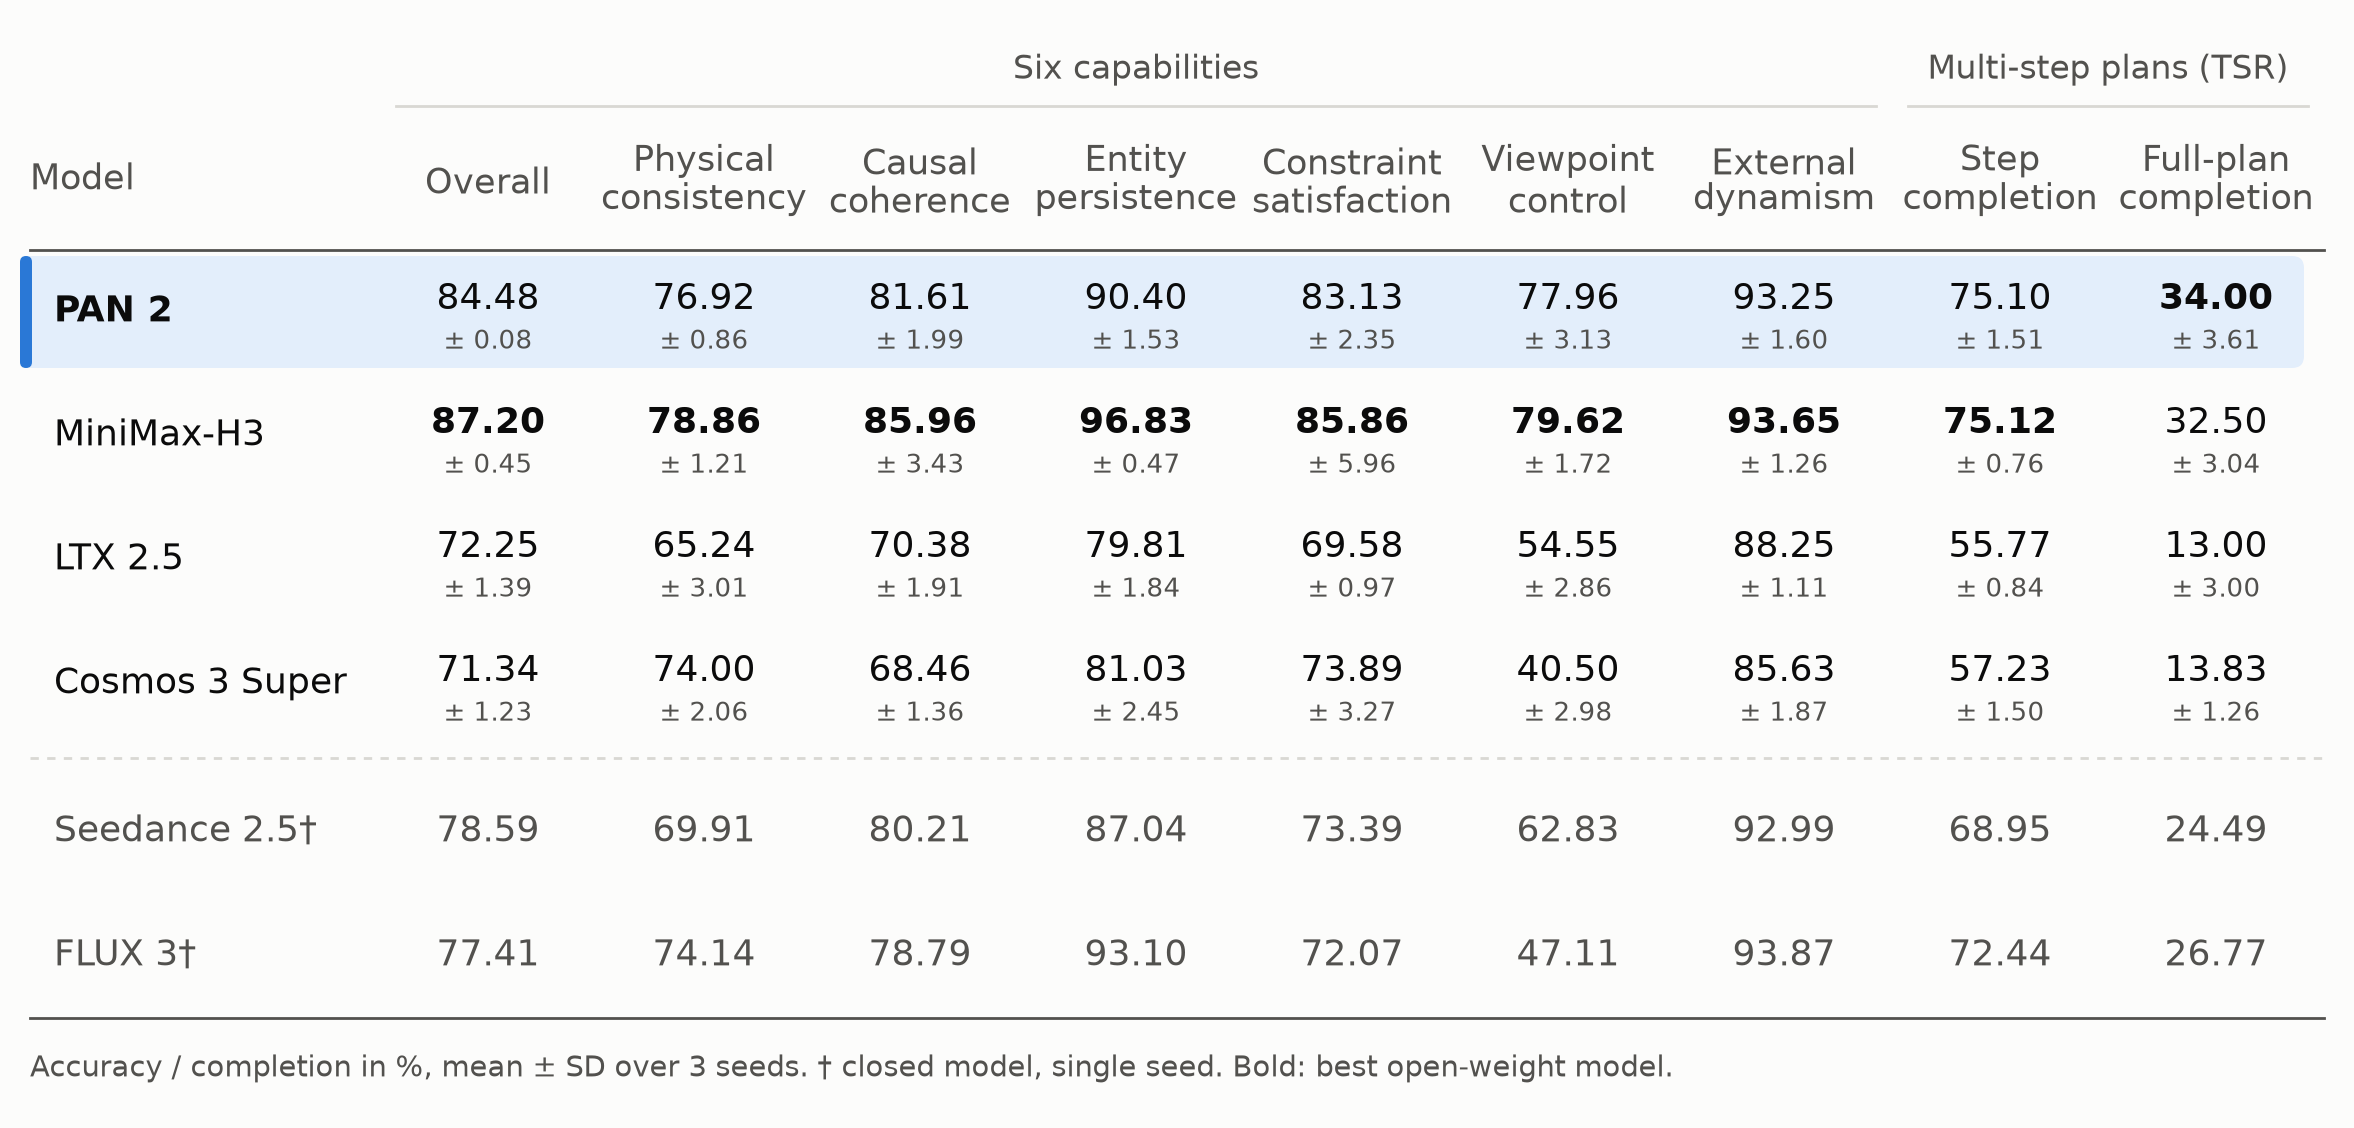
Precisión por capacidad y finalización de planes de varios pasos, con PAN 2 resaltado. Fuente: IFM/PAN2
Los autores son directos sobre el punto débil: aproximadamente dos de cada tres planes de varios pasos simulados contienen al menos un paso que el modelo no lleva a cabo. Además, cada clip se simula desde como mucho un fotograma inicial más texto, así que la apariencia deriva a lo largo de una secuencia larga.
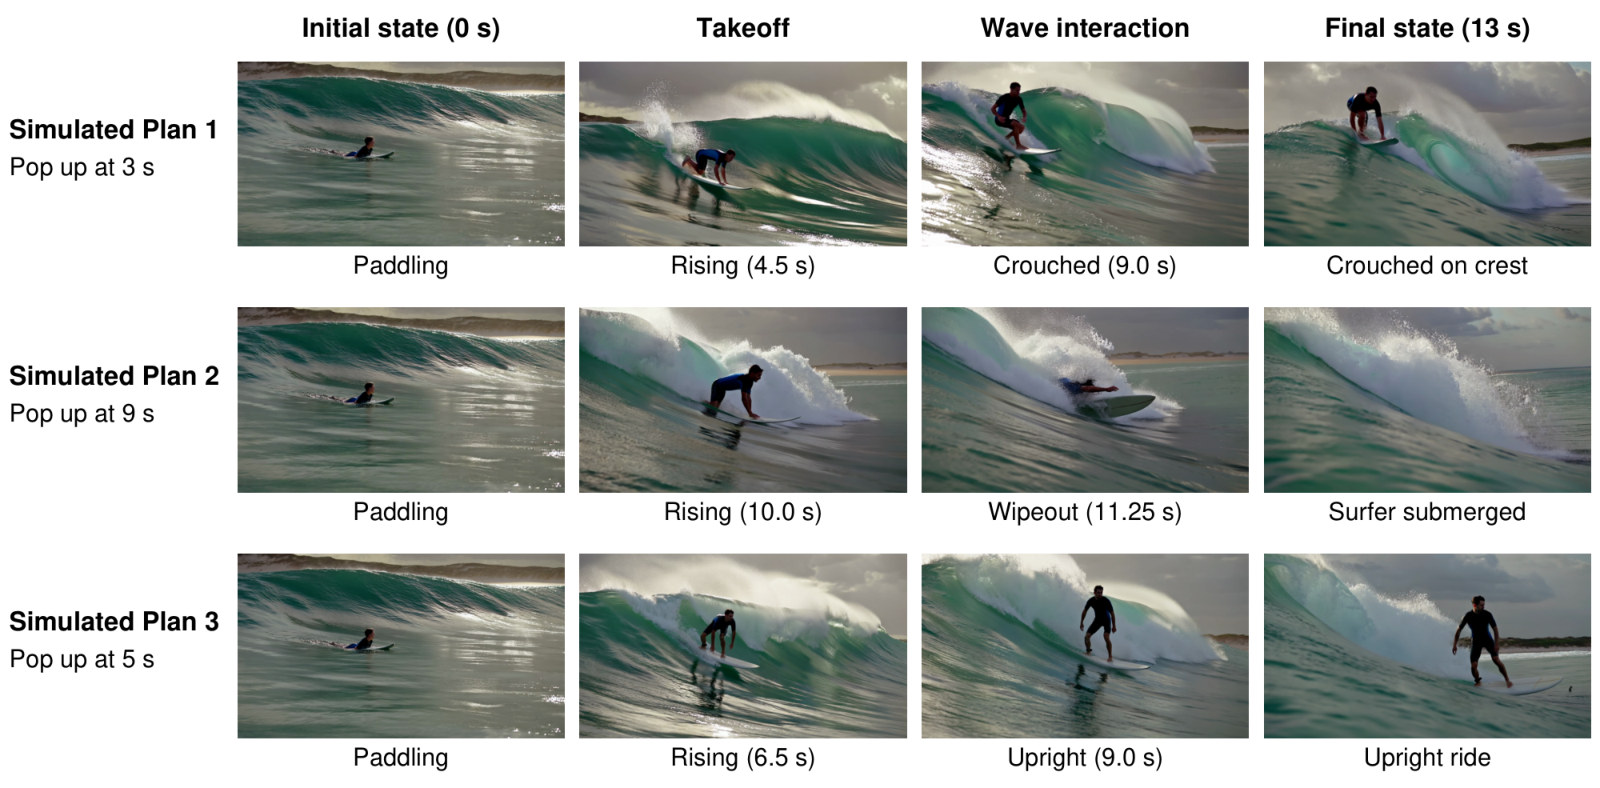
Un ejemplo de razonamiento simulado del informe. Fuente: IFM/PAN2
Vía oficial
Fuera de ComfyUI, PAN 2 incluye un pipeline de Diffusers (pan2), una receta de vLLM y un generate.py que convierte el checkpoint una vez y ejecuta un worker por GPU. El mismo repositorio contiene las configuraciones de preentrenamiento y SFT, así que la receta de entrenamiento es reproducible.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.