WeVisOne-VL en ComfyUI: cajas, máscaras y mattes desde un prompt
WeVisOne-VL de Tencent ya corre en el núcleo de ComfyUI. Un nodo Detect convierte una consulta de texto en cajas, máscaras, mattes alfa, puntos, recuentos y cajas OCR.
WeVisOne-VL es el modelo de visión de Tencent WeChat Vision, y ahora se ejecuta en el núcleo de ComfyUI. El soporte llegó el 2026-11-09 como PR 17632. Le das una imagen y una frase, y devuelve cajas, máscaras, mattes alfa, puntos, un recuento o cajas OCR. Sin SAM, sin nodos personalizados, sin backend de segmentación aparte.
Los checkpoints 2B y 4B son fine-tunes de Qwen3-VL con un decodificador de máscaras de 9,6M de parámetros. El nodo lee la frase, escribe las coordenadas como tokens simples y el decodificador convierte los tokens coincidentes en salida a nivel de píxel.
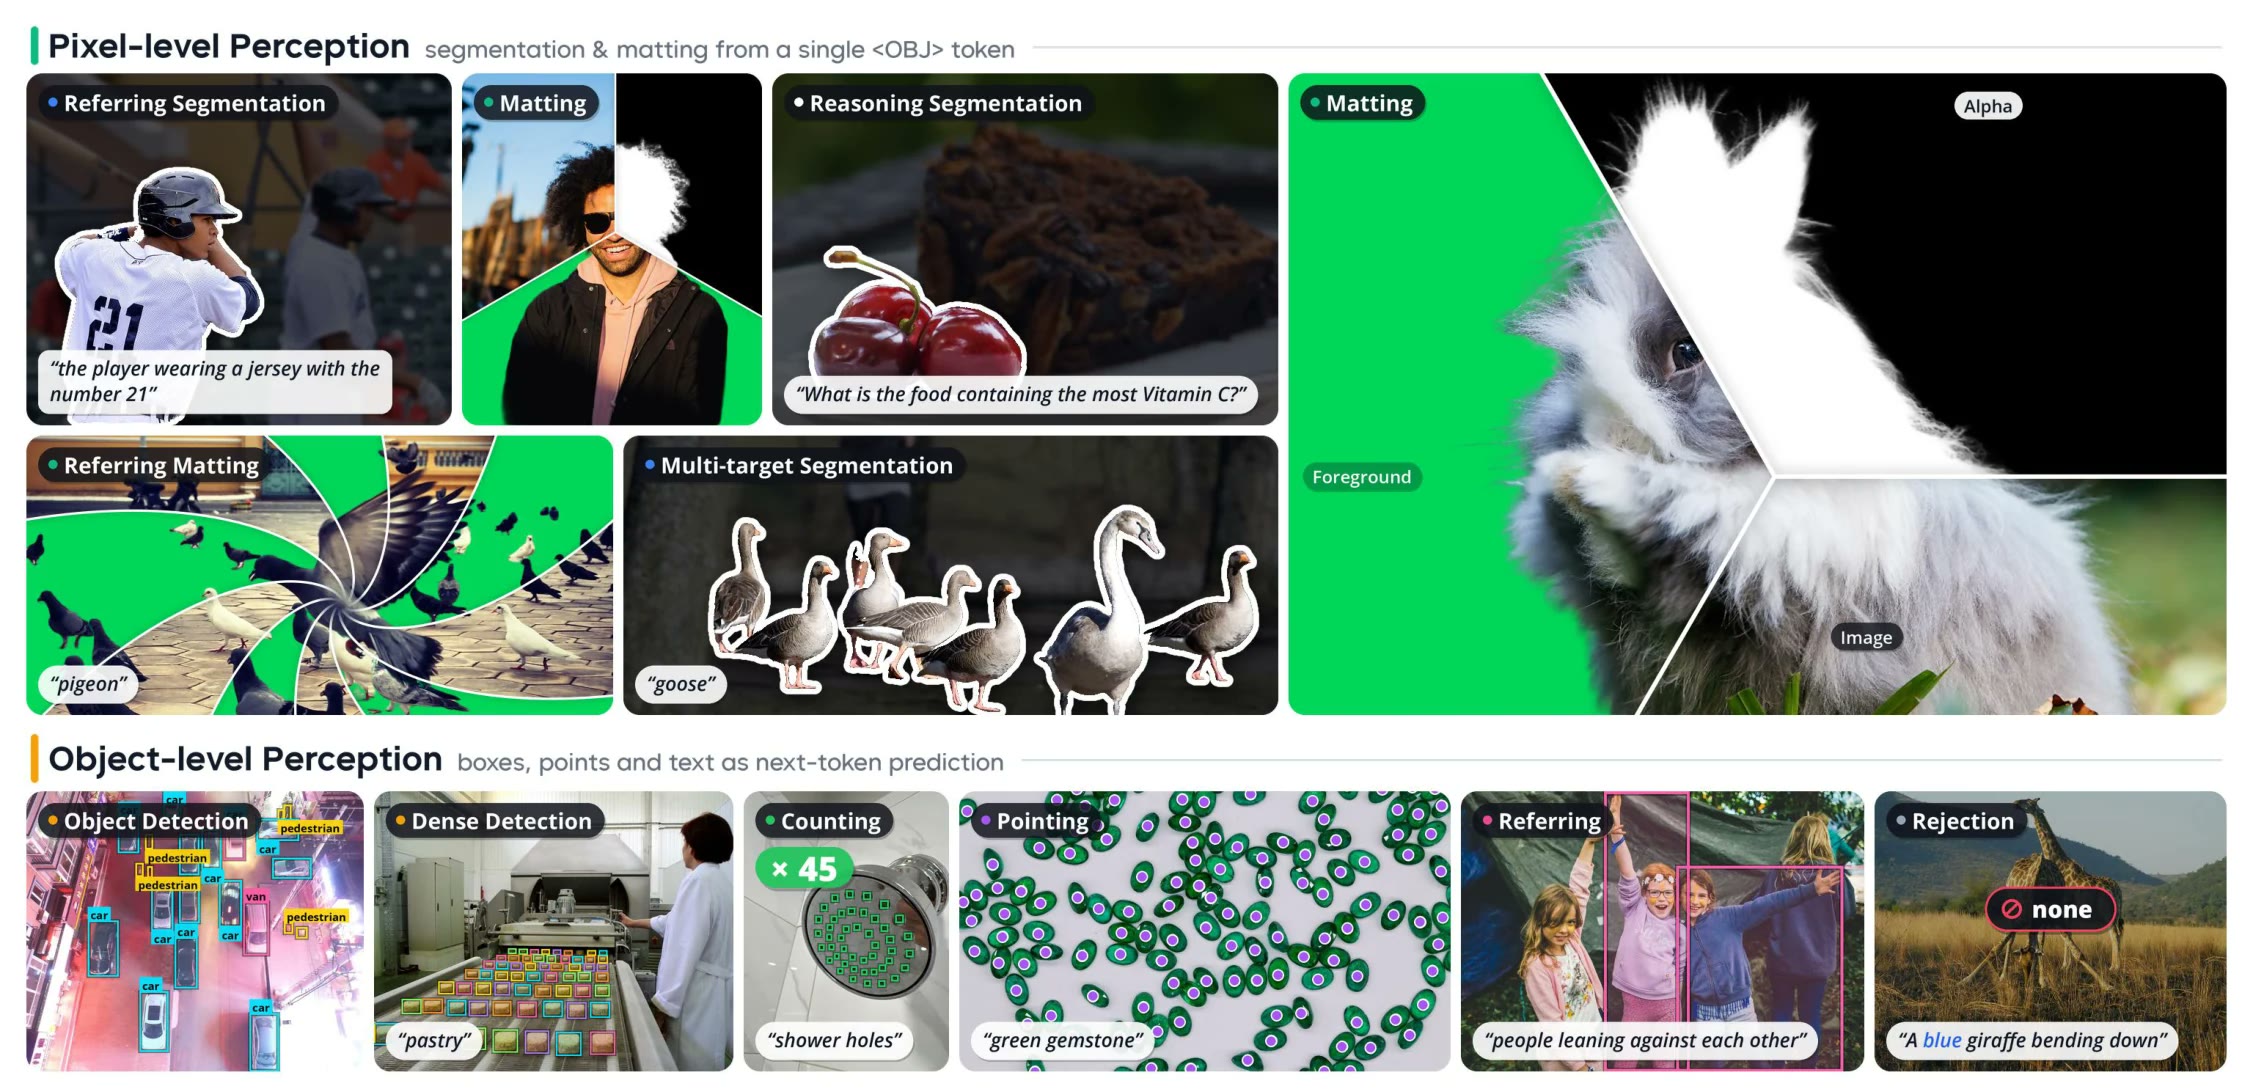
Un modelo cubre puntos, cajas, máscaras binarias y mattes alfa continuos. Fuente: página del proyecto
Qué devuelve el nodo
WeVisOne-VL Detect se encuentra en image/detection y tiene cuatro salidas: masks, bboxes, points (JSON en coordenadas de píxel) y el texto de respuesta sin procesar. Lo que obtienes depende de la tarea que elijas.
| Tarea | Qué escribes | Salida |
|---|---|---|
segmentation | una frase, p. ej. person | cajas más mattes alfa por instancia |
detection | una etiqueta por línea | cajas, listas para Draw BBoxes |
referring | una frase descriptiva | cajas del objeto que coincide |
point | una etiqueta por línea | coordenadas de puntos como JSON |
count_box / count_point | el sujeto, p. ej. cars | recuento, con cajas o puntos |
ocr | dejar vacío | cada palabra como una caja |
ocr_grounding | la cadena de texto | dónde está ese texto |
visual_prompt | cajas de referencia de otra ejecución | objetos similares a la referencia |
freeform | tu prompt completo | respuesta sin procesar |
Activa individual_masks para conservar una máscara por caja en lugar de una única máscara de unión. Para recortes, conecta masks y la imagen a InvertMask + JoinImageWithAlpha.
Cada coordenada es un token de <0> a <1000>, así que una caja cuesta cuatro tokens. Fuente: página del proyecto
Cómo ejecutarlo
-
Actualizar ComfyUI. El nodo está en master; la última etiqueta (v0.44.2) todavía no lo incluye.
-
Descargar los pesos desde Comfy-Org/WeVisOne-VL en
ComfyUI/models/text_encoders/. El repack incluye cuatro archivos:Archivo Tamaño wevisone_vl_4b_bf16.safetensors9.7 GB wevisone_vl_4b_int8_convrot.safetensors5.3 GB wevisone_vl_2b_bf16.safetensors4.9 GB wevisone_vl_2b_int8_convrot.safetensors2.9 GB -
Cargar un
CLIPLoadercon tipostable_diffusiony elegir uno de esos archivos, luego conéctalo a la entradaclipdel nodo.
El ejemplo de tres grupos del PR: matting alfa en una persona, detección y OCR. Sustituye los tres nodos LoadImage por tus propias imágenes.
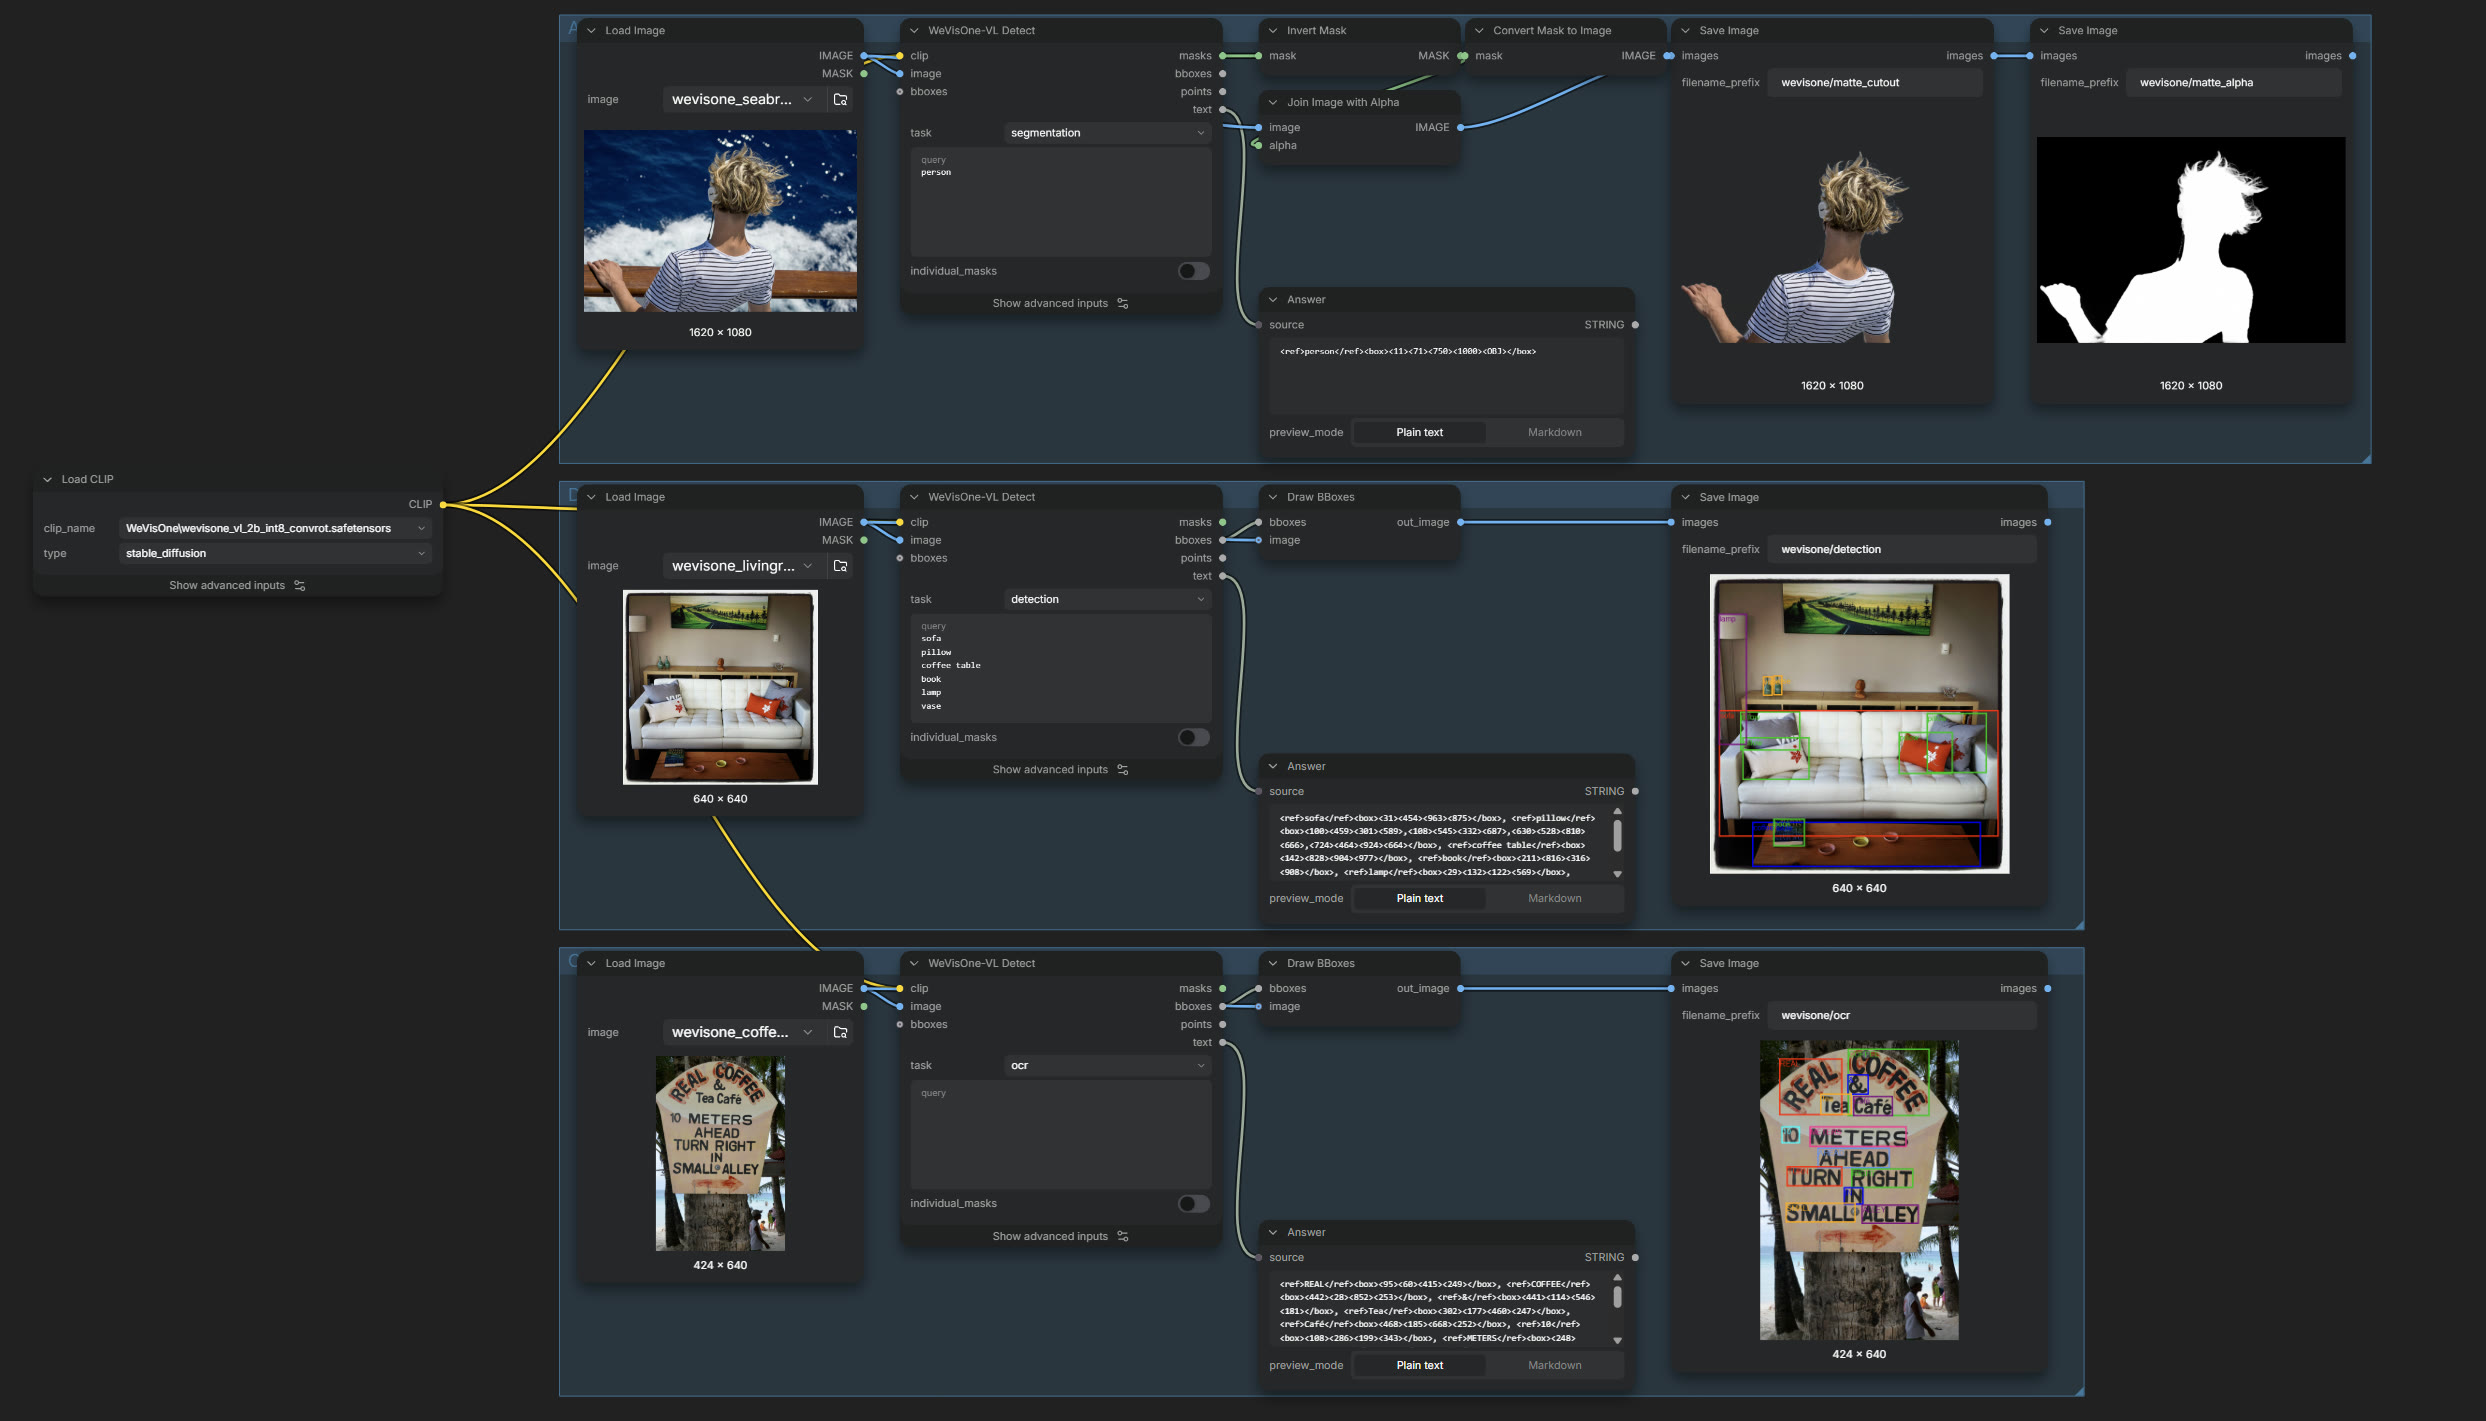
Matting alfa, detección y OCR en un solo gráfico. Fuente: PR 17632
¿Qué tan bueno es?
Cifras destacadas del modelo 4B frente a la línea base abierta más potente en cada benchmark:
| Tarea | Benchmark | Línea base | WeVisOne-VL-4B |
|---|---|---|---|
| Detección | LVIS, F1 | 50.7 | 55.3 |
| Rechazo de objetivos ausentes | WeRef-Bench | 73.0 | 96.4 |
| OCR | TotalText, F1 | 43.3 | 52.0 |
| Segmentación referida | ReasonSeg, gIoU | 65.0 | 71.2 |
| Matting de cajas | P3M-500-NP, MAD (menor es mejor) | 15.4 | 7.3 |
La fila de rechazo es la que importa en un gráfico: pide algo que no está en el encuadre y el modelo escribe None en lugar de inventar una caja.
Limitaciones
- Solo imágenes individuales. El decodificador de píxeles rechaza rejillas de vídeo, así que este no es un nodo de seguimiento.
- Los bordes alfa finos todavía se desvían en oclusiones fuertes o sujetos transparentes, y la redacción de la consulta cambia los resultados.
detectionypointquieren una etiqueta por línea; una lista separada por comas se lee como una sola frase.
Pesos originales: tencent/WeVisOne-VL-4B y 2B. El repack de ComfyUI de arriba es el que carga.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.