P-H3-Image se ejecuta en 2 pasos con un LoRA pDMD en ComfyUI
Un LoRA pDMD de 2 pasos reduce P-H3-Image de 8 pasos a 2 a 8 MP: un solo archivo, un flujo de trabajo de ComfyUI listo y sin nodos personalizados, unos 2,9 s por imagen.
 |  |
|---|---|
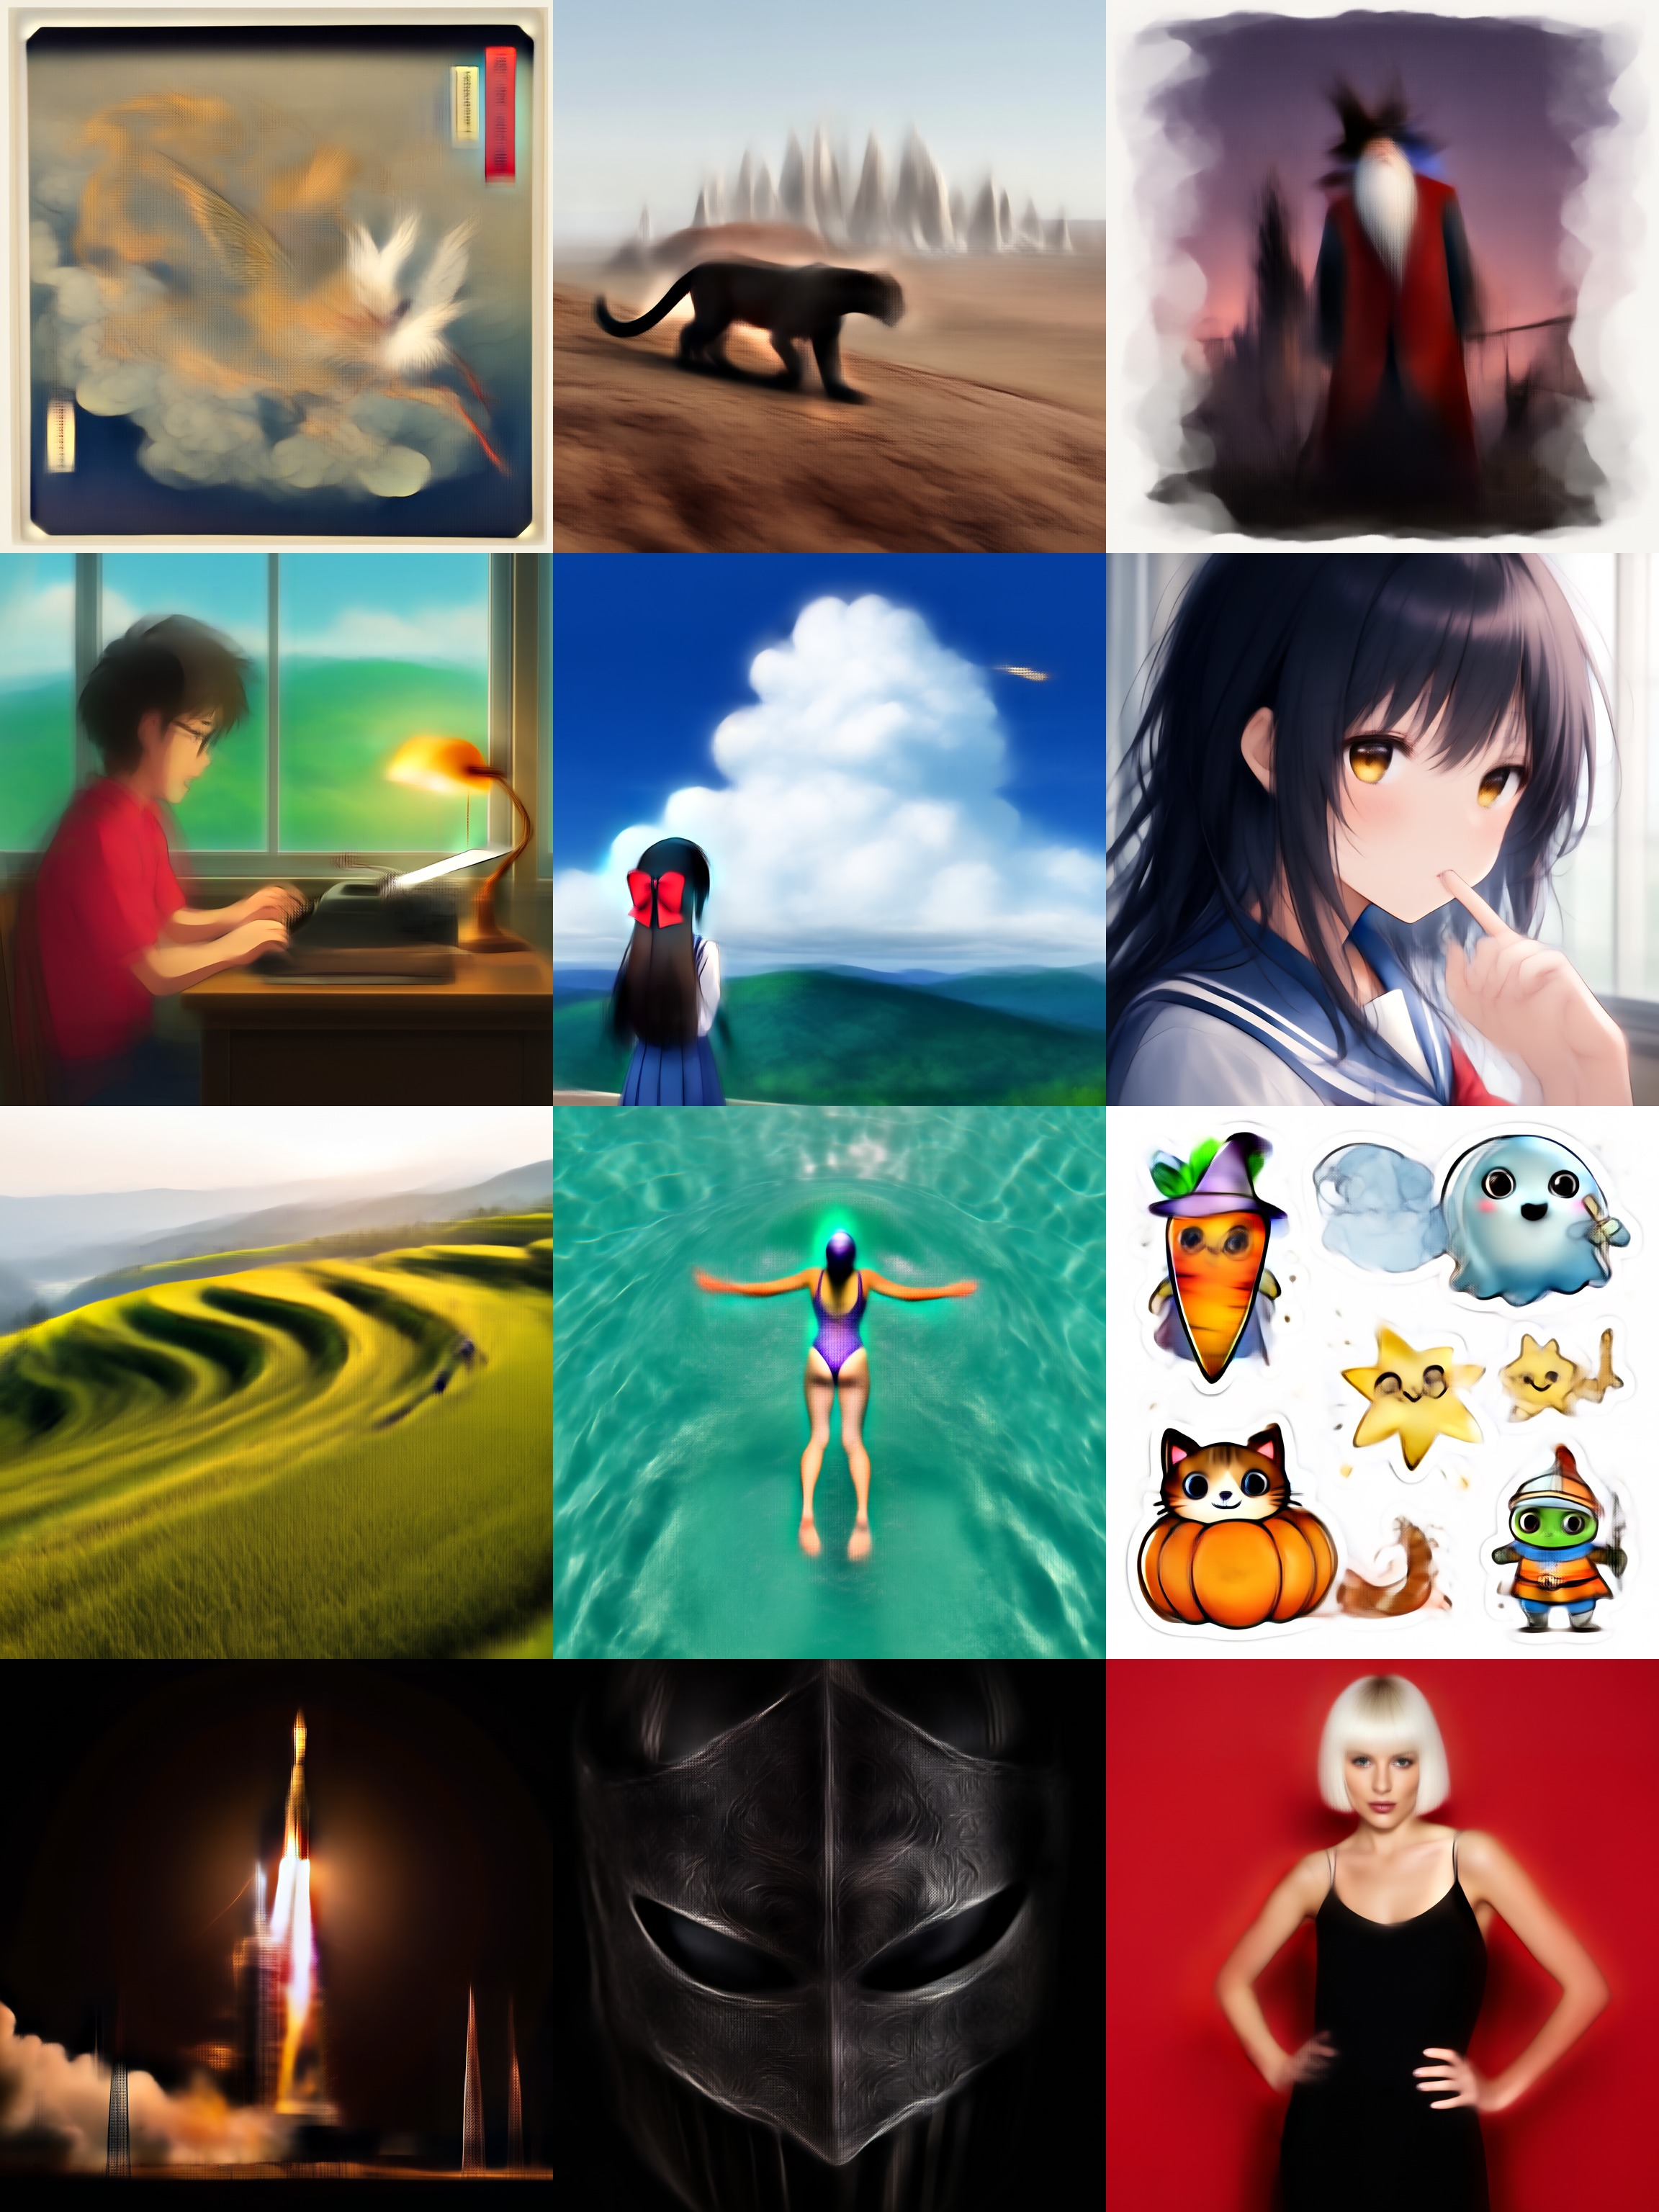
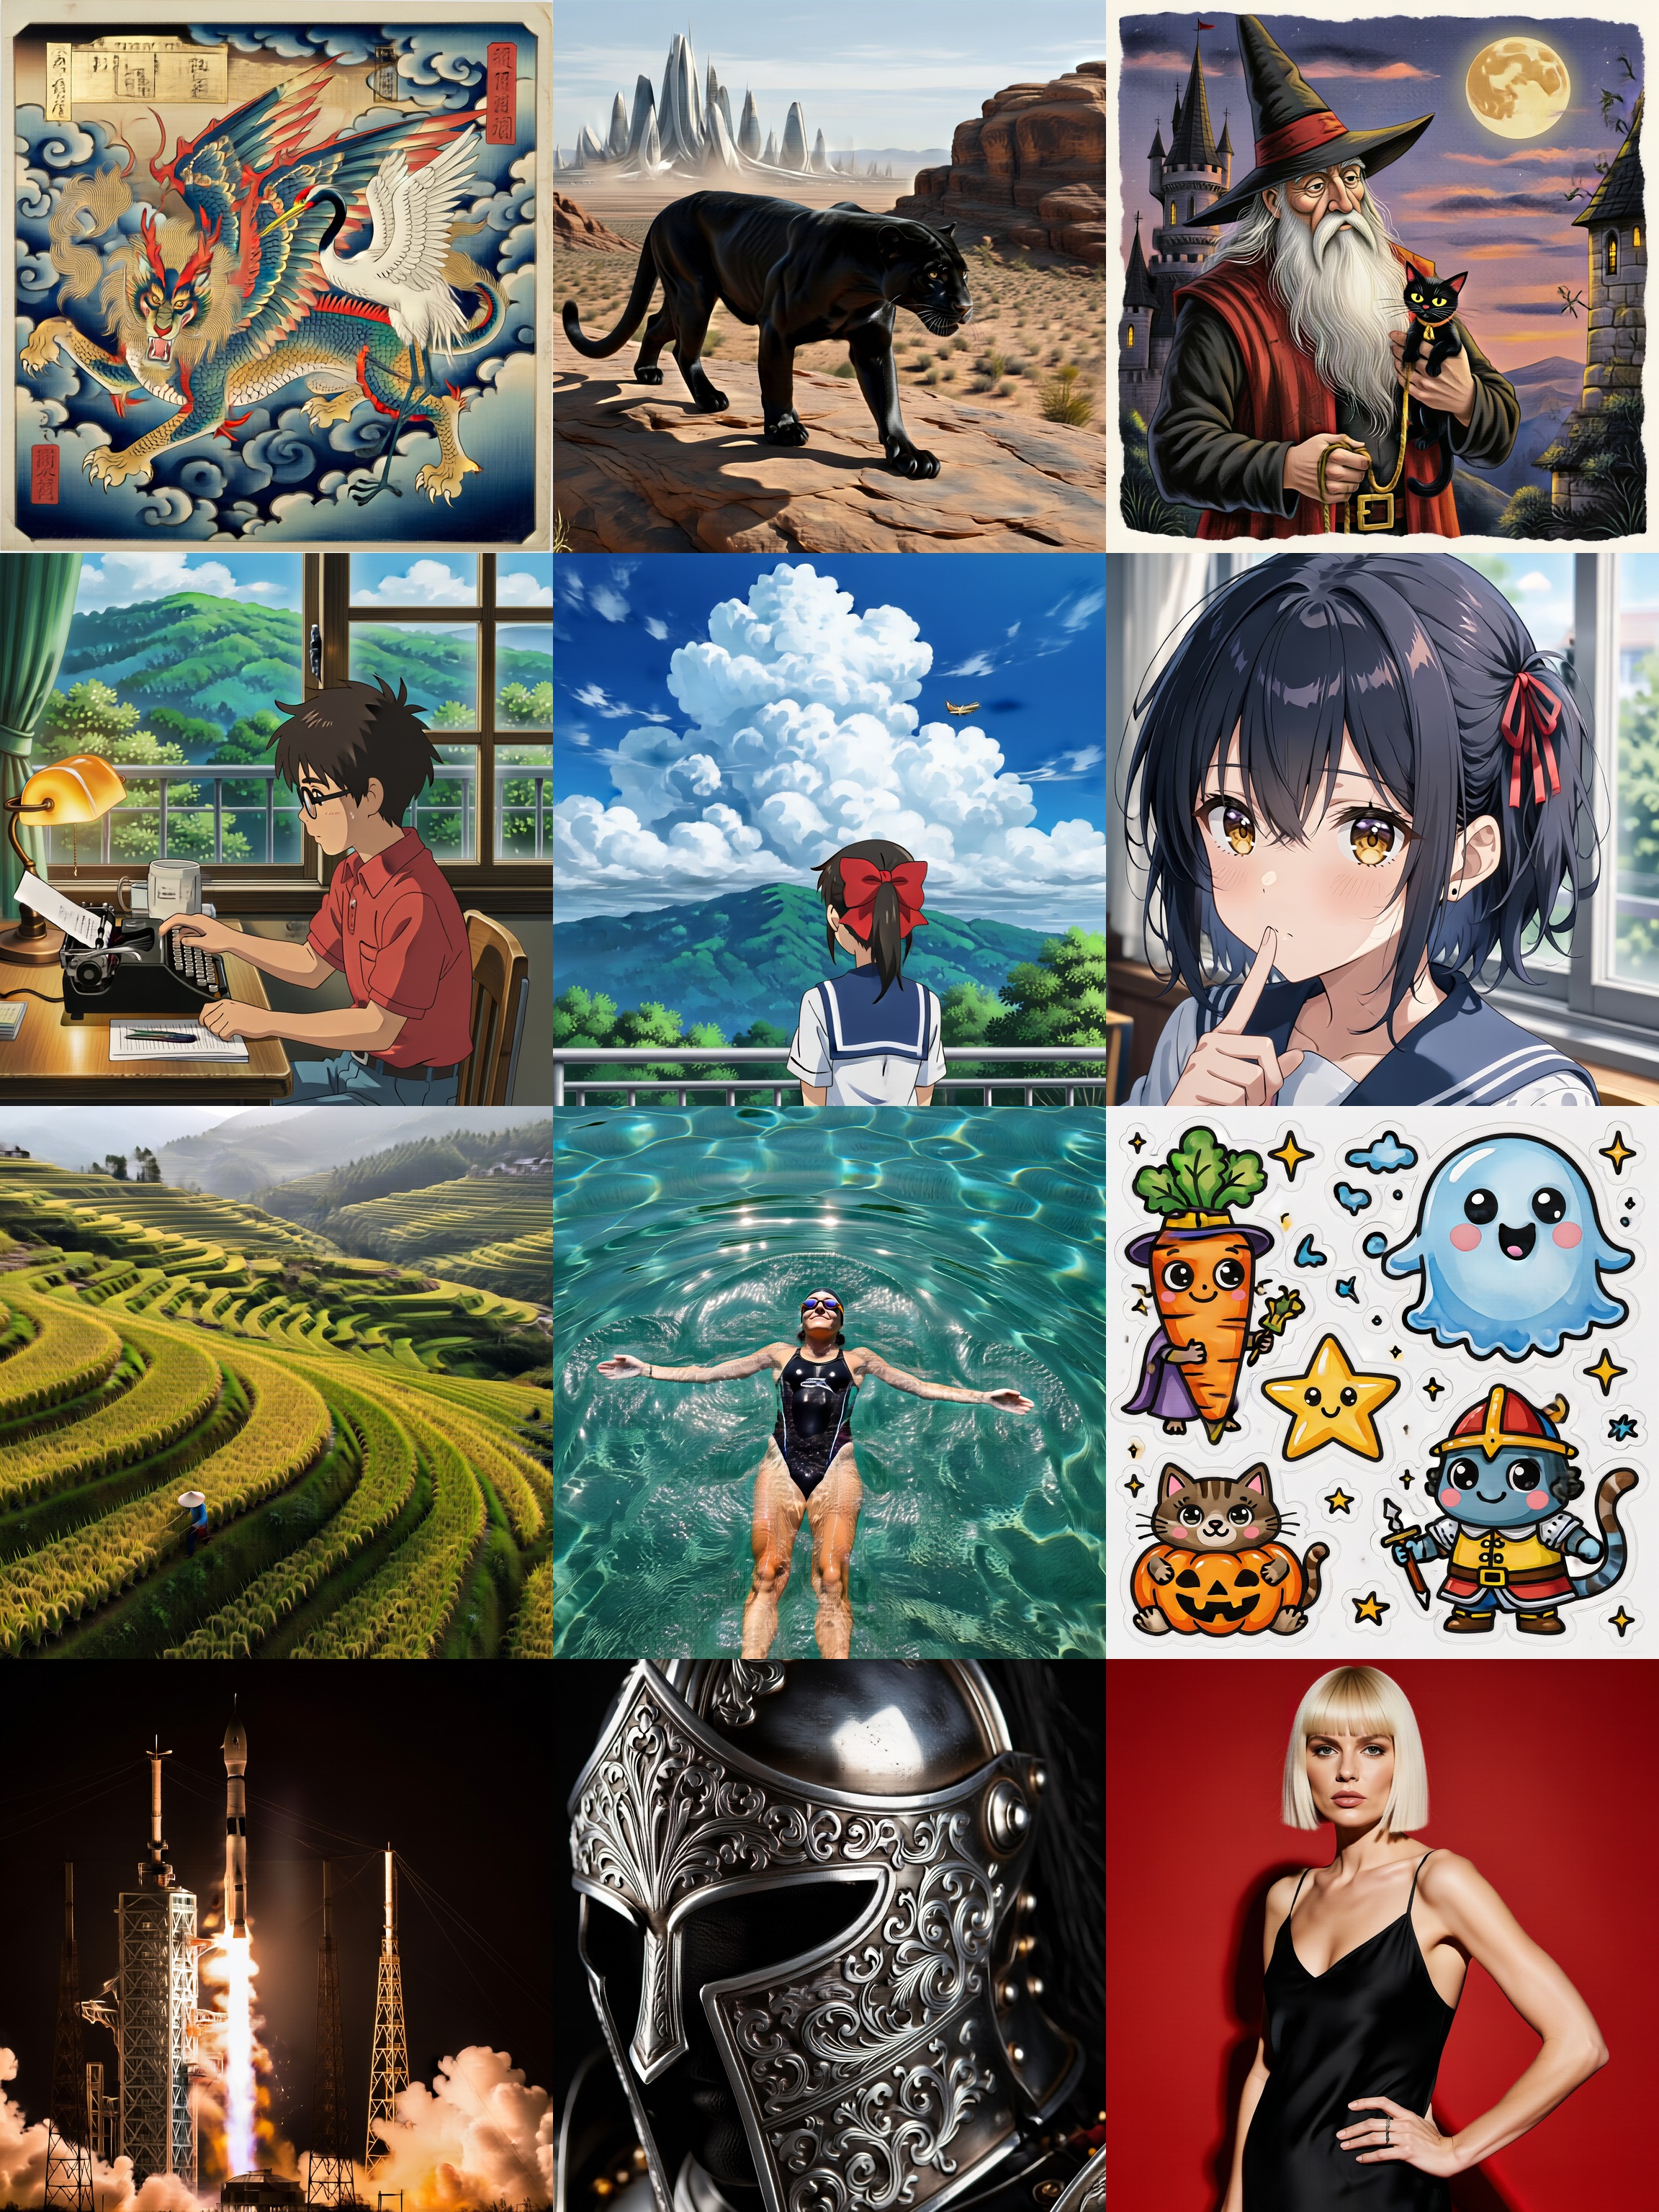
| Modelo original, 2 pasos | Con el LoRA pDMD, 2 pasos |
Doce prompts, 2 pasos, shift 12, semilla 3, renderizado a 2912 x 2912 desde el repositorio del autor. Sin el LoRA, el modelo sigue a mitad del denoise con 2 pasos.
Ejecutarlo
- Configure P-H3-Image según P-H3-Image-Comfy y actualice ComfyUI a la última versión master.
- Descargue el LoRA en
ComfyUI/models/loras/:hf download akhaliq/p-h3-image-pdmd-2step minimax_h3_pdmd_2nfe_comfyui.safetensors --local-dir ComfyUI/models/loras - Abra el flujo de trabajo de abajo. Dos cambios respecto al gráfico original de 8 pasos: Cargar LoRA (Omitir, solo modelo) con fuerza 1.0 entre Cargar modelo de difusión y el muestreador, y un Programador básico en
simplecon 2 pasos y flow shift 12 en lugar de la cuadrícula de Sigmas manuales de 8 pasos. Conserveeuler, Guía básica y sin CFG.
También hay una demostración en el navegador para texto a imagen y ediciones de una sola imagen a 2, 3 y 4 pasos.
2, 3 o 4 pasos
| Pasos | Resultado |
|---|---|
| 2 | Utilizable: nítido y coherente, pero la composición se desvía de la línea base de 8 pasos y los prompts gráficos pueden inventar pseudo-texto |
| 3 | El ajuste intermedio seguro |
| 4 | El más cercano a la línea base, y la opción para texto entre comillas y gráficos planos |
El LoRA es el adaptador pDMD 2-NFE (rango 128, alfa 128 sobre los mismos 312 módulos, bf16, sin modificaciones respecto a la publicación original). Se destiló para el modelo de vídeo H3 y aquí se fusiona en el transformer de imágenes de P-H3-Image.
Pase de detalle opcional
Un refinador Regenerate-2K añadido encima aporta detalle real: renderice un borrador de 2 MP a 2 pasos, aplique un upscale de 2x y luego regenere a 8 MP con el LoRA refinador a sigma 0.7 durante 3 pasos de Euler. El autor mide unos 7 s por imagen en total, aproximadamente 1,7x más rápido que la línea base de 8 pasos sin refinar. Use 0.5 para retratos, que mantiene mejor los rostros aunque aporta menos detalle.
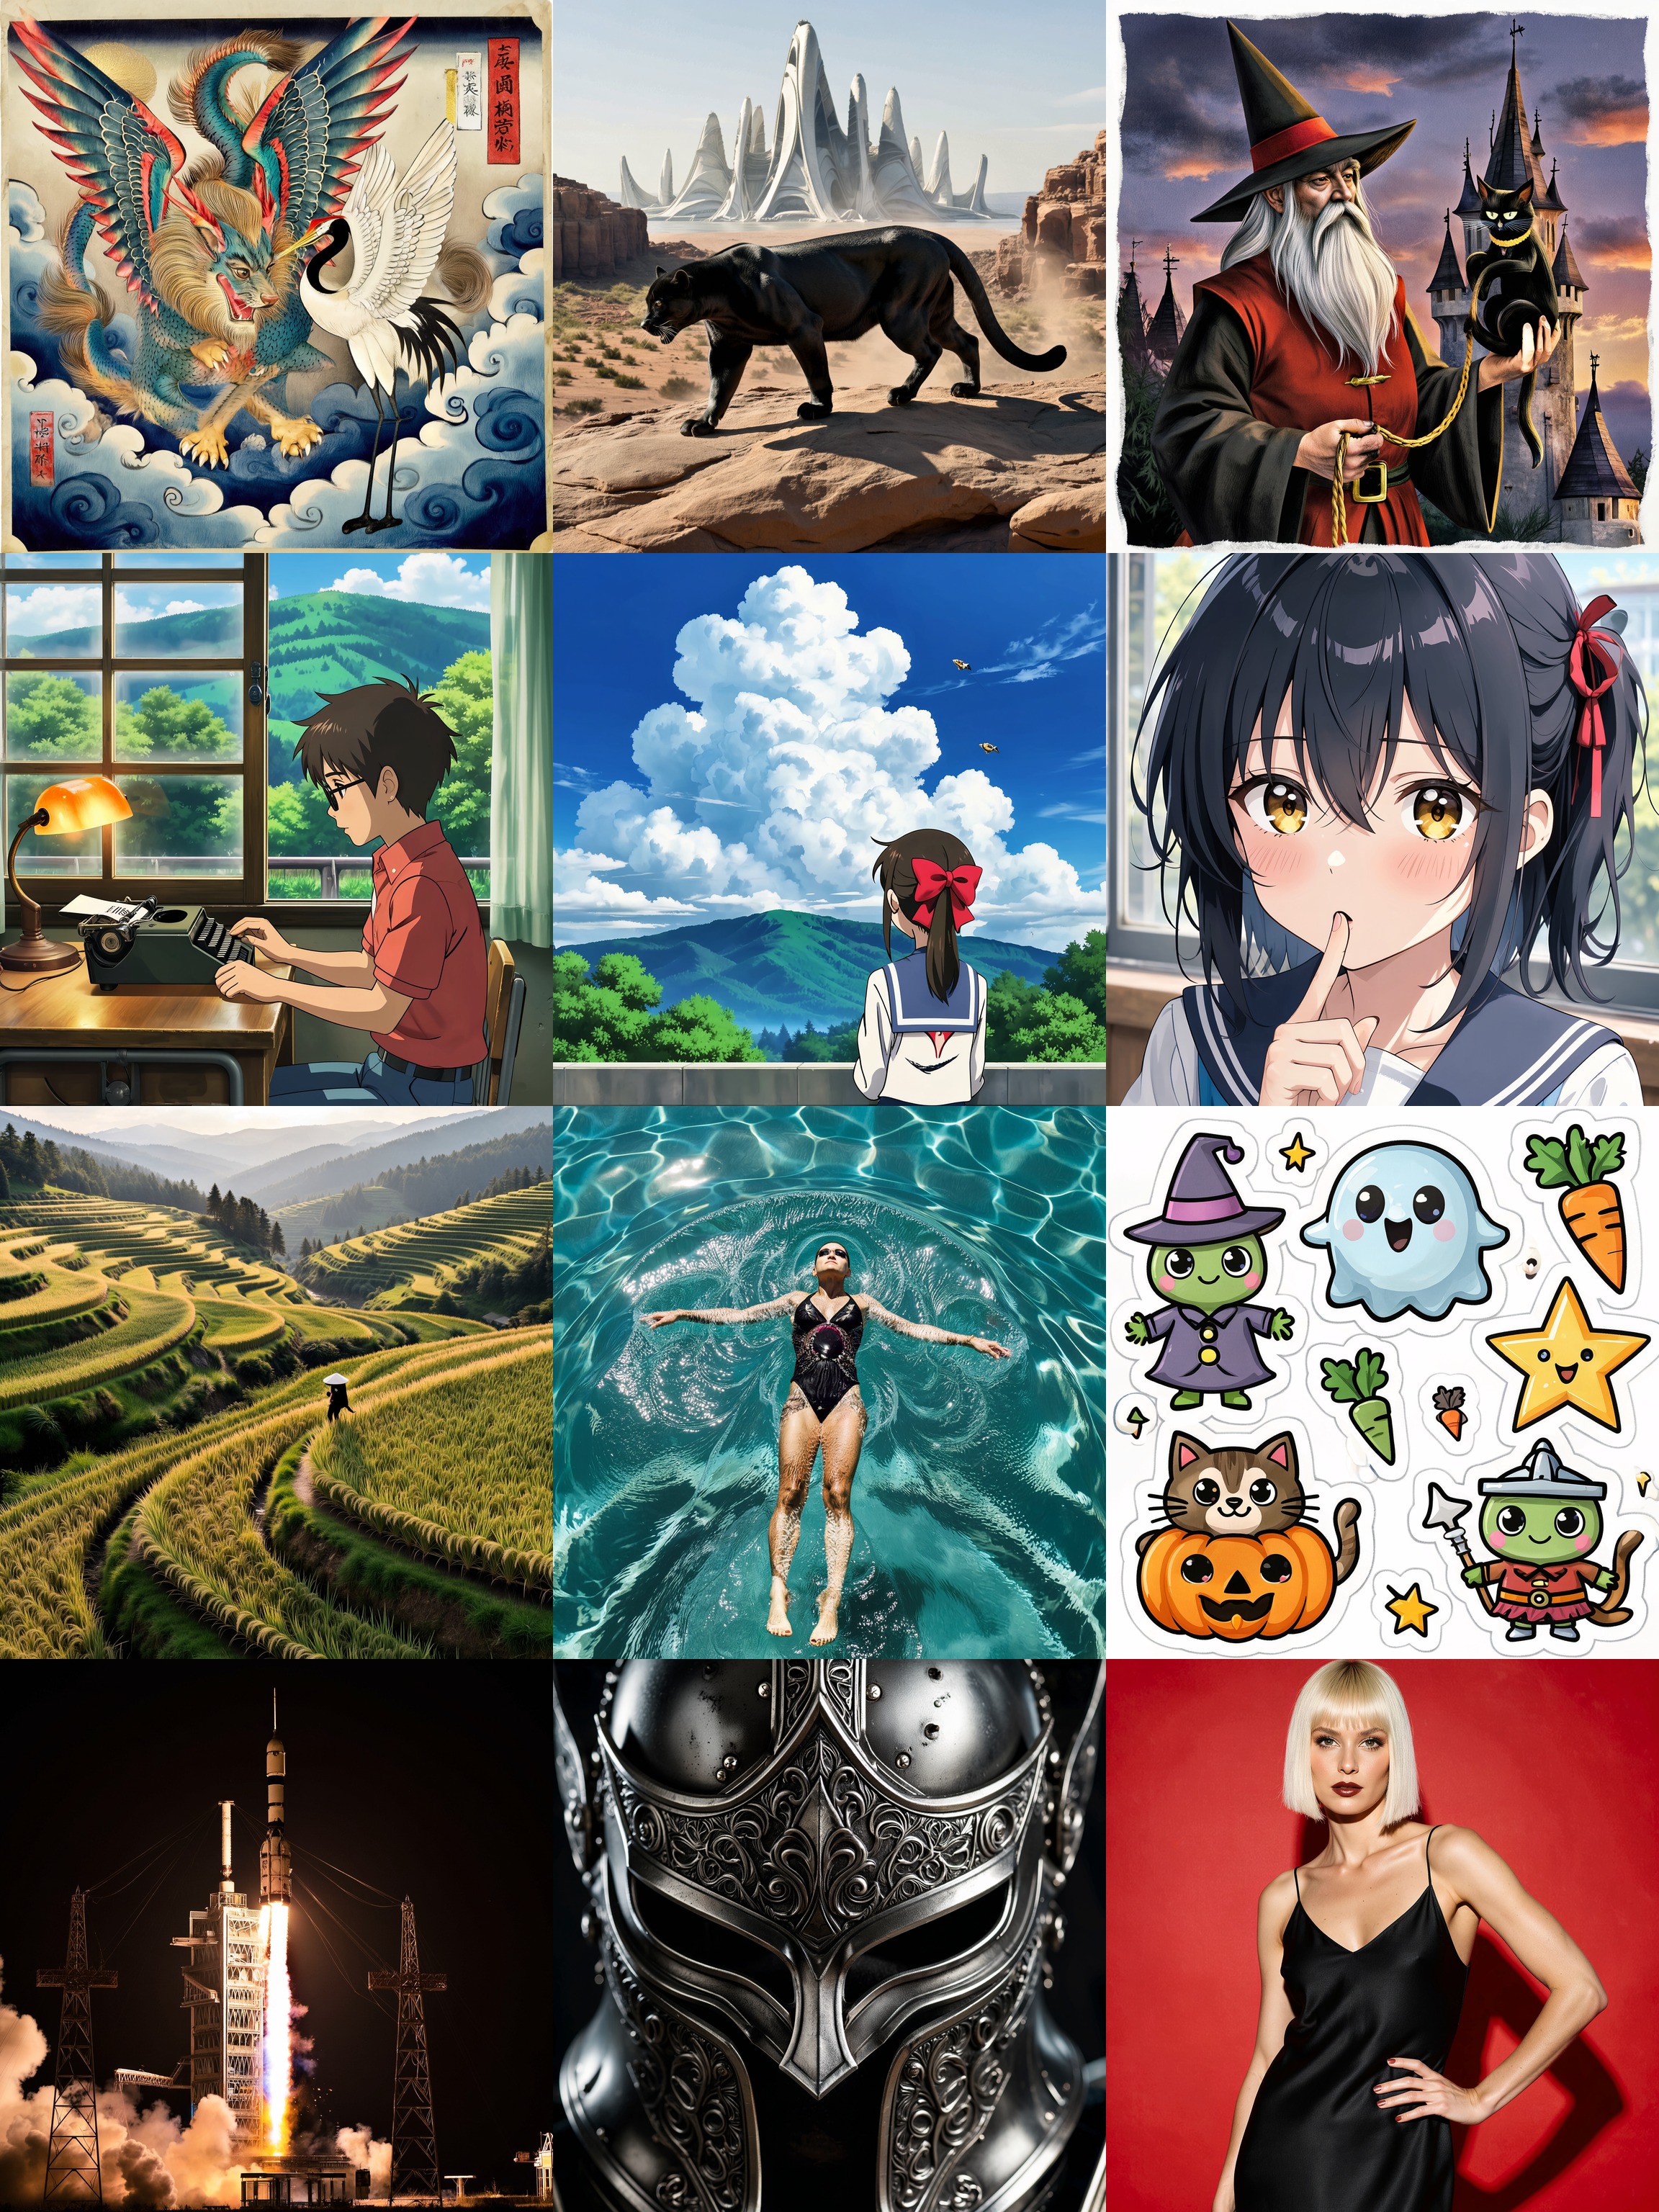
Borrador de 2 pasos más el pase Regenerate-2K a sigma 0.7, los mismos doce prompts.
La VRAM no cambia: el LoRA se fusiona al cargar, así que el conjunto bf16 sigue necesitando unos 83 GB sin el ampliador de prompts, o unos 76 GB con el offload de componentes de ComfyUI.
Disponibilidad
- LoRA, flujo de trabajo y cuadrículas de comparación: akhaliq/p-h3-image-pdmd-2step
- Space de demostración: akhaliq/p-h3-image-2step
- Modelo base: PrunaAI/P-H3-Image, archivos de ComfyUI en P-H3-Image-Comfy
- Método y artículo: PDMD, arXiv 2609.35768
Comentarios
Inicia sesión con GitHub para unirte a la conversación.