Viggle Remake: regraba cualquier video con dos LoRAs de H3
Viggle Remake es un par abierto de LoRAs de MiniMax H3 para recastear o editar metraje existente: pinta de uno a cuatro fotogramas, conserva la banda sonora y ejecútalo en ComfyUI con tan solo 12 GB.
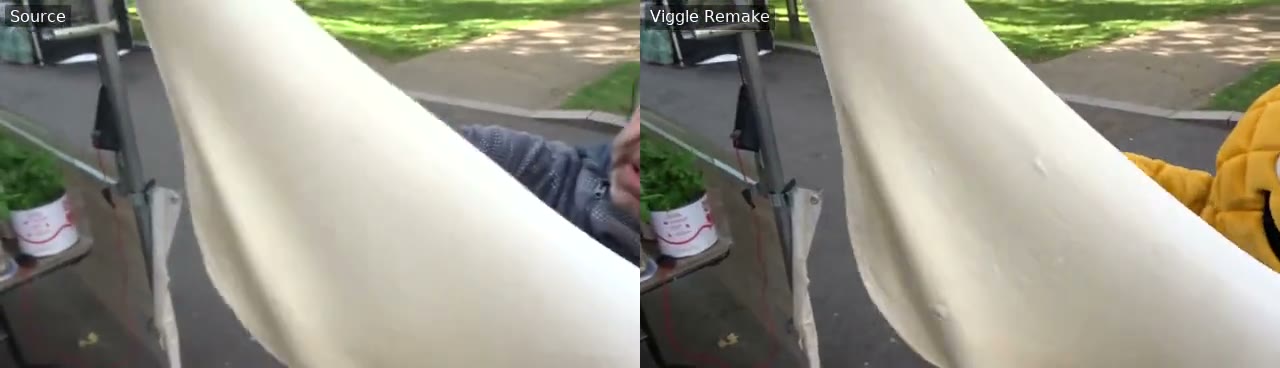
Izquierda: el clip de origen. Derecha: la misma toma con la mascota de piña recasteada, sin tocar el movimiento, la cámara ni el tiempo.
Viggle lleva tiempo construyendo en esta dirección desde Viggle-Animate a finales de agosto, que reemplazaba a un personaje en una toma a partir de un único fotograma repintado sobre un finetune de H3 ref2va muy destilado. Remake es lo que la ficha del modelo llama el "Viggle-Animate v2" que se anticipó allí, y avanza en dos sentidos: es una LoRA sobre el transformer H3 estándar en lugar de un finetune, y edita más que personas.
Dos modos
Ambos modos toman el clip de origen más de una a cuatro imágenes de referencia, llamadas <Picture 1> a <Picture 4> en el prompt. Esas referencias las pintas tú, ya sea encima de fotogramas extraídos del clip o desde cero, y cada una puede fijarse al fotograma de origen desde el que se pintó.
swapreemplaza personas y personajes, uno o varios a la vez.edithace el resto: reemplazar, eliminar o insertar objetos, cambiar el fondo, el clima o la luz.
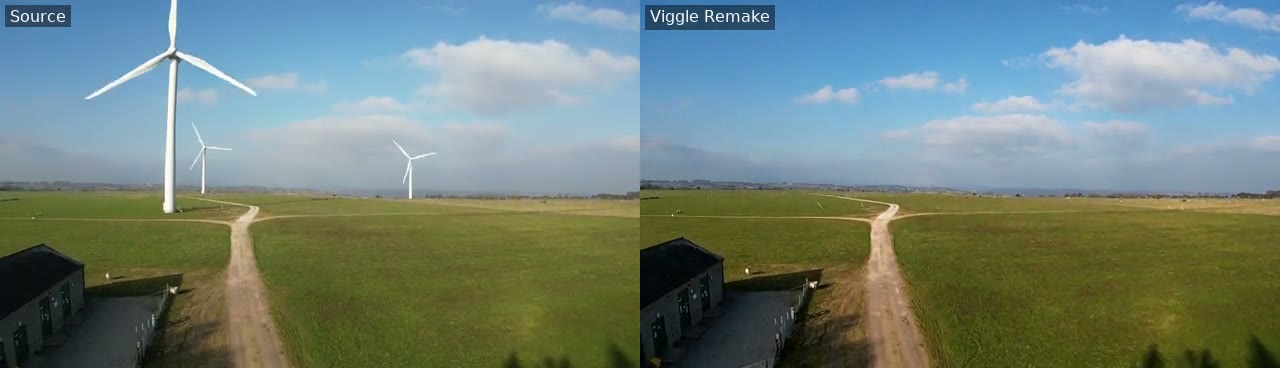
La LoRA de edición eliminando objetos de una toma mientras el movimiento de cámara y el resto del plano se mantienen intactos.
La identidad proviene de los fotogramas pintados, no de un codificador de rostros ni de una máscara de segmentación. Por eso el pipeline no necesita estimación de pose ni seguimiento, y también por eso la ficha del modelo es tajante al afirmar que no puede verificar el consentimiento: el único lugar donde se decide la identidad es la imagen que pintas.
Qué es, técnicamente
Cada modo es una LoRA PEFT, de rango 256 y alpha 256, sobre 302 capas lineales del transformer FL2VA de H3, almacenada en bf16 con cuatro tensores proj_in / proj_out en fp32. Nada más del modelo base cambia; la LoRA es un delta que se aplica al cargar. El repositorio también incluye los mismos pesos reempaquetados con los nombres de capas de ComfyUI, transformers int8 y GGUF fusionados, y un muestreador de referencia en inference/sample.py.
El sonido se arrastra en lugar de generarse. La salida conserva la banda sonora del clip de origen, así que una fuente silenciosa da un resultado silencioso, y la codificación de audio se rellena al final porque la codificación de audio estándar de ComfyUI recorta la pista a bloques completos de 800 muestras por ambos extremos, desplazándola hasta 400 muestras respecto a la imagen.
La ruta de ComfyUI
ComfyUI ejecuta H3 de forma nativa, así que el paquete de nodos solo cubre las cuatro cosas que los nodos estándar hacen de forma distinta. Añade tres nodos, probados con ComfyUI 0.42.0:
- Viggle Remake Conditioning, que recibe los fotogramas de origen, el audio, hasta cuatro referencias, los fotogramas fijados y el prompt.
- Viggle Remake Keyframe Until, que convierte las referencias fijadas en keyframes hasta una fracción determinada del rango muestreado.
- Viggle Remake Noise, que reproduce el ruido inicial del muestreador de referencia para una semilla.
Por lo demás, el grafo es estándar: LoraLoaderBypassModelOnly, BasicGuider, KSamplerSelect con euler, ManualSigmas, SamplerCustomAdvanced, dos decodificaciones VAE y Create Video a 24 fps.
Hay un ajuste que merece repetirse porque cambia la salida y no la velocidad. El LoraLoaderModelOnly simple fusiona la LoRA en los pesos bf16, y en bf16 gran parte de la actualización se redondea y desaparece: el proyecto mide que solo sobrevive entre el 37 y el 73 por ciento de ella en las capas de atención y MLP, y el render fusionado del ejemplo de swap es un 7 por ciento menos nítido (21.2 dB frente a 24.7 dB). LoraLoaderBypassModelOnly mantiene la LoRA como una rama separada a cambio de entre un 2 y un 3 por ciento más de tiempo por render.
| swap | edit | |
|---|---|---|
| LoRA | viggle_remake_swap_comfyui.safetensors | viggle_remake_edit_comfyui.safetensors |
| ManualSigmas | 1.0, 0.990476, 0.965243, 0.923077, 0.8, 0.631579, 0.0 | 1.0, 0.983607, 0.96, 0.923077, 0.857143, 0.705882, 0.0 |
Tarjetas más pequeñas: int8 y GGUF
La ruta en bf16 pide una tarjeta de 80 GB y unos 144 GB de modelo base. Por debajo de eso, cada modo se distribuye como un único archivo de transformer con la LoRA ya fusionada en fp32 y cuantizada, que reemplaza tanto al modelo de difusión base como al cargador de LoRA en el grafo.
| archivo | tamaño | cargador |
|---|---|---|
int8/viggle_remake_{swap,edit}_pruned_int8_convrot.safetensors | 21.0 GB | Cargar modelo de difusión (core) |
gguf/*-Q8_0.gguf | 22.3 GB | Unet Loader (GGUF) |
gguf/*-Q6_K.gguf | 17.6 GB | Unet Loader (GGUF) |
gguf/*-Q4_K_M.gguf | 14.3 GB | Unet Loader (GGUF) |
La tabla de tarjetas del proyecto, medida con el ejemplo de edit a 226 fotogramas y dos referencias fijadas:
- 12 GB: Q4_K_M o Q8_0 con
--reserve-vram 8; int8 solo ejecuta 124 fotogramas. - 16 GB: int8 a 832x480; Q4_K_M o Q6_K con
--reserve-vram 6; a 1280x736, Q4_K_M con--reserve-vram 10y 124 fotogramas. - 24 GB: int8 o Q4_K_M a 832x480; Q4_K_M o Q8_0 a 1280x736 con
--reserve-vram 20. - 32 a 80 GB: int8 o Q8_0 con holgura a 832x480; a 1280x736 el archivo int8 se queda sin memoria a 226 fotogramas en tarjetas de 48 y 80 GB, mientras que Q8_0 cabe en 24 GB con una reserva.
Calidad frente a la referencia bf16 más LoRA, medida como PSNR en todos los fotogramas: int8 obtiene 27.2 dB en swap y 46.8 dB en edit, Q8_0 26.9 y 49.8, Q6_K 24.6 y 44.6, Q4_K_M 20.6 y 38.3. La columna de swap es la ruidosa: redondear los mismos pesos bf16 de una segunda forma ligeramente distinta ya desplaza ese render a 29.6 dB, así que unos pocos dB ahí no constituyen un ranking de formatos.
Velocidad
En una B200 a 832x480 con 226 fotogramas y dos referencias fijadas, ComfyUI tarda unos 95 segundos por render una vez cargados los modelos, aproximadamente 13.5 segundos por paso a lo largo de seis pasos, frente a unos 58 segundos con sample.py. Un primer render que incluye la carga tarda entre 2.5 y 3 minutos. A 1280x736 un paso cuesta entre 64 y 72 segundos y un render entre 510 y 585 segundos. El proyecto solo midió B200 y así lo indica; las tarjetas de consumo serán más lentas.
Límites
- Un render cubre una ventana de 90 a 345 fotogramas (
17n+5, 24 fps); el proyecto recomienda hasta 294, unos 12 segundos, y los videos más largos se convierten en ventanas que el servidor MCP corta en los límites de cada toma. - El prompt de seis secciones de H3 es requerido, y sus marcas de tiempo deben coincidir con el número de fotogramas.
- Los fotogramas pintados deciden la identidad y el aspecto; los fotogramas fijados también fijan la composición en ese fotograma.
- Fallos conocidos: un personaje no humanoide en una toma larga continua, pequeños artefactos en el detalle fino, y tomas que se desfasan en el tiempo cuando se renderiza un clip de varias tomas sin fijaciones.
El ejemplo de swap que incluyen los flujos de trabajo de ComfyUI: 226 fotogramas, con dos referencias fijadas en los fotogramas 12 y 184.
El ejemplo de edit: las turbinas salen del plano mientras el paneo y la luz se mantienen.
Disponibilidad
Los pesos, las LoRAs, los archivos int8 y GGUF, el paquete de nodos y los flujos de trabajo están en Hugging Face, junto con COMFYUI.md, PROMPTING.md y MODIFICATIONS.md. El repositorio completo ocupa unos 210 GB, así que la guía de ComfyUI descarga solo los subconjuntos comfyui/ y examples/inputs/. Se publicó el 4 de noviembre de 2026 y @viggleai lo anunció ese mismo día; la ficha no incluye ningún benchmark frente a otros modelos de edición, por lo que las cifras anteriores son las del propio proyecto.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.