P-H3-Image lleva la generación de imágenes de MiniMax H3 a ComfyUI
P-H3-Image de PrunaAI genera imágenes de 8 MP en 8 pasos sin CFG y edita con hasta 8 referencias. ComfyUI añadió soporte nativo el día de su lanzamiento.
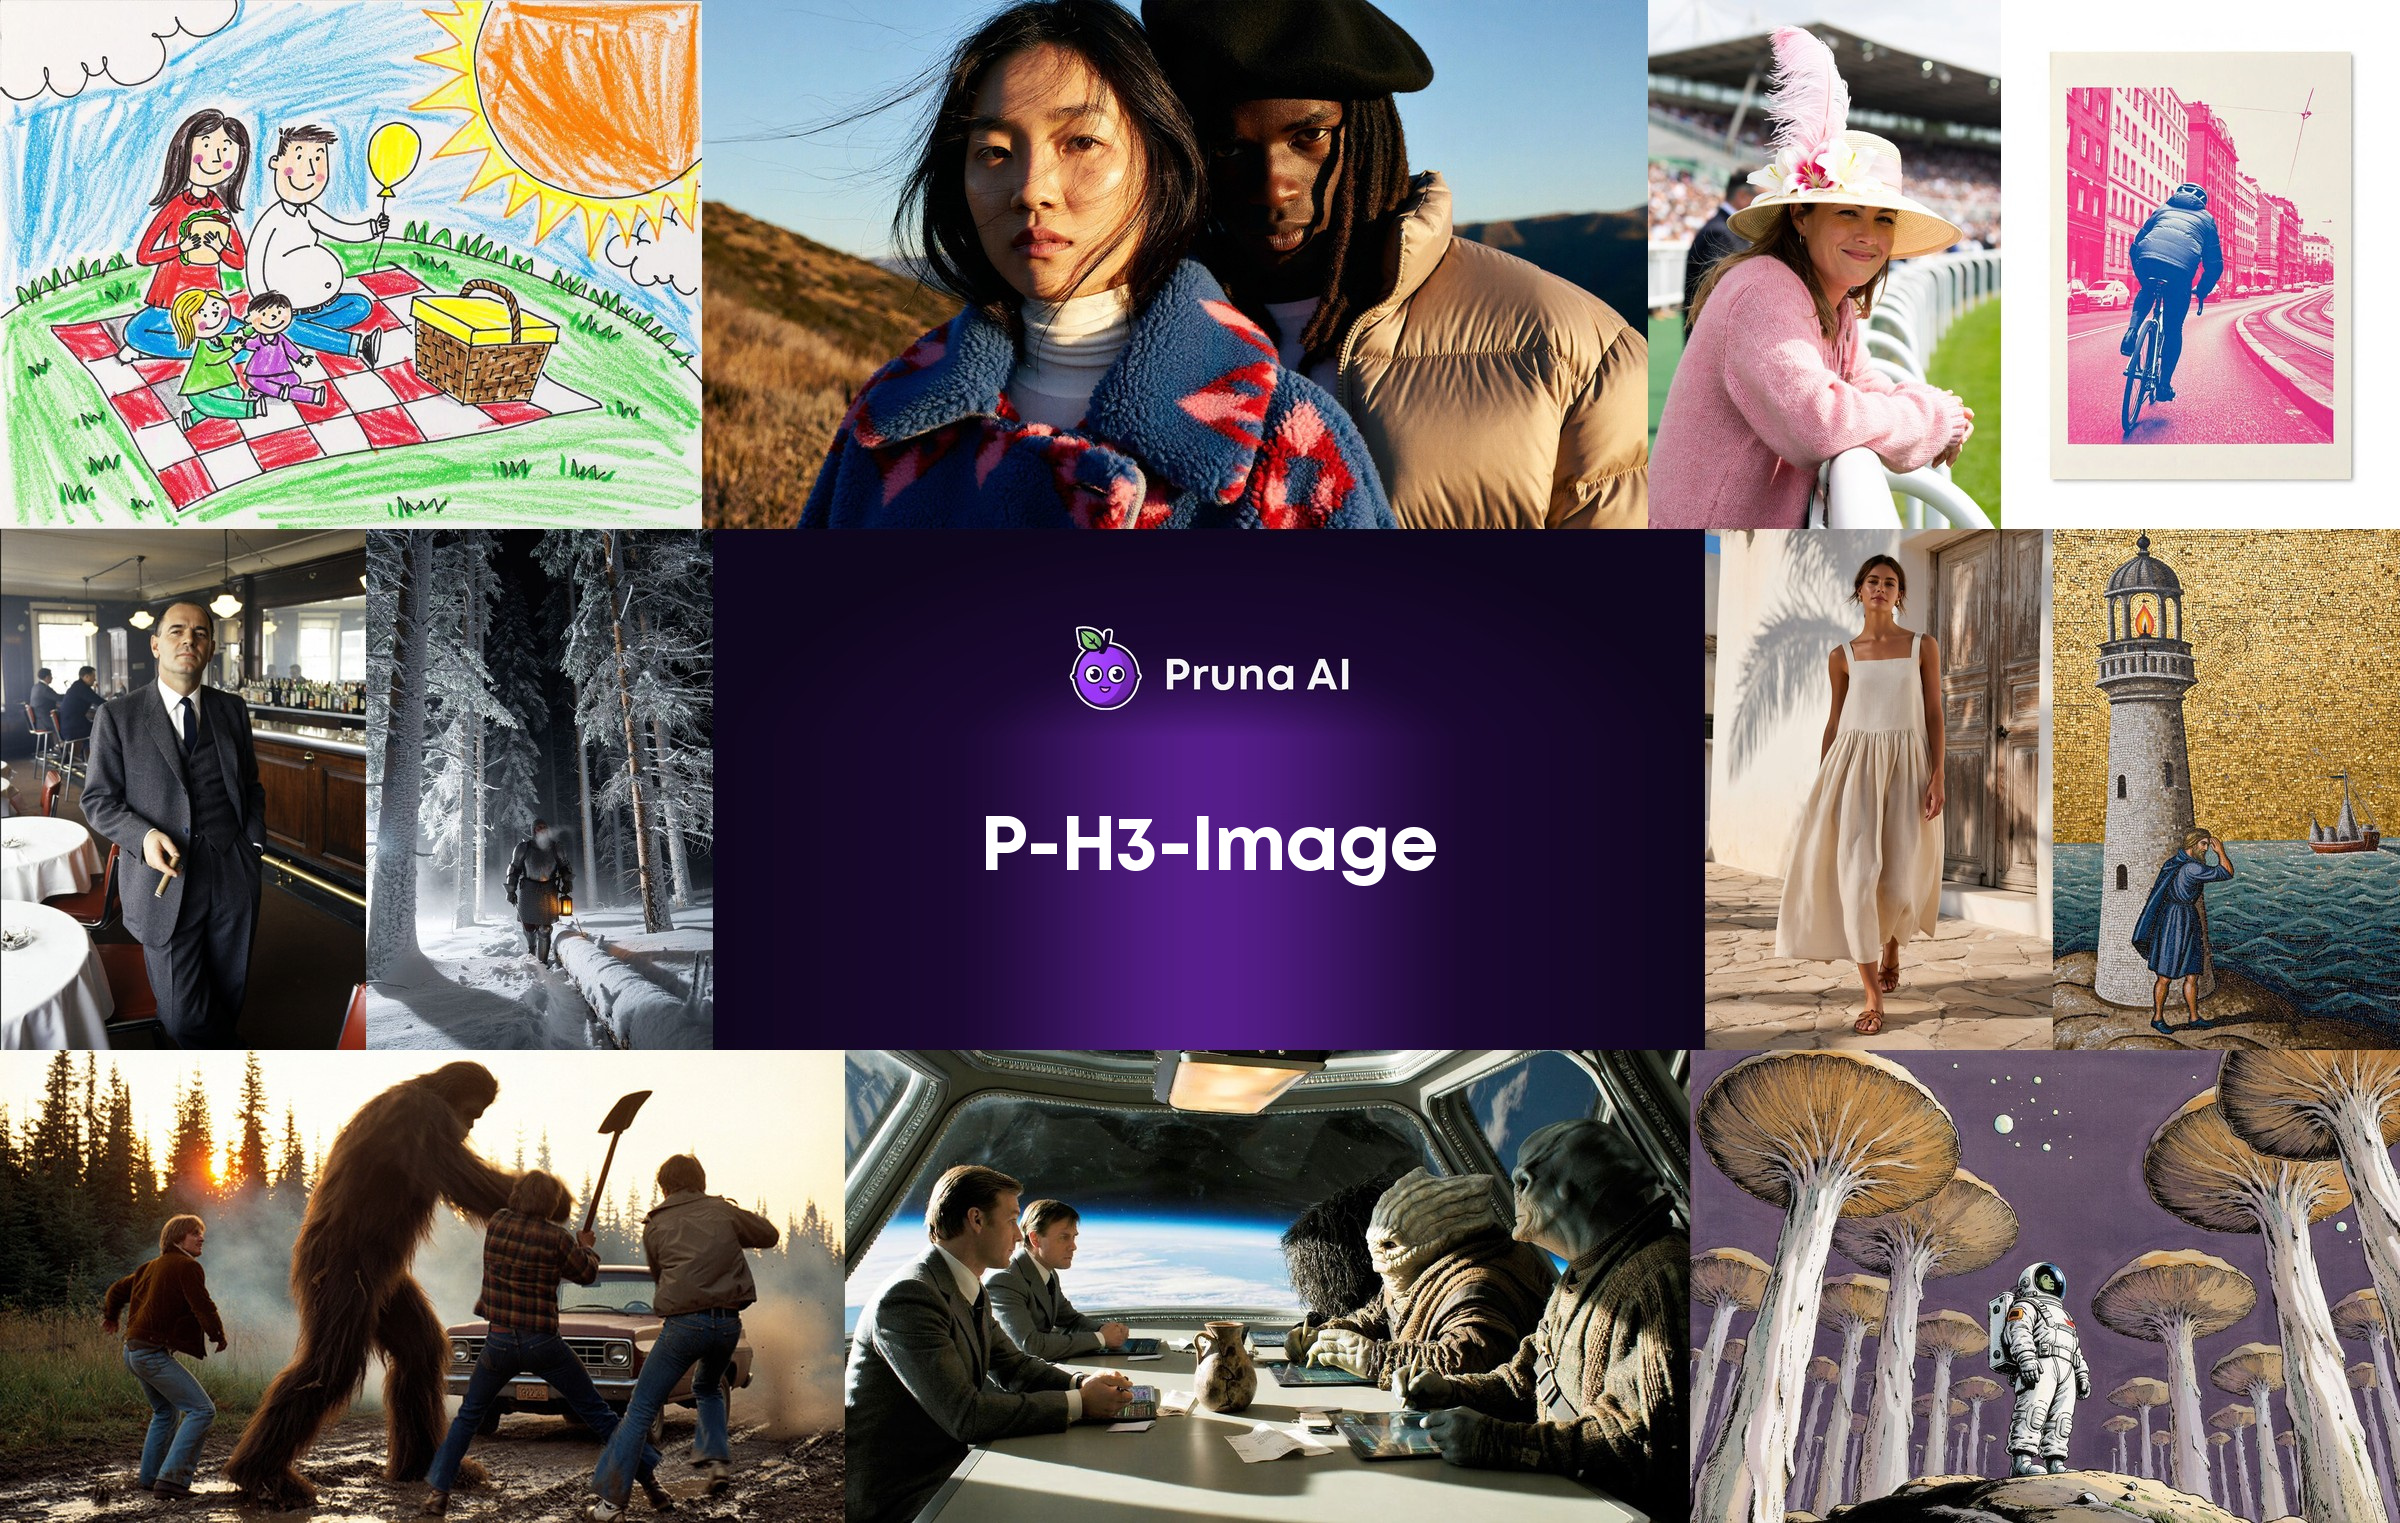
Muestras de la tarjeta oficial del modelo. La tarjeta posiciona P-H3-Image para fotorrealismo, estilos cinematográficos y editoriales, y estilos gráficos con texto corto entrecomillado.
Qué es el modelo
El lanzamiento es un transformer de 33.1B de parámetros con un codificador de texto de 4B, un VAE y un upsampler de prompts independiente, 100 GB en bf16. Es un ajuste fino de MiniMax H3 en lugar de una arquitectura nueva, así que hereda el VAE y la pila de atención de H3 y dedica su presupuesto de entrenamiento a imágenes fijas en vez de a vídeo.
| Tareas | Texto a imagen y edición con 1 a 8 imágenes de entrada |
| Muestreo | 8 pasos, sin CFG ni prompt negativo |
| Resolución | 8 MP para texto a imagen, 4 u 8 MP para ediciones |
| Upsampler de prompts | Incluido, activado por defecto, basado en Qwen3.5-9B |
| Pesos | Transformer de 33.1B, codificador de texto de 4B, VAE, upsampler de prompts |
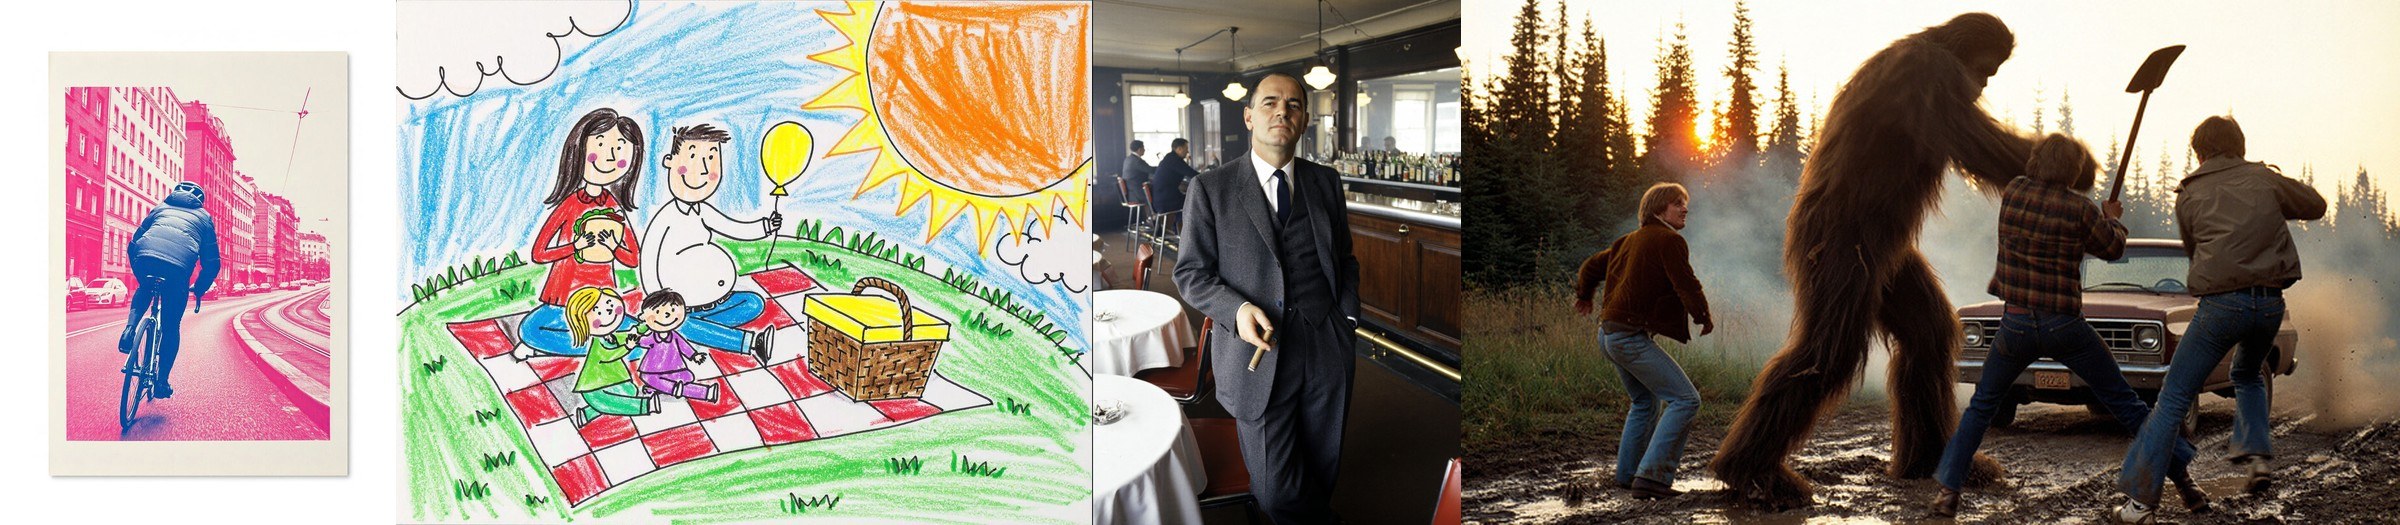
Cobertura de estilos de la tarjeta del modelo, renderizada a 8 MP.
Soporte nativo de ComfyUI el día del lanzamiento
ComfyUI fusionó el soporte de PH3Image en PR 17506 (CORE-697) el 2026-11-03, el mismo día en que PrunaAI publicó la revisión update-for-launch de los pesos. Las dos plantillas oficiales de Comfy-Org/workflow_templates incluyen minComfyUIVersion: 0.44.0, por lo que cualquier versión anterior a ese lanzamiento no puede abrirlas.
El grafo usa solo nodos integrados: Cargar modelo de difusión carga el checkpoint, MiniMax H3 Sigma Shift se ejecuta a 1.0 para ambos shifts, Cargar CLIP con tipo minimax carga el codificador de texto, y el nuevo nodo p-h3-image Conditioning convierte el prompt y cualquier imagen en acondicionamiento y un latent de imagen. El muestreo es Sigmas manuales sobre la rejilla de 8 pasos hacia Muestreador personalizado avanzado con Guía básica y euler, sin CFG y sin prompt negativo. El LoRA opcional se carga mediante Cargar LoRA configurado solo para el modelo.
Qué archivos descargar
PrunaAI/P-H3-Image-Comfy replica los pesos en los formatos nativos de ComfyUI, y las precisiones se pueden mezclar libremente siempre que cada componente provenga de una misma fila. MiniMax H3 por sí solo son 143 GB de pesos; el conjunto P-H3-Image más pequeño es una descarga de 20 GB que alcanza un pico de 21 GB de VRAM a 8 MP.
| Componente | Carpeta | bf16 | int8 | w4a8 |
|---|---|---|---|---|
| Modelo de difusión | diffusion_models/ | 40.5 GB | 21.2 GB | 13.4 GB |
| Codificador de texto | text_encoders/ | 9.1 GB | 5.1 GB | 3.6 GB |
| Upsampler de prompts | text_encoders/ | 19.3 GB | 9.7 GB | 6.7 GB |
| VAE | vae/ | 5.6 GB | 3.1 GB | ninguno |
| Conjunto | Descarga | VRAM máxima a 8 MP |
|---|---|---|
| bf16 | 55 GB | 56 GB |
| int8 | 30 GB | 31 GB |
| w4a8 + VAE int8 | 20 GB | 21 GB |
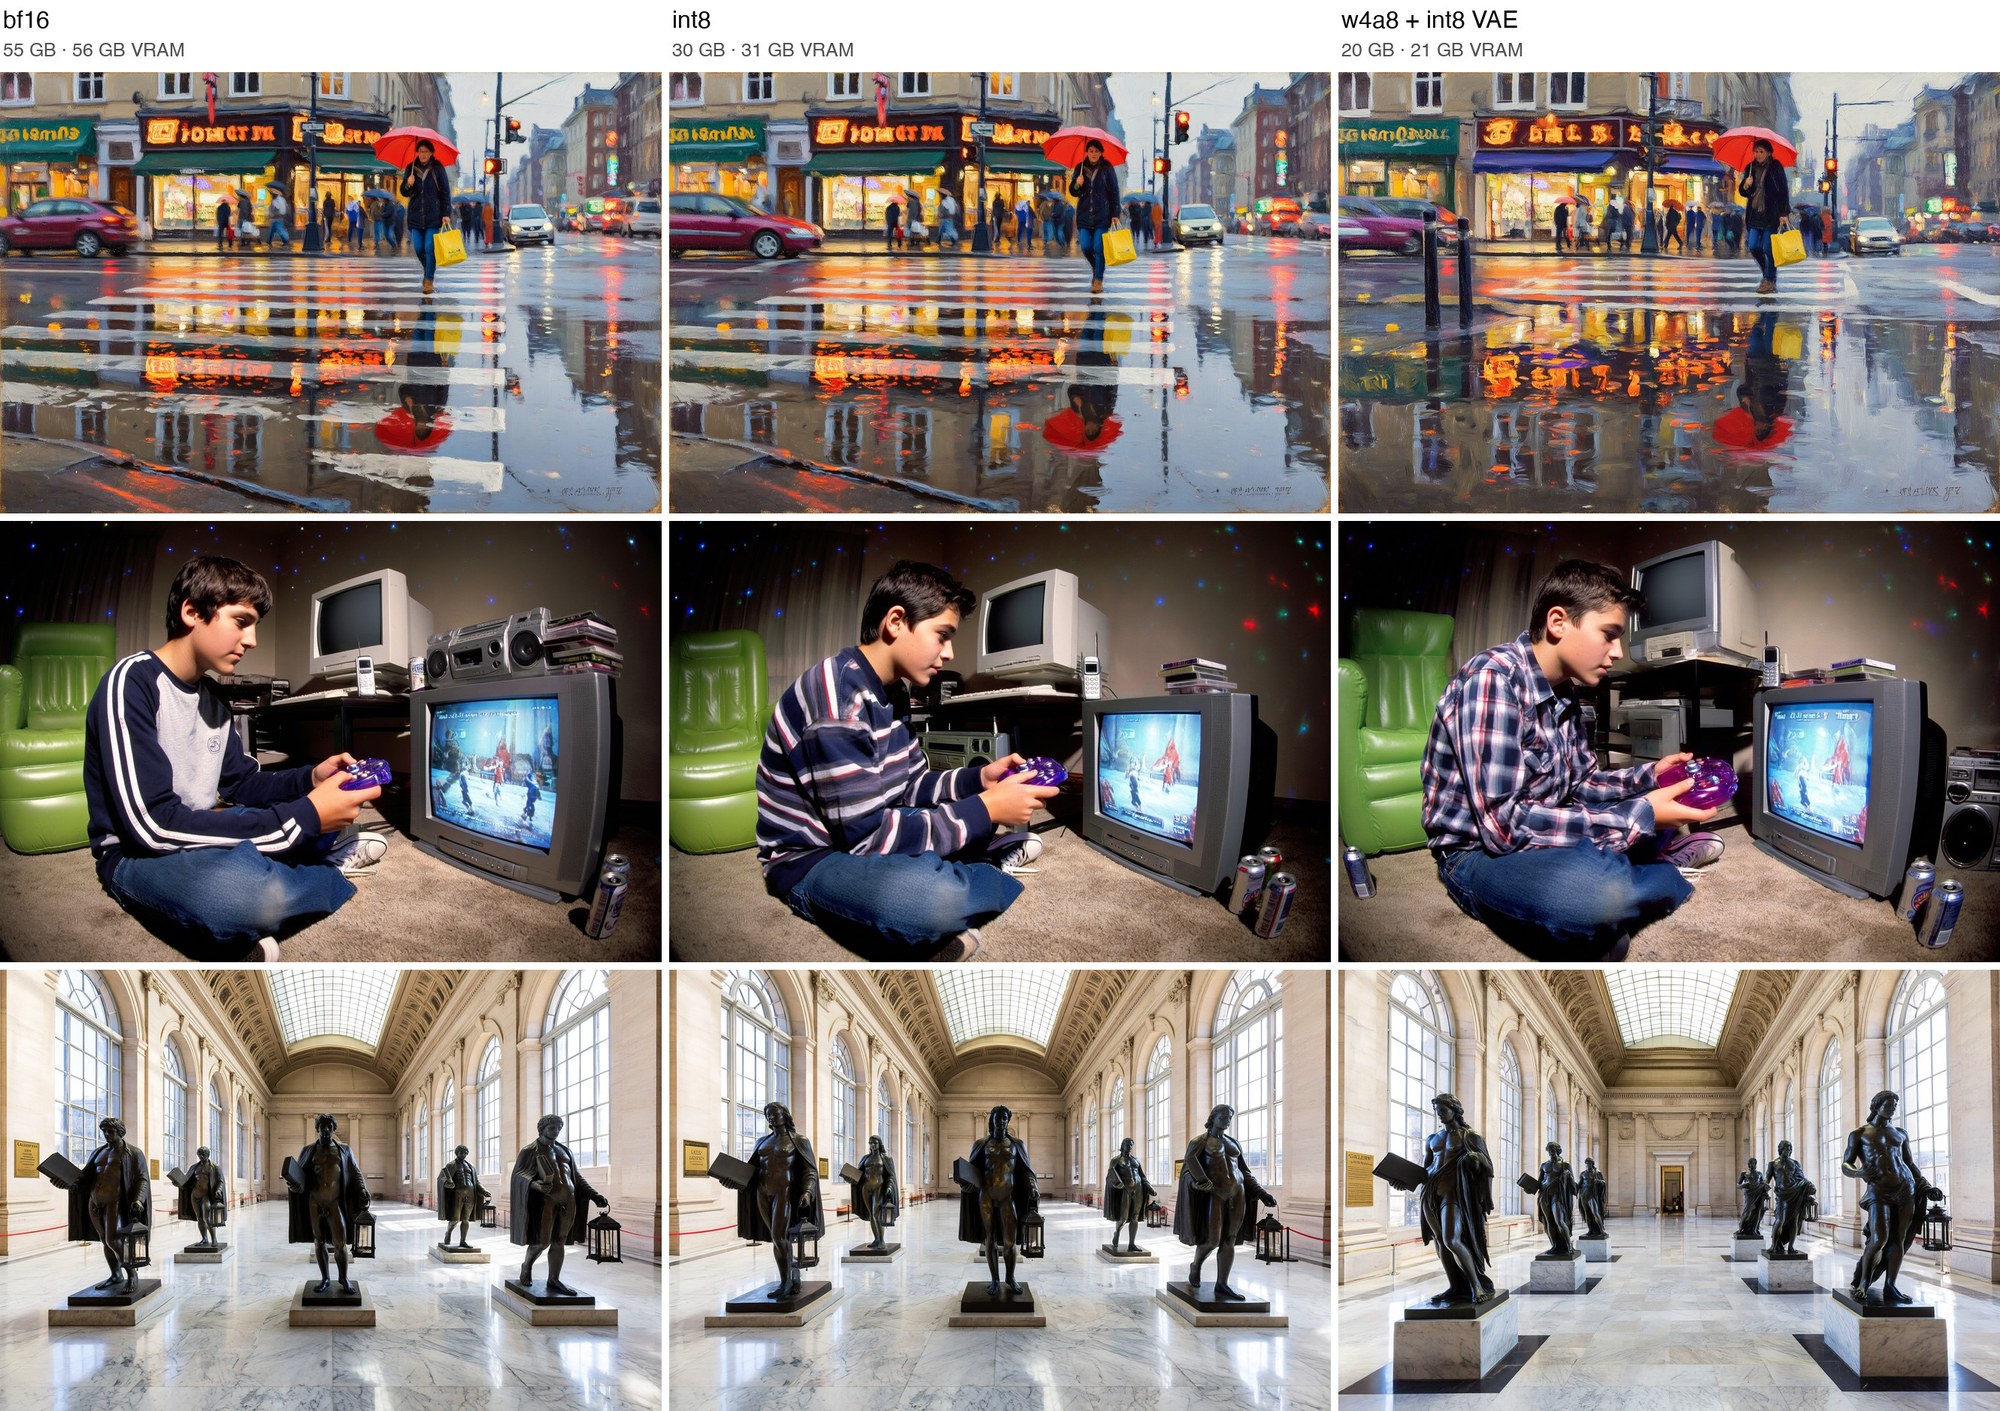
Los mismos prompts y semilla en bf16, int8 y w4a8 a 8 MP, con cada encabezado indicando su tamaño de descarga y su VRAM máxima.
Los archivos int8 se mantienen muy cerca de bf16, a menudo casi píxel por píxel. w4a8 conserva la calidad pero desplaza más detalles y a veces la composición. Ambos son formatos de cuantización propios de ComfyUI: int8 aplica una rotación de Hadamard agrupada frente a los valores atípicos y almacena escalas por fila con las activaciones cuantizadas al vuelo, mientras que w4a8 coloca pesos de 4 bits en un libro de códigos de 16 niveles con una escala FP8 por cada 16 entradas y mantiene las capas sensibles en int8. Ninguno necesita datos de calibración, y ambos se ejecutan con los kernels INT8 de comfy-kitchen para NVIDIA Ampere o superior y AMD RDNA3/4.
También hay un LoRA de 2.0 GB en loras/, que aplica el mismo comportamiento a tus propios pesos de MiniMax H3 en lugar del checkpoint completo. Dos de los cuatro flujos de trabajo del repositorio están construidos en torno a él.
El upsampler de prompts es parte del modelo
P-H3-Image renderiza mucho mejor los prompts completos y específicos que las peticiones cortas, así que todos los flujos de trabajo de ejemplo ejecutan primero el upsampler. En ComfyUI tampoco es un nodo personalizado: Cargar CLIP con tipo minimax más Generar texto con decodificación voraz, de modo que la misma petición siempre produce el mismo prompt.
Para texto a imagen, Formatear texto compone Aspect ratio: 1:1 y Request: ... en dos líneas con thinking activado. Para ediciones escribe un bloque <Picture N> por imagen, con image_1 a 1 MP y las referencias rellenadas hasta ese tamaño mediante Procesar imágenes por lotes. Un interruptor If/Else Usar upsampler de prompt configurado en false envía la petición al modelo tal cual.
El upsampler se ejecuta antes del modelo de difusión y ComfyUI lo saca de la VRAM cuando P-H3-Image necesita la memoria, y su salida se almacena en caché para que solo se vuelva a ejecutar cuando cambian la petición o las imágenes. El upsampler bf16 es el RECOMENDADO, con 19.3 GB y unos 21 GB de VRAM.
Edición con hasta ocho imágenes
Una edición toma la imagen a cambiar como image_1 más hasta siete referencias, en el mismo orden en Procesar imágenes por lotes y en el nodo de acondicionamiento, con un bloque <Picture N> para cada una en la entrada del upsampler. La petición puede nombrarlas como quiera, así que "el sombrero de la segunda foto" se resuelve con la segunda imagen. Solo se edita la imagen 1; el resto son contexto.
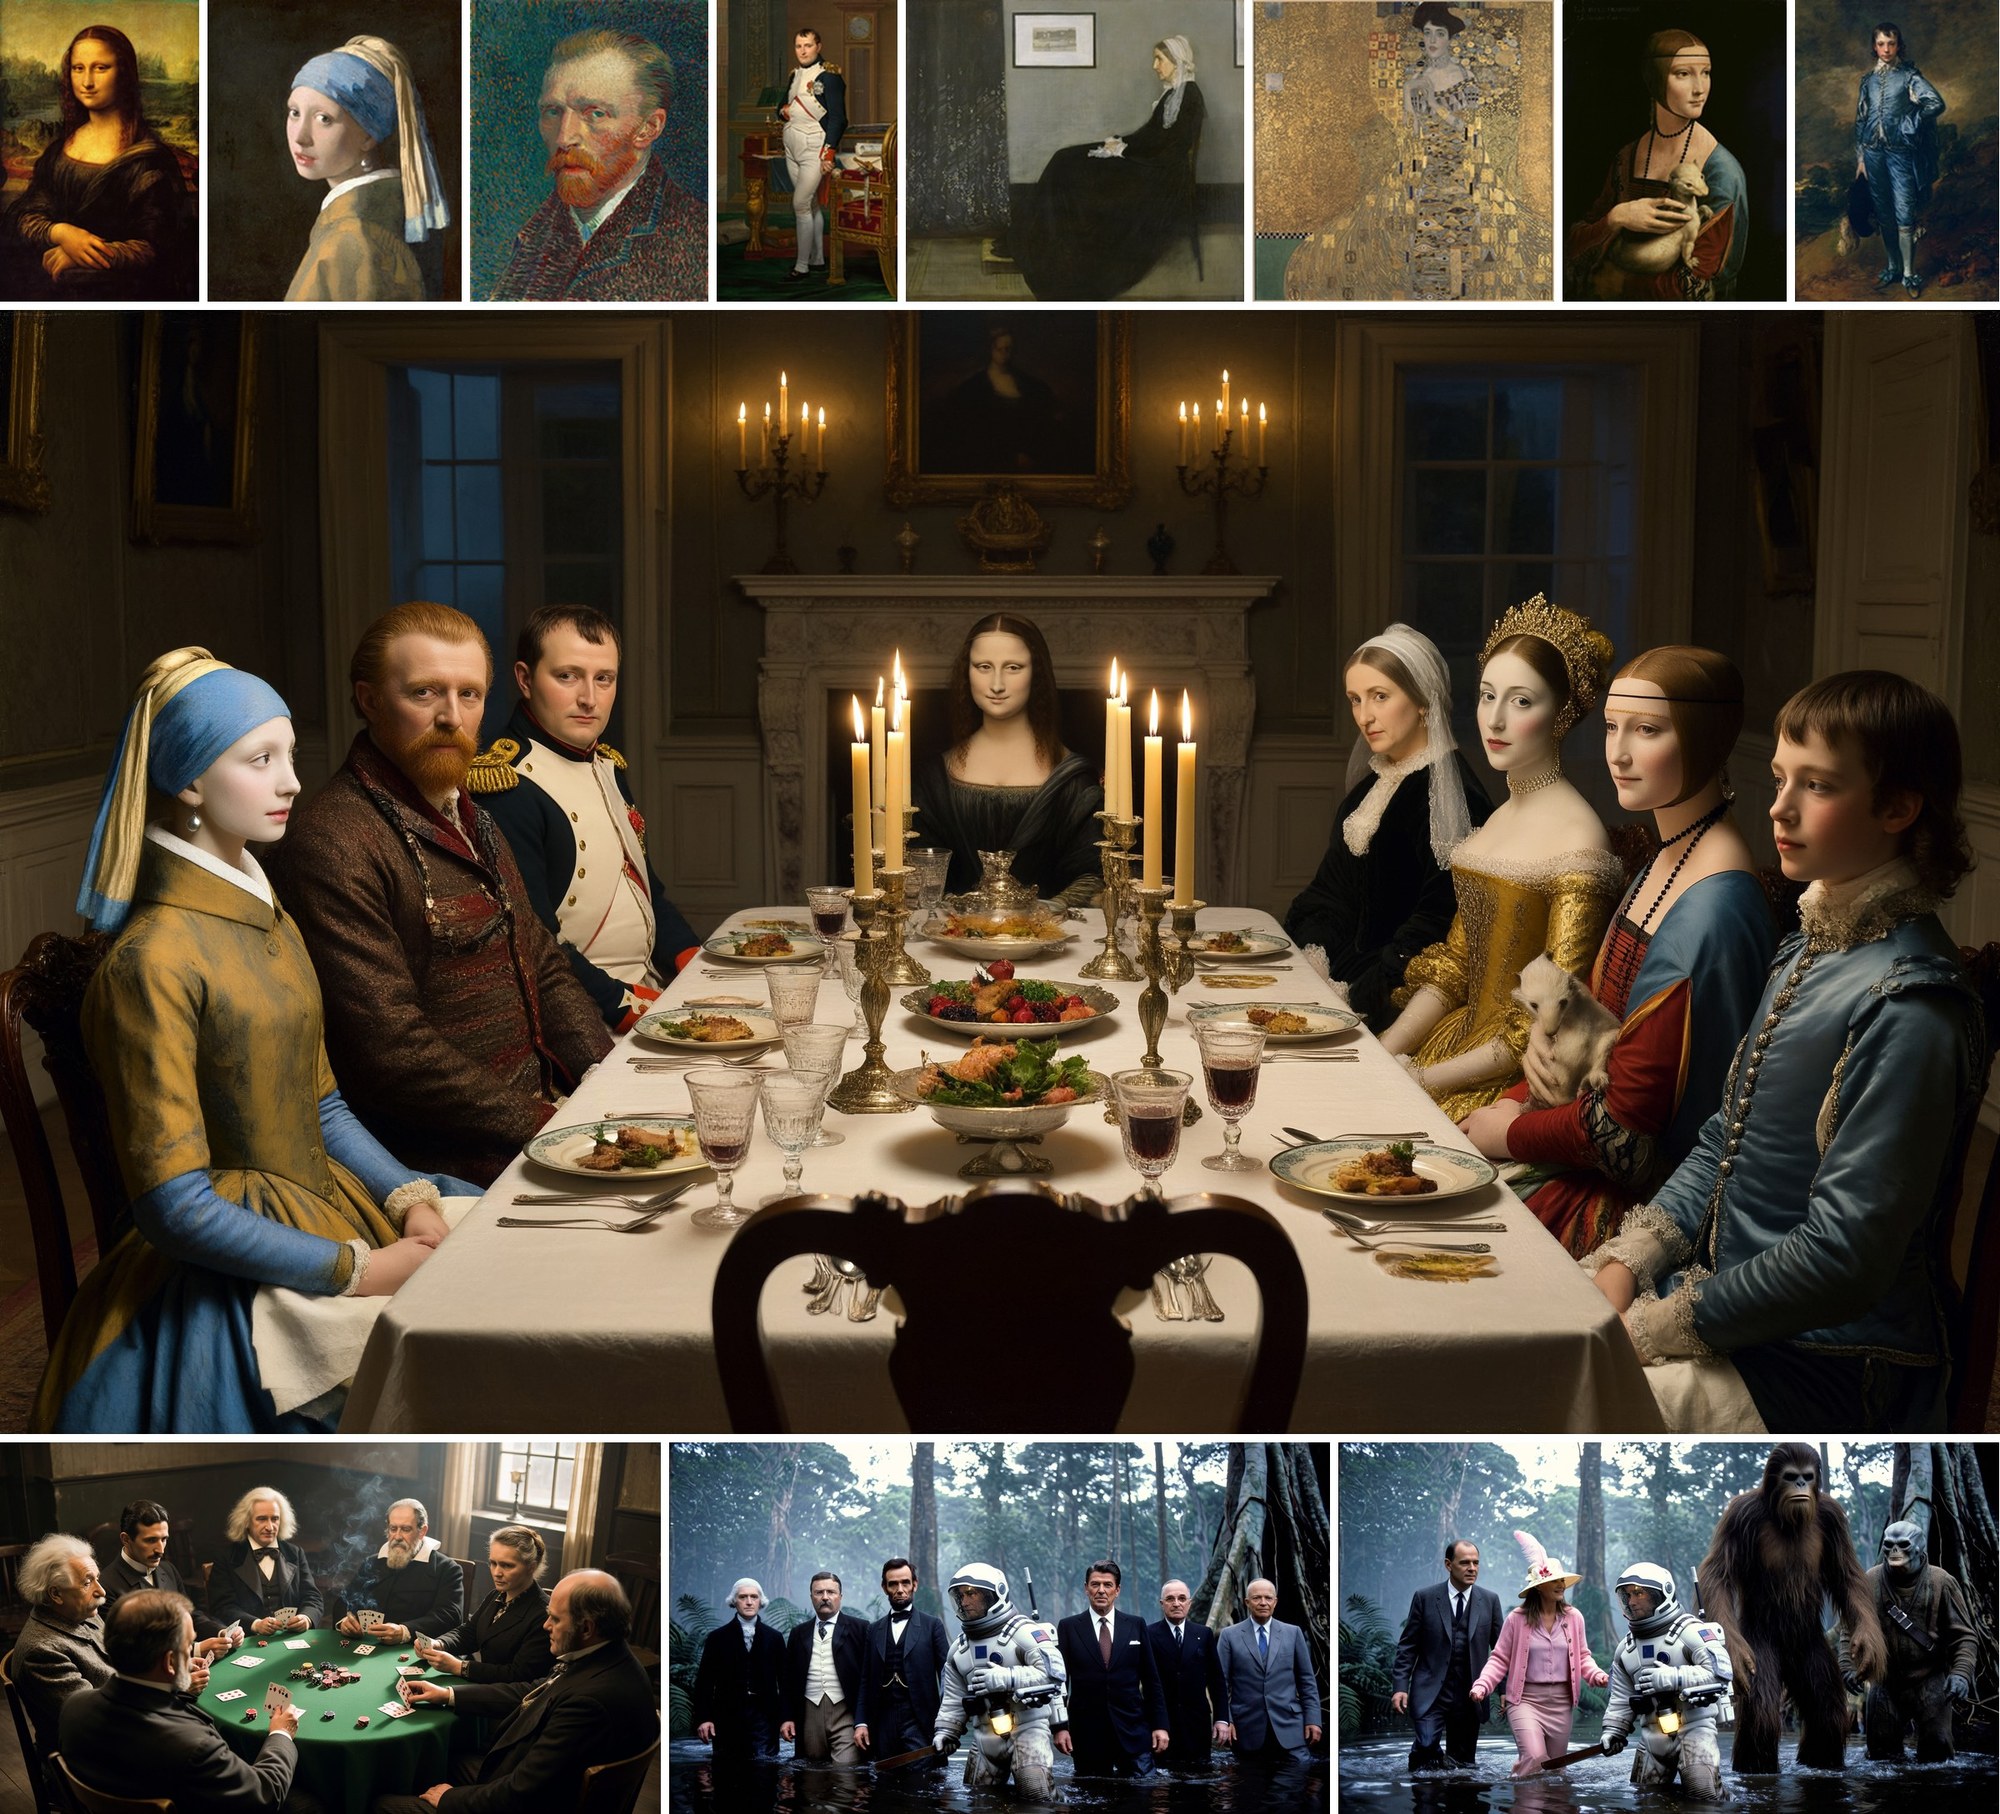
Ocho retratos de dominio público y la cena que P-H3-Image compuso a partir de ellos en una sola petición.
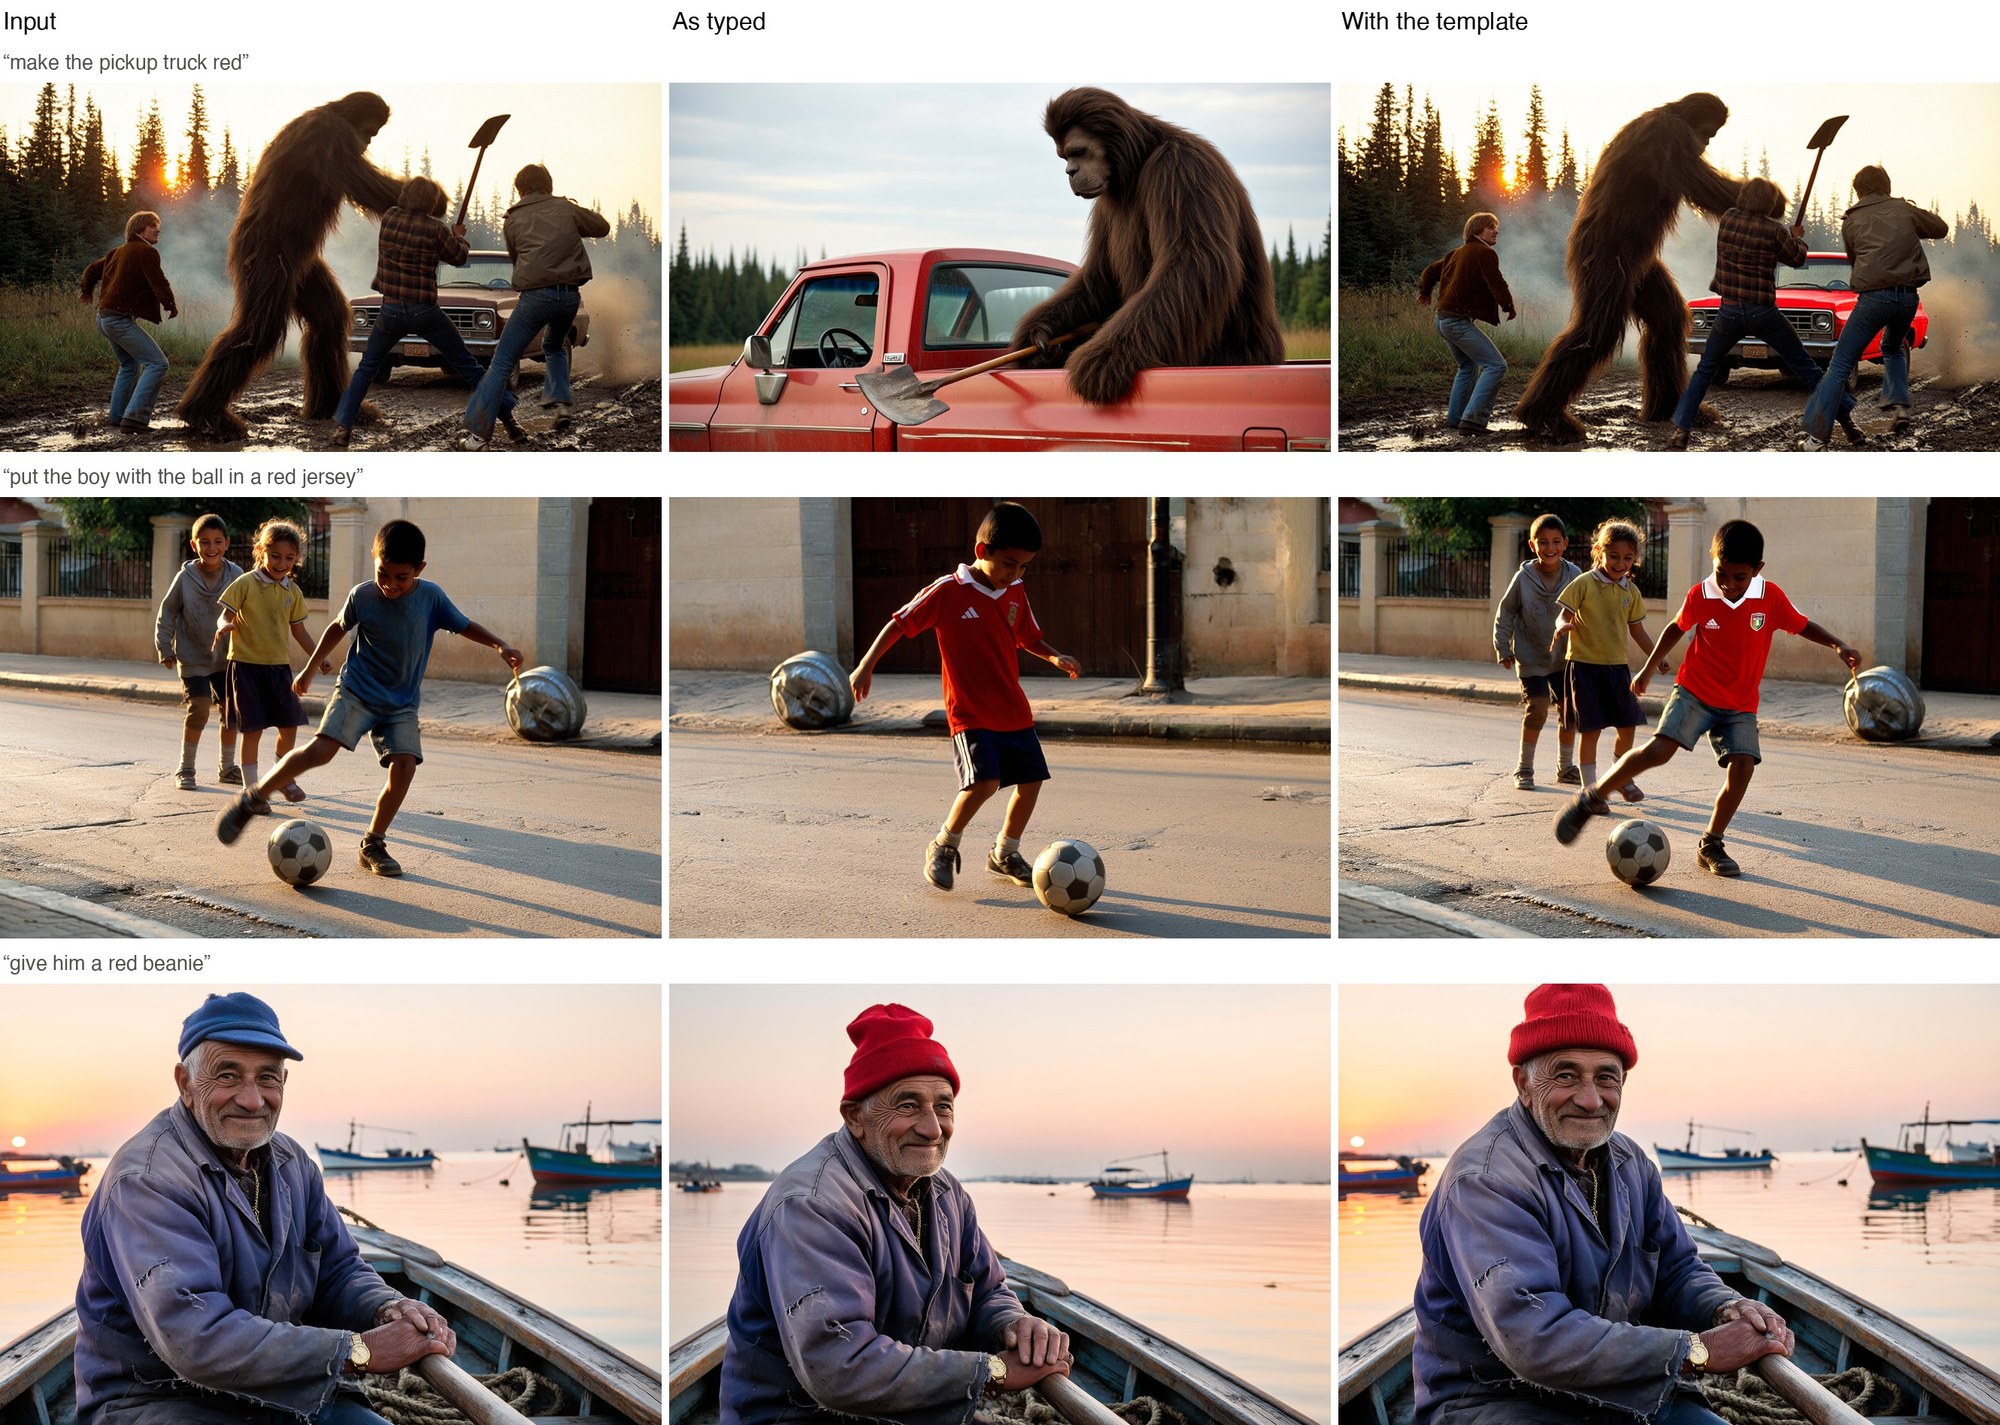
Salidas de edición de la tarjeta oficial.
8 MP es el punto de operación
El modelo está entrenado para 8 MP y la tarjeta es tajante en que 2 y 4 MP son peores, con artefactos más visibles en caras, manos y detalles pequeños. El tamaño predeterminado de texto a imagen es 2912 x 2912, y los lados se redondean a múltiplos de 32.
| Relación de aspecto | 8 MP (ancho x alto) | 4 MP, para ediciones |
|---|---|---|
| 1:1 | 2912 x 2912 | 2048 x 2048 |
| 4:3 | 3360 x 2496 | 2368 x 1760 |
| 3:4 | 2496 x 3360 | 1760 x 2368 |
| 3:2 | 3552 x 2368 | 2496 x 1664 |
| 2:3 | 2368 x 3552 | 1664 x 2496 |
| 16:9 | 3872 x 2176 | 2720 x 1536 |
| 9:16 | 2176 x 3872 | 1536 x 2720 |
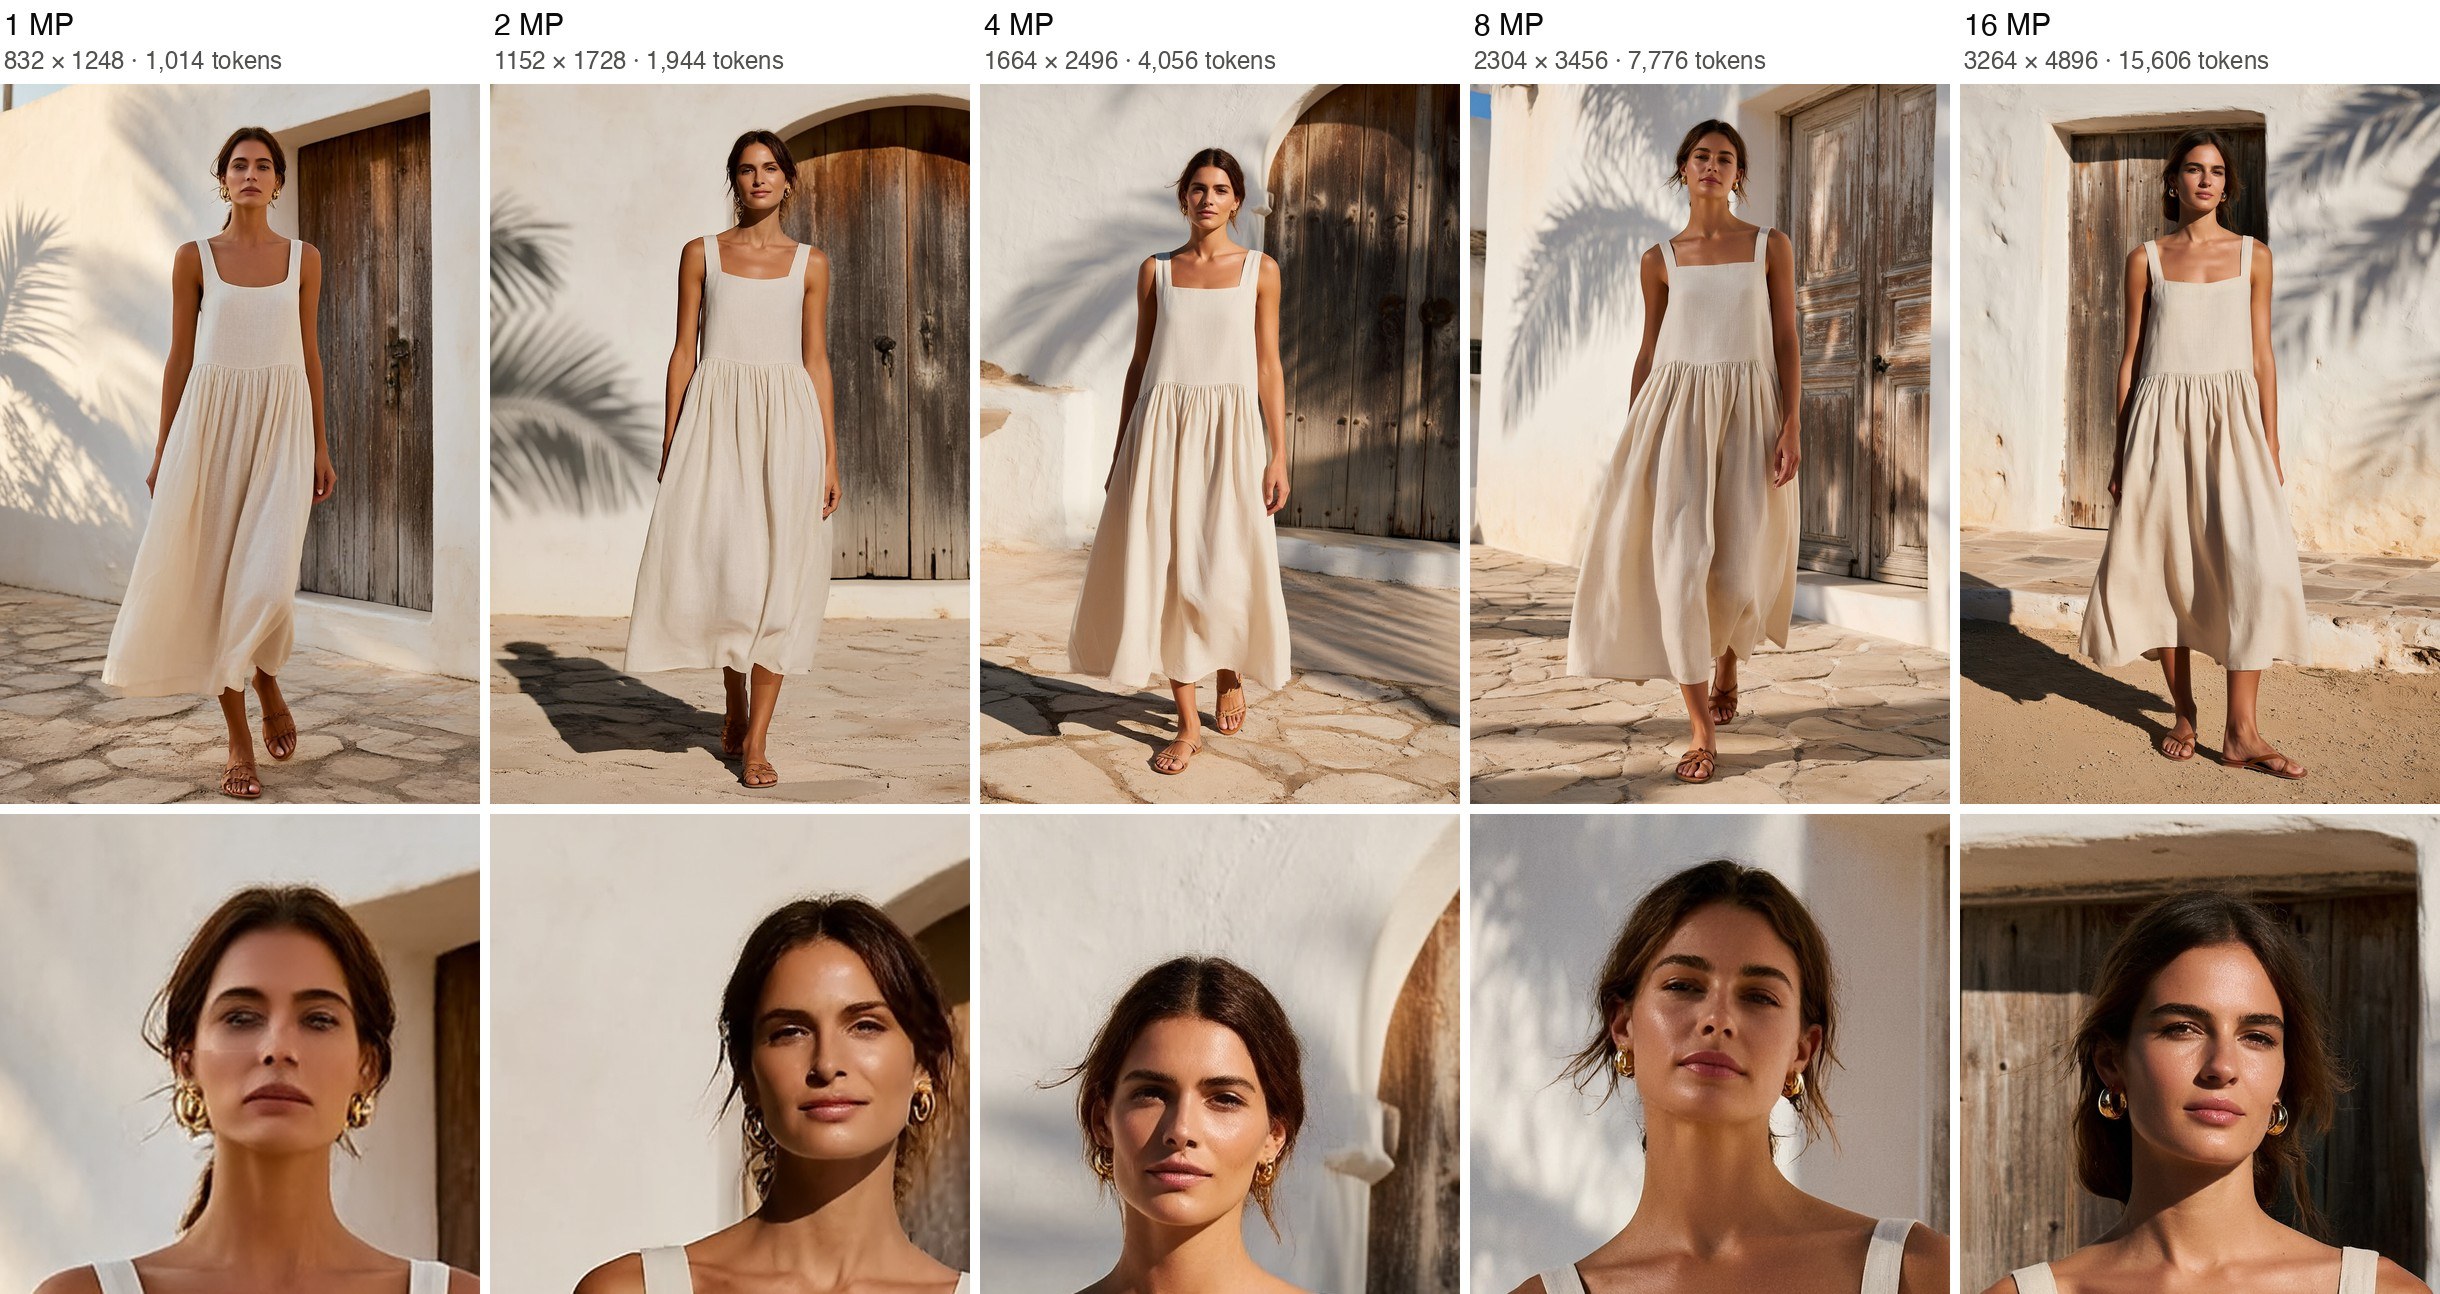
El mismo prompt y semilla de 1 a 16 MP con la cara ampliada. A 1 MP la piel es suave y cerosa; a partir de 8 MP aparecen la textura, los pelos sueltos y los pendientes.
Las ediciones sin ancho y alto explícitos se generan al tamaño de la imagen 1, escalada hasta al menos 4 MP. Pasar las dos dimensiones cambia el tamaño del lienzo, no las imágenes que contiene.
Disponibilidad
- Pesos y pipeline de diffusers: PrunaAI/P-H3-Image
- Archivos y flujos de trabajo de ComfyUI: PrunaAI/P-H3-Image-Comfy
- Demo en el navegador: PrunaAI/P-H3-Image en Hugging Face Spaces
- Soporte de ComfyUI: PR 17506, en la v0.44.0
Comentarios
Inicia sesión con GitHub para unirte a la conversación.