BluePixel-Turbo: el editor de imágenes nativo 4K en 4 pasos de vivo
vivo libera como código abierto BluePixel-Turbo, un editor FLUX.2 Klein con VAE DCAE-F64 que edita a 4K nativo en 4 pasos, con un paquete de nodos de ComfyUI de la comunidad.
 |  |
|---|---|
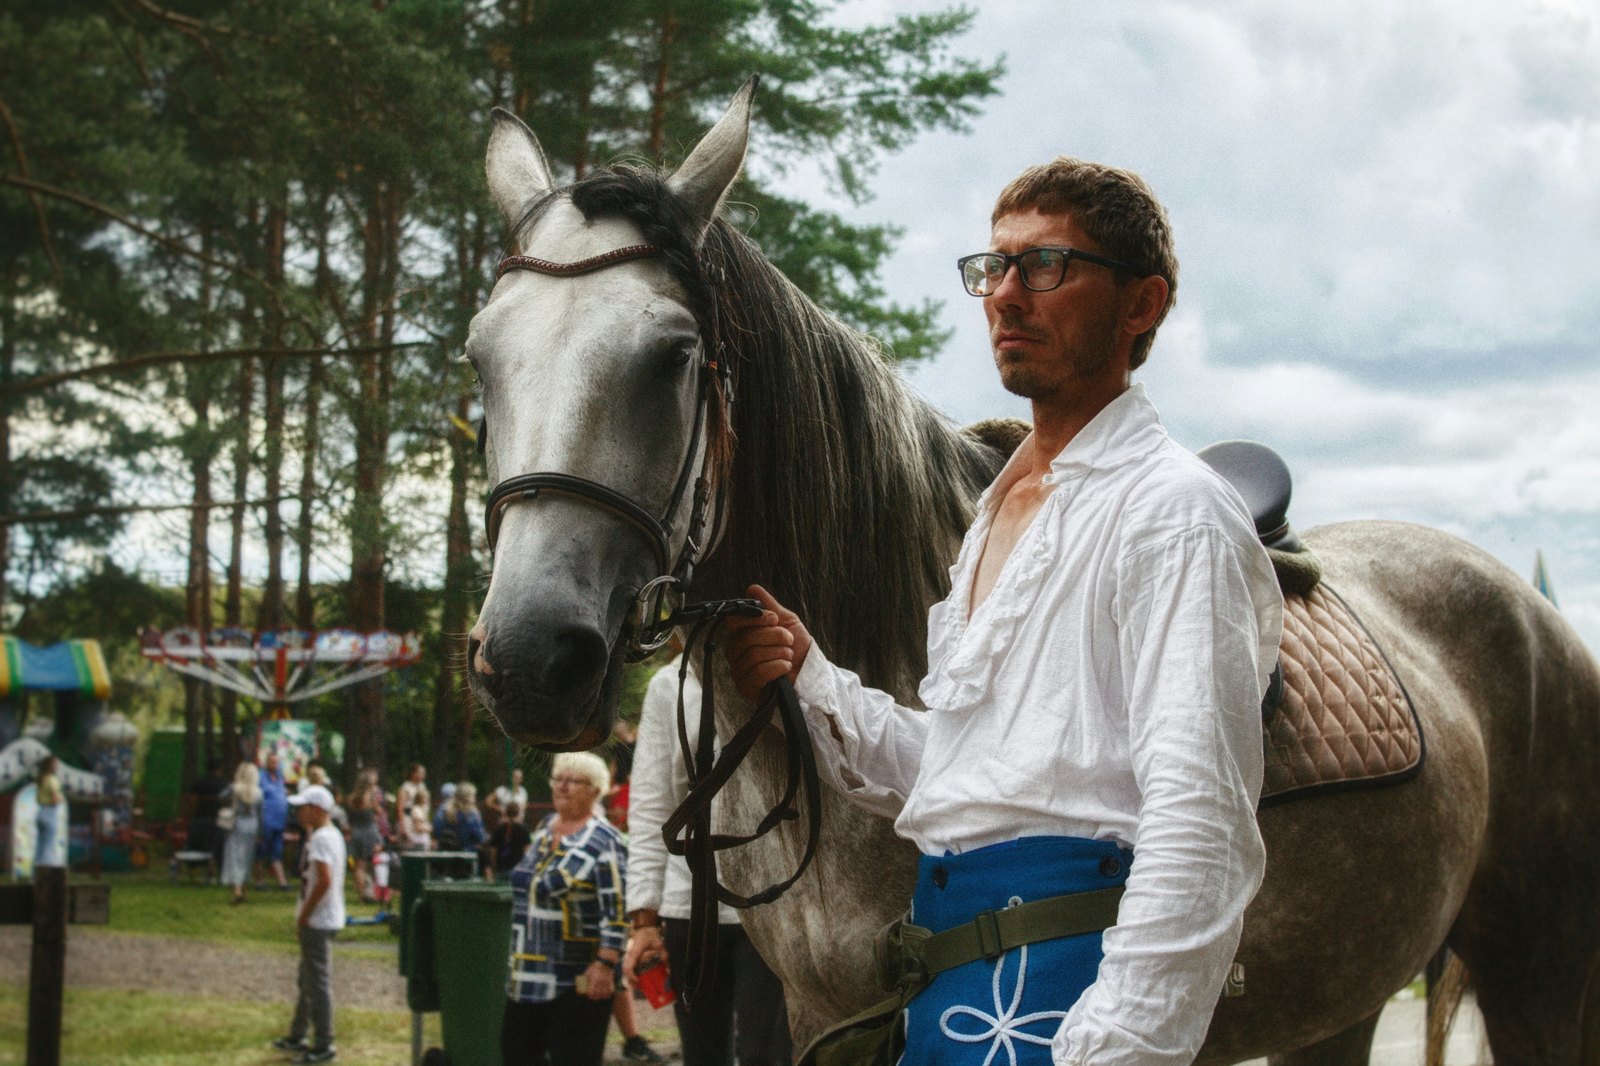
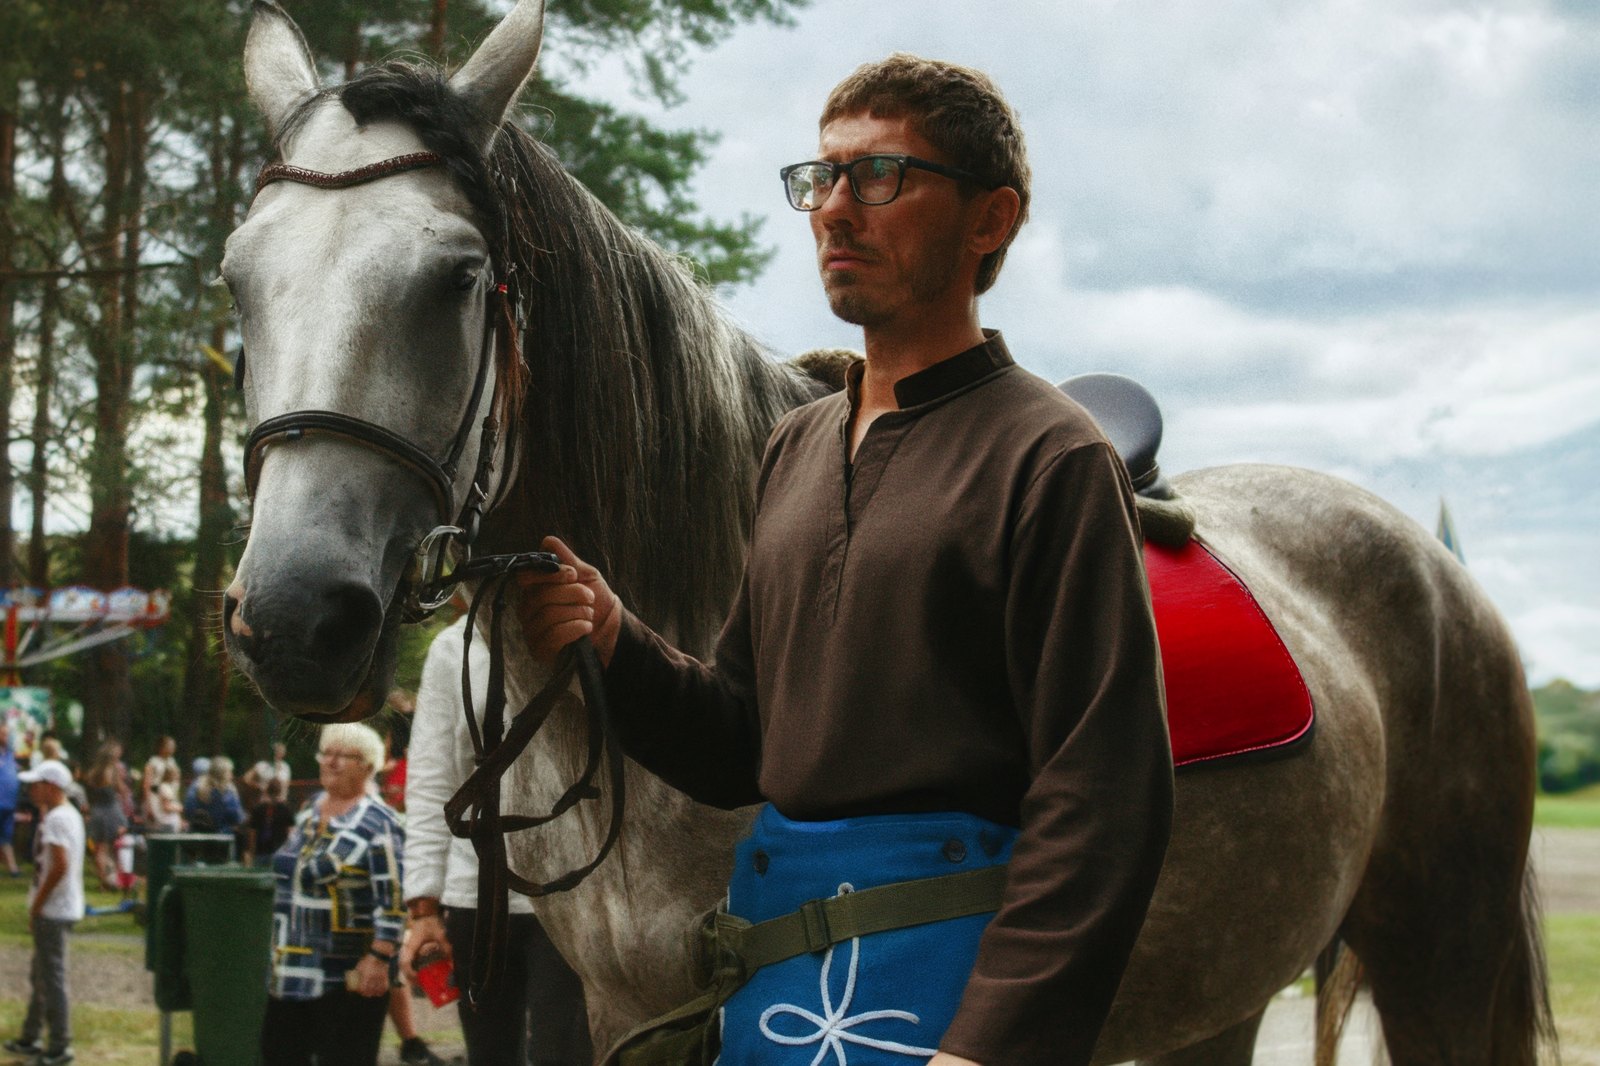
| Entrada, encuadre de editor 1K | Salida tras una edición compuesta de cuatro operaciones |
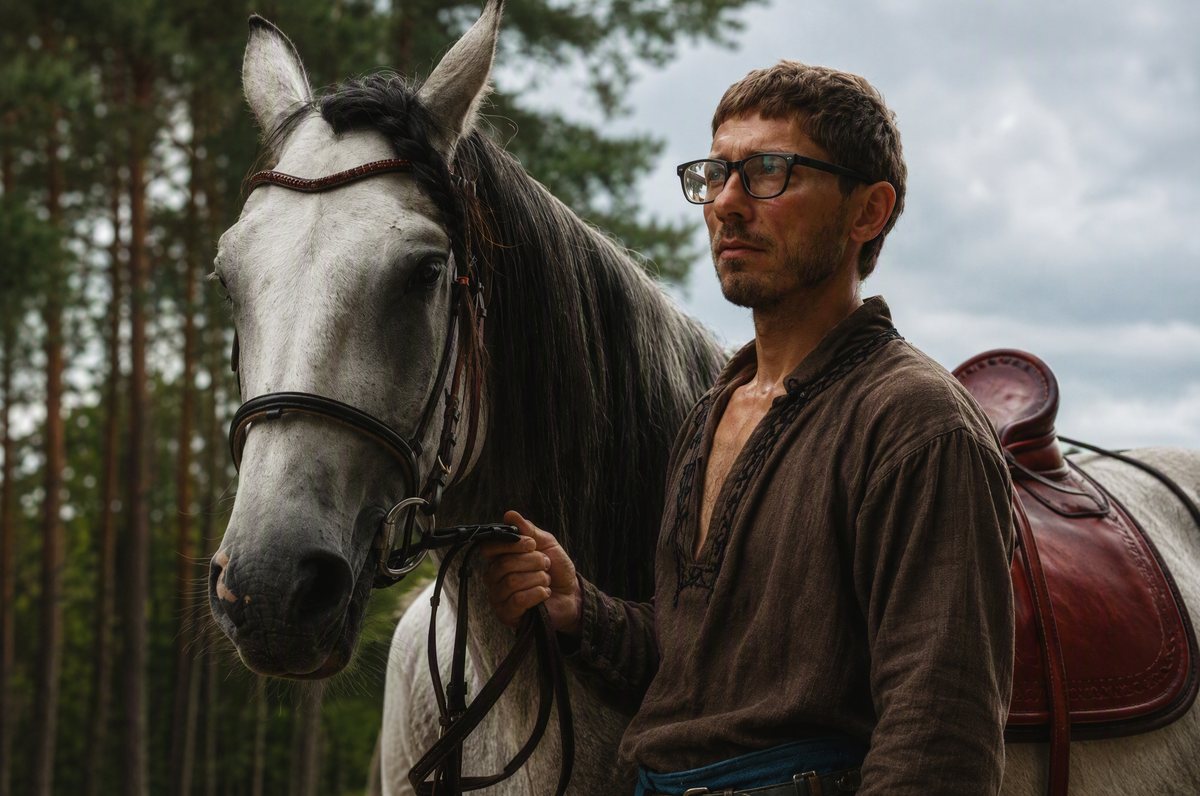
Demostración oficial: acercar al hombre y al caballo, cambiar la camisa blanca por una túnica marrón oscuro y sustituir la manta de la silla por cuero rojo, todo con una sola instrucción.
Una actualización, no un primer lanzamiento
El repositorio ya contenía un checkpoint SFT anterior (ckpt800). El 2026-11-03 fue reemplazado por ckpt35, el transformer destilado con SATP, que la model card etiqueta como un checkpoint intermedio sin la etapa posterior de post-entrenamiento.
El diff es acotado y verificable: los diez shards del transformer se volvieron a subir, mientras que el codificador de texto (cinco shards), los pesos del VAE DCAE-F64 y el tokenizer son idénticos byte a byte a la revisión anterior. El total_size del transformer no cambia en 36.314.324.992 bytes y el conteo de tensores se mantiene en 233, así que nada en la arquitectura ni en la ruta de carga se movió. El índice de archivos de HF lista 9.078.581.248 parámetros almacenados en fp32.
| Parte | Cambio en la revisión del 11-03 |
|---|---|
| Transformer (10 shards) | Reemplazado |
| Codificador de texto, VAE, tokenizer | Idénticos byte a byte |
| Config, índice, scheduler | Solo metadatos |
Convertir un editor 1K en uno 4K
La parte difícil de la edición en 4K no es el muestreador, sino el conteo de tokens: un latente 4K con la compresión habitual f=8 tiene dieciséis veces el área espacial de 1K. BluePixel cambia el VAE f=8 de FLUX.2 Klein por DCAE-F64, un autoencoder de compresión profunda que mantiene el conteo de tokens del DiT en 4K al nivel de 1K, y luego alinea los nuevos latentes con el editor preentrenado mediante destilación por proyección progresiva en 8 → 32 → 64.
El equipo estima el costo de esa etapa en aproximadamente 4 días en 32 XPU Kunlunxin P800 con cerca de 200K muestras, que es el argumento que plantea el artículo: la edición en 4K se convierte en un problema de sistema con una receta asequible en lugar de un entrenamiento preentrenado desde cero.
Habilidades de cola larga sin olvidar el modelo base
Aprendizaje continuo grupo por grupo: cada habilidad vertical (peinados, expresión, pose, efectos fotográficos globales) se enseña como un banco de ACE-LoRA sobre gradientes ortogonales, y luego se destila de vuelta al modelo base con MOPD antes de que empiece el siguiente grupo. El artículo reporta CIE-Bench total 6,24 → 8,87 mientras las métricas generales de edición se mueven menos de ±0,03, y el banco de peinados por sí solo contiene 26 plantillas aprendidas de unas pocas docenas de muestras cada una.
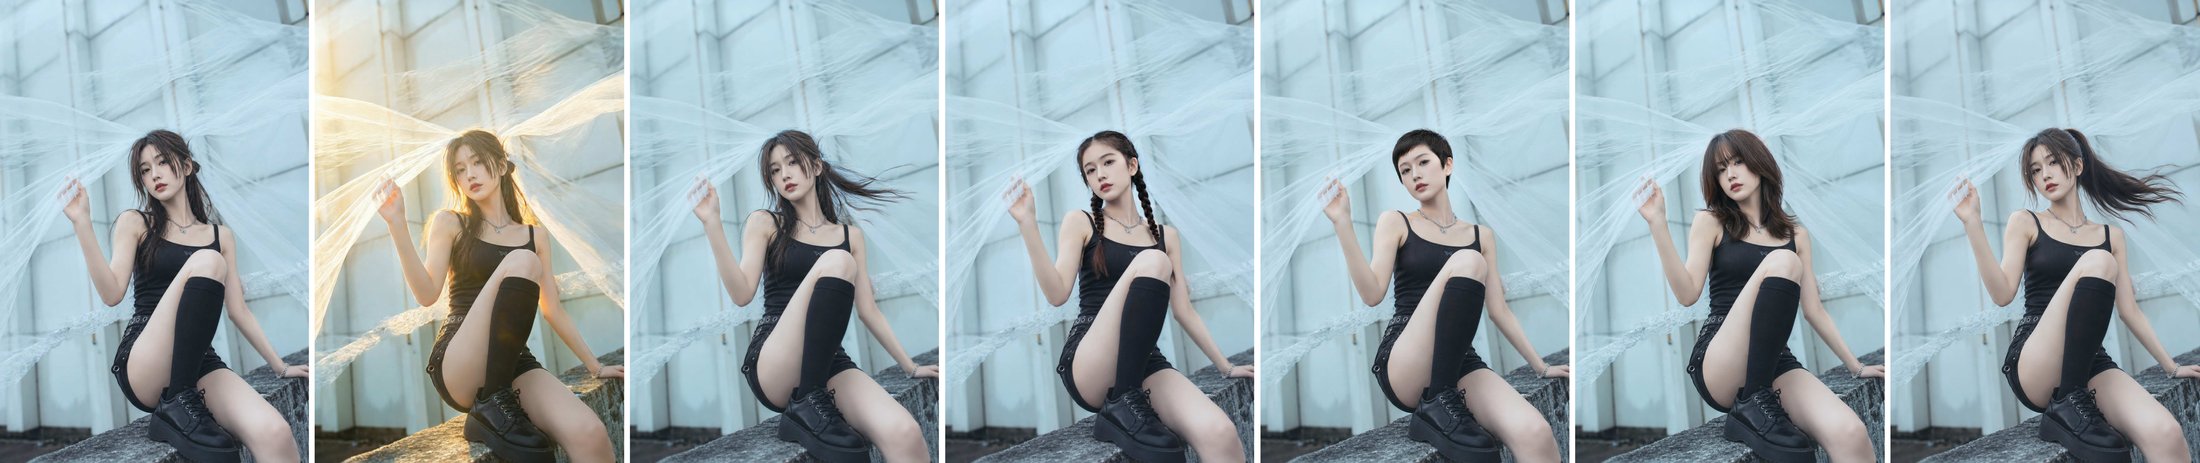
Tiras de plantillas del artículo: la imagen fuente a la izquierda de cada grupo y las salidas de plantilla después.
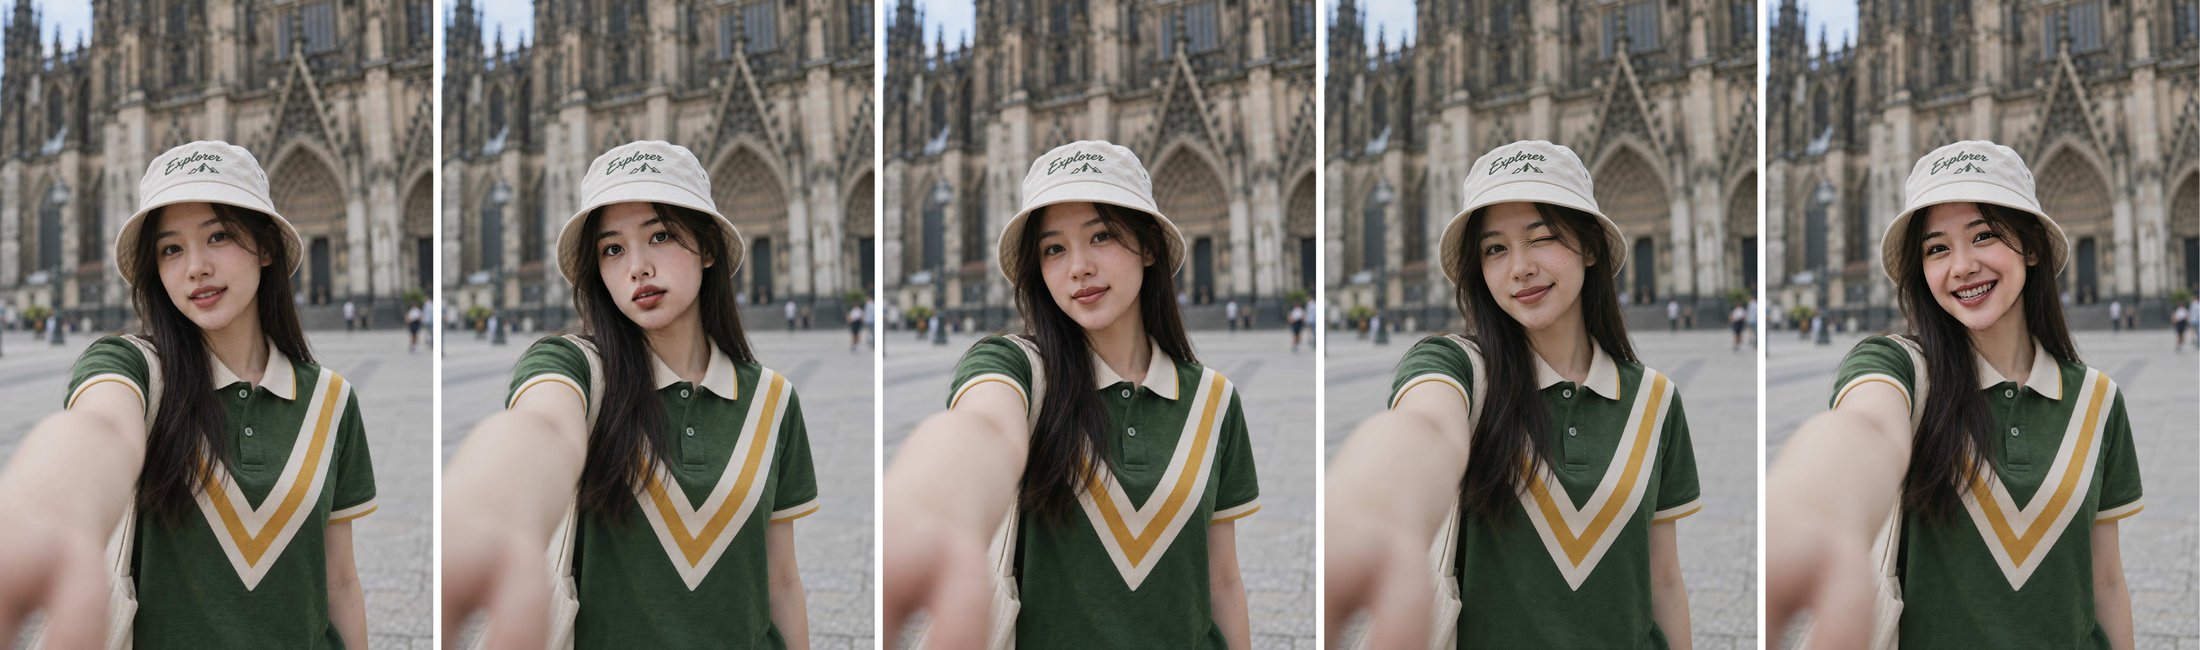
El grupo de expresión del mismo banco, también destilado de vuelta al modelo base antes de entrenar el siguiente grupo.
Cuatro pasos en lugar de cincuenta
La proyección del objetivo anclada a la fuente (SATP) es el esquema de destilación detrás del nombre Turbo: el estudiante queda anclado al latente de la fuente para que las regiones no editadas sobrevivan al recorte de pasos. El resultado declarado es una reducción de 50 → 4 pasos, una inferencia aproximadamente 4x más rápida, manteniendo la tasa de éxito de tareas y la consistencia del fondo. La cifra de 8,7 s se mide en hardware XPU Kunlunxin P800, así que una ejecución en un equipo de escritorio con CUDA no la alcanzará.
Benchmarks
Las cifras a continuación provienen de la página del proyecto; la página señala que no asigna cada puntuación de calidad a este checkpoint Turbo específico.
- VINS-4KEval++ (3.305 casos nativos 4K, 7 modelos): global 8,62, 2.º de 7; consistencia en regiones no editadas 9,06, 2.º solo por detrás de GPT Image 2
- ImgEdit-Bench: 4,59 Hybrid y 4,93 Action, 1.º en ambos; empatado en 1.º en Add
- Estabilidad con 8 semillas: media 8,624, rango 0,053
- CIE-Bench: 6,24 → 8,87 mediante ACE-MOPD
 |
|---|
| GPT Image 2, misma entrada y misma instrucción compuesta, de la comparativa de la página del proyecto |
Disponibilidad
La vía oficial es el pipeline basado en Diffusers en vivo/BluePixel (load_pipeline + vins_infer.py, 4 pasos, guidance_scale 3.0, target_pixels 4096×4096). Todavía no hay un cargador nativo de ComfyUI en el núcleo, así que el acceso desde ComfyUI llega mediante un paquete de la comunidad: T8mars/Comfyui-BluePixel-T8, listado en el Comfy Registry como bluepixel-t8, con 20 nodos, cargador dividido para el modelo de difusión / codificador de texto Qwen3-8B / VAE DCAE-F64, y un reempaquetado INT8 ConvRot del transformer en t8star/BluePixel-Comfy (unos 28,19 GB repartidos en tres archivos).
Una restricción acompaña al paquete: DCAE-F64 comprime a 64x, por lo que no se puede mezclar con un VAE FLUX.2 normal ni con un latente vacío creado para este. El paquete requiere ComfyUI 0.43.0+ y Diffusers 0.40+.
- Pesos: openvivo/BluePixel-Turbo
- Código: vivo/BluePixel
- Artículo: arXiv:2610.19882
- Dataset: openvivo/VINS-120K
Comentarios
Inicia sesión con GitHub para unirte a la conversación.