Anima RGBA proporciona a Anima un canal alfa real en ComfyUI
Anima RGBA combina un VAE Qwen-Image de 4 canales con un LoRA de Anima para generar PNG transparentes en ComfyUI sin nodos personalizados, con MAE alfa de 0.0027.
transparent background en el prompt y VAE Decode devolverá RGB Recto más alfa, que Save Image escribirá como un PNG RGBA. Sin Nodos Personalizados.
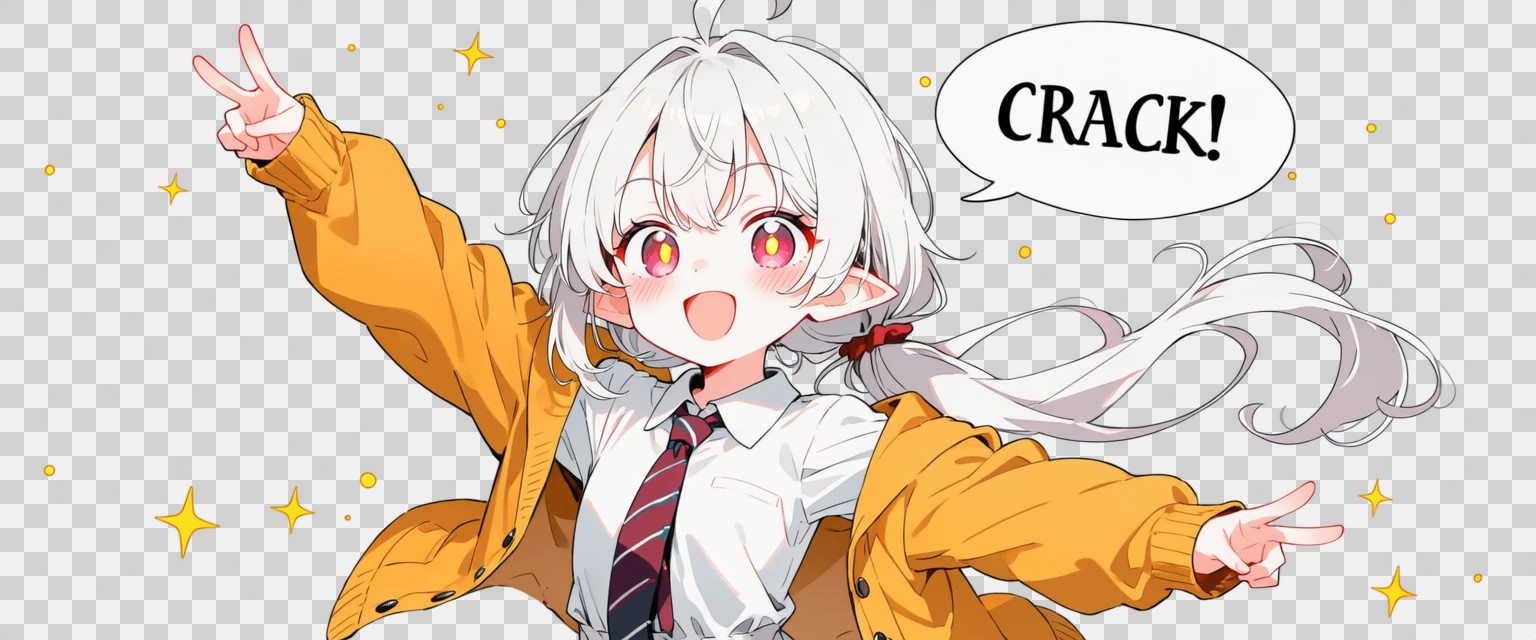
Generados con el VAE RGBA y el LoRA, mostrados sobre un tablero de ajedrez.
Anima usa el VAE de Qwen-Image, que decodifica a tres canales. Por eso, pedirle al modelo un Fondo transparente produce un sujeto dibujado sobre un Fondo que se le ha dicho al modelo que imagine vacío, y el recorte se hace después con una pasada de matting. Un VAE RGBA traslada eso al decodificador: la última capa simplemente tiene cuatro canales en lugar de tres.
Convertir un VAE de 3 canales en uno de 4 canales
El truco es menor de lo que parece. El VAE mantiene su latente de 16 canales a 1/8 de Resolución, así que nada del espacio latente de Anima cambia. El codificador toma RGB compuesto sobre Blanco más un Canal alfa; el decodificador devuelve RGB Recto, sin premultiplicar, más alfa.
La inicialización hace el resto: los pesos de 3 canales se Copian, la nueva columna de Entrada de alfa empieza en cero y la nueva fila de Salida de alfa empieza en cero con sesgo +1, de modo que antes de cualquier entrenamiento el modelo reproduce el VAE original y decodifica todo como opaco. El entrenamiento después lleva el nuevo codificador hacia los latentes del original congelado para la misma composición sobre Blanco, lo que mantiene el espacio latente donde Anima ya trabaja y deja al LoRA solo un pequeño residual de alfa que aprender.
La composición sobre Blanco es una elección deliberada: el RGB no está definido donde el alfa es cero, y una composición sobre Blanco es lo que Anima ya dibuja para prompts de Fondo transparente, así que los latentes RGBA se mantienen cerca de los que produce el Modelo base. La deriva medida es una distancia RMS de 0.058 en unidades de la desviación estándar del latente, aproximadamente el 6% de una sigma, y esa es la brecha que el LoRA cierra.
Cómo se ven los números
El VAE se entrenó durante 12,000 pasos con lote de 4 sobre recortes de 512 px, con pérdida L1 de composición sobre Fondos sólidos aleatorios, LPIPS a 0.2, L1 de alfa, un término de gradiente Sobel de alfa y MSE de latente de Referencia frente al codificador original; el 15% de cada lote eran Imágenes opacas usadas como regularización. En un conjunto de validación de 200 Imágenes transparentes y 50 opacas a 512 px, ninguna de las cuales se usó en el entrenamiento:
| Métrica | Valor |
|---|---|
| MAE de alfa | 0.0027 (aproximadamente 0.7 / 255) |
| RMSE de alfa | 0.0157 (aproximadamente 4 / 255, concentrado en las Aristas) |
| PSNR compuesto sobre Blanco | 34.94 dB |
| PSNR compuesto sobre Negro | 33.17 dB |
| PSNR opaco, VAE Qwen-Image original | 34.26 dB |
| PSNR opaco, VAE Anima RGBA | 34.74 dB |
La reconstrucción opaca es ligeramente mejor que la original en lugar de ligeramente peor, y ese es el resultado útil: cambiar el VAE no cuesta nada en Imágenes ordinarias.
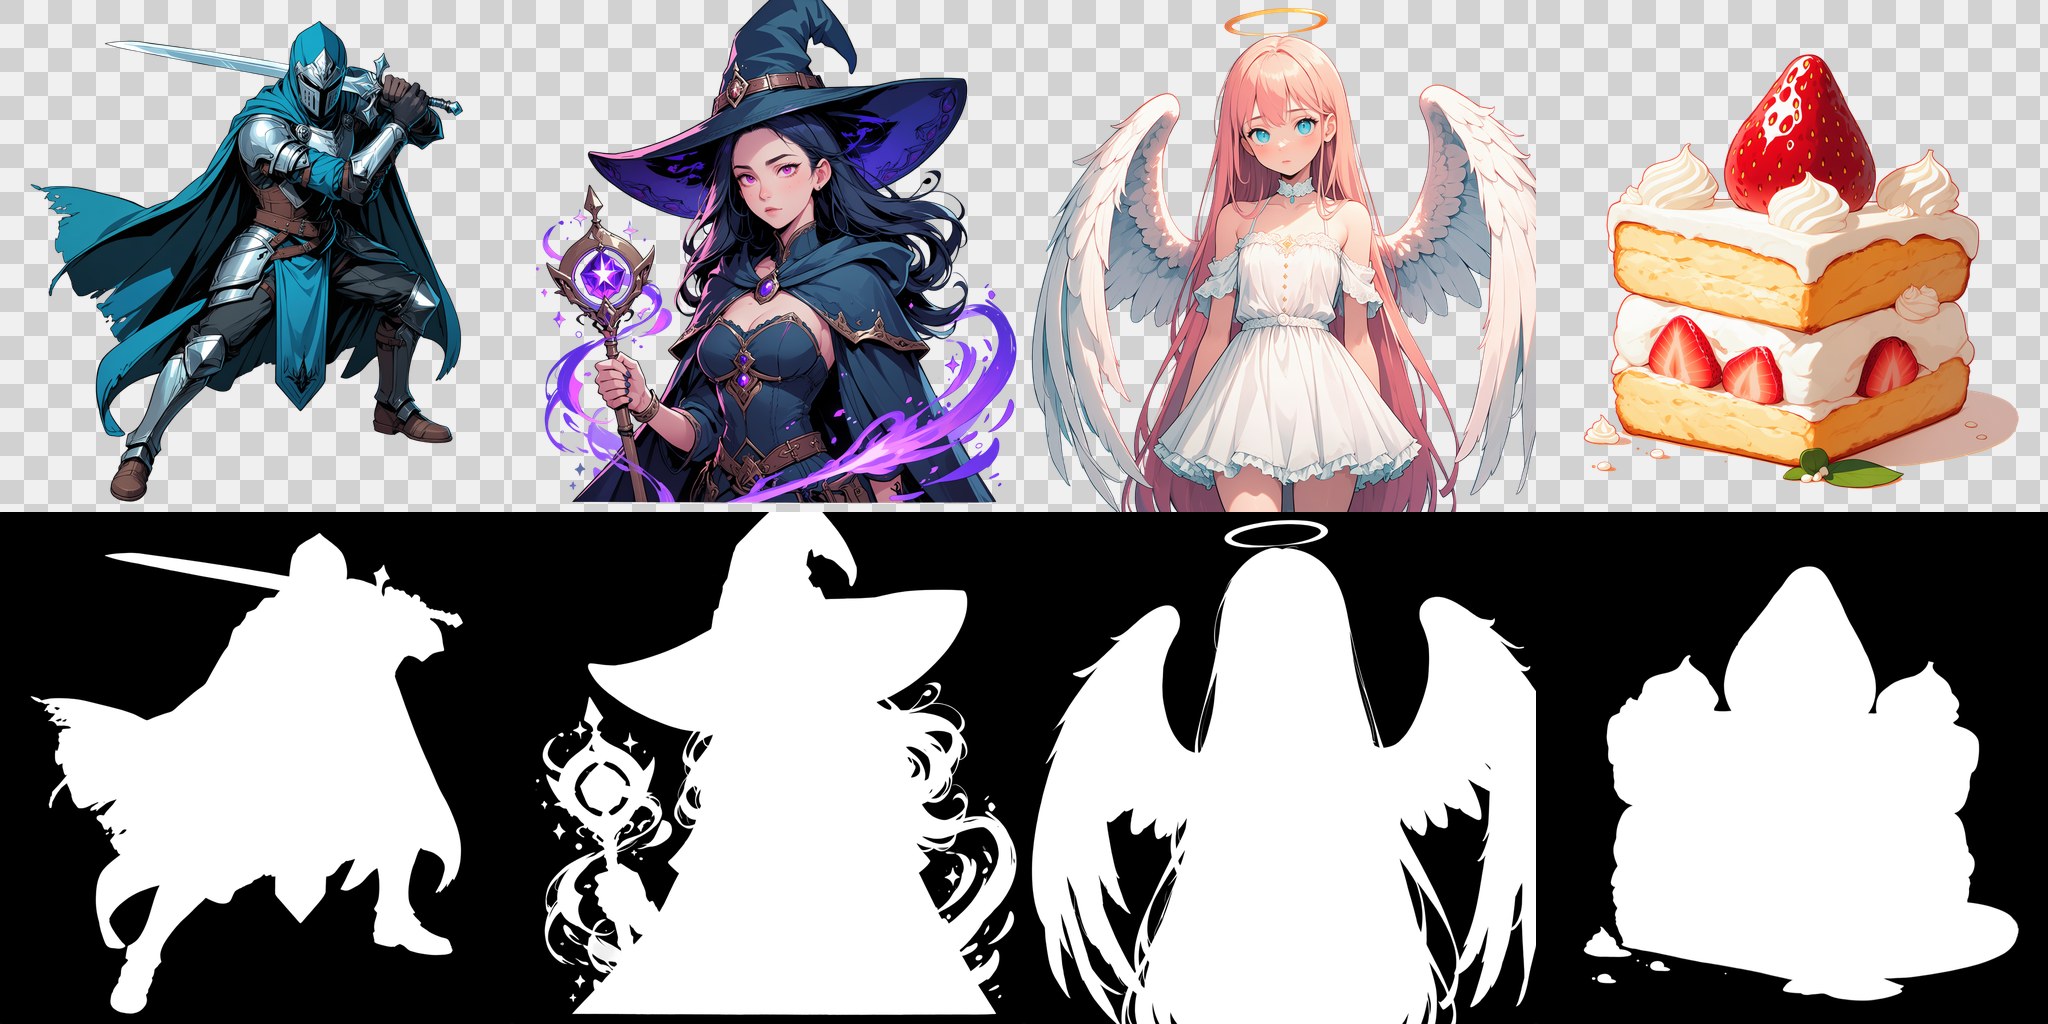
Fila superior: Salida RGBA sobre un tablero de ajedrez. Fila inferior: el Canal alfa por sí solo.
Por qué el LoRA sigue siendo necesario
Sin él, el VAE sigue produciendo un Canal alfa, pero uno brumoso: los personajes y la ropa blanca salen parcialmente transparentes, porque los latentes del Modelo base solo coinciden aproximadamente con lo que espera el nuevo decodificador. El LoRA se entrena con latentes de este VAE con rango 32, paso 25,000, sobre 18,426 Imágenes con el codificador de texto Qwen3 y el adaptador LLM congelados. Las Imágenes transparentes se describen con dos líneas de activación alternas, transparent background e isolated on a transparent background, mientras que las Imágenes opacas de regularización no llevan activador.
La tabla de pruebas de la Tarjeta del modelo, 8 prompts por 2 semillas a 1024 x 1024, muestra qué ocurre al girar las perillas:
| Fuerza del LoRA | Peso del activador | Transparente | Píxeles semitransparentes |
|---|---|---|---|
| ninguna | 1.0 | 16 / 16 | 12.8% |
| 1.0 | 1.0 | 16 / 16 | 0.9% |
| 1.2 | 1.0 | 16 / 16 | 1.0% |
| 1.5 | 1.0 | 16 / 16 | 1.4% |
| 1.0 | 1.2 | 16 / 16 | 0.9% |
| 1.0 | 1.5 | 16 / 16 | 0.9% |
Cada ajuste produce un resultado transparente, así que el número que importa es la proporción de píxeles semitransparentes sueltos: 12.8% sin LoRA frente a 0.9% con los valores predeterminados. Llevar el LoRA a 1.5 no ayuda y añade residuos semitransparentes y humo alrededor del sujeto; subir en cambio el peso del activador deja la Imagen y el alfa casi sin cambios. Es lo contrario del instinto habitual, y la Tarjeta lo dice directamente: sube el peso del activador, no la fuerza del LoRA.
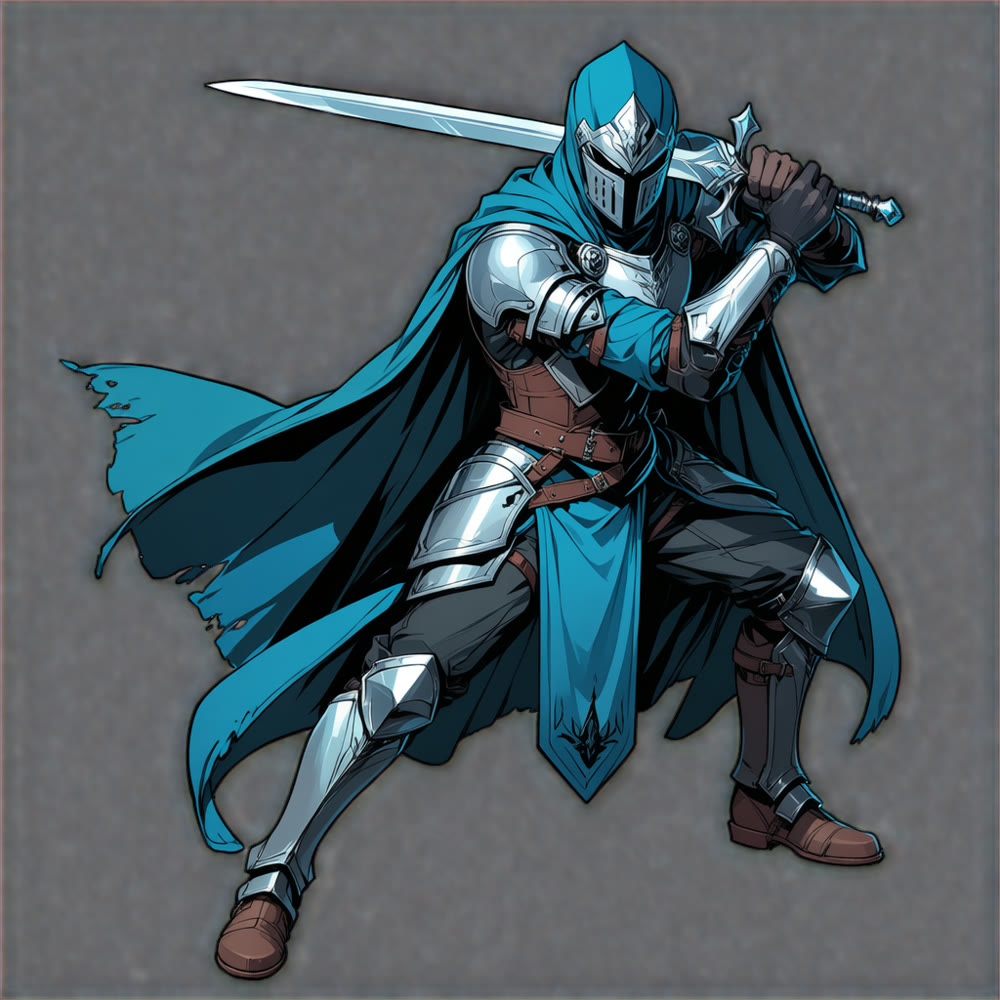
Un personaje de cuerpo completo con LoRA 1.0, 30 pasos, CFG 4.5, er_sde con simple.
Dónde se queda corto
El VAE se entrenó con recortes de 512 px y decodifica a Resoluciones mayores, pero el detalle semitransparente fino como los mechones de pelo, el vidrio y el humo es su punto más débil. El alfa Generado es en su mayoría binario, así que la ropa translúcida suele salir opaca. Los primeros planos que llenan el encuadre a veces conservan un Fondo blanco opaco, más a menudo cuando se apilan otros LoRAs. Está pensado para contenido de anime e ilustración, que es lo que dibuja Anima.
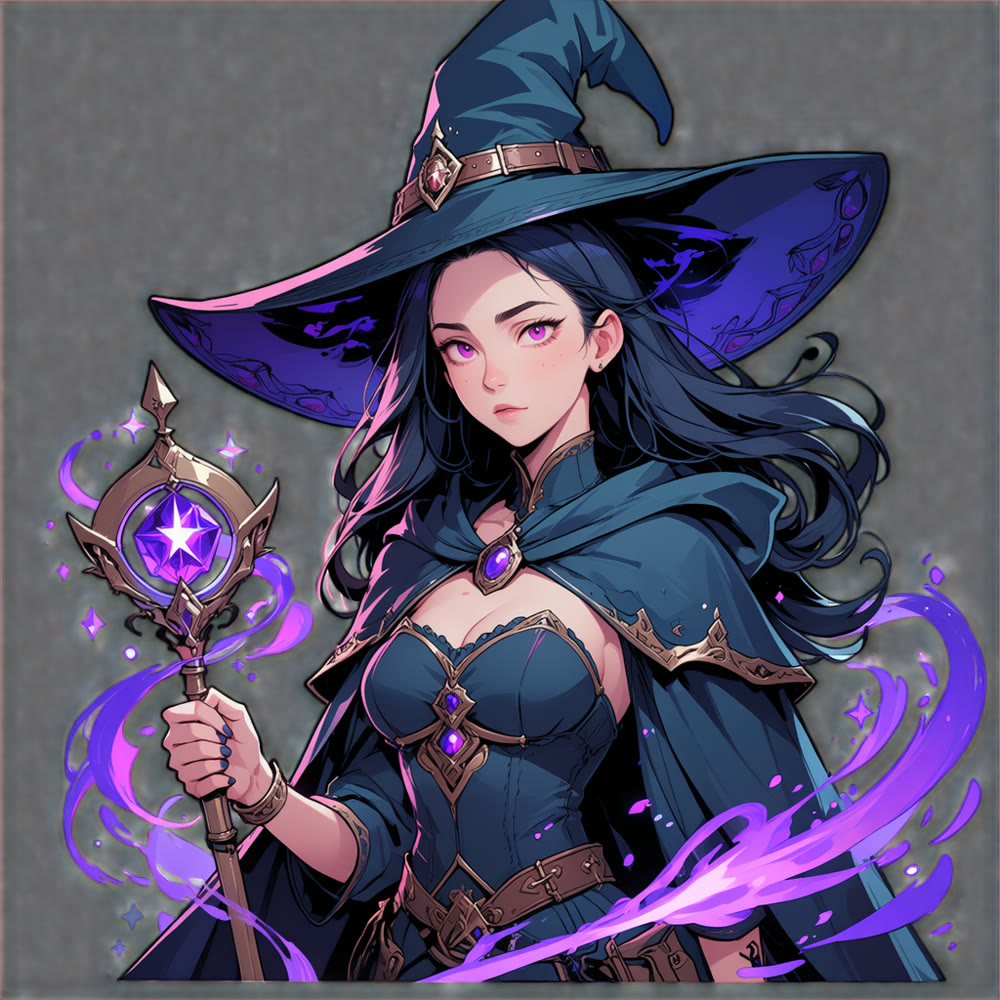
La misma receta en otro sujeto, con el alfa conservado a través del sombrero y el bastón.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.