Lightning v2 RL: Qwen-Image 2.1 en 4 pasos, refinado con RL
Lightning v2 RL de LightX2V sustituye el adaptador de 67 MB por un transformer completo de Qwen-Image 2.1 destilado a 4 pasos y refinado con aprendizaje por refuerzo.
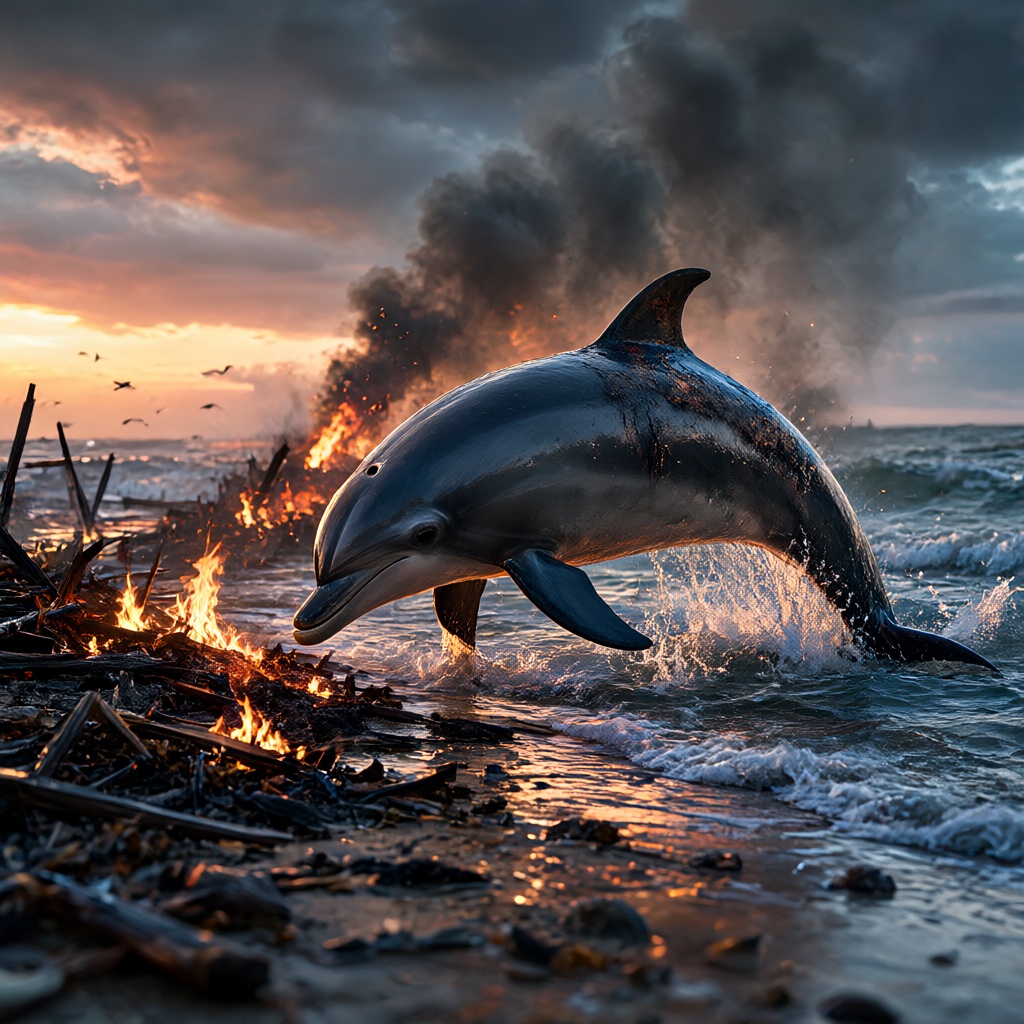
Un render de 1024 x 1024 del checkpoint RL de cuatro pasos, "Delfín en una costa en llamas".
Qué cambió respecto al LoRA
La versión de octubre añadía un adaptador de 67 MB al checkpoint original de Qwen-Image 2.1 y dependía de una lista de sigmas fija en el momento del muestreo. La v2 cambia ambas mitades de esa configuración:
- Pesos completos del transformer en lugar de un adaptador: un único
diffusion_pytorch_model.safetensorsalmacenado en FP32 (28,5 GB) con su propioconfig.json, descrito en la model card como cargable en BF16 para inferencia. No hay ningún LoRA que apilar. - Una etapa de aprendizaje por refuerzo después de la destilación. La model card describe el checkpoint como la versión refinada con RL de Lightning v2, entrenada con LightX2V RL. Solo se publica el checkpoint refinado, así que los pesos de la v2 previos al RL no están disponibles para comparar.
- Tres tareas desde un único checkpoint: texto a imagen, edición con una sola referencia y generación con múltiples referencias, que la v1 también abordaba.
El calendario de cuatro pasos
La configuración de muestreo se distribuye como inference_config.json, y no es el calendario uniforme que usaba el LoRA de la v1. La v2 ejecuta cuatro sigmas de 1.0, 0.95418, 0.89508 y 0.704534, con true_cfg_scale en 1.0 y la caché KV habilitada:
pipe.scheduler = FlowMatchEulerDiscreteScheduler(
    **inference_config["scheduler"],
)
image = pipe(
    prompt=prompt,
    width=1024,
    height=1024,
    sigmas=SIGMAS,                    # 1.0, 0.95418, 0.89508, 0.704534
    num_inference_steps=len(SIGMAS),
    true_cfg_scale=1.0,
    use_kv_cache=True,
)
Tres pasos se sitúan por encima de 0,89 y el cuarto cae de 0,895 a 0,705 antes de que el scheduler añada el cero terminal, de modo que la mayor parte del denoising ocurre al principio. El README deja claro que establecer solo num_inference_steps=4 no reproduce este calendario, y que las sigmas almacenadas ya están desplazadas, por lo que el desplazamiento dinámico debe permanecer desactivado.
Cuatro pasos frente a cuarenta
El repositorio empareja cada ejemplo con una ejecución de 40 pasos de los pesos originales de Qwen-Image 2.1, con el mismo prompt, la misma semilla, el mismo CFG 1.0 y una salida de 1024 x 1024.
| Modelo base, 40 pasos | Lightning v2 RL, 4 pasos |
|---|---|
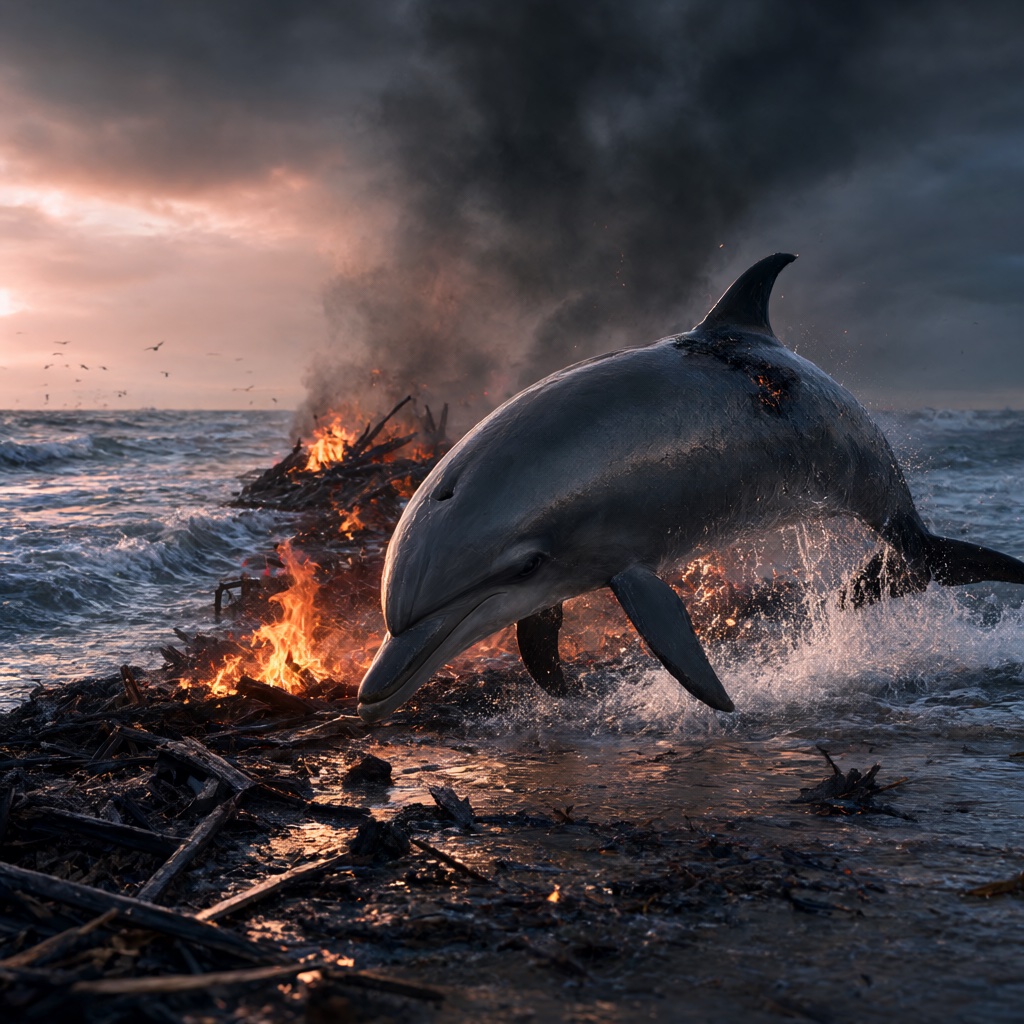 | |
| Delfín en una costa quemada | Delfín en una costa quemada |
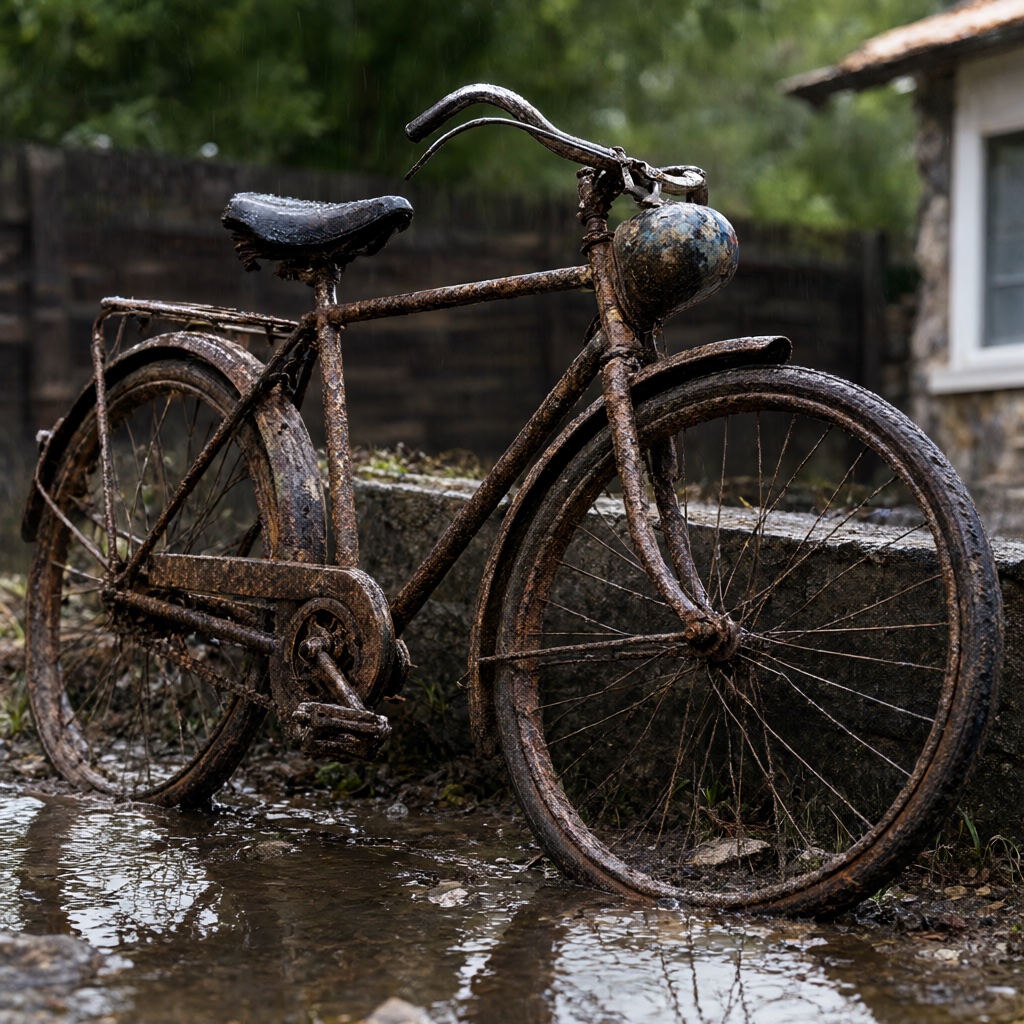 | 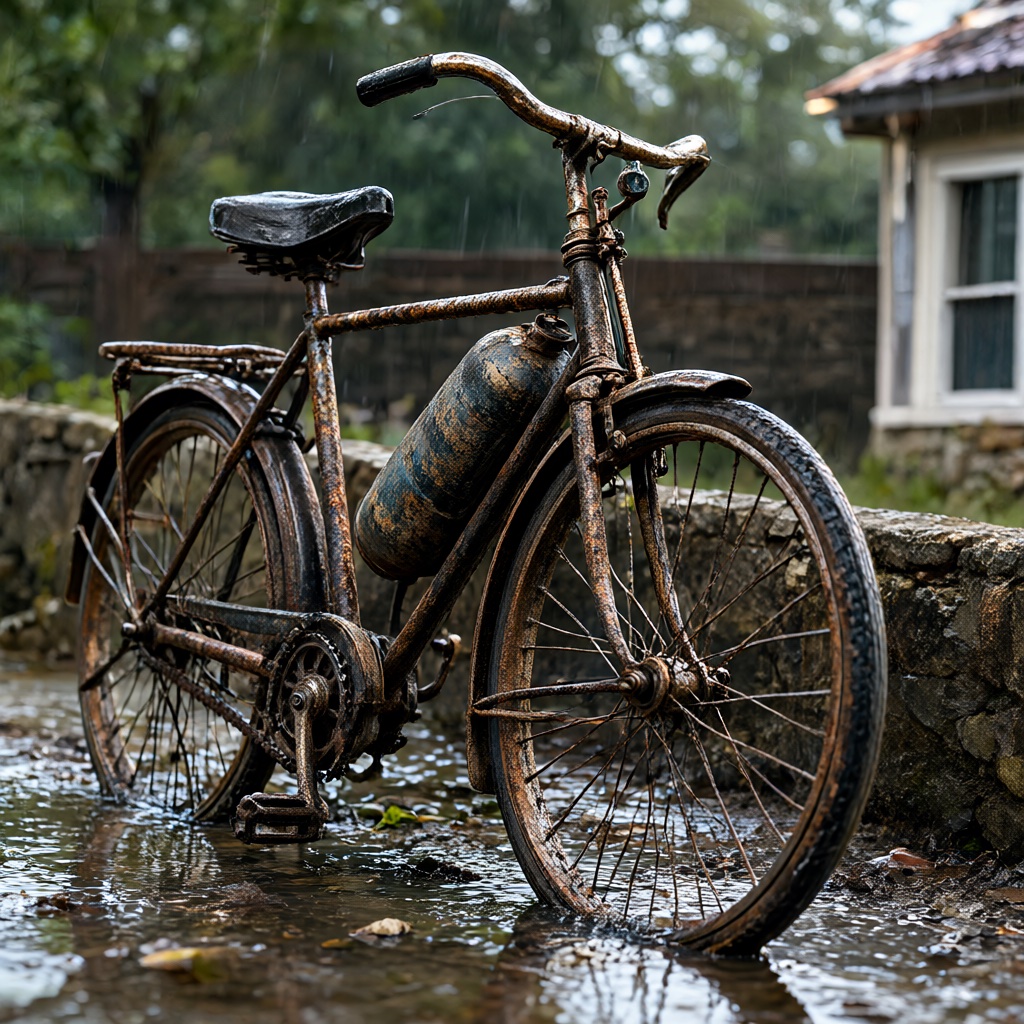 |
| Bicicleta desgastada bajo la lluvia | Bicicleta desgastada bajo la lluvia |
Ambos prompts son descripciones de escena largas y estructuradas: el del delfín recorre el color de las nubes, las columnas de humo, las vigas carbonizadas, la ubicación de las brasas y la iluminación de la aleta dorsal antes de terminar; el de la bicicleta recorre el óxido de cada tubo del cuadro, el número de radios y las estrías de lluvia. La model card presenta estos como ejemplos de validación seleccionados, no como un benchmark, y advierte que el texto fino, la anatomía, el recuento de objetos y la preservación precisa de referencias aún pueden requerir revisión.
Editar una sola referencia
Para la edición, la imagen de referencia entra como el argumento image del pipeline, en la misma llamada que lleva la instrucción:
| Referencia | Modelo base, 40 pasos | Lightning v2 RL, 4 pasos |
|---|---|---|
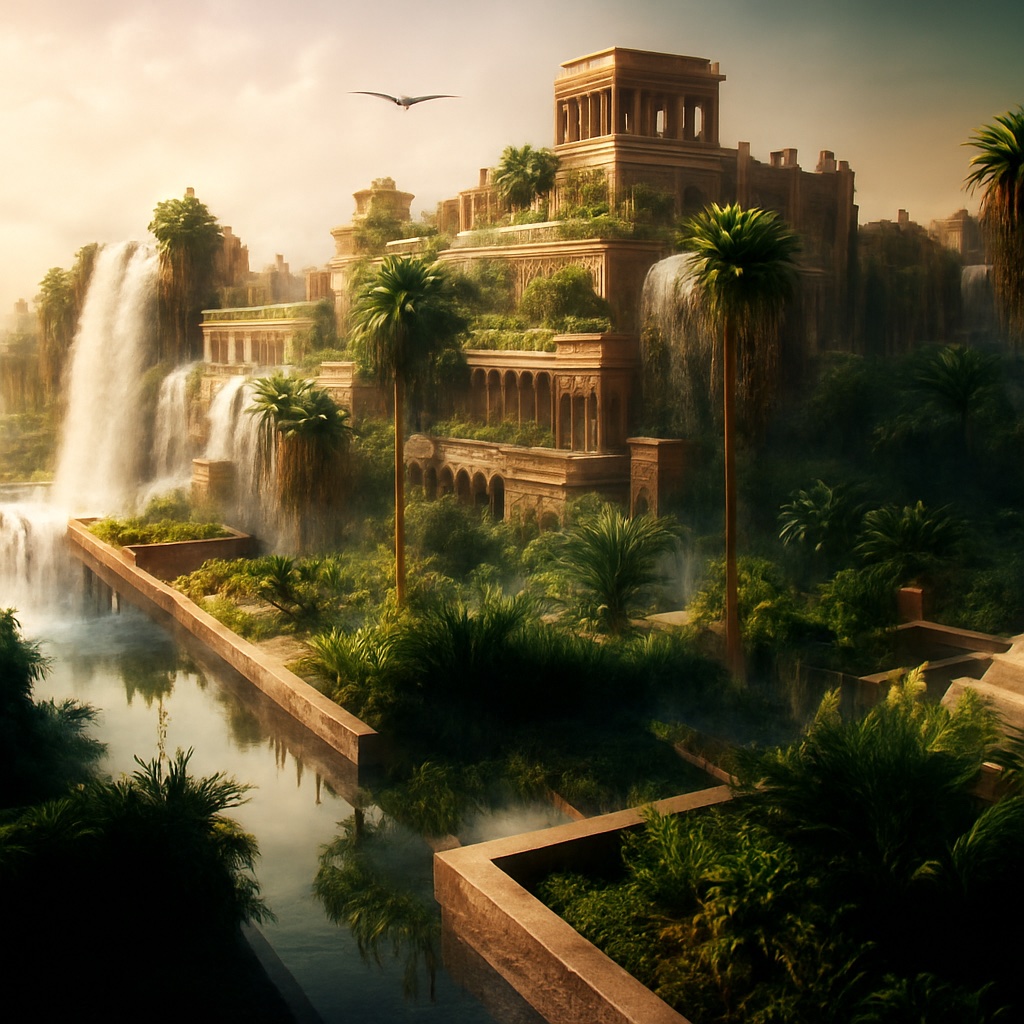 | 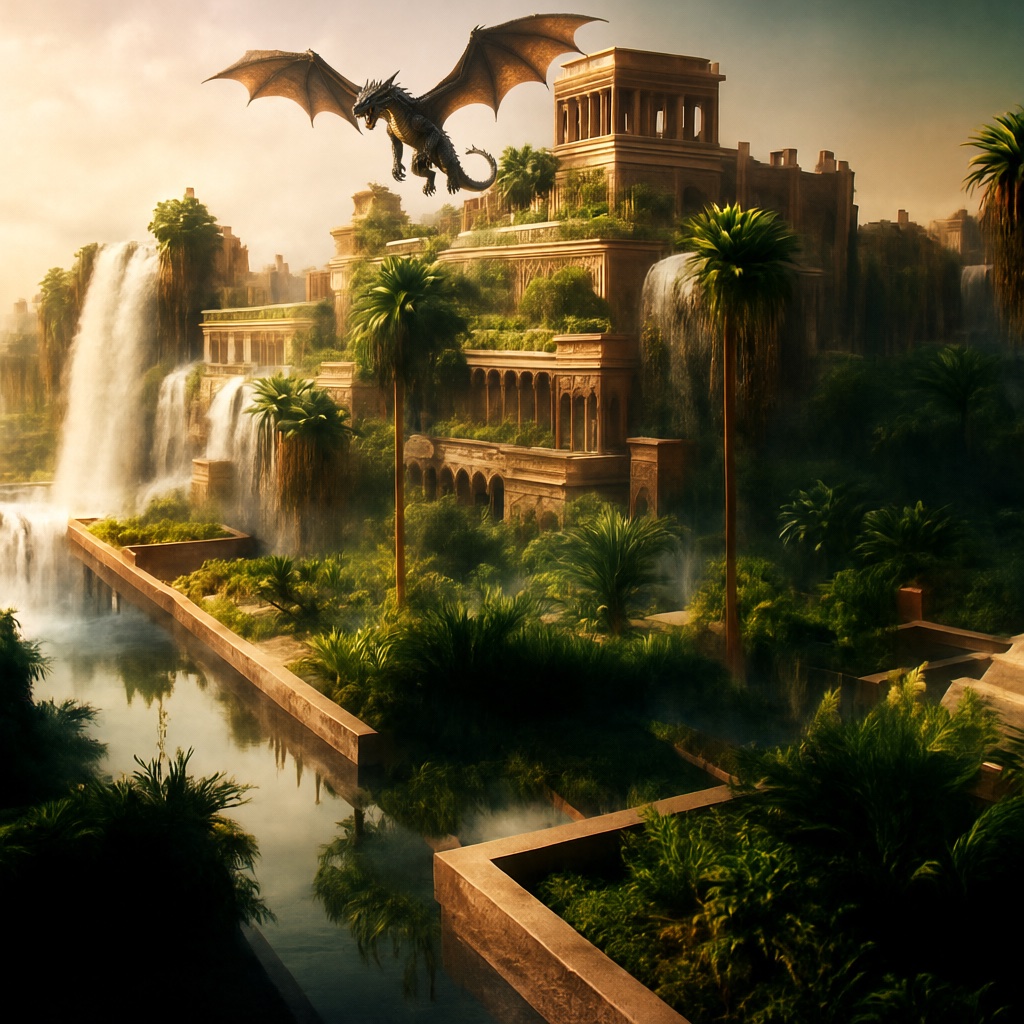 | 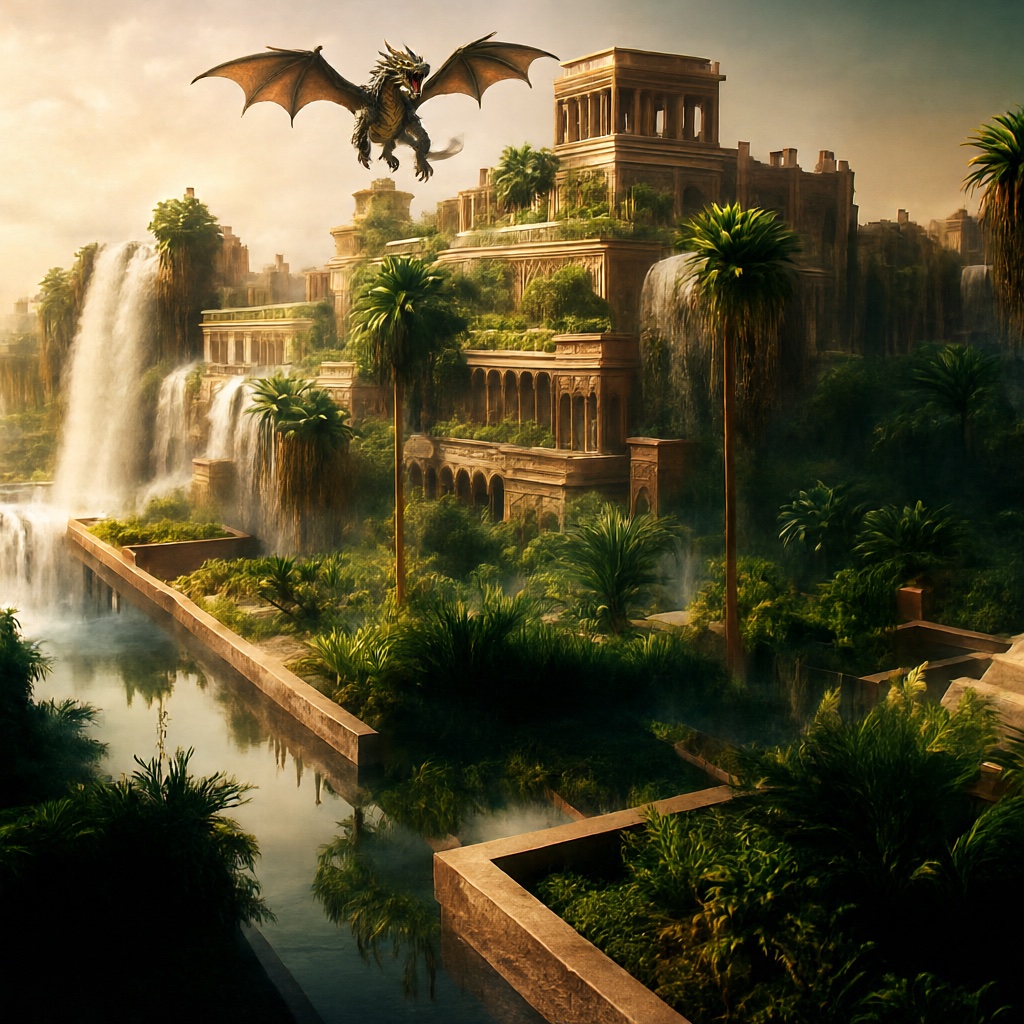 |
"Sustituye el pájaro que vuela en la parte superior central del cielo por un dragón volador que se eleva en la misma posición y distancia. … Conserva todo lo demás completamente sin cambios: la arquitectura de piedra en terrazas … las cascadas …"
El prompt fija el dragón a la dirección de vuelo del pájaro y luego enumera lo que no debe moverse: galerías de piedra, jardines en las azoteas, cascadas, palmeras, niebla y el cielo brumoso. El segundo ejemplo de edición del repositorio sustituye la escena de un guitarrista.
Generación con múltiples referencias
La ruta de múltiples referencias toma varias imágenes a la vez y se dirige a ellas por índice dentro del prompt (<image1>, <image2>), que es como la model card mantiene ordenadas dos referencias:
| Referencias | Modelo base, 40 pasos | Lightning v2 RL, 4 pasos |
|---|---|---|
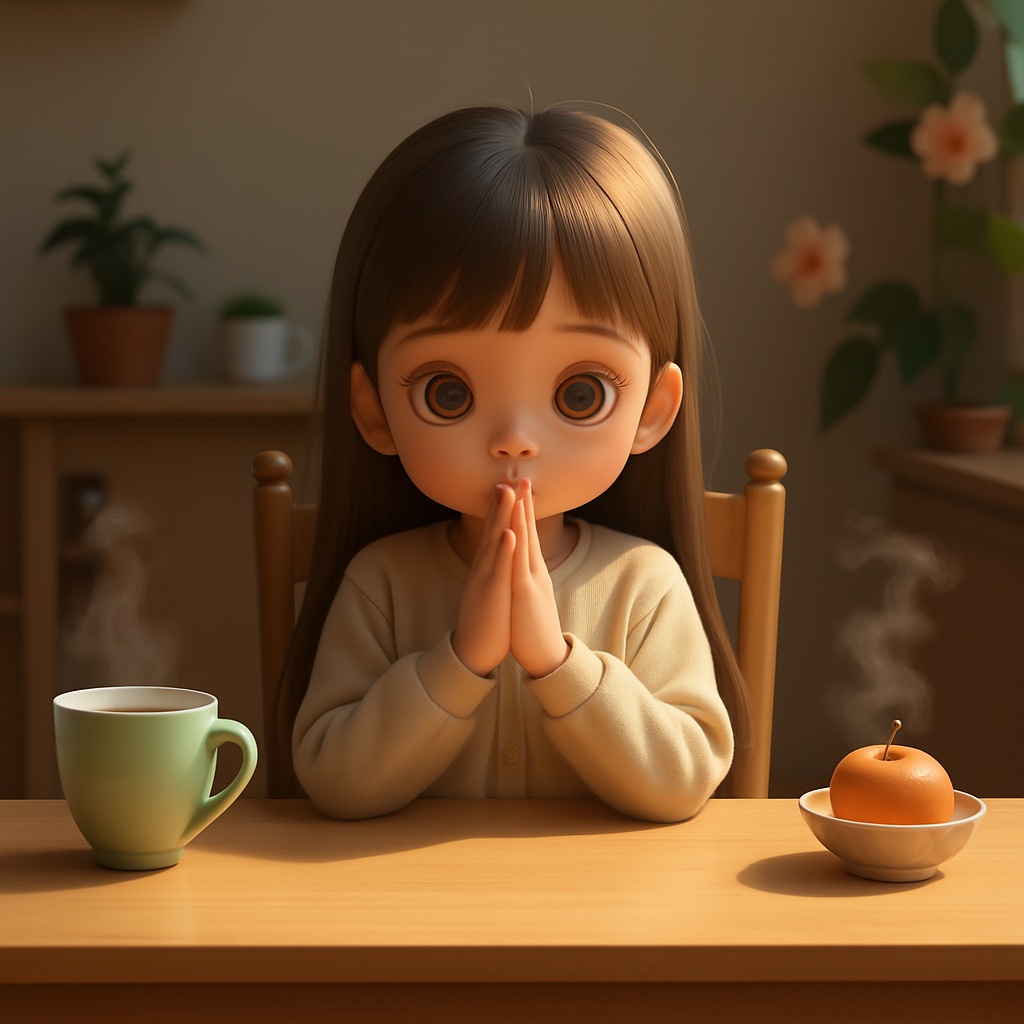 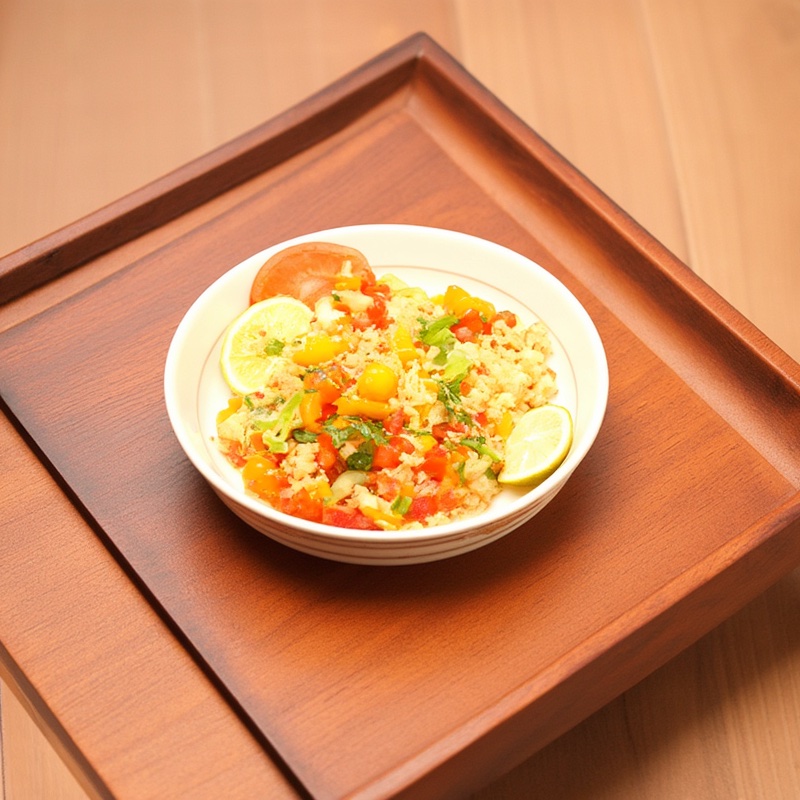 | 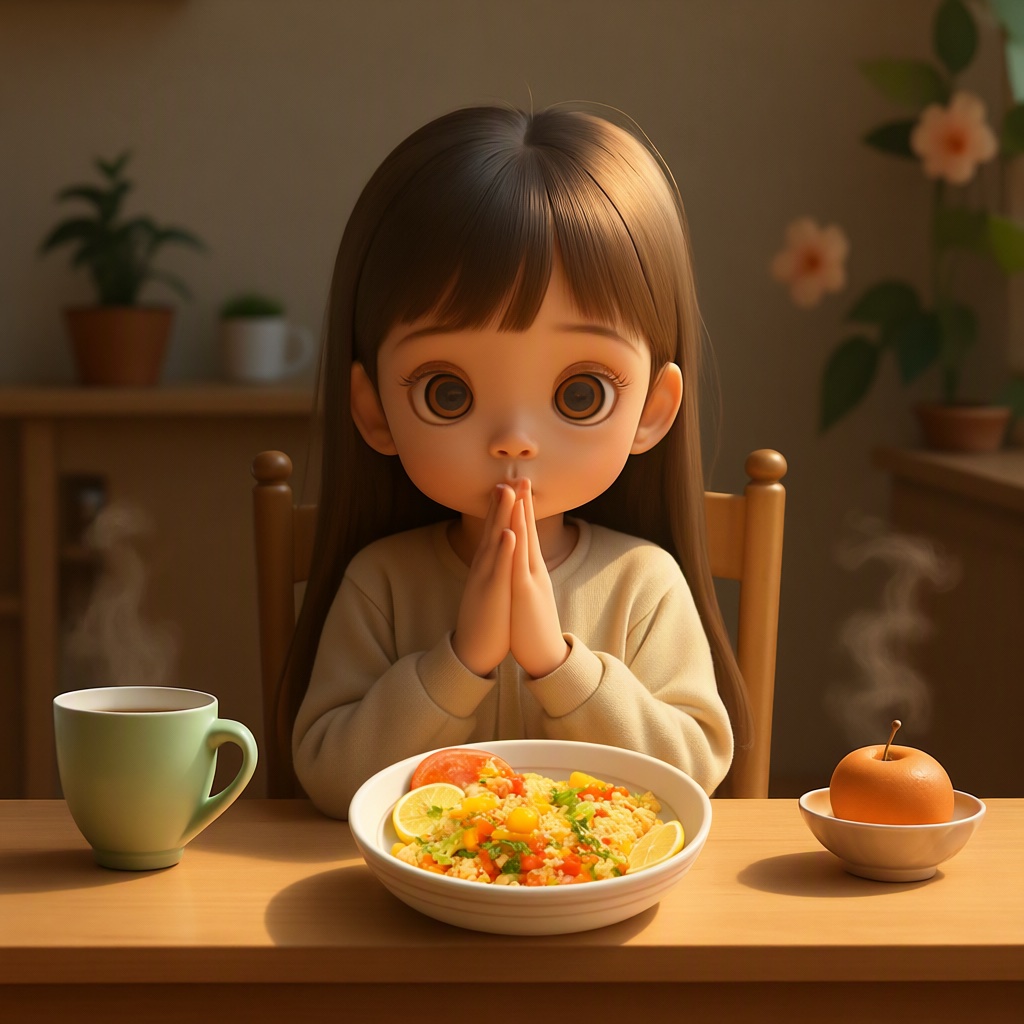 | 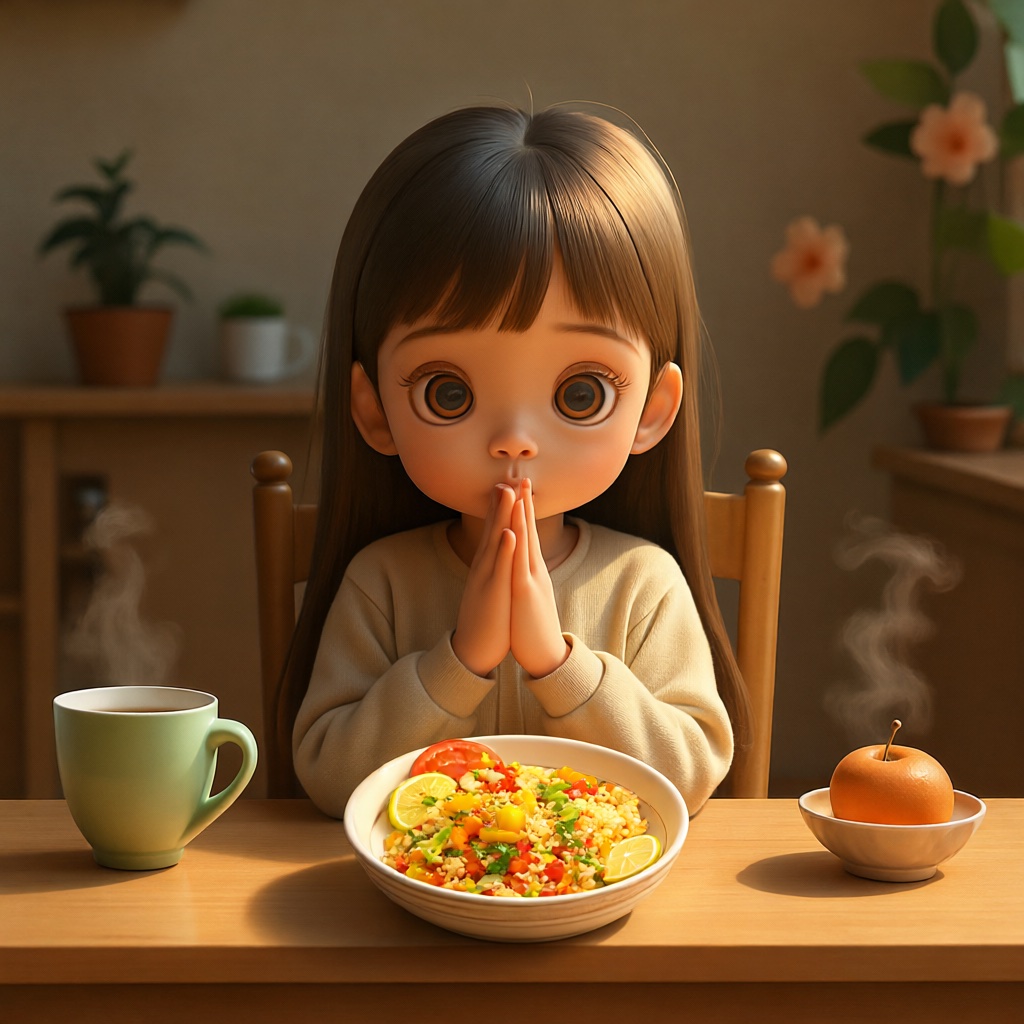 |
"Sobre <image1> (lienzo), coloca el cuenco de comida extraído de <image2> en la mesa de madera … Renderiza el cuenco y la comida añadidos con el mismo estilo de ilustración 3D suave de <image1> en lugar del estilo fotorrealista de <image2>. …"
La instrucción incluye escala, perspectiva, dirección de la luz y dirección de la sombra, además de una lista explícita de lo que debe conservarse del lienzo: el rostro de la chica, su cárdigan, la taza humeante, el frutero y el estante detrás de ella. Un segundo ejemplo de múltiples referencias transfiere un patrón de porcelana floral a una tetera en una escena de retrato.
Disponibilidad
Pesos: lightx2v/Qwen-Image-2.1-Lightning-v2-RL en Hugging Face. Modelo base: Qwen/Qwen-Image-2.1. Framework de entrenamiento e inferencia: ModelTC/LightX2V.
Los archivos publicados están en el formato de Diffusers (QwenImage21Transformer2DModel, 32 capas, 32 cabezas), y el inicio rápido de la model card los carga mediante QwenImage21Pipeline sustituyendo el transformer del pipeline. El repositorio no incluye pesos en formato ComfyUI y, en el momento del lanzamiento, no existe un checkpoint convertido, una compilación GGUF ni un loader para ello, por lo que la vía de ComfyUI para Lightning sigue siendo el LoRA de la v1.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.