Krea 2 Turbo en 3 pasos: LoRA de destilación con más detalle
Un LoRA de rango 64 reduce Krea 2 Turbo de 8 pasos a 3 con cfg 1.0, mide una textura fina 1.11x la del maestro y se acompaña de un flujo de trabajo de ComfyUI con nodos estándar.
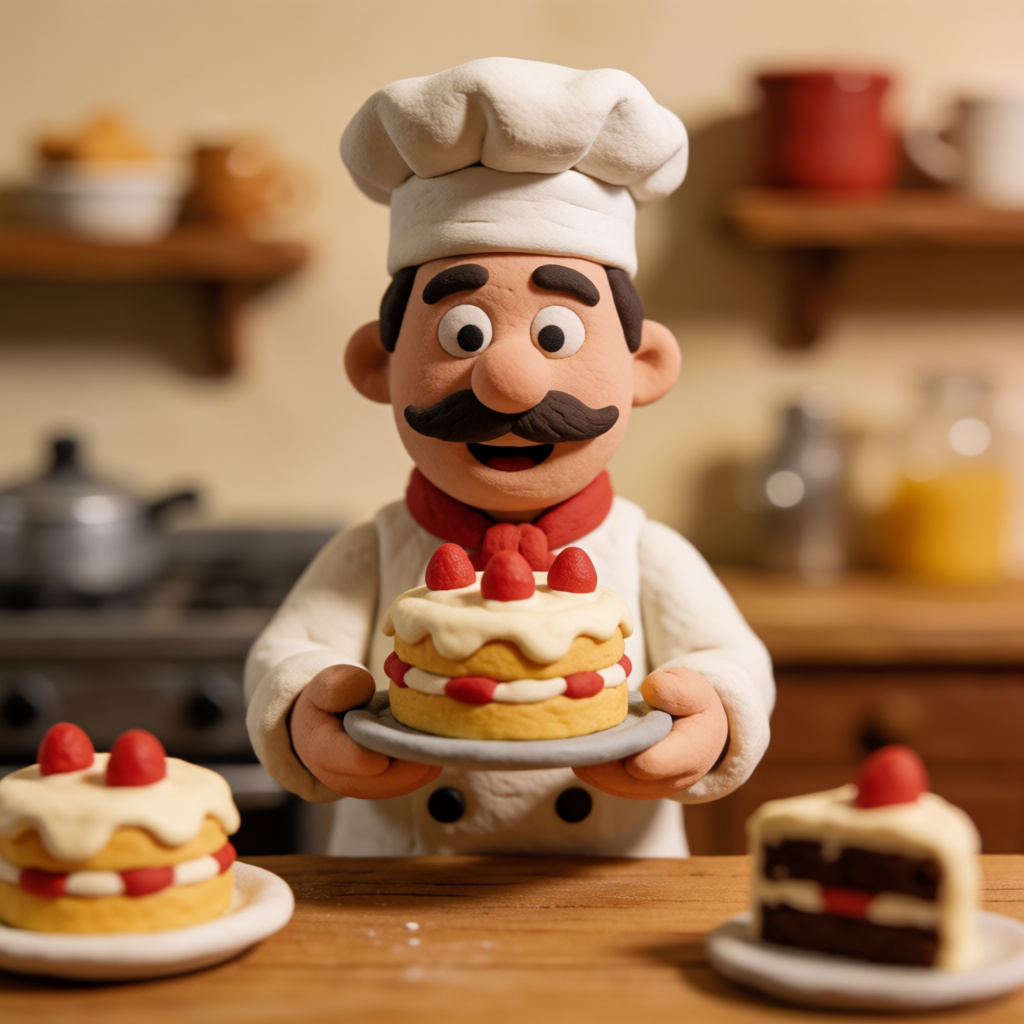
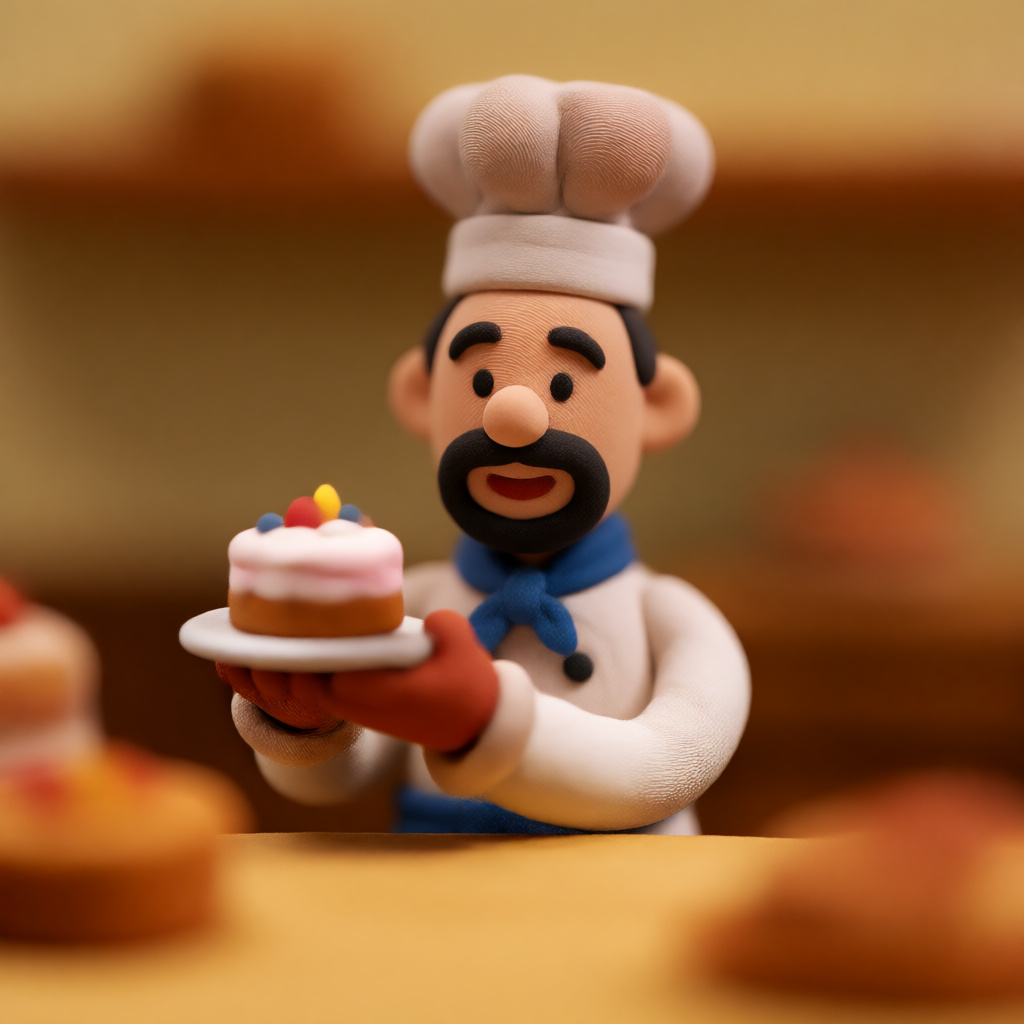
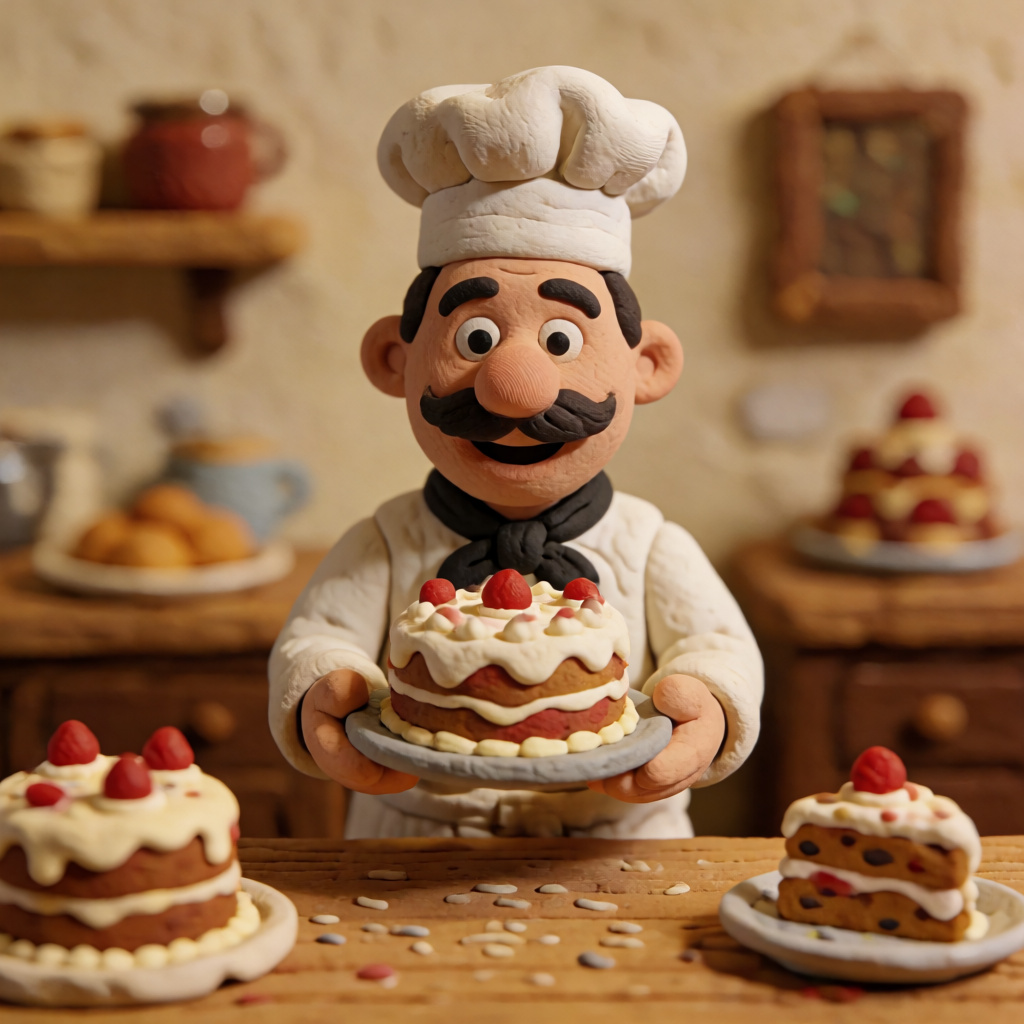
El mismo autor que llevó Krea 2 Turbo de 8 pasos a 4 y luego hasta 2 ha cubierto el hueco intermedio: este adaptador ejecuta el modelo en 3 pasos, con una eliminación de ruido unas 2.6 veces más rápida (de 65.4 s a 24.9 s a 1024x1024, float16, sin contar la codificación de texto ni la decodificación VAE), mientras mide una textura fina 1.11x la del maestro de 8 pasos en los 22 prompts de prueba del autor, frente a 1.04x del adaptador de 4 pasos. El Turbo de serie a 3 pasos se queda en 0.58x, que es justo el hueco que cierra este LoRA.
 |  |  |
|---|---|---|
| Turbo, 8 pasos: el listón de calidad | Turbo a 3 pasos, sin LoRA: blando y plano | 3 pasos con el LoRA: detalle restaurado |
El proyecto sigue en entrenamiento: el checkpoint compartido ahora es chk00030000, tomado de pesos ya estabilizados donde las últimas 600 muestras aplican un annealing de la tasa de aprendizaje hasta cero, y el autor espera más checkpoints. Los dos archivos de pesos del repositorio contienen ese mismo checkpoint con los nombres de claves de diffusers y de ComfyUI.
Tres pasos con el propio schedule de Turbo
El estudiante hace tres llamadas con los sigmas de 3 pasos propios de Turbo, [1.0, 0.8633, 0.6123], con el mu canónico del modelo de 1.15 y sin orientación. El entrenamiento partió de los pesos del adaptador de 4 pasos publicado, manteniendo su forma: rango 64 sobre los mismos 228 módulos. Se tomaron alrededor de 30.000 muestras de trayectorias grabadas del maestro en 11 resoluciones, desde 512x768 hasta 1440x1440 y 1824x1024.
Dos cosas cambian respecto a los adaptadores anteriores. La base se ejecutó en bf16 en una sola H100/H200 (los proyectos de 4 y 2 pasos se entrenaron en una RTX 3090 contra una base int8 solo de pesos), unas 91 horas para las 30.000 muestras. Y el objetivo sigue siendo el emparejamiento de distribuciones en lugar de la imitación de trayectorias: al estudiante lo puntúan ocho críticos montados sobre las propias características de la red intermedia de la base congelada, que cubren artefactos, verosimilitud de fotografía real, composición de la primera llamada, contenido, coincidencia con el prompt, rotulación, rostros grandes y todo el despliegue de tres llamadas. Igualar lo que el maestro produciría con probabilidad, en lugar de su ruta exacta, es lo que evita que tres pasos se diluyan en desenfoque y bordes duplicados.
Las bandas medidas concuerdan con eso: textura fina 1.11x la del maestro, las bandas de 16 píxeles y 8 píxeles en 1.10x y 1.12x, y el color al nivel del maestro.
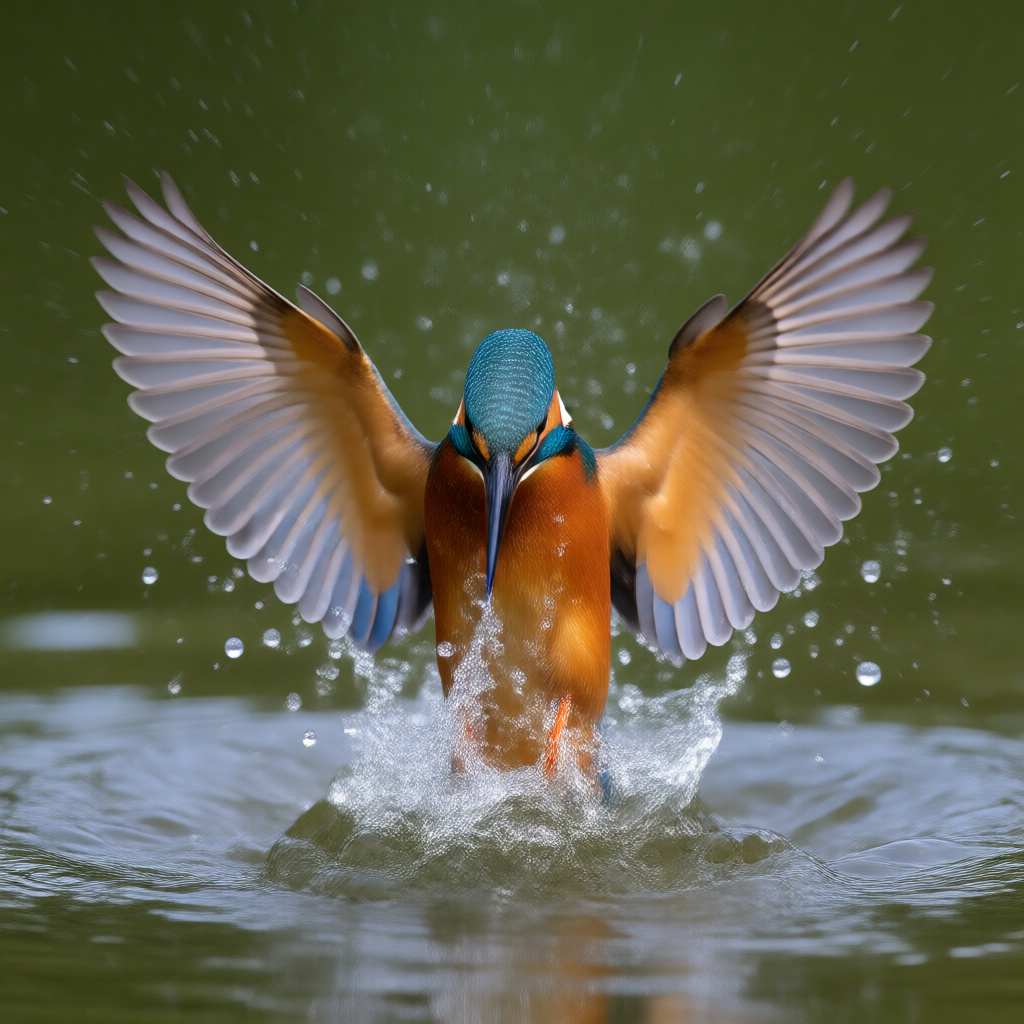
Turbo a 3 pasos con el prompt del martín pescador, sin el adaptador. La versión del LoRA con la misma semilla y el mismo prompt es la imagen de portada.
Qué cede a cambio
El autor publica los costos junto a las ganancias, y merece la pena leerlos antes de cambiarlo:
- Más lejos de la imagen del maestro que el adaptador de 4 pasos: distancia 0.401 frente a 0.320, coincidencia de detalle 0.26 frente a 0.39. Tres pasos es un camino más corto desde el mismo ruido, así que el encuadre, la pose o algún elemento pequeño pueden diferir del render de 8 pasos con la misma semilla. La imagen del maestro es una referencia de calidad, no un objetivo que reproducir.
- Textura más fuerte que la del maestro: el grano en zonas planas mide 1.57x el del maestro, frente a 1.29x en la versión anterior. El papel de acuarela, los poros de la piel y el grano de película se ven más marcados; una fuerza por debajo de 1.0 lo suaviza.
- Bordes duplicados tenues en el pelo, las estrías de lluvia y las extremidades finas, sobre todo a 768x1024 y 1024x768: el índice de ghosting es 1.14x el del maestro, mientras que el adaptador de 4 pasos se sitúa en 1.02x.
- Los rostros pequeños en multitudes siguen siendo el punto débil de cualquier adaptador de pocos pasos.
La ventana útil de fuerza del LoRA es estrecha alrededor de 1.0, ya que con tres pasos el adaptador hace todo el trabajo de convertir llamadas toscas en una imagen terminada. Cuando la cercanía al render propio del maestro importa más que la velocidad, el adaptador de 4 pasos es la mejor herramienta.
Uso en ComfyUI
El repositorio incluye krea2_turbo_3step_rank_64_lora_comfyui.safetensors con los nombres de claves de ComfyUI, además de krea2_turbo_3step_lora_t2i.json, un flujo de trabajo construido solo con nodos estándar.
| archivo | dónde colocarlo |
|---|---|
krea2_turbo_3step_rank_64_lora_comfyui.safetensors | ComfyUI/models/loras/ |
krea2_turbo_bf16.safetensors (de Comfy-Org/Krea-2) | ComfyUI/models/diffusion_models/ |
qwen3vl_4b_bf16.safetensors (mismo repositorio) | ComfyUI/models/text_encoders/ |
qwen_image_vae.safetensors (mismo repositorio) | ComfyUI/models/vae/ |
Configuraciones: pasos 3, cfg 1.0, muestreador euler / simple, fuerza del LoRA 1.0.
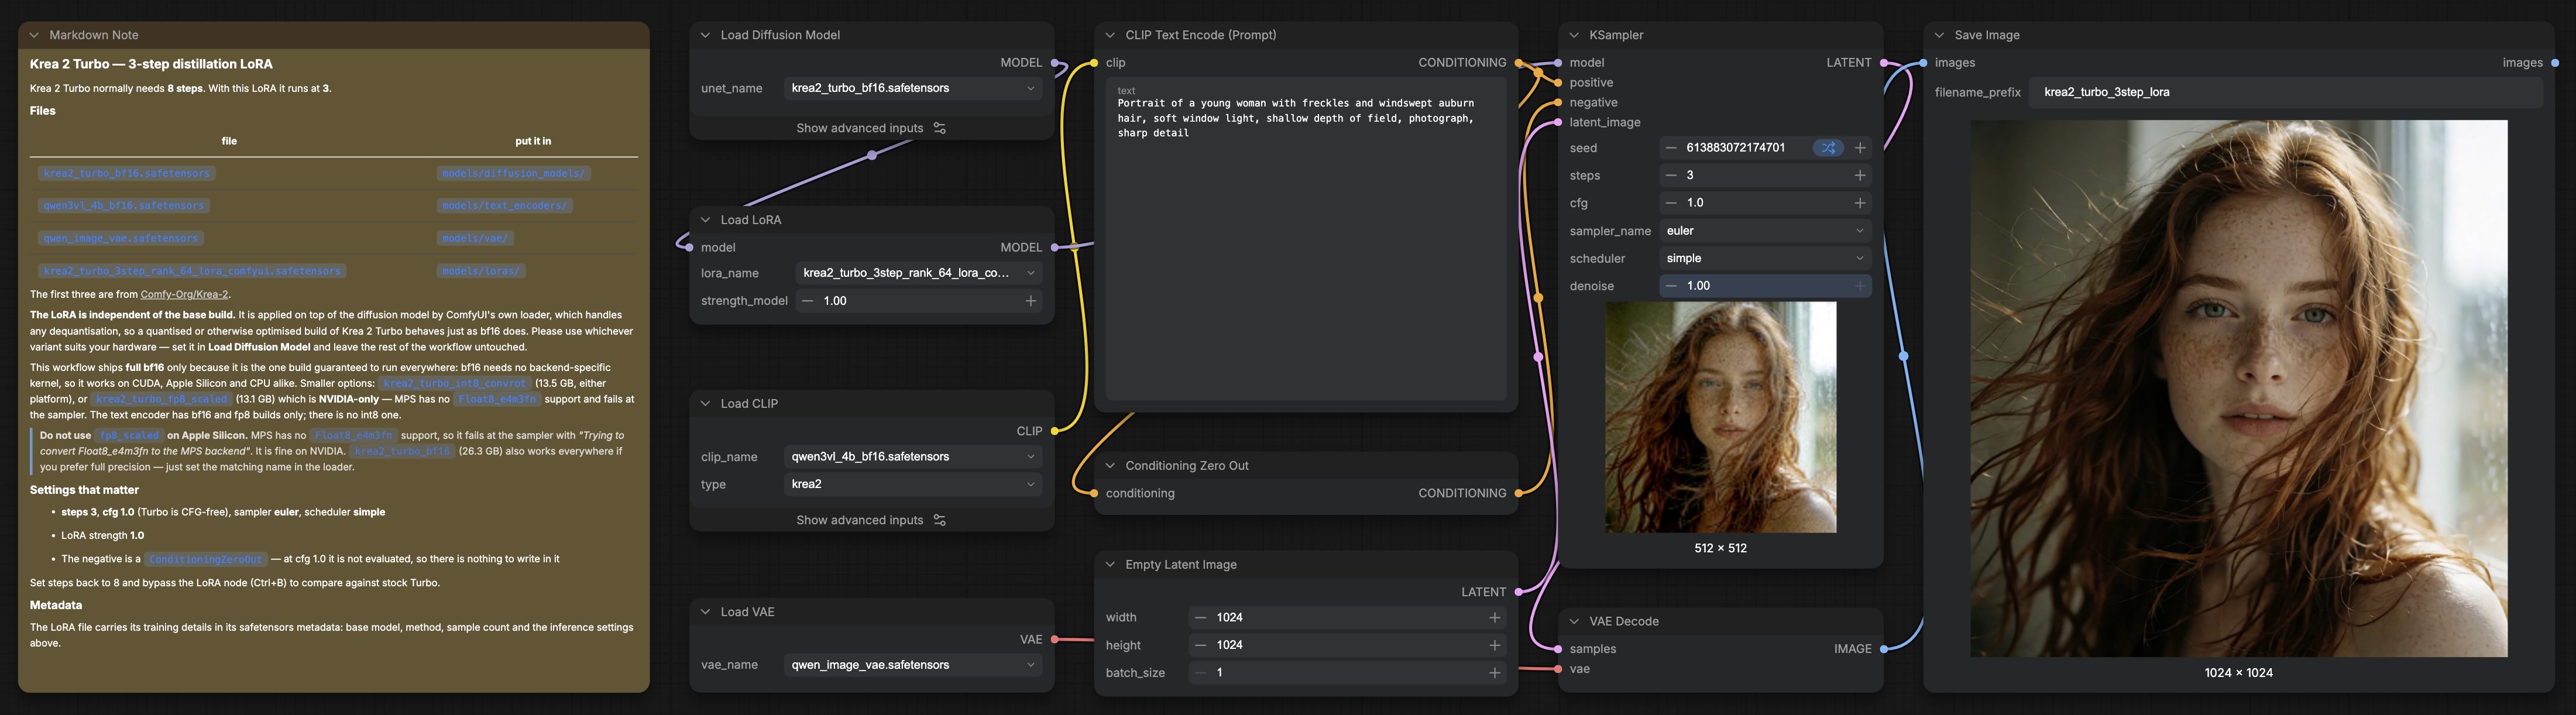
El flujo de trabajo incluido: Krea 2 Turbo más el LoRA de 3 pasos, solo con nodos estándar.
guidance_scale=0.0 del ejemplo de diffusers es esa misma configuración escrita a la manera de diffusers.
Dos advertencias de la tarjeta del modelo. Una base cuantizada cambia detalle por memoria: en el Turbo de 4 bits (nvfp4) de Comfy Cloud, la textura fina del adaptador midió aproximadamente una quinta parte por debajo de un render completo en bf16. Y en Apple Silicon, las compilaciones fp8_scaled no se cargan, porque MPS no tiene Float8_e4m3fn; hay un flujo de trabajo MLX aparte en el repositorio que ejecuta el mismo LoRA mediante el nodo MLX Krea 2 de LVNodes del autor.
Como extra, también se carga en Krea 2 Raw, que comparte la arquitectura: en Raw a 13 pasos con CFG 3.5 conserva la composición de Raw y añade detalle que Raw no alcanza con ese número de pasos. El autor es explícito en que esto es terreno no entrenado, no un modo compatible.
Disponibilidad
- Hugging Face: lvladikov/Krea2-Turbo-Distill-3step-LoRA, con 22 hojas de comparación y el informe completo del entrenamiento en
DETAILED-README.md - El LoRA de 4 pasos sigue siendo la opción más cercana a la salida de 8 pasos de Turbo; el LoRA de 2 pasos sigue siendo la opción de vista previa
- Todas las mediciones anteriores son del propio autor, tomadas sobre 22 prompts de prueba; la tarjeta enumera los problemas conocidos por orden de frecuencia de aparición
Comentarios
Inicia sesión con GitHub para unirte a la conversación.