Tessera: escalado 4K y 8K por mosaicos para vídeo de MiniMax H3
Tessera es un paquete de nodos de ComfyUI que refina clips de MiniMax H3 mosaico a mosaico hasta 2K, 4K y 8K, con condicionamiento por mosaico y VAE en flujo.
H3 funciona bien con clips cortos a 544p y resulta costoso por encima de eso. Las rutas existentes hacia una mayor resolución o bien regeneran el fotograma a un tamaño mayor y aceptan una pasada más lenta y menos estable, o bien escalan los píxeles y pierden detalle. Tessera toma una tercera ruta: conservar el clip de origen como la referencia que el modelo ya entiende, escalar la imagen con un remuestreador neutro y dejar que H3 vuelva a renderizar cada tesela de esa placa bajo un acondicionamiento local exacto.
El paquete se distribuye como nodos ComfyUI simples sin dependencias adicionales, versión 1.0.0, y su pyproject.toml incluye un bloque [tool.comfy] (DisplayName = "Tessera", PublisherId = "hashu786") para la publicación en Comfy Registry.
 | 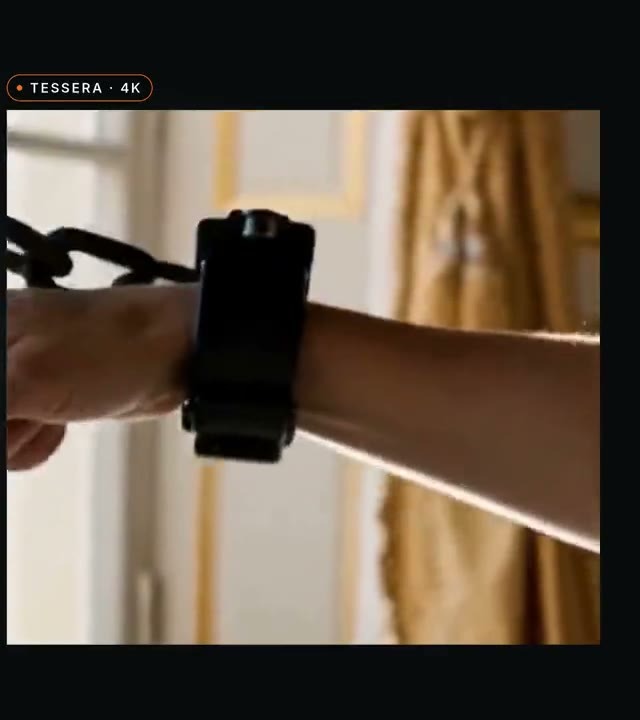 |
|---|---|
| Clip de origen a 544p | Render de 3840x2176 del vídeo promocional del proyecto |
Teselas ancladas a la placa, no entre sí
La forma obvia de refinar un latent grande por partes es recorrer las teselas en orden y dejar que cada una herede el borde finalizado de sus vecinas. El autor de Tessera midió por qué eso falla con H3: la deriva de registro se acumula a lo largo de una fila, en +1.5, -2.1, -9.3 y -15.5 px a lo largo de cuatro teselas, porque cada tesela se condiciona con la suposición de la tesela anterior en lugar de con la fuente.
Tessera invierte la dependencia. Cada tesela se somete a denoising con sus propios recortes de la misma verdad de referencia:
- Referencias DiT: se recortan a la ventana de la tesela y se asignan a la cuadrícula latente de esa ventana, de modo que la referencia de vídeo y la referencia de imagen opcional muestran el fragmento de la tesela en el fotograma, no el plano completo.
- Texto: se vuelve a codificar a partir del propio recorte de la tesela cuando hay una entrada
clipconectada. Sin ella, el nodo de referencia estándar entrega a Qwen el fotograma completo y a cada tesela se le indica un sujeto que puede no contener, lo que las notas llaman el fallo del sujeto fantasma. - Guías: permanecen en la cuadrícula exacta de la placa, y el nodo falla de inmediato si no coinciden.
Las teselas también comparten un único campo de ruido global en lugar de generar ruido por tesela, y las franjas a lo largo de una costura las generan ambos vecinos con una banda seam_regen de 32 px, y luego se mezclan mediante acumulación normalizada por peso. Dos teselas que vieron la misma franja producen un fundido cruzado exacto de render a render en lugar de una mezcla fantasma.
El schedule consta de un paso de cabeza y dos pasos de cola
Los sigmas por defecto son 1.0, 0.7, 0.4, 0.0: un paso con la cabeza turbo destilada y después dos pasos de euler en la cola fina. La guía in-band se trata como un clamp de espectro, por lo que solo recibe ruido durante la cola (guide_release 0.8) en lugar de durante toda la ejecución. La cabeza decide la estructura con toda la evidencia, la cola añade textura con libertad y, al llegar el traspaso, ya hay suficiente señal comprometida como para que el contenido no pueda moverse.
Medido en el clip de referencia del autor, esa combinación aporta +67 % de detalle local por tile frente a la línea base de borde congelado, con un shimmer cercano al de la línea base, y cambiar el mismo schedule de LMS a euler dio +56 % de detalle a la vez que reducía el shimmer en alrededor de un tercio. Dos pasos de cabeza es peor, no mejor: converge el estado hacia la guía suave y cuesta un 21 % de detalle, y un modelo turbo destilado al que se le dieron dos pasos por sigmas intermedios emitió NaN en el latente en una de las ejecuciones medidas.
Los tiles sin rasgos se omiten en lugar de muestrearse. Un recorte de placa plana da al modelo cero evidencia y total libertad, y el autor lo sorprendió pintando la cara de referencia en el cielo vacío y el humo, algo aún peor cuando se activó la recodificación de texto por tile. flat_skip (por defecto 4.0) mantiene la placa en esas ventanas y devuelve el tiempo de muestreo. La decisión se toma por tile y por chunk según la energía de píxeles de la fuente, ya que dos métricas en espacio latente resultaron falsas de forma consecutiva.
Streaming de las partes que no caben
A 4x, un clip de 15 segundos ocupa aproximadamente 36 GB como un IMAGE de ComfyUI en float32, por copia, y el gráfico simple contiene tres copias más dos codificaciones del clip completo. Eso produce OOM en cualquier GPU, por lo que Tessera divide el trabajo:
- Codificación por streaming escala y codifica con VAE la fuente en ventanas temporales sobre la cuadrícula de bloques de 17 px de H3, con una recodificación de calentamiento de 22 px por ventana que se descarta. En una ejecución validada de 544p a 4K, el búfer de píxeles máximo del lado de la codificación fue de unos 5.2 GB, frente a 57.6 GB de la copia del clip completo que provocó OOM en el gráfico simple.
- Decodificación por streaming ensambla la salida mediante una única decodificación por streaming, con un búfer respaldado por disco por encima de 4 GB. Un lienzo 8K de 124 cuadros había fallado antes al asignar 49.7 GB en la decodificación monolítica.
- Se ejecuta una verificación previa del disco antes de que se muestreen los primeros mosaicos, porque la necesidad de espacio temporal de la decodificación se puede conocer en la etapa de planificación. Una ejecución de muestreo 8K ya había consumido 8 horas y 49 minutos antes de fallar al asignar un búfer de 67.6 GB.
- Seguro contra fallos: si la etapa de salida falla de todos modos, el latente refinado se guarda como
tessera_rescue_<timestamp>.latenty el gráfico aún devuelve un latente, por lo que LoadLatent más el decodificador por streaming recuperan el render sin remuestreo.
Los clips largos con movimiento rápido pasan por Temporal Dilate / Decimate, que aumenta la frecuencia de cuadros por tramo y vuelve a sincronizar temporalmente la salida en el camino de vuelta. Las ventanas de fragmentos se presupuestan en segundos reales de contenido: la dilatación divide el contenido en cada ventana, por lo que la ventana temporal escala con el factor de dilatación para conservar la misma cantidad de estructura de movimiento por ventana. El planificador también ajusta cada inicio de ventana de tramo medio a un múltiplo de 5 latentes, lo que coincide con la propia temporización de tokens de H3: un token de cabeza y luego cuatro cuadros por token, después de que una prueba de 15 segundos mostrara un metrónomo de parpadeo de cuadros de 17 px a lo largo de cada fragmento desalineado.
Ejecuciones medidas
La ejecución de referencia del autor para la ruta de 544p a 4K: un clip de 15 segundos, 617 fotogramas dilatados, 18 ventanas, 24 tiles en 3 fragmentos ajustados, 3 horas en total en una GPU. La oscilación entre fotogramas quedó en 2,44 % de media y 16,1 % de pico, frente al 2,32 % y 12,3 % de la referencia 2x del mismo clip, sin que quedara la firma de 17 fotogramas en la autocorrelación.
Ejecuciones publicadas en el Discord de Banodoco el día después del lanzamiento, de personas que no eran el autor:
- LDWorks David, RTX 6000 Pro con pesos BF16: 121 fotogramas, de 2K a 4K, 84 pasos de refinado a unos 32 s/paso, 44 minutos para alcanzar el 93 %.
- seitanism: 1344x768, 362 fotogramas, dilatados temporalmente a 583 fotogramas y renderizados a 2688x1536 en 46:58; un segundo clip de 1920x1088 a 3840x2176 en 53:08; un tercero con una imagen fija de Qwen-Image 2.1 como ancla de fotograma en 27:48. Su lectura: no corrige todos los artefactos de movimiento, pero aguanta.
- mdkb, en una RTX 3060 de 12 GB, lo probó frente a su propio presupuesto de 20 minutos y pidió una receta para poca VRAM. La respuesta del autor fue que aún está por llegar: los valores predeterminados incluidos apuntan a tarjetas con mucha VRAM.
Uso en ComfyUI
Instala clonando el repositorio en ComfyUI/custom_nodes/. La consola de arranque muestra [Tessera] loaded 9 node(s) cuando todo se ha registrado correctamente.
| nodo | qué hace |
|---|---|
| Tessera Tile Plan | simulación previa: cuadrícula de tiles, distribución de chunks y coste antes de gastar tiempo de GPU |
| Tessera Streamed Encode | fuente a latente de placa más acondicionamiento guía, en ventanas temporales |
| Tessera Refine | el refinador por mosaico con acondicionamiento por tile, chunking, tiles destacados, omisión de tiles planos y salida a prueba de fallos |
| Tessera Streamed Decode | decodificador en streaming independiente, también la ruta de recuperación para latentes rescatados |
| Tessera Guide Anchor | empalma una imagen fija detallada en la banda fina de la guía, con corrección de desplazamiento y propagación de flujo |
| Tessera Temporal Dilate / Decimate | dilatación de la tasa de fotogramas y re-timing exacto por tramo |
| Tessera Guide Grain | grano emparejado para la guía |
| Tessera Extra Options | los ajustes expertos con los valores predeterminados validados |
El flujo de trabajo incluido conecta el clip fuente como referencia H3, una placa Lanczos a la escala elegida, un anclaje opcional al primer fotograma con Qwen-Image 2.1 y el par de LoRA que el autor usa como receta habitual (el LoRA de detalle LMS del paquete H3 de Alissonerdx y un LoRA turbo de 3 pasos). Está pensado para 4x sobre una fuente de 544p, terminando en 3840x2176.
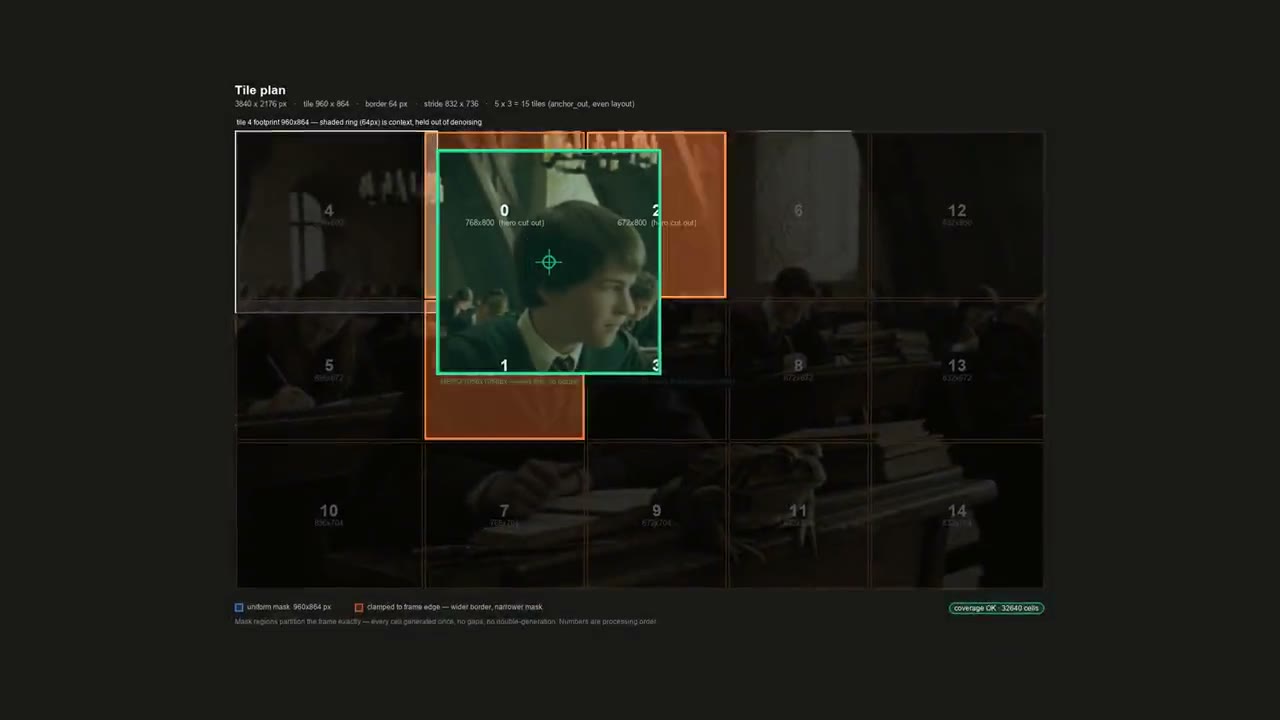
El nodo Tile Plan en el vídeo promocional: cuadrícula, chunks y coste previsto antes de una ejecución.
Modelos usados por el ejemplo: MiniMax H3 ref2va (la build int8 podada en la configuración del autor), los VAE de vídeo y audio de H3, el codificador de texto Qwen3-VL, además del checkpoint opcional Qwen-Image 2.1 con su LoRA turbo y VAE de corrección de texturas para la imagen fija de anclaje. El flujo de trabajo también requiere los paquetes de nodos SAM3 y KJ para los nodos opcionales de máscara de héroe y vista previa.
Límites que conviene conocer
- El ejemplo está configurado para un solo objetivo. El tamaño de salida esperado y el factor de escala son widgets independientes; ambos deben coincidir con el clip que cargues. Un probador de Discord ejecutó el flujo de trabajo incluido sobre un clip distinto esperando 2x y obtuvo un lienzo 4K que consideró peor que su fuente.
- El ancla de imagen fija es una herramienta de 2x. A 4x y más, las notas recomiendan dejarla desconectada y permitir que el modelo renderice la cabeza, porque el empalme hace un crossfade entre dos renderizados distintos de la misma textura.
- El shimmer de la fuente se hereda. Una fuente de baja resolución cuya propia banda fina oscila se escala hacia un movimiento ampliado y ondulante: el refinamiento eleva la coherencia hasta aproximadamente 0.75 y no puede superarla.
- Los cortes de escena son orientativos. El oráculo de cortes imprime los fotogramas que encontró y recomienda dividir el clip en ese punto; las tomas cortas dentro de una misma ventana no pueden satisfacer a la vez la regla de temporización de la cabeza y el presupuesto de tiempo de contenido.
- Los segundos saltos entran con sigma reducido, por ejemplo
1.0, 0.923, 0.55, 0.0, y la placa del segundo salto debería ser la salida del primero, no un intermedio re-suavizado.
Disponibilidad
- hashu786/ComfyUI-Tessera en GitHub, con
example_workflows/tessera_upscaler.jsony las notas de ingeniería completas endocs/LAWS.md pyproject.tomlincluye el bloque[tool.comfy]para el Comfy Registry (DisplayName = "Tessera"); en el momento del escaneo el paquete aún no estaba listado allí, así que instálalo desde el repositorio- Los fotogramas de referencia de este artículo provienen del vídeo promocional del proyecto, que compara la fuente de 544p con el render 4x
Comentarios
Inicia sesión con GitHub para unirte a la conversación.