Primal VAE: submuestreo 2x que iguala las formas latentes de Flux
Ostris publicó Primal VAE, dos autoencoders de ~80M de parámetros que submuestrean solo 2x, dejan el patchify 8x al DiT y no llevan factor de escala ni de desplazamiento.
2x1 submuestrea 2x a un solo canal, 2x2 a dos canales.
La mayoría de los VAE modernos comprimen la imagen 8x y luego entregan al modelo de difusión un latente que debe reescalarse con un factor de escala medido, un factor de desplazamiento o estadísticas de batch-norm. Primal VAE toma el camino opuesto: el VAE solo realiza una reducción espacial de 2x, y el propio paso de patchify del DiT aporta los 4x restantes. Un latente de 1 canal a 2x, parcheado 4 veces, se convierte en 16 canales a 8x, la misma forma que produce un VAE Flux.1; la variante de 2 canales llega a 32 canales a 8x, la forma del VAE Flux.2.
| modelo | latente | patch 4 | misma forma que |
|---|---|---|---|
2x1 | 1 ch @ 2x | 16 ch @ 8x | VAE Flux.1 (16 ch @ 8x) |
2x2 | 2 ch @ 2x | 32 ch @ 8x | VAE Flux.2 (32 ch @ 8x) |
Ambos checkpoints tienen unos 80M de parámetros, y los lados de la imagen deben ser múltiplos de 16.
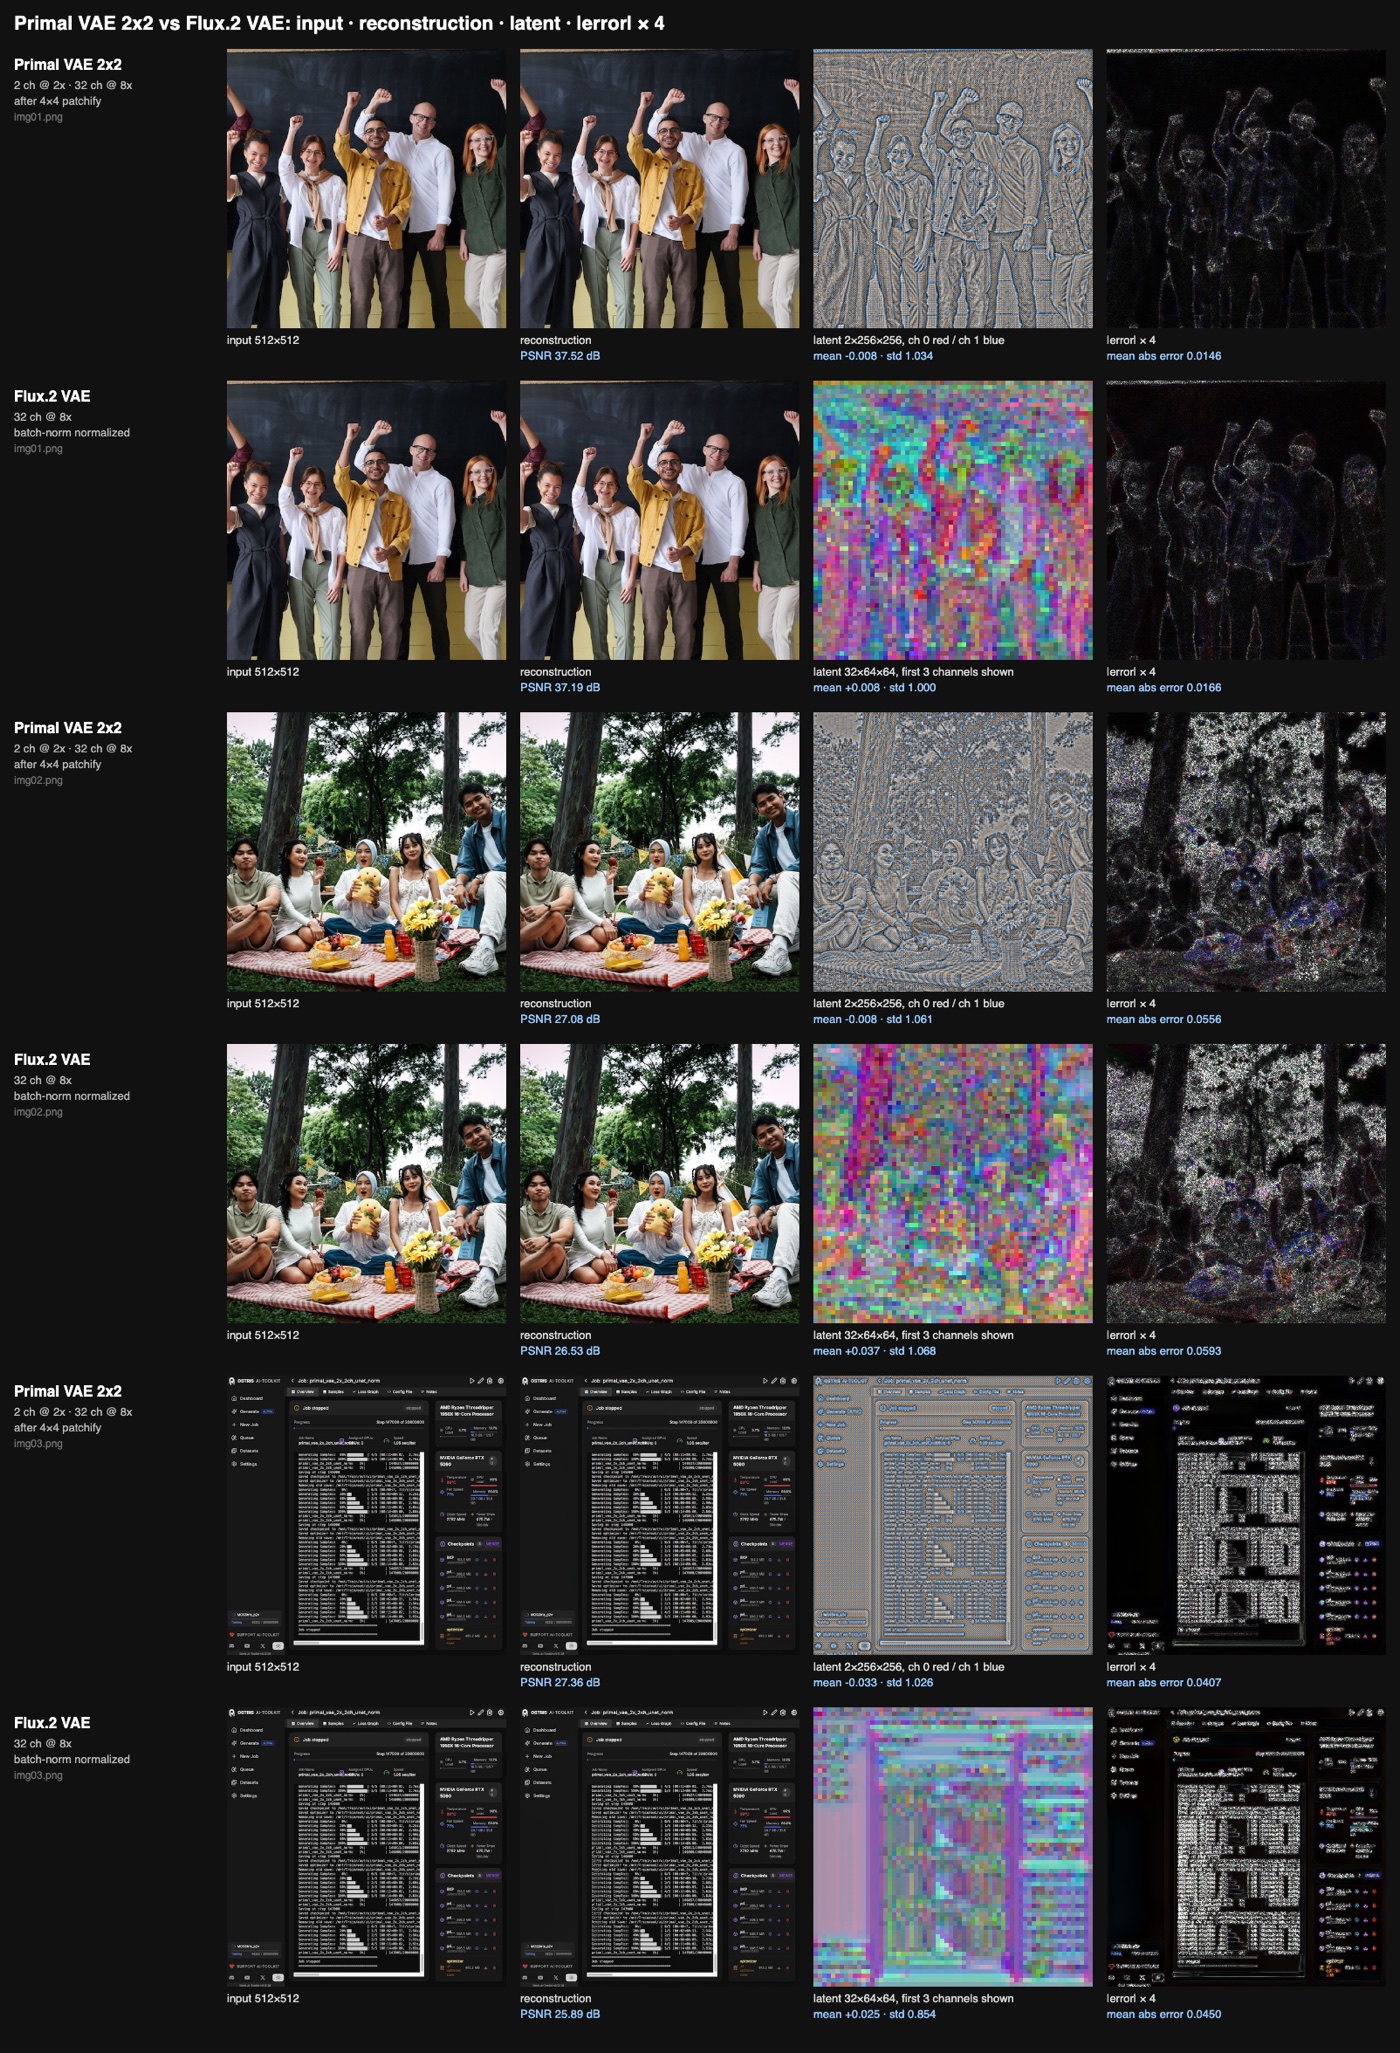
Cada fila es entrada, reconstrucción, latente y |error| x 4. Bajo cada fila de Primal VAE se sitúa el VAE Flux con la misma disposición de latente, sobre la misma imagen. Los latentes se dibujan a 3 sigma; el latente de dos canales pone el canal 0 en rojo y el canal 1 en azul.
Calidad de reconstrucción en las tres imágenes de 512 px del repositorio, en dB:
| imagen | Primal 2x1 | VAE Flux.1 | Primal 2x2 | VAE Flux.2 |
|---|---|---|---|---|
| img01 (personas, estudio) | 32.1 | 35.7 | 37.5 | 37.2 |
| img02 (pícnic, follaje) | 22.0 | 24.2 | 27.1 | 26.5 |
| img03 (captura de pantalla de interfaz) | 21.3 | 24.7 | 27.4 | 25.9 |
El autor afirma sin rodeos que tres imágenes y PSNR no son un benchmark, y que un VAE KL paga un peaje de reconstrucción por el ruido de su posterior que uno determinista no paga. La variante 2x2 iguala o supera al VAE Flux.2 con el mismo presupuesto de información de 32 valores por bloque de 8x8 píxeles. La variante 2x1 va por detrás del VAE Flux.1 en contenido texturizado: un canal a 2x es una reducción de 12:1 sin margen, y recibió bastante menos de la mitad de los pasos de entrenamiento que la ejecución 2x2 (62k frente a 147k).
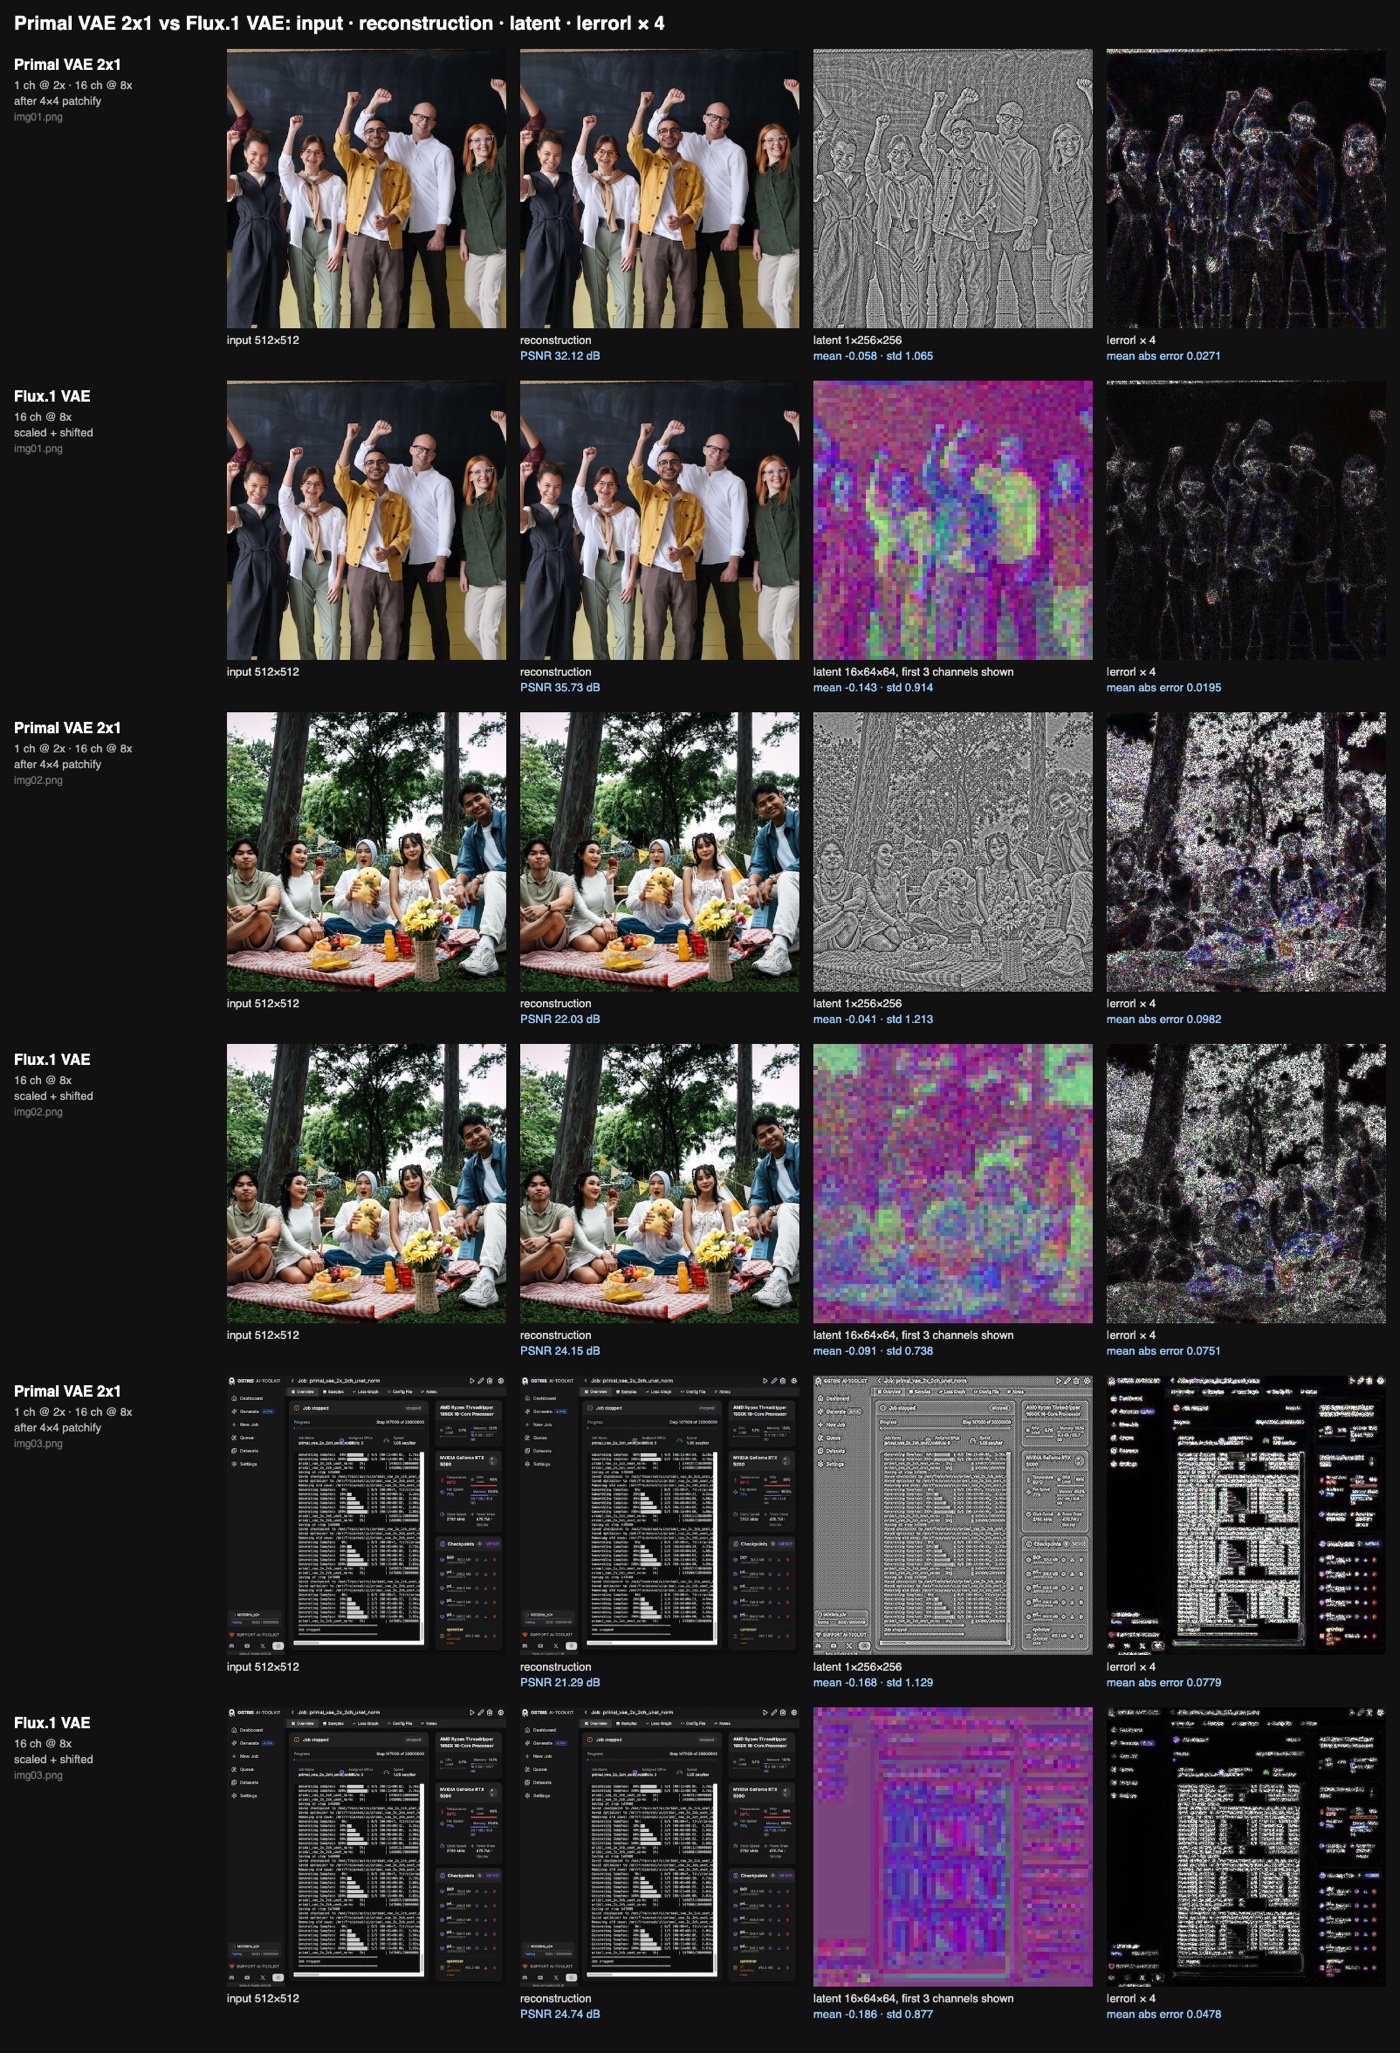
La comparación de 1 canal. El latente de un solo canal se muestra en gris y su desviación estándar por imagen todavía deriva, de 1.07 a 1.21, porque solo recibió la normalización por imagen durante sus últimos 9k pasos.
Arquitectura
Ambas variantes son la misma red y solo se diferencian en los canales de salida:
- La entrada pasa por
pixel_unshuffle(2), de modo que RGB se convierte en 12 canales a la mitad de resolución. Todo se ejecuta a la resolución del latente o por debajo, lo que mantiene el latente como un mapa espacialmente honesto de la imagen. - El codificador y el decodificador son U-Nets convolucionales simétricas con cuatro niveles a 1/2, 1/4, 1/8 y 1/16 del tamaño de la imagen, anchos de 96 / 192 / 384 / 384, y bloques residuales con dilataciones que ciclan 1, 2, 4.
- La normalización es RMSNorm sobre canales en cada posición. No hay estadísticas espaciales ni atención, por lo que un tile se codifica y decodifica igual que la imagen completa si hay cierto solapamiento.
- El codificador termina en una convolución 3x3 simple a 1 o 2 canales. Sin posterior, sin término KL, sin convoluciones de cuantización.
Mantener el latente en línea con el ruido
Un modelo de difusión se entrena contra ruido gaussiano, por lo que el latente ya debería parecerse a ruido gaussiano. En lugar de añadir un término KL y medir un factor de escala después, las estadísticas entran directamente en la pérdida sobre la salida del codificador:
- Pérdida de momentos:
mean^2 + (std - 1)^2con peso 0.1, calculada por imagen y por canal, de modo que cada imagen sale con media 0 y desviación estándar 1 en lugar de solo el conjunto de datos en promedio. - Pérdida de estadísticos de orden gaussianos: los valores del latente de cada imagen y canal se ordenan y se comparan con los estadísticos de orden esperados de una normal estándar del mismo tamaño, usando la aproximación de Blom. Esto fija toda la forma de la distribución en lugar de los dos primeros momentos, de modo que una imagen gris plana todavía se codifica en algo que se parece a ruido en vez de a una constante.
Gracias a eso, no hay factor de escala, ni factor de desplazamiento, ni normalización de latente que arrastrar, y la codificación devuelve un tensor simple en lugar de una distribución: encode da [B, 1, H/2, W/2] sin .latent_dist y sin paso de muestreo.
Entrenamiento
La reconstrucción es MAE a 0.5 y LPIPS a 1.0, más un término L1 sobre el espectro 2D de log-magnitud a 0.1 que empuja la energía de alta frecuencia sin exigir la fase exacta. Además, varios trucos buscan hacer el latente más fácil de difundir:
- Volteos y rotaciones del latente tomados de EQ-VAE: en el 50% de los pasos el latente se voltea o se rota 90 grados y se decodifica contra la imagen transformada de igual manera, de modo que el latente tiene que ser una imagen de la imagen y no un código arbitrario.
- Decodificación perturbada con ruido: en el 20% de los pasos el decodificador recibe
z + sigma * noiseconsigmaextraído por imagen deU(0, 0.5)y aún tiene que reconstruir la imagen limpia, lo que enseña al decodificador a tolerar el error de difusión. - El 5% de las imágenes se reemplazan por un color plano aleatorio, porque las regiones planas son el caso difícil para un latente normalizado por imagen.
- La variante 2x1 pasó sus últimos 9k pasos bajo un crítico: un ViT SigLIP2 NaFlex congelado aporta características de parche de las capas 4, 8 y 12 de la imagen real y la reconstruida a resolución nativa, pequeñas cabezas convolucionales con normalización espectral se entrenan con una pérdida hinge más R1, y el decodificador recibe el término del generador con peso 0.1. La 2x2 se entrenó sin crítico.
Los archivos de pesos publicados son los checkpoints de entrenamiento, sin cambios, en fp32. Cargarlos con torch_dtype=torch.bfloat16 para inferencia cuesta unos 0.05 dB.
Disponibilidad
Primal VAE todavía no es usable dentro de ComfyUI. No hay nodo cargador de VAE personalizado, ni repack de Comfy-Org, ni soporte en el núcleo: el repositorio incluye una implementación AutoModel de diffusers con trust_remote_code=True (modeling_primal_vae.py más config.json), y la ruta documentada es AutoModel.from_pretrained("ostris/primal_vae", variant="2x1") seguida de patchify / unpatchify para alcanzar la disposición de tokens de Flux.1 o Flux.2.
Una discusión del repositorio abierta el 31 de octubre pregunta directamente si puede ejecutarse en ComfyUI y todavía no tiene respuesta funcional; otra discusión de la comunidad ofrece una compilación Rust de un solo archivo para inferencia local en GPU o CPU.
Todo lo demás se queda en el terreno de Python: vae.encode(x) devuelve el latente, vae.patchify(latent, compression=8) lo convierte en tokens con la forma de Flux.1 o Flux.2, y vae.decode(vae.unpatchify(tokens)) lo recupera, sin escala ni desplazamiento aplicados en ninguno de los dos lados. La arquitectura se lee a partir de las formas de los tensores, así que un fine-tune exportado desde ai-toolkit puede cargarse con weights_name="my_finetune.safetensors".
Comentarios
Inicia sesión con GitHub para unirte a la conversación.