RelayVSR X2: un upscaler de vídeo 2x entrenado con clips H3
El equipo de LightX2V reentrenó RelayVSR para lograr una superresolución de vídeo 2x nativa, con 45 FPS en una H100, supresión del parpadeo y dos checkpoints.
scripts/relayvsr de LightX2V, y todavía no existe un nodo de ComfyUI para él.
Un clip H3 de 768x1344 se duplica limpiamente a 1536x2688, que es una resolución de acabado habitual. RelayVSR solo hacía 4x, así que el mismo clip llegaba a 3072x5376 y pagaba cuatro veces el trabajo de píxeles para una salida que la mayoría de los planos no necesita. X2 calcula a 2x en lugar de calcular a 4x y reducir después.
Primero el parpadeo, después la nitidez
Los modelos de superresolución tienden a amplificar el ligero parpadeo temporal que el vídeo generado ya trae consigo, por lo que el clip escalado puede verse peor en movimiento que la fuente, incluso cuando los fotogramas individuales se ven más nítidos. El diseño de RelayVSR apunta a eso: un modelo generativo grande escribe latentes de referencia solo para keyframes dispersos, y una pequeña red VSR transporta esas referencias a través de cada fotograma, con un lookahead acotado y una caché KV en anillo de fotogramas en la implementación de LightX2V.
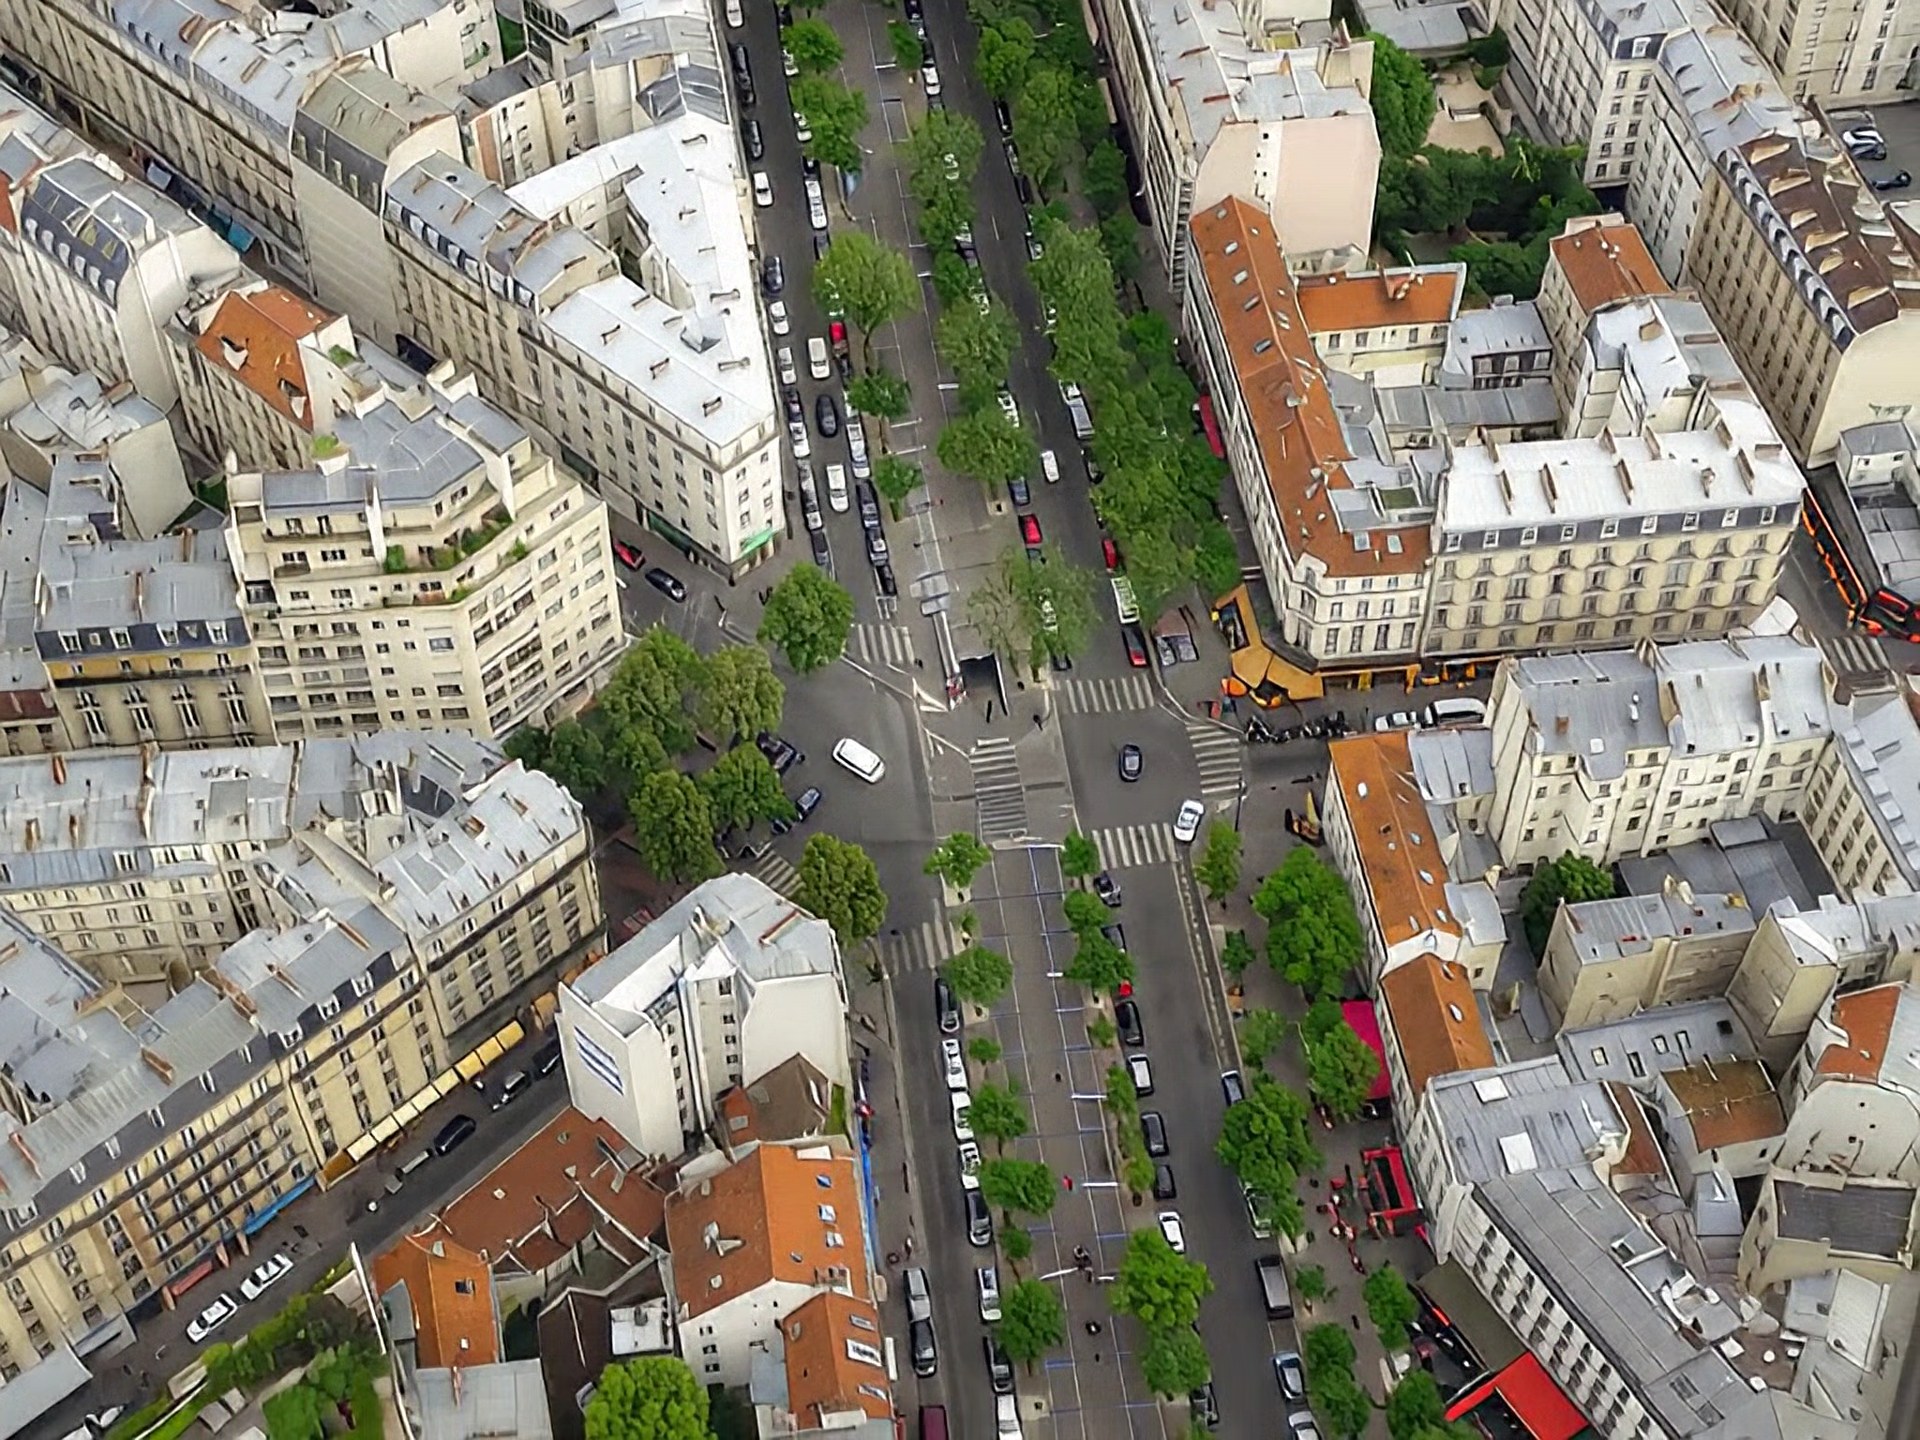
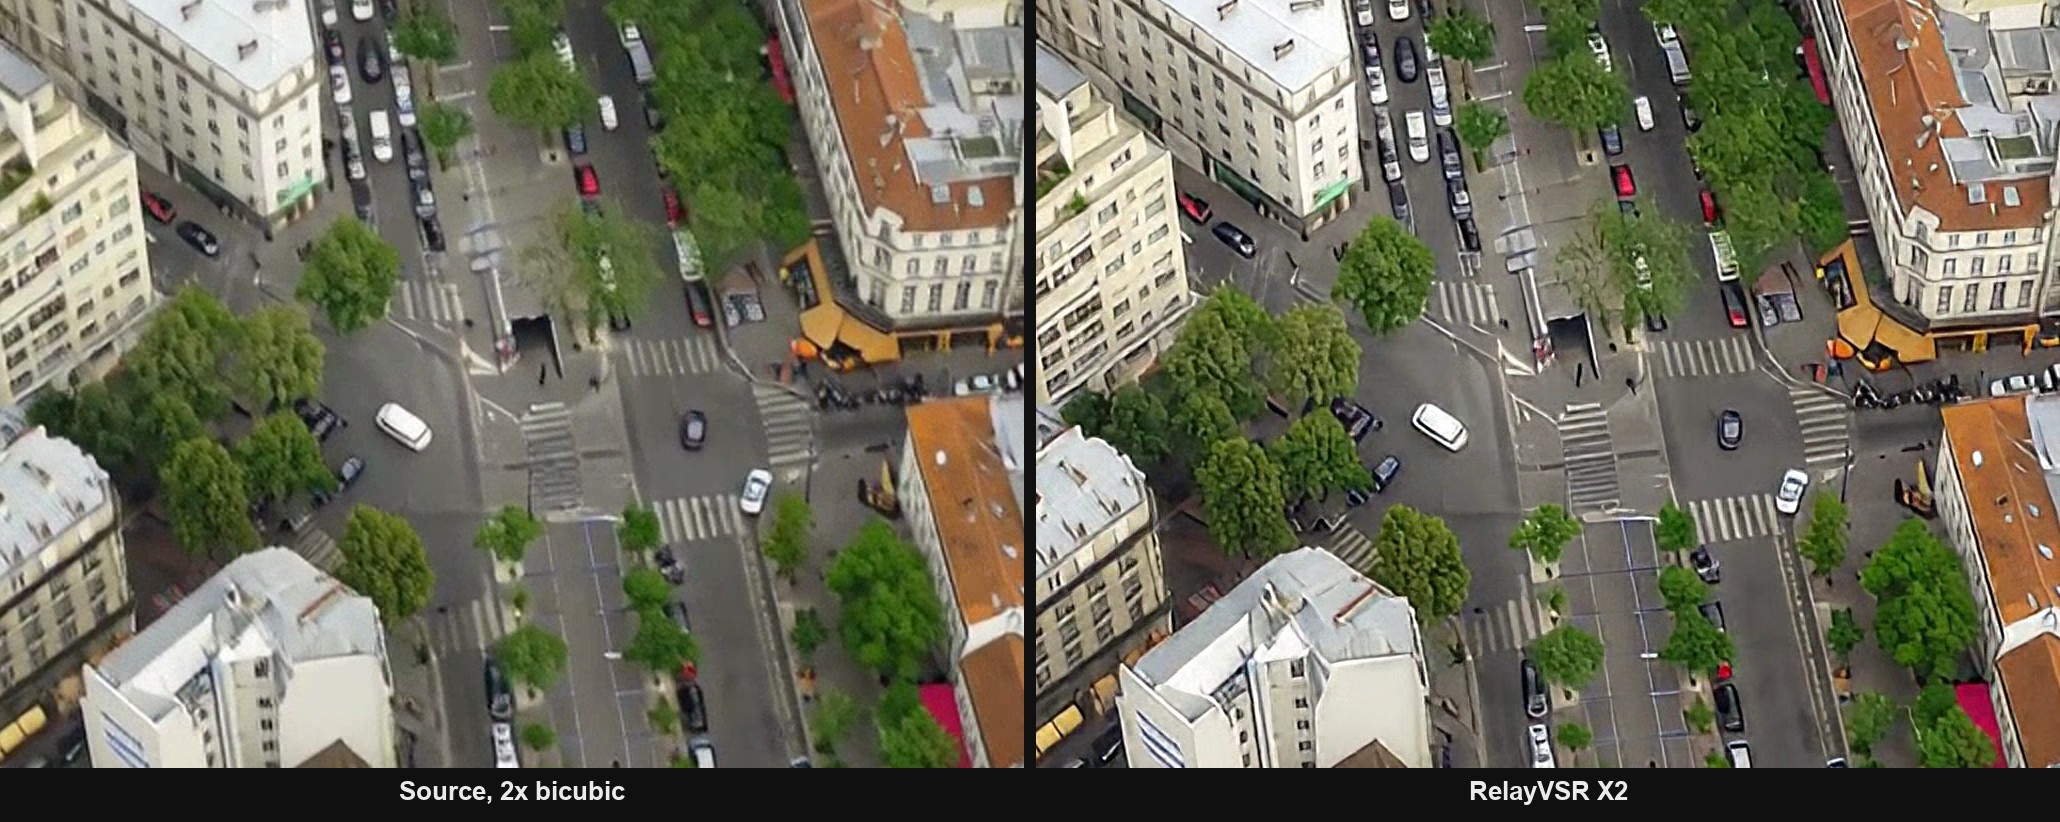
La entrada del benchmark publicado es en sí misma salida de H3, un clip de dron sobre tejados a 1024x768 y 24 fps con un ligero parpadeo preexistente, así que la cuadrícula comparativa muestra el caso alrededor del cual se entrenó el modelo y no metraje limpio de cámara.
Dos checkpoints, una escala
La versión X2 se distribuye como dos archivos que deben descargarse en el mismo directorio:
wan_x2.safetensors(10.1 GB), el checkpoint basado en Wan que genera las referencias de keyframes dispersos.flash_x2.safetensors(127 MB), el decodificador condicional compacto que aplica superresolución a los fotogramas restantes.
El runner de LightX2V valida la escala y la arquitectura, y rechaza pesos 2x y 4x mezclados en lugar de cargar un par que no coincide. El tamaño de salida no es un ajuste del usuario: se deriva de las dimensiones de entrada y de sr_ratio, que debe ser 2 para el modelo X2. El checkpoint 4x anterior todavía acepta sr_ratio=2, pero calcula internamente a 4x y reduce el tamaño después, que es justo el coste que esta versión existe para evitar.
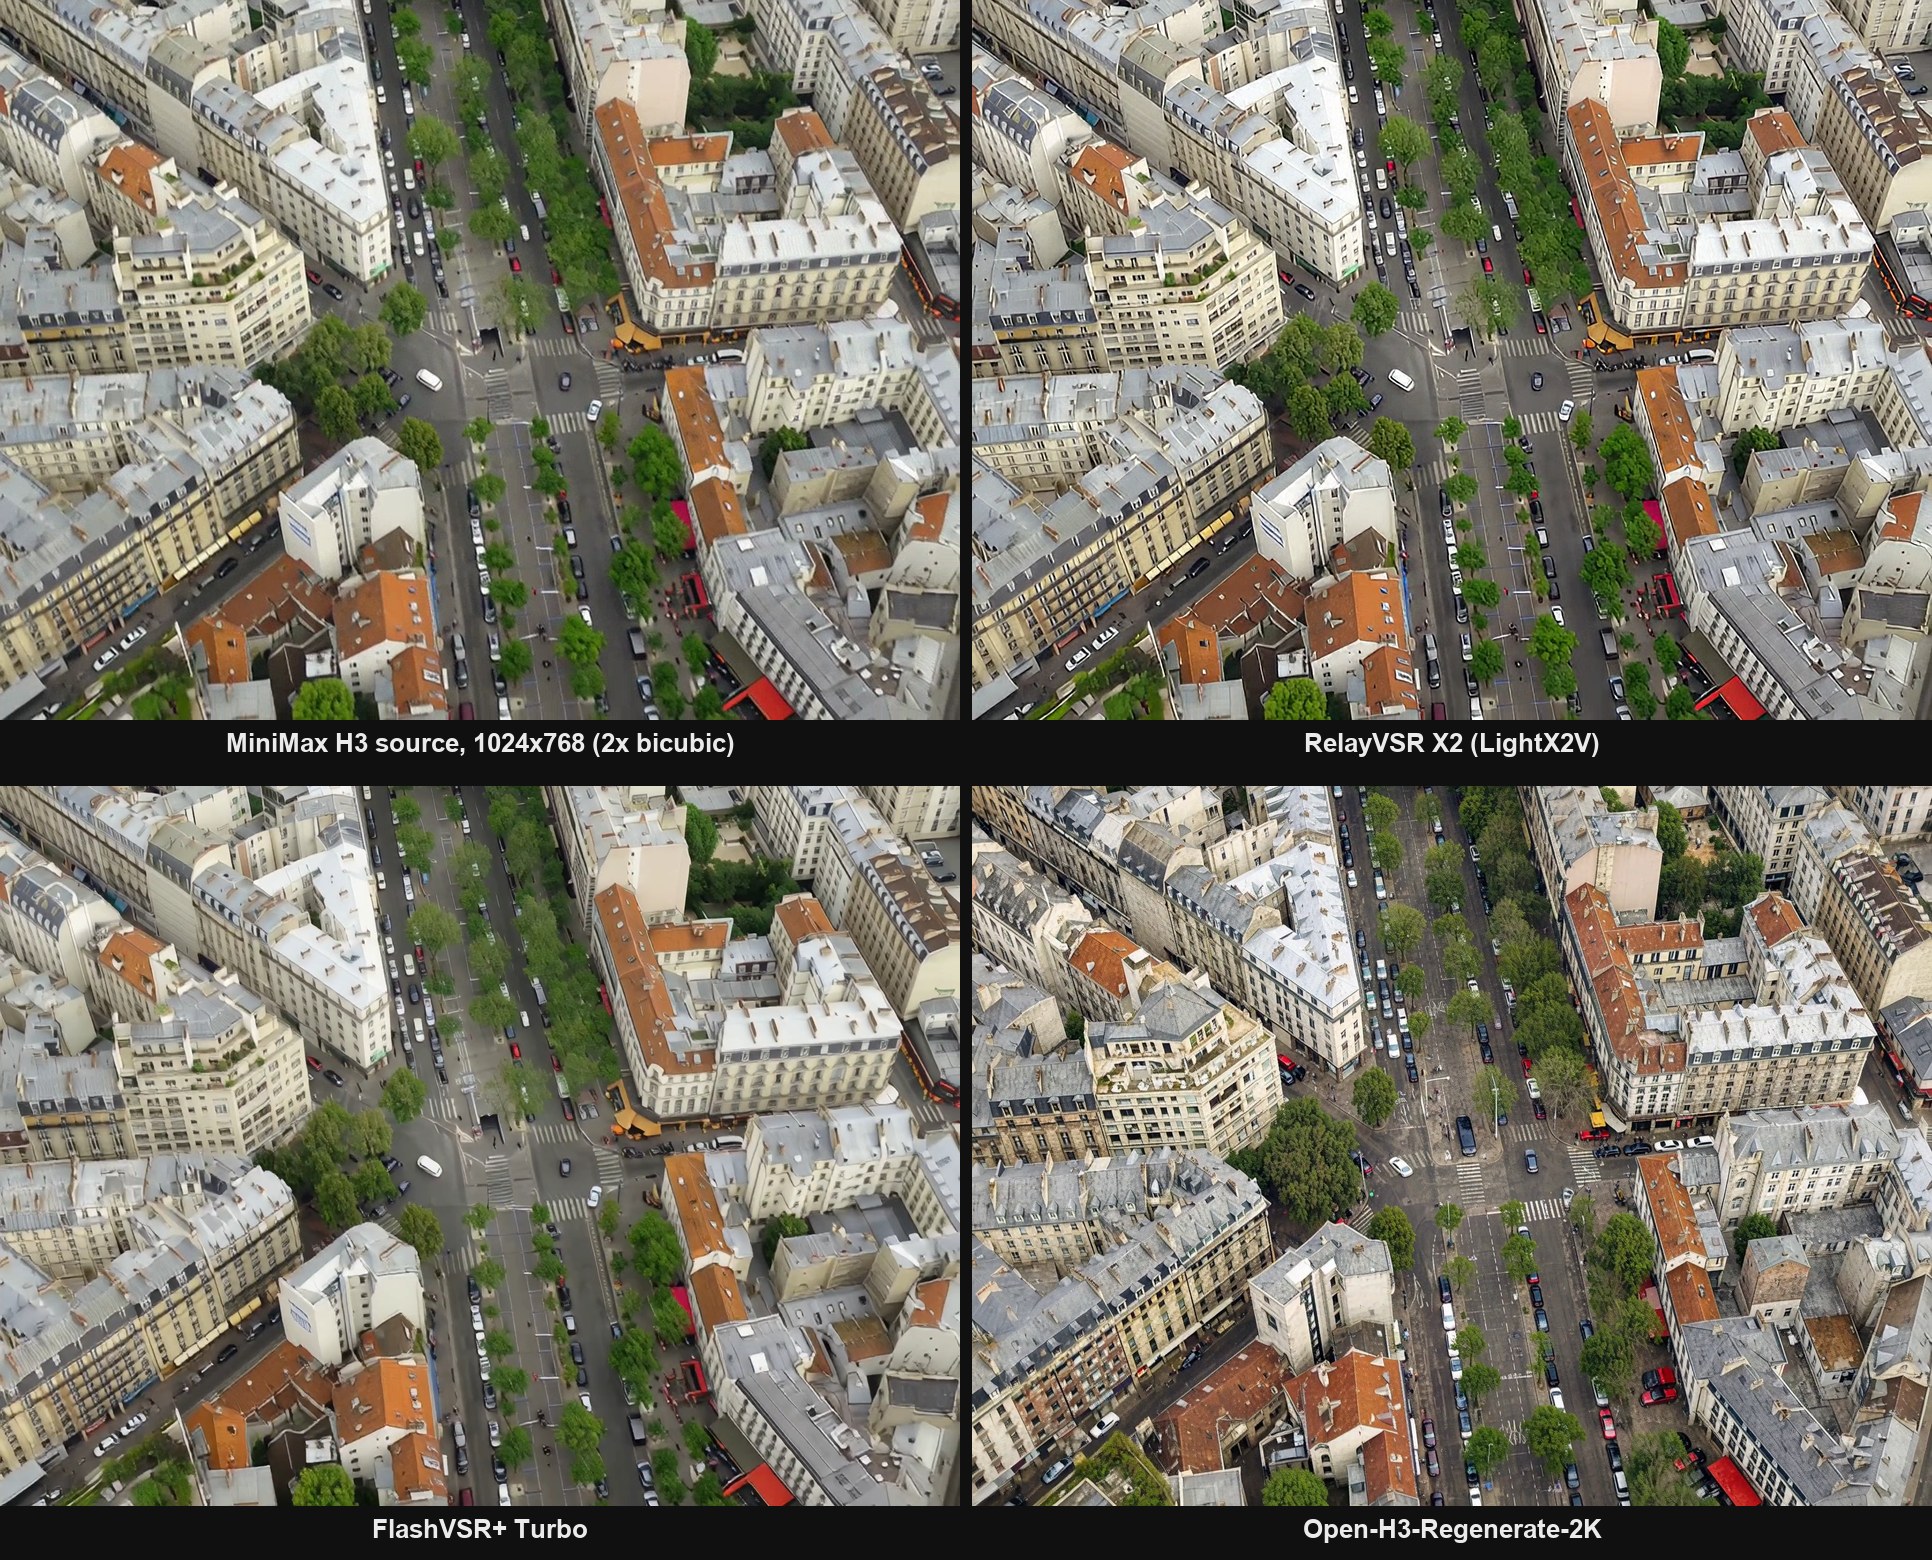
El mismo fotograma a un tamaño de visualización de 960x720: fuente H3 escalada 2x con bicúbica (arriba a la izquierda), RelayVSR X2 (arriba a la derecha), FlashVSR+ Turbo (abajo a la izquierda) y Open-H3-Regenerate-2K (abajo a la derecha). Fotogramas de los clips del benchmark publicado.
Medido en una sola H100
La tarjeta reporta una ejecución medida por modelo tras un calentamiento a la misma resolución, de forma secuencial en una única H100 de 80GB con PyTorch 2.11.0 y CUDA 13.0, sobre 243 fotogramas de 1024x768 a 24 fps:
- RelayVSR X2 (LightX2V): 5.348 s, 45.44 FPS, salida de 2048x1536
- SwiftVR (LightX2V): 6.399 s, 37.98 FPS
- SwiftVR: 7.252 s, 33.51 FPS
- RelayVSR 4x (LightX2V): 19.304 s, 12.59 FPS, salida de 4096x3072
- RelayVSR 4x: 26.332 s, 9.23 FPS, salida de 4096x3072
- FlashVSR+ Turbo: 54.024 s, 4.50 FPS
- SeedVR2-3B: 352.820 s, 0.69 FPS
- Open-H3-Regenerate-2K: 784.954 s, 0.31 FPS
Esos son números de H100 para un clip de 10 segundos. El paper del modelo 4x original reporta 29.29 FPS a 1080p en una A100 con 13.82 GB de memoria máxima frente a 7.80 FPS y 24.447 GB de FlashVSR-Tiny, así que la arquitectura está pensada para mantenerse dentro de una sola GPU en lugar de ganar en un equipo de benchmark.
Una medición temprana de un usuario en Banodoco sitúa la diferencia en el mismo rango en hardware de consumo: JohnDopamine leyó las marcas de tiempo de una ejecución en la que la etapa de acabado de Relay tardó unos 85 segundos mientras que FlashVSR+ registró 331 segundos (mensaje). El mismo clip, su propia GPU y configuración, así que conviene leerlo como una relación y no como una velocidad absoluta.
Cómo ejecutarlo
La inferencia vive en LightX2V, no en un paquete separado:
git clone https://github.com/ModelTC/LightX2V.git
cd LightX2V
hf download lightx2v/RelayVSR_X2 \
    wan_x2.safetensors flash_x2.safetensors \
    --local-dir ./models/RelayVSR_X2
Apunta scripts/relayvsr/run_relayvsr_x2_sr.sh a la copia clonada, a los pesos, a un vídeo de entrada y a una GPU, conserva --model_cls relayvsr_x2 con --config_json configs/relayvsr/relayvsr_x2.json y --sr_ratio 2, y ejecútalo desde la raíz del repositorio. La configuración predeterminada mantiene ambos checkpoints residentes con la compilación y el calentamiento activados; relayvsr_x2_block_offload.json descarga los bloques de Wan para reducir el uso de VRAM, y relayvsr_x2_sp.json divide un clip entre dos GPU.
Para trabajo repetido existe un modo de servidor residente: inicia python -m lightx2v.server --model_cls relayvsr_x2 --task sr, y luego envía la ruta de entrada, sr_ratio, la ruta de salida y la semilla a /v1/tasks/video/ por cada clip, de modo que los pesos se cargan una sola vez.
Disponibilidad
RelayVSR X2 es un lanzamiento de LightX2V: Linux más una GPU NVIDIA, ejecutado desde la CLI o el servidor, sin nodo ni wrapper de ComfyUI publicado todavía y sin pipeline de diffusers en el repositorio. El changelog de LightX2V menciona codificación asíncrona y audio de origen conservado, así que un clip H3 mantiene la pista con la que se generó. Quien lo quiera dentro de un gráfico tiene actualmente que envolver el runner por su cuenta.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.