Pika H3 Flex convierte MiniMax H3 en un LoRA de ComfyUI de seis pasos
Pika entrenó MiniMax H3 para crear Pika H3 Flex, un modelo de seis pasos distribuido como dos LoRA de ComfyUI con tres plantillas oficiales y control de 12 referencias.
Pika H3 Flex es la versión post-entrenada de MiniMax H3 según Pika: el mismo modelo omni de 33B, reentrenado con un corpus interno de audio y vídeo, destilado de un profesor de 50 pasos hasta seis pasos de muestreo y después refinado con aprendizaje por recompensa y optimización de preferencias. Pika publicó los pesos en Hugging Face, liberó el paquete de inferencia en GitHub y publicó un artículo técnico junto con la entrada de lanzamiento el 29 de octubre de 2026.
Para ComfyUI, lo importante es que Flex no es una arquitectura nueva. Llega como dos adaptadores LoRA con el diseño nativo de módulos de MiniMax H3, así que se carga mediante el nodo estándar LoraLoaderModelOnly sobre la base H3 que ya tengas, con tres flujos de trabajo de plantilla oficiales en la biblioteca de plantillas.
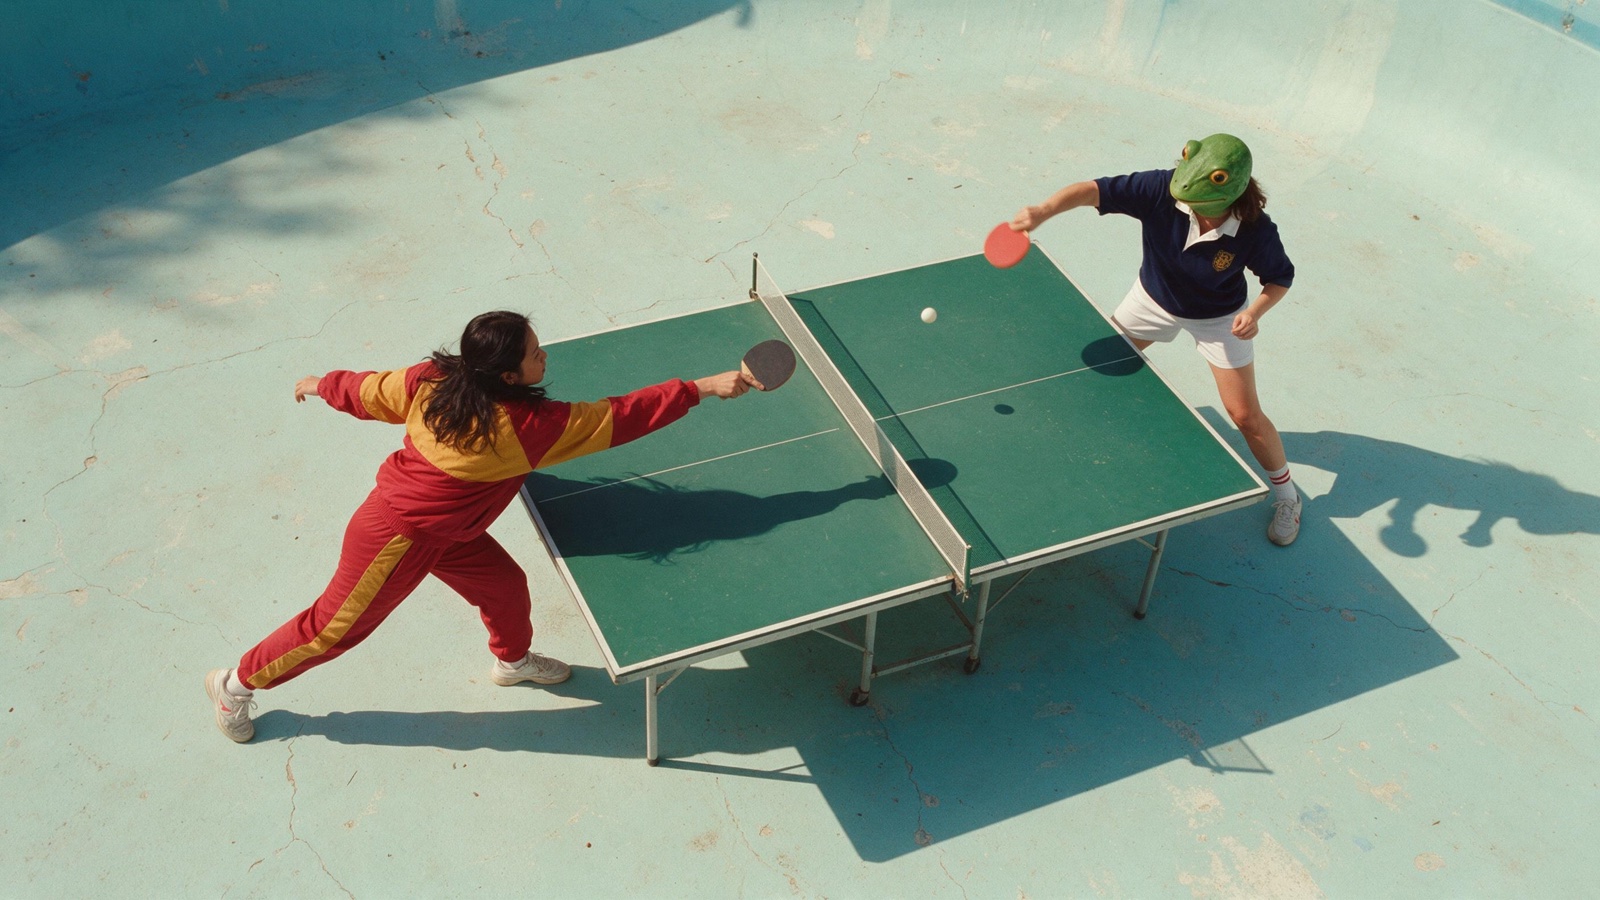 |  |
|---|---|
| Referencia de primer fotograma | Un fotograma de la salida de seis pasos |
La demo de tenis de mesa: entra una imagen fija y el prompt pide cinco movimientos de cámara programados (cenital, grúa descendente, paneos rápidos, una órbita de 180 grados, un travelling bajo) dentro de una toma de 15 segundos. Fuente: tarjeta del modelo Pika H3 Flex
El clip completo del recorrido de cámara con su banda sonora generada, tomado del conjunto de demostraciones de Pika en el repositorio del modelo.
Dos adaptadores, un mismo esquema de seis pasos
Flex divide las dos rutas de acondicionamiento de H3 en adaptadores separados, igual que la propia división del modelo base:
| Adaptador | Se condiciona con | Tareas |
|---|---|---|
| FL2VA | texto, más primer y/o último fotograma opcionales | texto a vídeo (T2V), primer fotograma (I2V), último fotograma, primer y último fotograma |
| Ref2VA | texto, más referencias ordenadas de imagen, vídeo y audio | referencia a vídeo, transferencia de movimiento, intercambio de personaje, edición guiada por referencia |
Ref2VA acepta hasta 9 imágenes, 3 vídeos y 3 clips de audio independientes, con 12 archivos de referencia en total, y se requiere al menos una imagen o un vídeo. Cada vídeo de referencia o clip de audio independiente debe durar de 2 a 15 segundos, con cada uno de esos dos grupos limitado a 15 segundos en conjunto. La banda sonora propia de un vídeo permanece asociada a ese vídeo y no cuenta como un archivo de audio adicional.
La salida es de 480p o 768p de forma nativa en 11 relaciones de aspecto, a 24 fps, con audio estéreo de 32 kHz mezclado en el archivo, para duraciones solicitadas de 5 a 15 segundos. La cuadrícula de fotogramas de H3 redondea esos valores: una solicitud de 5 segundos devuelve 124 fotogramas, y una de 15 segundos devuelve 362.
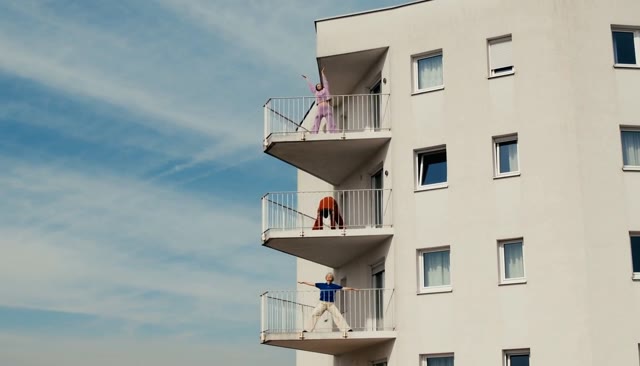
Un único prompt dirige a tres personas animadas por separado en balcones superpuestos a través de una órbita, un acercamiento, una grúa vertical y una órbita inversa, sin cortes.
El lanzamiento para ComfyUI
Tres plantillas se incluyen en la biblioteca de plantillas de ComfyUI dentro de Video: video_pika_h3_flex_t2v.json, video_pika_h3_flex_fl2va.json y video_pika_h3_flex_ref2va.json, todas documentadas en la página de tutoriales de ComfyUI. Cada una combina un modelo de difusión H3 int8 podado con el adaptador correspondiente y ejecuta el esquema publicado por Pika: el muestreador LCM con ManualSigmas y CFG 1.0 mediante BasicGuider, con la fuerza del adaptador fijada en 1.0.
Hay dos detalles que importan si construyes tu propio gráfico en lugar de cargar una plantilla:
- La cuadrícula de sigmas forma parte del contrato del checkpoint. El manifiesto de Pika enumera los nudos
1000/750/500/250/100/40/0, desplazamiento de vídeo 12, desplazamiento de audio 3 y ruido intermedio nuevo. Elegir seis pasos en un muestreador genérico no reproduce ese contrato. - No apiles un segundo LoRA de aceleración. El adaptador ya está destilado a seis pasos, y el tutorial señala que añadir un LoRA turbo o Lightning encima rompe la salida.
Los conectores son conversiones simples a BF16 en lugar de un checkpoint nuevo: los módulos ordinarios mantienen rango 128, mientras que las proyecciones Q/K/V fusionadas se combinaron a rango 384, y la conversión reordena las mitades de SwiGLU para coincidir con el diseño nativo de H3. El propio readme del adaptador de Pika es explícito en que se validaron la integridad de los archivos y la conversión de tensores, pero que no se verificó ningún render de ComfyUI de extremo a extremo como parte de la subida. Es de esperar cierta desviación respecto al paquete de inferencia de referencia.
Un primer informe práctico de #pika-h3-flex-early encaja con eso: el probador NebSH encadenó un paso de 6 pasos a 960x544 con un upscale en latente más un paso de 4 pasos a 1920x1088, logrando un resultado de 2560x1440 en 3 min 17 s, mientras que WAS señaló la aparición de popping en detalles de alta frecuencia, como aves lejanas, a cuatro pasos, y sugirió mantener seis.
Cómo llegó Pika a seis pasos
El análisis técnico detallado describe tres etapas de post-entrenamiento sobre el H3 publicado y destilado con orientación:
- Ajuste fino supervisado sobre un conjunto de datos interno de audio y vídeo, curado estéticamente, que abarca tareas de generación y edición, aún con los 50 pasos del profesor.
- Destilación por coincidencia de distribución proyectada (PDMD, Wang et al. 2026) para reducir el muestreo de 50 pasos a seis. Pika informa de que el DMD estándar era inestable en sus ejecuciones y que PDMD se entrenó de forma más fiable con mejor calidad de salida.
- Aprendizaje por recompensa posterior a la destilación mediante ReFL (estética y claridad) y DPO (seguimiento de instrucciones, realismo, calidad visual), entrenados como dos LoRA separados y fusionados en un único adaptador para que el comportamiento combinado no cueste pasos de muestreo adicionales.
Una pila de servicio separada hace el resto: proyecciones AdaLN dependientes del timestep en caché, kernels fusionados, FlashAttention-4 y atención bloque-dispersa con comunicación comprimida. En ocho GPUs B300 a 768p y 5 segundos con audio, eso redujo la inferencia completa de 3.409 s a 2.129 s, una aceleración de 1.60x, con el checkpoint y el esquema de seis pasos fijos.
Lo que dicen los números, y lo que no
Pika evaluó Flex frente a MiniMax H3 oficial, Fal H3 Max y HeyGen Video (calidad) a 768p con el mismo conjunto de prompts, y reporta la puntuación más alta en las cinco métricas de calidad visual y de audio:
| Métrica | Pika H3 Flex | MiniMax H3 | Fal H3 Max |
|---|---|---|---|
| Vídeo técnico | 12.3 | 11.7 | 10.6 |
| Vídeo estético | 5.41 | 5.28 | 5.00 |
| Audio estético | 7.02 | 6.85 | 6.89 |
| Alineación audio-vídeo | 0.212 | 0.208 | 0.216 |
La alineación audio-vídeo y texto-vídeo queda más o menos al nivel de los comparadores, y los números son la evaluación propia de Pika. En su estudio ciego por pares, Flex lidera en anatomía humana, composición compleja y sincronización de audio para la generación condicionada por texto e imagen, y en estilo visual, encuadre y movimiento de cámara para la generación condicionada por referencia. Pika también afirma que los otros sistemas siguen siendo preferidos en física, narrativa multi-escena, iluminación y materiales, y en tareas de referencia con mucha acción.
Los A/B de la comunidad hasta ahora son pequeños, pero coherentes con un modelo de seis pasos utilizable, no con una solución milagrosa. Kijai ejecutó el mismo prompt de ejemplo de T2V con DMAD y con Flex a seis pasos cada uno e informó de que DMAD falló en ese caso, mientras que djbfilmz comparó Flex a seis pasos con una ejecución de veinte pasos sin el adaptador y dijo que iteraría con Flex y haría un render completo de veinte pasos para los finales. La propia afirmación del tutorial es un clip de 5 segundos a 1344x768 en aproximadamente un minuto en una sola tarjeta gráfica.
 |  |
|---|---|
| Película de producto multi-toma | Referencias de personaje y entorno más un clip de movimiento |
Dos casos de demostración más: un anuncio de nueve tomas a partir de una única referencia de producto, y una transferencia de movimiento que toma la coreografía de un vídeo mientras la identidad y el estilo provienen de dos imágenes fijas.
Disponibilidad
El repositorio contiene los dos adaptadores FP32 (fl2va/adapter.safetensors, ref2va/adapter.safetensors, 2.77 GB cada uno) para el paquete de inferencia de Pika, las conversiones BF16 para ComfyUI (1.96 GB cada una) en comfy/loras/, y los componentes base de H3 en formato Diffusers que, según Pika, suman aproximadamente 210 GB. Cada plantilla de ComfyUI carga solo la partición del transformer que necesita.
Las extensiones alojadas de Pika quedan fuera de la descarga: el upscale a 1080p, 2K y 4K desde un borrador de 768p, cinco pistas de audio separadas (diálogo, banda sonora, efectos de sonido, foley, ambiente), la mejora de prompts y la pila de servicio acelerada son todas funciones de API. La inferencia local con pesos abiertos cubre 480p y 768p.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.