El núcleo de ComfyUI añade ampliación latent H3 y Sol-H3-VAE
Dos PR del núcleo de ComfyUI cargan los escaladores latent de MiniMax H3 y el decodificador Sol-H3-VAE, que baja la decodificación 2K H3 de 14,5 s a 0,89 s.
ComfyUI fusionó dos pull requests del núcleo el 28 de octubre de 2026 que trasladan la ruta de alta resolución de MiniMax H3 fuera de los nodos personalizados y hacia el núcleo. PR 17412 añade soporte para modelos de escalado latent con un nodo dedicado para H3, y PR 17411 enseña al cargador de VAE a abrir Sol-H3-VAE, el decodificador rápido destilado del equipo Efficient-Large-Model de NVIDIA. Ambos fueron escritos por Kijai y ambos llegaron después de la etiqueta v0.43.1, por lo que aparecen en master y en las compilaciones nocturnas, no en la versión actual 0.43.x.
La combinación apunta a las dos partes costosas de un trabajo H3 en 2K: ampliar el latent sin un viaje de ida y vuelta por el VAE, y decodificar el clip finalizado.
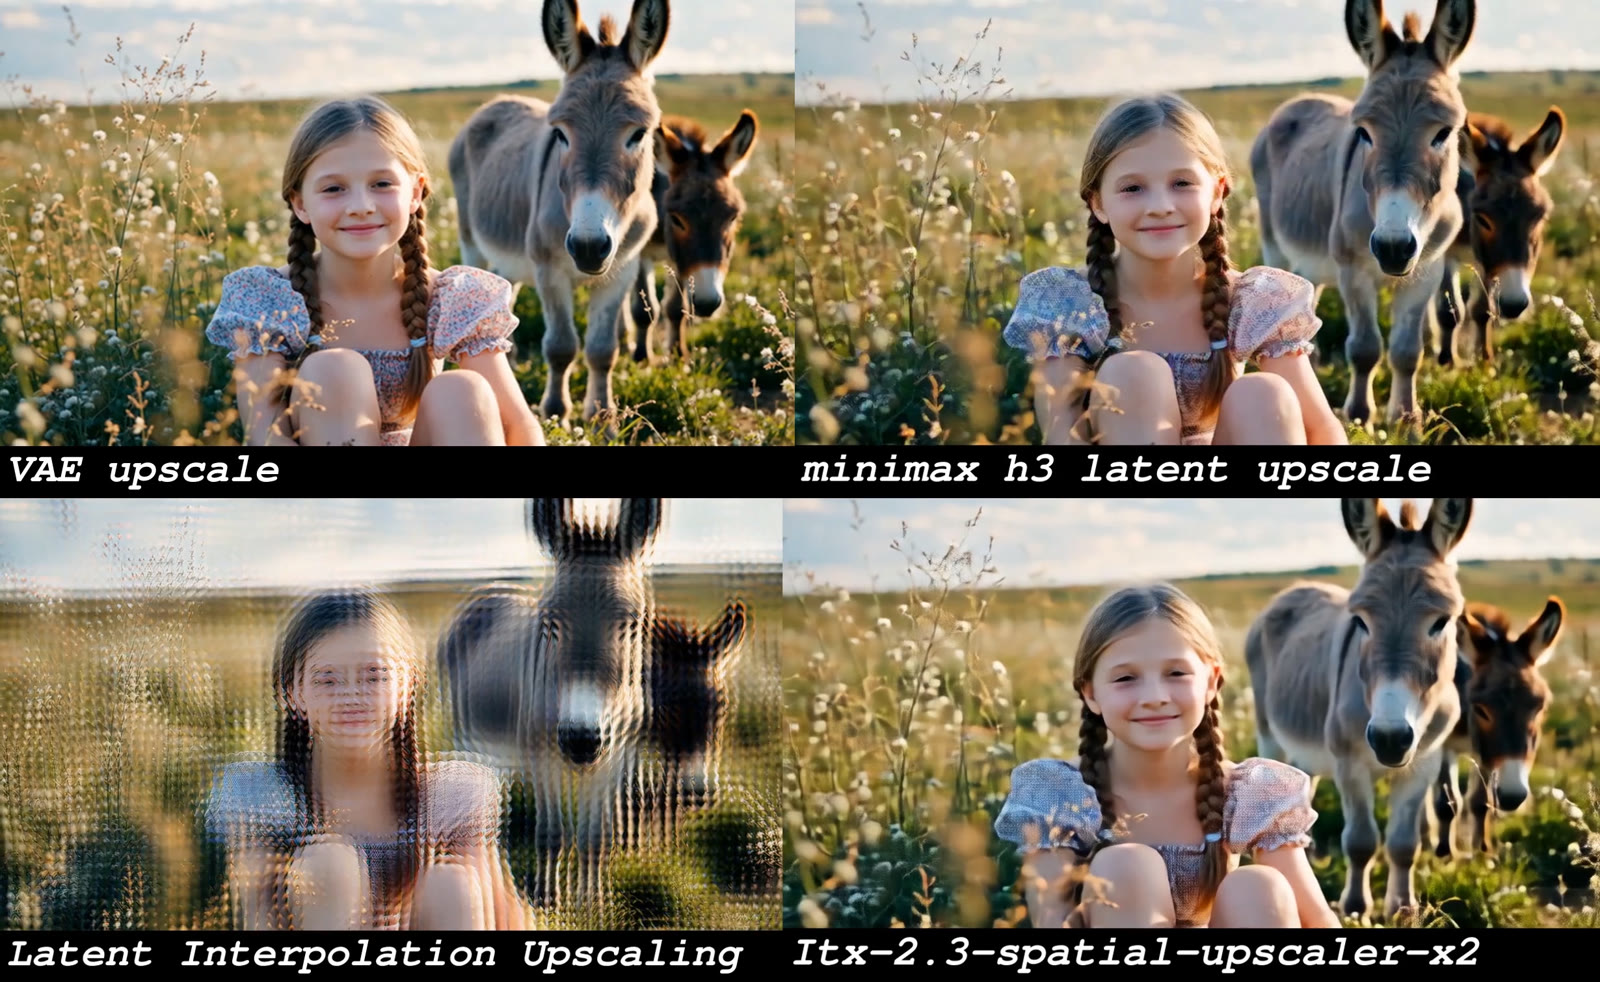
Una pasada de baja resolución ampliada en el espacio latent con el escalador latent de H3, según su ficha del modelo.
La comparación en vídeo del mismo repositorio.
Qué llegó al núcleo
| PR | Fusionado | Qué cambia |
|---|---|---|
| 17412 | 2026-10-28 20:05 UTC | Nuevo módulo comfy/ldm/minimax/latent_upscaler.py, rama H3 en Load Latent Upscale Model, nuevo nodo MiniMax H3 Latent Upscale With Model |
| 17411 | 2026-10-28 23:46 UTC | Detección de Sol-H3-VAE y reasignación de claves en el cargador de VAE, ruta de decodificador no causal, soporte de decodificador cuantizado int8, estimación de memoria del decodificador |
Ninguno de los PR incluye un checkpoint. Hacen que los pesos existentes de la comunidad se carguen con el cargador estándar, de modo que un escalador H3 que antes necesitaba un paquete de nodos ahora funciona solo con nodos del núcleo.
Ampliación dentro del latent
Los latentes de H3 llevan 24 canales y un flujo de audio separado. El escalador latent de LBH-123-AI trabaja directamente sobre el latent de vídeo con un backbone de convolución 3D: 345.280.216 parámetros, 24 canales de entrada y salida, 512 canales base, 12 bloques de entrada y 12 de salida, con una convolución temporal cada dos bloques con tamaño de kernel 5.
El objetivo es evitar decode -> pixel upscale -> encode a través del VAE de H3, que la ficha del modelo describe como de aproximadamente 5B de parámetros. Su autor también informa que la interpolación bilineal o bicúbica simple de los latentes de H3 produce ghosting, algo que el escalador aprendido está entrenado para evitar. El entrenamiento utilizó alrededor de 80.000 muestras emparejadas, divididas en aproximadamente 70.000 pares de vídeo y 8.000 pares de imágenes 2K, con 2x como escala dominante en la mezcla.
El núcleo lee la arquitectura del state dict, por lo que los recuentos de bloques, el ancho de canales y el kernel temporal provienen de los propios pesos en lugar de un archivo de configuración aparte. La salida del nodo conserva el latent anidado de H3, lo que significa que la mitad de audio pasa sin cambios y la banda sonora generada sobrevive a la ampliación. Se descarta una máscara de ruido en el latent de entrada.
Vale la pena conocer dos diferencias con el paquete de nodos complementario:
- El nodo del núcleo toma un tamaño objetivo, no un factor de escala.
MiniMax H3 Latent Upscale With Modelusa por defecto 2560x1440, con un paso de 32 y el límite de resolución habitual. El nodo de la comunidad, en cambio, expone una escala continua de 1.0x a 4.0x. - La ampliación por sí sola no añade detalle. Redimensiona el latent, por lo que la segunda pasada de muestreo en la nueva resolución es la que devuelve el detalle. Usar un número bajo de pasos ahí deja el resultado suave.
Si el tamaño solicitado coincide con el tamaño del latent, el nodo del núcleo devuelve la entrada sin tocar en lugar de ejecutar el modelo.
Sol-H3-VAE como decodificador de reemplazo directo
Sol-H3-VAE es un decodificador de vídeo rápido para H3 que sustituye el decodificador VAE estándar de 36 capas por un decodificador no causal de 24 capas y 1,62B de parámetros, destilado a partir de él. Decodifica fotogramas completos con atención por ventanas en lugar de mosaicos espaciales, y decodifica cada bloque nativo de 5 latentes de forma bidireccional. Según su ficha del modelo, acepta los mismos latentes normalizados y devuelve los mismos fotogramas que el decodificador VAE de H3, y deja intacto el decodificador de audio.
| Un clip de 5 segundos | H3 VAE | Sol-H3-VAE |
|---|---|---|
| 768p, RTX 5090 | 12,5 s | 5,0 s |
| 720p, GB200 | 6,16 s | 0,34 s |
| 2K, GB200 | 14,5 s | 0,89 s |
La ficha reporta 45,4 dB de PSNR frente al decodificador H3 en latentes reservados que abarcan de 720p a 2K, y 38,2 dB en un clip generado de 768p. Las cifras de GB200 provienen de un grafo CUDA capturado; la de RTX 5090 es en modo eager.
Abrir ese checkpoint en el núcleo requirió más que un nuevo patrón de nombre de archivo:
- El archivo publicado almacena su decodificador sin el prefijo
decoder., por lo que el cargador reasigna las claves sobre la marcha y completa la media y la desviación estándar del latent de H3 cuando faltan. - El decodificador no causal cambia el cálculo de fotogramas. Su salida es de 4 fotogramas por latent, con el primer latent de cada bloque de 5 latentes conservando uno:
4t - 3 * ceil(t/5)fotogramas paratlatentes, con la inversa correspondiente para la codificación. - Como el clip completo se decodifica de una vez en lugar de por mosaicos, el PR añade una estimación de memoria separada para que el cargador pueda planificar la VRAM antes de que comience la decodificación.
- Las compilaciones cuantizadas del Sol VAE también se cargan: el cargador detecta int8 con pesos de rotación de convolución y cambia a operaciones de precisión mixta.
El archivo publicado es un único sol_h3_vae.safetensors de unos 6,5 GB en fp32.
Integración en un grafo de nodos
- Coloca el checkpoint del escalador en
ComfyUI/models/latent_upscale_models/. La versión de H3 incluye bf16 y fp16 de unos 691 MB cada una, más un.pthfp32 de 1,38 GB. - Coloca
sol_h3_vae.safetensorsenComfyUI/models/vae/y cárgalo con el cargador VAE habitual. - Encadena
Load Latent Upscale ModelaMiniMax H3 Latent Upscale With Modelentre la pasada de muestreo de baja resolución y una segunda pasada del muestreador a 2560x1440 o más. - Decodifica el latent refinado con el Sol VAE.
Los pesos del escalador son Apache-2.0. La biblioteca de plantillas de ComfyUI todavía solo incluye las plantillas de la API de H3 alojada, por lo que aún no existe una plantilla local oficial en 2K para esta combinación, y los tiempos anteriores son mediciones de las propias fichas de los modelos, no benchmarks de ComfyUI.
Disponibilidad
- Escalador: LBH-123-AI/Minimax_h3_latent_Upscaler (Apache-2.0, checkpoints bf16 / fp16 / fp32, más dos flujos de trabajo de ejemplo en el repositorio)
- Decodificador rápido: Efficient-Large-Model/Sol-H3-VAE, con el paquete Python de referencia en
code/y la etapa de ComfyUI del runtime más amplio en la rama Sol-Engine de NVlabs/Sana - Cambios en el núcleo: PR 17412, PR 17411
Comentarios
Inicia sesión con GitHub para unirte a la conversación.