Open-H3-Regenerate-2K: refinamiento abierto a 4K para MiniMax H3
NVlabs Sana publica Open-H3-Regenerate-2K, un LoRA refinador abierto que redibuja borradores de MiniMax H3 a 2K y 4K en tres pasos de denoising.
Open-H3-Regenerate-2K es la alternativa abierta del equipo NVlabs Sana a la etapa H3-Regenerate-2K de MiniMax, la segunda mitad del pipeline H3 que redibuja un borrador 768P finalizado a mayor resolución. La versión alojada de esa etapa no incluye pesos, así que el equipo la reconstruyó como un único LoRA refinador sobre un transformer H3 congelado y un VAE de vídeo, y publicó los pesos en Hugging Face junto con el código y una página del proyecto.
El refinador toma un borrador a 384P, 512P, 576P o 768P y devuelve un clip nativo de 768P, 1080P, 2K (2560x1440) o 4K (3840x2160) de 5 a 15 segundos, en tres pasos de denoising en lugar de una ejecución de muestreo completa. Por defecto decodifica mediante el VAE rápido H3 de 24 capas de StreamRender-H3 en lugar del decodificador publicado.
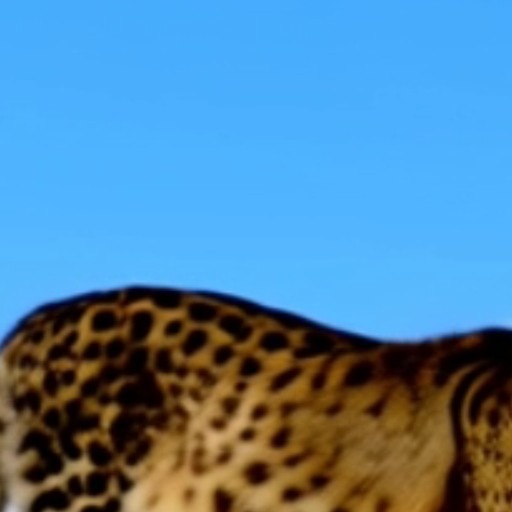 | 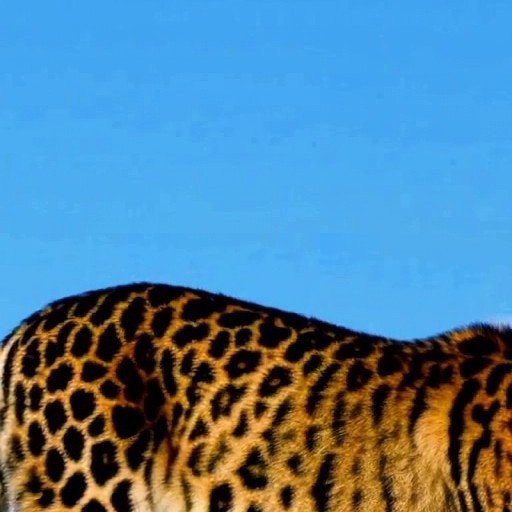 |
|---|---|
| Fotograma del borrador, mismo recorte | Regenerado a 2K |
El mismo fotograma y la misma ventana del conjunto de comparación del propio proyecto, que empareja recortes de la API oficial de H3-Regenerate-2K con el refinador abierto. Fuente: página del proyecto
Qué reemplaza el refinador
H3 genera en dos etapas: el modelo base asienta el contenido y el movimiento a baja resolución y después una etapa de regeneración redibuja rostros, tejidos, pelaje y follaje a tamaño completo. Solo la primera etapa se publicó como pesos en agosto; la segunda existía como una API alojada que acepta la salida 768P de H3 sin modificar y devuelve 2K.
Open-H3-Regenerate-2K mantiene la misma división y abre la segunda etapa. La entrada no se limita al modelo base H3: el proyecto demuestra borradores creados por LTX-2 y SANA-Video a 1024x576, y el refinador traslada su composición, color y movimiento a la cuadrícula mayor.
Cómo hacen el trabajo tres pasos
El borrador se codifica una vez y luego un upscaler latente convolucional 3D amplía el latente directamente hasta la cuadrícula objetivo, sin decodificar y recodificar entre medias. Al latente ampliado se le vuelve a añadir ruido hasta sigma 0.909 y se aplica denoising en tres pasos de Euler (0.909, 0.857, 0.667 a 0) con la orientación libre de clasificador desactivada, de modo que cada paso es una única llamada al transformer a resolución completa.
Tres adaptadores aportan el comportamiento de pocos pasos, y la versión publicada los fusiona en un solo archivo concatenando sus factores a lo largo del eje de rango:
- el propio refinador Open-H3, EMA del paso 5000, rango 384
- LightX2V FL2VA Turbo v1.2, rango 128
- LMS Sharp v1.0, rango 64
El LoRA fusionado tiene rango 576 en 312 capas lineales, se almacena en FP32 junto con las ramas de curva de timesteps de Sharp, que se mantienen como módulos separados porque leen una curva de 8 dimensiones en lugar de la entrada de la capa. La comprobación de fusión del proyecto informa de que el delta fusionado coincide con los tres adaptadores separados hasta un error relativo de 2.2e-8.
Velocidad y benchmarks
El equipo midió un clip de 5 segundos en una sola B200, de latente 768P a 2560x1440, en caliente, con la mediana de tres ejecuciones. El upscale del latente, los tres pasos de refinado y la decodificación VAE tardaron 22,45 segundos con el forward de SoL-Engine y el decodificador VAE rápido, frente a 87,26 segundos del forward estándar de diffusers con el decodificador publicado. Evitar la decodificación y la recodificación es de donde procede la mayor parte de la ganancia: el decodificador rápido procesa el clip 2K en 1,58 segundos en lugar de unos 15.
En RefinerBench-150, con ambos sistemas ejecutados a 2560x1440, el equipo informa de puntuaciones superiores a las de la API oficial en los tres ejes de UniPercept y en calidad estética, calidad de imagen y consistencia del sujeto de VBench. En un estudio ciego de 200 juicios, el refinador abierto fue preferido en el 87 %.
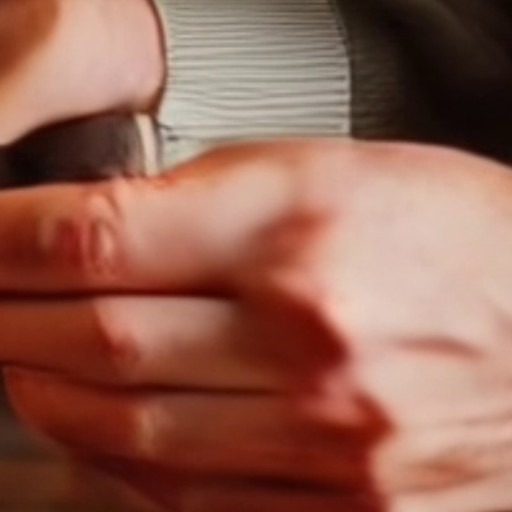 | 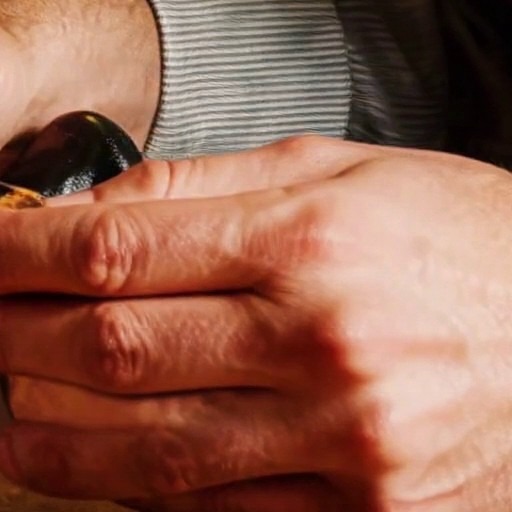 |
|---|---|
| Fotograma del borrador, segunda escena | Regenerado a 2K |
Un segundo par de recortes del mismo conjunto de comparación. Fuente: página del proyecto
Disponibilidad
No hay nodos oficiales de ComfyUI para el refinador. La implementación de referencia es una CLI de Python en el repositorio de Sana (Linux, Python 3.11, PyTorch 2.11 con CUDA 13.0), y el ayudante download.py descarga los pesos, el LoRA fusionado, el upsampler latente y el decodificador VAE rápido.
Los usuarios de ComfyUI lo han portado por su cuenta: Kijai publicó el refinador por separado como un LoRA de rango 384 para poder combinarlo con otros destilados, y hay conversiones de la comunidad del LoRA adaptado completo en Hugging Face (father558, DrakenZA). Quienes hicieron las conversiones advierten de que una conversión directa reproduce pesos incorrectos porque el diseño de Diffusers necesita una transformación SwiGLU, así que las conversiones hechas sin ese paso se verán defectuosas.
El repositorio incluye el LoRA refinador, el decodificador VAE rápido (1,62 mil millones de parámetros) y una copia sin modificar de los componentes Diffusers de H3, de modo que toda la ruta de 768P a 2K puede ejecutarse sin la API de MiniMax.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.