TARA: alineación temporal nativa para referencias de MiniMax H3
ComfyUI-BFSNodes añade TARA, un parche experimental que mantiene nativa la referencia de movimiento de MiniMax H3 y sesga la atención hacia el momento correspondiente de la guía.
La transferencia de movimiento en MiniMax H3 suele funcionar inyectando los latentes del clip de conducción como guía: Add Guide, o un latente enmascarado en el mismo espacio latente. TARA toma el otro camino. El clip entra como referencia nativa <Video N> en MiniMax H3 Reference to Video, su origen RoPE temporal se alinea con el reloj de salida y se penaliza la atención desde cada momento de salida hacia momentos lejanos de la guía. En palabras del repositorio, el modo "retiene una referencia de vídeo nativa, alinea sus coordenadas RoPE temporales con el objetivo y penaliza suavemente las consultas objetivo que atienden a tiempos lejanos de la guía".
No se entrena nada para el parche en sí. No añade pesos aprendidos ni carga ningún LoRA propio; la preferencia temporal se calcula en el momento del muestreo y solo afecta a las consultas de salida que atienden al vídeo de movimiento seleccionado. Las imágenes de referencia conservan sus coordenadas nativas, y el texto, el audio de referencia y la autoatención del propio objetivo mantienen su regla normal.
La regla temporal
Solo se modifican las aristas desde las consultas del vídeo de salida hacia las claves del vídeo de movimiento seleccionado:
dt = abs(output_time - guide_time)
penalty(dt) = min(strength * (max(dt - window, 0) / falloff)^2, cap)
score = dot(Q, K) / sqrt(head_dim) - penalty(dt)
Los valores predeterminados son una ventana libre de 0,20 s, falloff 0,25 s, strength 2,0 y cap 6,0, expuestos en el nodo como window, falloff, strength y cap. Dentro de la ventana libre no hay penalización alguna. Fuera de ella la penalización crece de forma cuadrática hasta alcanzar el cap, de modo que los fotogramas lejanos de la guía siguen disponibles con un peso pequeño en lugar de quedar enmascarados. Con los valores predeterminados, la corrección local se anula alrededor de 0,633 s.
| Diferencia de tiempo | Penalización | Factor de atención |
|---|---|---|
| 0,00 s | 0,00 | 1,000000 |
| 0,40 s | 1,28 | 0,278037 |
| 0,80 s | 6,00 | 0,002479 |
Hay una advertencia documentada con claridad: poner strength a cero elimina el sesgo pero no la alineación RoPE, así que una comparación real con "TARA desactivado" implica saltar el nodo y enrutar el modelo original tanto al guía como al scheduler.
Cómo conectarlo
El nodo independiente es BFS MiniMax H3 TARA - Native Temporal Alignment (Experimental), colocado en la ruta MODEL después de la carga de LoRA y antes del guía. El clip de movimiento es una referencia nativa <Video N> normal, y motion_video_index selecciona cuál de ellas aporta el movimiento; la numeración de imágenes y de vídeos es independiente.
El repositorio pide 24 fps en ambos lados y ventanas de fotogramas coincidentes (107 fotogramas es un recuento válido), advierte contra apilar un segundo parche temporal y mantiene fuera de la ruta MODEL Add Guide, las guías de primer fotograma, VSA, SLA y los reemplazos desconocidos de atención o de bloques. Las máscaras de generación ordinarias sí están permitidas, porque una máscara no crea una guía temporal. En las rutas CFG, cada rama de acondicionamiento que evalúa el modelo parcheado debe mantener la referencia de movimiento.
Dentro del Shot Planner (BFS Shot H3 Conditioning) el mismo comportamiento es una entrada del desplegable, guide_mode = TARA - Native Temporal Alignment (experimental). El nodo de acondicionamiento devuelve el modelo parcheado, y lo que se muestrea es la rejilla temporal empaquetada del plano actual.
Tres backends
- Flash Partitions (predeterminado desde 1.115.11) conserva la regla pero la evalúa mediante FlashAttention nativo de CUDA con salidas log-sum-exp, fusionando tres contribuciones no negativas en lugar de construir un tensor de sesgo denso o un kernel de
torch.compile. Requiere CUDA FP16/BF16 y el primitivo FlashAttention-with-LSE de PyTorch. - Los kernels one-pass de Comfy Kitchen (1.115.16 y posteriores) fusionan la regla en kernels densos INT8 y de sol-attn y eliminan el bucle de atención por fotograma. Se distribuyen bibliotecas precompiladas para SM80, SM86, SM89, SM90, SM100 y SM120 en Linux, con DLL de Windows para SM86, SM89 y SM120; el controlador debe admitir CUDA 13 incluso cuando PyTorch se ejecuta sobre 12.x. A partir de 1.115.17 la configuración de primer uso es automática en Linux SM120, y una línea de registro en el momento del muestreo indica si la ruta fusionada se ejecutó realmente.
- La compatibilidad con sol-attn (1.115.14) está soportada con límites documentados, y el nodo oficial Backend de atención del modelo se respeta desde 1.115.13.
Lo que dicen los números
El repositorio separa un microbenchmark aislado de los registros de flujo de trabajo completo de un usuario, y etiqueta ambos. En una RTX PRO 6000 Blackwell con 107.126 tokens, 8 cabezas y BF16:
| Backend | Llamada de atención |
|---|---|
| FlashAttention nativo | 0,327 s |
| Flash Partitions | 0,422 s |
| FlexAttention temporal original | 0,628 s |
Eso es aproximadamente 1,5x respecto al backend temporal original para esa forma, medido mientras se ejecutaba un proceso de entrenamiento, con 8 cabezas en lugar de las 56 de H3, y no es una afirmación de velocidad sobre el modelo completo. Una ejecución de un usuario en una RTX 5090 a 544×928 y 360 fotogramas reportó 179,18 s para la primera evaluación completa del modelo con escala de guía 1,0 (52.751 filas de guía) y 54,45 s con escala 0,5 (11.984 filas), con una segunda evaluación de 47,19 s. La ruta FlexAttention anterior quedó registrada en 603,40 s para su primer paso, incluyendo la inicialización, lo que la documentación califica como no comparable con una llamada de atención ya calentada.
Lo que aún necesitas
TARA no sustituye al LoRA de transferencia de movimiento, cambia cómo se acondiciona la referencia. La documentación empareja el nodo con un checkpoint entrenado mediante la rama feat/h3-native-temporal-motion de ai-toolkit (native_temporal_v1), mientras que la comparación pública del repositorio usa un LoRA del paso 10500 entrenado para Add Guide. Bajo el parche temporal ese LoRA sigue la interpretación de origen y mantiene la ropa del personaje de referencia, algo que el autor registra como observación experimental y no como garantía. Se menciona en la documentación un checkpoint nativo-temporal nuevo en el paso 750 que mostraba una retención de identidad más débil y que no se publica como descarga, así que todavía no hay un adaptador público equivalente.
En el Discord de Banodoco, un usuario probó el nodo en una RTX 4090 y una H100 el mismo día en que llegó e informó que ambas tarjetas lo ejecutaban, con la ruta Kitchen algo más lenta que flash partitions en ese hardware.
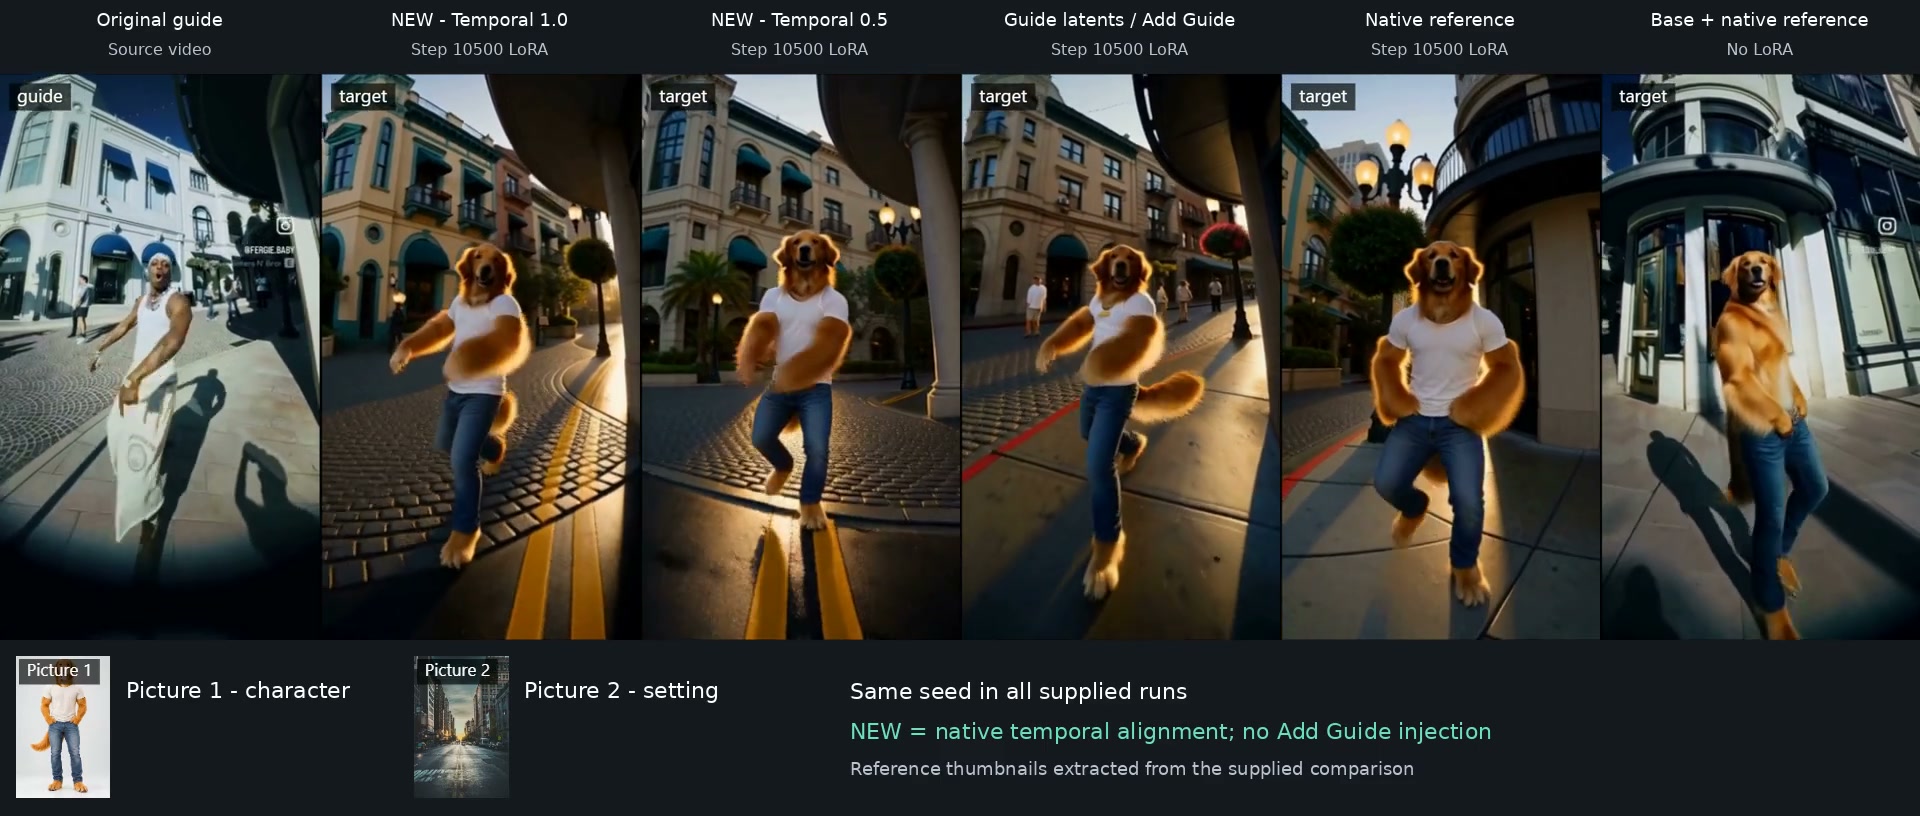
Un fotograma de la comparación de seis columnas, de izquierda a derecha: la guía original, el LoRA del paso 10500 con TARA a escala de guía 1,0, el mismo LoRA con TARA a 0,5, el mismo LoRA con latentes de Add Guide, una referencia nativa sin el parche temporal y el modelo base con una referencia nativa. Las columnas temporales están marcadas como NEW en el vídeo.
La exportación completa de 15 segundos lado a lado del repositorio, con las seis columnas reproduciéndose a la vez.
Ajustar los cuatro controles
El paquete también incluye una guía de parámetros animada con una versión HTML sin conexión cuyos deslizadores animan la misma regla. Su consejo es partir de los valores predeterminados, mantener fijos la semilla, el LoRA, el prompt, el origen y la salida, y cambiar un control a la vez. La deriva de movimiento es primero un problema de línea temporal: el <Video 1> equivocado, una discrepancia de fotogramas por segundo o una ventana de fotogramas desplazada no se pueden reparar con un sesgo más fuerte. La deriva de identidad apunta a la asignación de referencias, al LoRA y al acondicionamiento de imagen más que a los controles temporales.
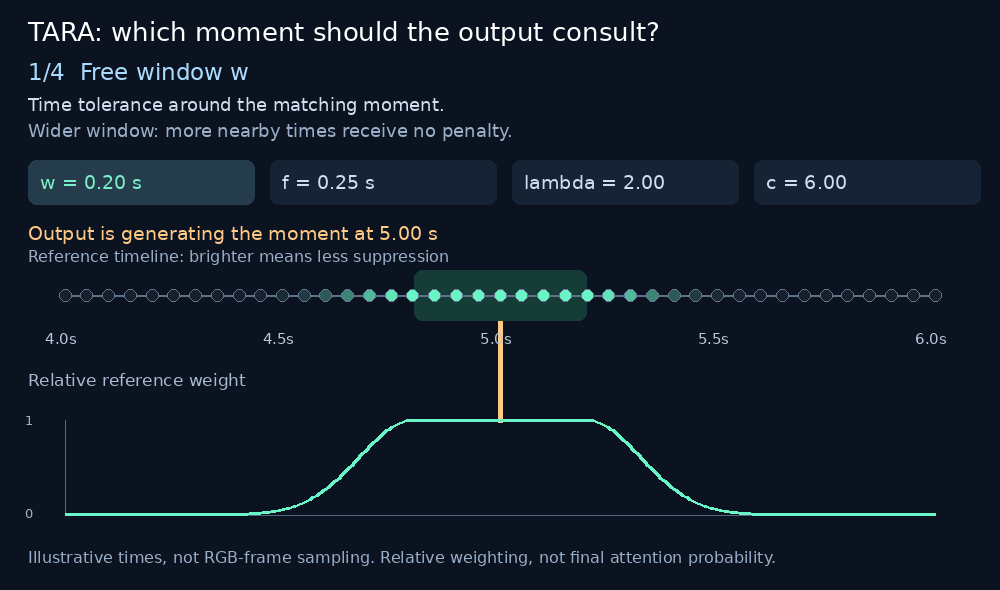
Ventana libre, falloff, strength y cap, según la guía de parámetros del repositorio.
Limitaciones
- La función es experimental y opcional; el valor predeterminado del Planner sigue siendo Add Guide, y la documentación indica que la validación completa de calidad visual está incompleta.
- La demo publicada es cualitativa: semillas idénticas entre columnas, pero no se capturaron todos los ajustes de generación, y la sustitución de fondo solicitada queda parcial.
- Ambos clips necesitan rejillas temporales coincidentes, y la política mantiene el trabajo de atención cuadrática densa.
- La validación hasta ahora consiste en matemáticas en CPU y pruebas de enrutamiento, además de evaluaciones en RTX 5090 reportadas por usuarios. El audio de guía se empaqueta de forma nativa pero no recibe sesgo temporal.
Disponibilidad
ComfyUI-BFSNodes se publica en el registro de Comfy como bfsnodes y se instala a través de ComfyUI Manager, o se puede clonar en custom_nodes/. TARA funciona sobre los nodos nativos de MiniMax H3 y los pesos Comfy-Org/MiniMax-H3 usados para la generación normal de H3.
El contrato completo de acondicionamiento está en H3_NATIVE_TEMPORAL.md, la derivación de backends y las tablas de tiempos en H3_FLASH_PARTITIONS.md, y la rama de investigación detrás del método en alisson-anjos/ai-toolkit. Para usarlo fuera de este paquete de nodos hay una guía de instalación manual.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.