Qwen-Image 2.1 en 2 pasos: LoRA DMD2 con CFG 1
Un LoRA de destilación DMD2 ejecuta Qwen-Image 2.1 de texto a imagen y edición multirreferencia en 2 pasos con CFG 1, con demo Space en vivo y pruebas de Banodoco.
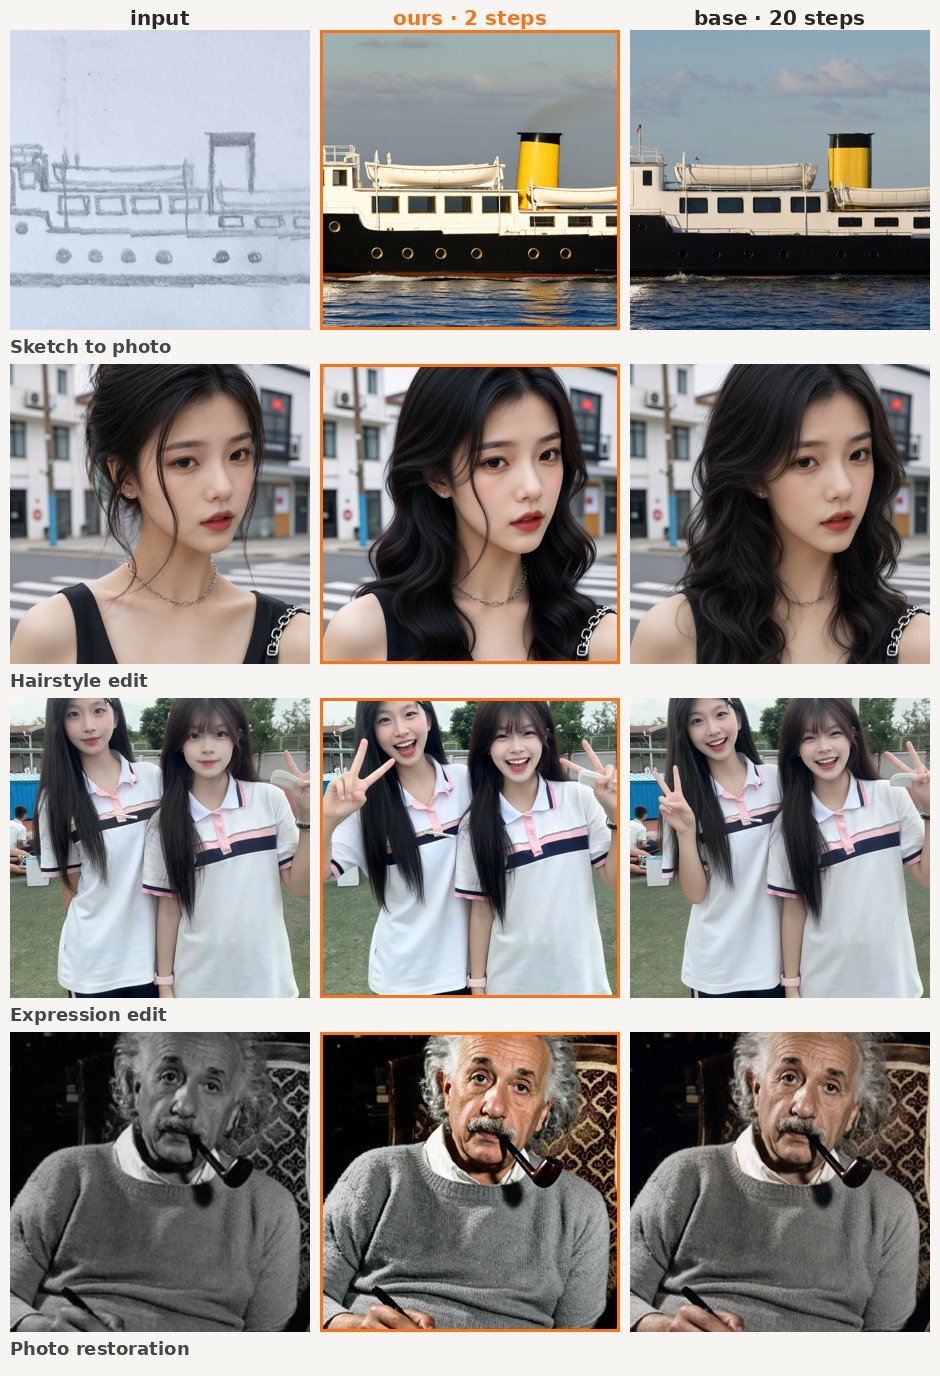
De boceto a foto, peinado, expresión y restauración de fotos, con la misma entrada, prompt y semilla. Cada fila muestra la entrada, el LoRA a 2 pasos y después el modelo base a 20 pasos.
Por qué 2 pasos es un nivel distinto
Qwen-Image 2.1 se distribuye con 40 pasos, y los aceleradores publicados hasta ahora llegan a 8 (el checkpoint Turbo de Alibaba) y a 4 (el LoRA Lightning de LightX2V). Este adaptador apunta al mínimo de ese rango, y el schedule de sigmas es fijo, no una recomendación:
| Ajuste | Valor |
|---|---|
| Pasos | 2 |
| Schedule de sigmas | [1.0, 0.5], fijo |
| CFG | 1 (true_cfg_scale=1.0) |
| Rango / alfa del LoRA | 32 / 32 |
| Módulos adaptados | solo atención: to_q, to_k, to_v, to_out.0 |
| Tamaño del archivo | 64 MB (256 tensores) |
La tarjeta indica explícitamente que el LoRA se entrenó con ese par exacto de sigmas, así que el scheduler tiene que quedar fijado con use_dynamic_shifting=False y shift=1.0. Si se deja activado el desplazamiento dinámico, las sigmas se reescalan según la resolución y el adaptador ya no muestrea la ruta sobre la que fue destilado.
Adaptar solo la atención es la otra decisión deliberada. La tarjeta sostiene que así se conserva la imagen de entrada de forma más fiel para la edición que adaptando también los bloques feed-forward, que es donde los adaptadores de pocos pasos anteriores para este modelo gastaban la mayor parte de su presupuesto.
Cómo se entrenó
DMD2 (Distribution Matching Distillation) con coincidencia de distribución on-policy y orientación CFG del profesor, sin pérdida de regresión ni pérdida GAN en el objetivo. El entrenamiento se ejecutó durante 2.000 pasos en una única H100 sobre recortes de varias relaciones de aspecto a aproximadamente 1 MP, lo que coincide con el alcance de resolución que usan las demos. El profesor de 20 pasos es la referencia con la que compara la tarjeta, no el valor predeterminado de 40 pasos del modelo.
Qué se mantiene con 2 pasos
La edición y la composición multirreferencia siguen funcionando. Qwen-Image 2.1 acepta una lista de imágenes de condición y el prompt se refiere a ellas por su posición, así que una ejecución de dos pasos todavía resuelve prompts como «coloca el gato de la Imagen 1 en la playa de la Imagen 2» sin colapsar a una sola referencia:
image = pipe(
    prompt="Place the cat from Picture 1 on the beach from Picture 2.",
    image=[cat, beach],
    num_inference_steps=2,
    sigmas=[1.0, 0.5],
    true_cfg_scale=1.0,
).images[0]
Texto a imagen es la misma llamada sin el argumento image. La salida RGBA no cambia, ya que el canal alfa proviene del modelo base y no del adaptador.
El Space de demo del autor, Qwen Image 2.1 Realtime, pone ese mismo schedule detrás de una interfaz en vivo: el modo realtime transmite un resultado de 512px que se actualiza a medida que cambia el prompt, y el modo de calidad completa salta a 1024 y 1536.
Pruebas de la comunidad
En el canal #qwen-image de Banodoco, los probadores ejecutaron el adaptador dentro de ComfyUI sobre los nodos nativos de Qwen-Image 2.1 y publicaron comparativas de pasos. RuneX informó de que un intercambio de rostro (head swap) a 2 pasos funciona y que un paso extra era ligeramente mejor, con los muestreadores Euler, ER-SDE y LCM. patientx midió 2, 3 y 4 pasos seguidos y encontró que 3 pasos están «muy cerca del resultado real», que 4 son usables y que 8 es un retroceso, con el tiempo total de ejecución apenas variando entre 2 y 4 pasos porque la carga del modelo domina.
El único inconveniente para ComfyUI es el nombrado de las claves. El safetensors se guarda en formato diffusers/PEFT, transformer.transformer_blocks.N.attn.to_q.lora.down.weight y los tensores .lora.up correspondientes, mientras que el cargador de ComfyUI usa los nombres propios de los parámetros del modelo que empiezan en transformer_blocks.N. Hay que eliminar el transformer. inicial antes de que el cargador asigne nada; de lo contrario, informa las claves como no asignadas y el LoRA no hace nada.
Disponibilidad
Pesos del LoRA: linoyts/Qwen-Image-2.1-DMD2-2steps en Hugging Face. Modelo base: Qwen/Qwen-Image-2.1. Demo: Qwen Image 2.1 Realtime.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.