Hi3D v1.0 refina mallas gruesas a geometría de 1536³
Hi3D v1.0, lanzado el 23 de octubre de 2026, refina una malla gruesa en geometría de alta resolución con un pipeline de tres pasos y una imagen de referencia.
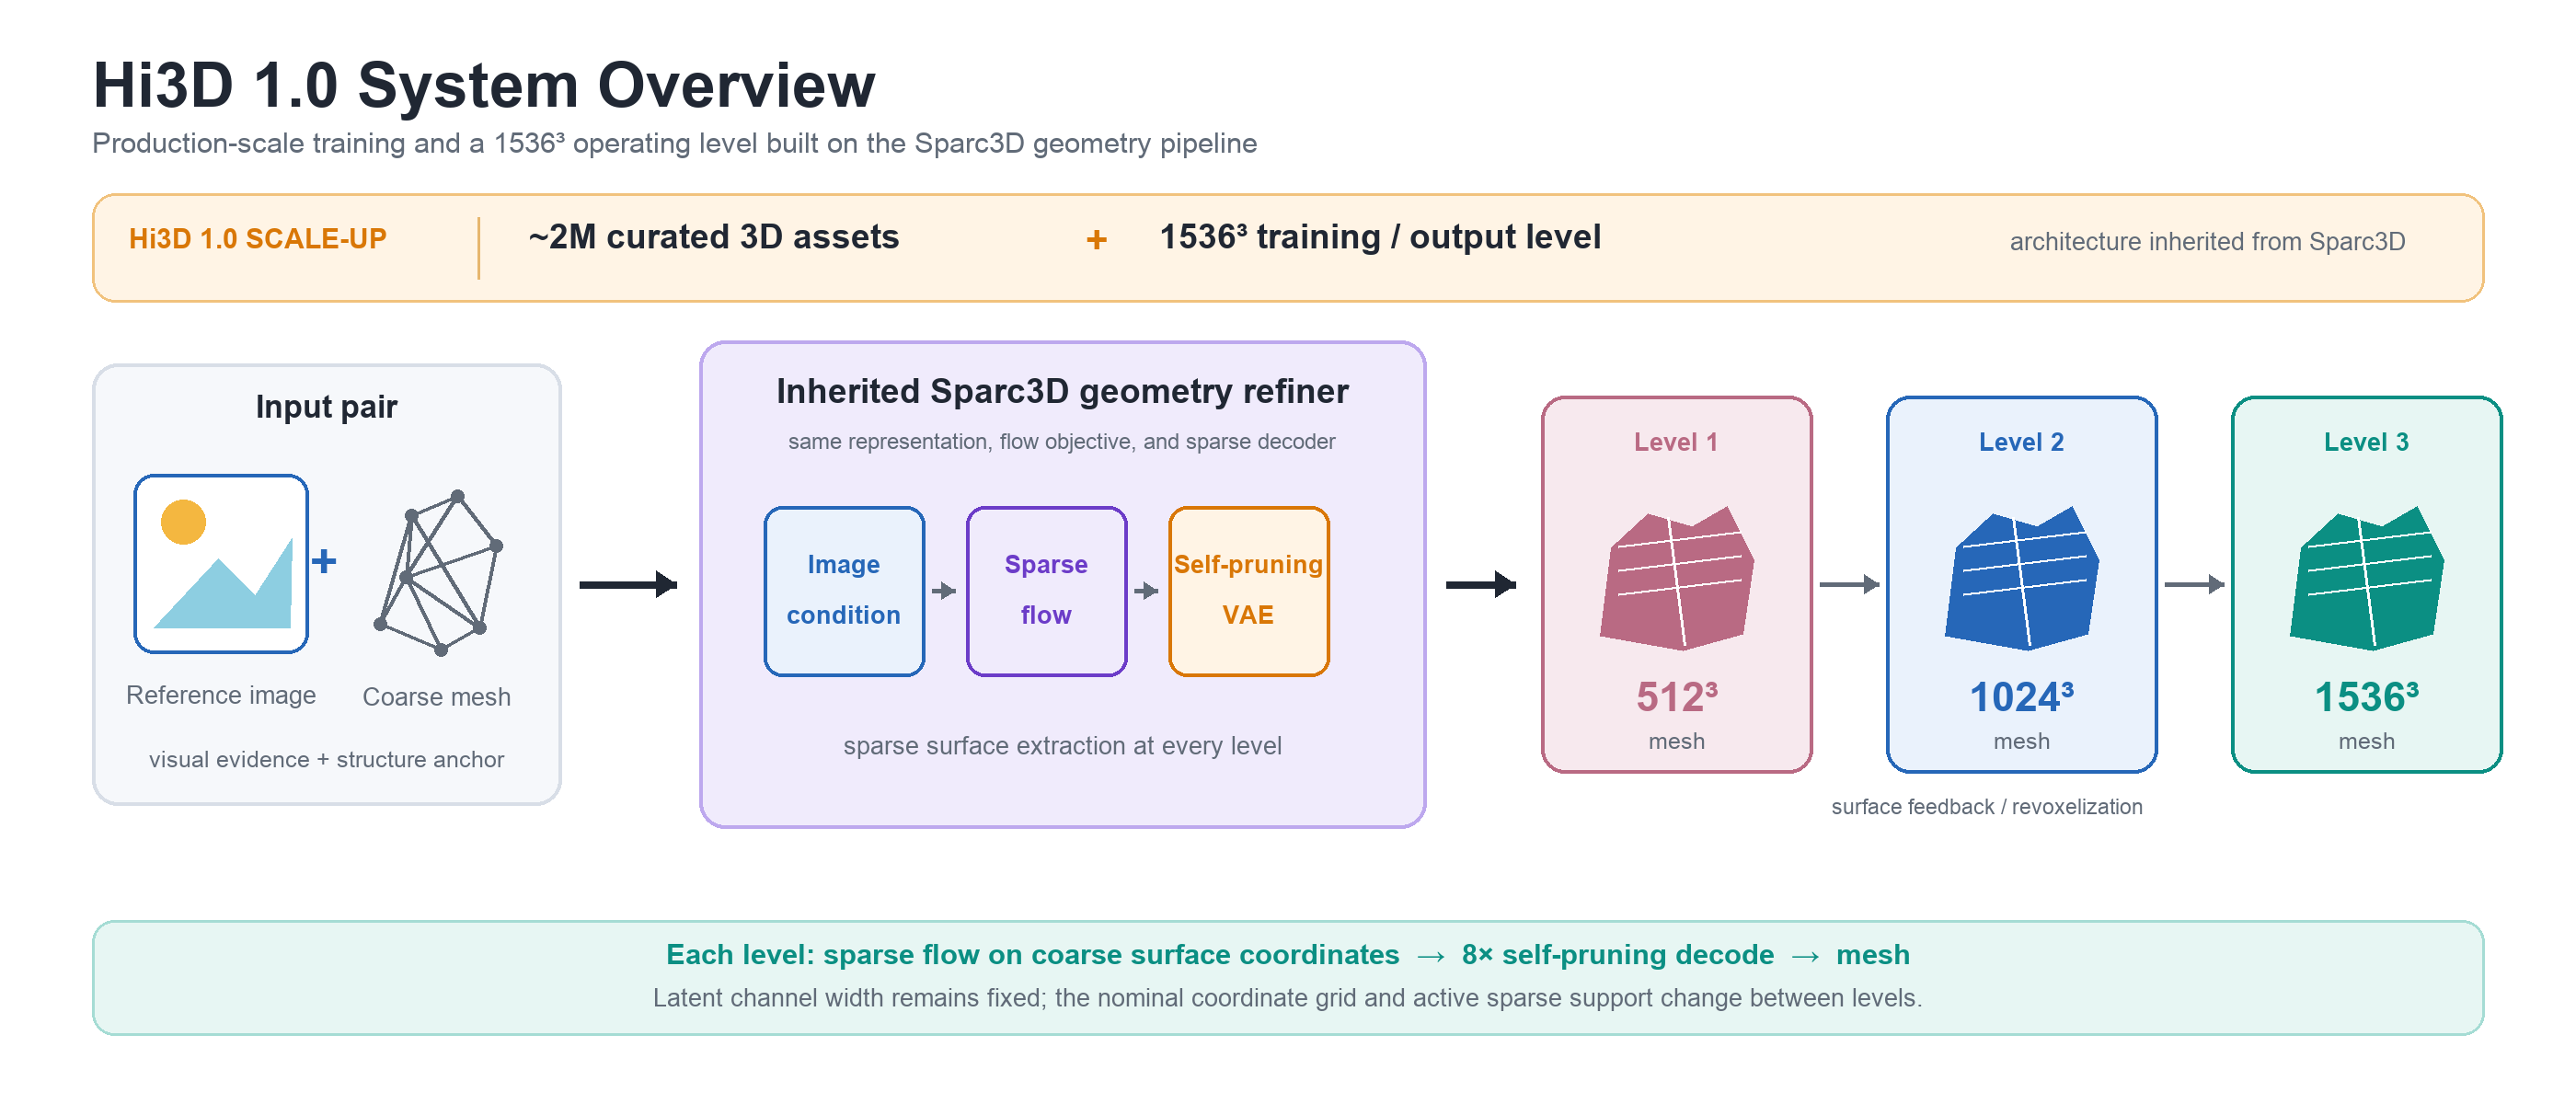
Descripción general del sistema desde el repositorio del proyecto: las características de la imagen condicionan el flujo disperso sobre coordenadas tomadas de la geometría gruesa, y cada malla extraída se revoxeliza para alimentar la siguiente pasada.
Una segunda etapa en lugar de otro generador
Los pipelines de imagen a 3D en ComfyUI, incluidos los nodos TRELLIS.2 y Pixal3D, terminan con una sola malla producida en una única cascada. Cualquier detalle que esa cascada no capte se pierde: el relieve fino se aplana, las molduras y los dientes se emborronan, y el resultado solo es tan nítido como lo era la etapa de forma.
Hi3D v1.0 está pensado para el paso posterior. No genera una malla a partir de una imagen por sí solo; asume que ya existe una malla gruesa y concentra su capacidad en hacer su geometría más densa y fiel, usando la misma imagen de referencia como señal de acondicionamiento en lugar de como objetivo de reconstrucción. La malla gruesa puede provenir de cualquier generador o de un artista.
El proyecto se basa en Sparc3D, y el paquete de Python y la API pública conservan los nombres originales por compatibilidad: importar el pipeline de refinamiento todavía se ve como from sparc3d import Sparc3DPipeline.
La escalera de tres pasadas
Una pasada muestrea un latente en cada coordenada de vóxel ocupada, lo decodifica en un campo de distancia con signo, extrae una malla y luego revoxeliza esa malla para proporcionar el soporte disperso de la siguiente pasada. Pedir una resolución mayor simplemente ejecuta más pasadas sobre la malla anterior.
| Pasada | Cuadrícula de estructura nominal | Presupuesto de vóxeles | Transformer | Cuadrícula de extracción |
|---|---|---|---|---|
| 1 | 64³ | 80.000 | transformer_512 | 512³ |
| 2 | 128³ | 90.000 | transformer_1024 | 1024³ |
| 3 | 192³ | 110.000 | transformer_1024 | 1536³ |
Una solicitud de 512³ ejecuta la primera pasada, 1024³ ejecuta dos y 1536³ ejecuta las tres. El proyecto aclara explícitamente que estas cifras describen cuadrículas dispersas de coordenadas y de extracción, no un tensor latente denso de 1536³ ni un número garantizado de triángulos, por lo que una ejecución de 1536³ no significa un volumen fijo de 1536³ vóxeles.
Dos transformers soportan el trabajo. Cada uno tiene 24 bloques, una anchura de 2.112 canales repartidos en 22 cabezas de atención y aproximadamente 1.800 millones de parámetros. Cada bloque aplica autoatención dispersa sobre los vóxeles, atención cruzada hacia los tokens de imagen y un MLP, con embeddings de posición rotatorios y normalización RMS en las consultas y claves de autoatención. El muestreo utiliza 25 actualizaciones del scheduler por pasada de forma predeterminada, con un sampler de segundo orden.
El acondicionamiento de imagen proviene de dos codificadores congelados: DINOv2-large a 756×756, que produce 2.917 tokens de imagen de 1.024 canales, y CLIP ViT-L/14 a 224×224, que produce un embedding agrupado que se difunde por esas posiciones. El resultado concatenado se calcula una vez y lo reutiliza cada pasada.
Qué cambia en la superficie
La evidencia más clara del lanzamiento es la comparación en primer plano, donde se pide a cada método que describa la misma región de referencia: relieve por capas, molduras arquitectónicas, límites curvos, escamas y dientes, surcos concéntricos. Hi3D v1.0 es la columna de la derecha.
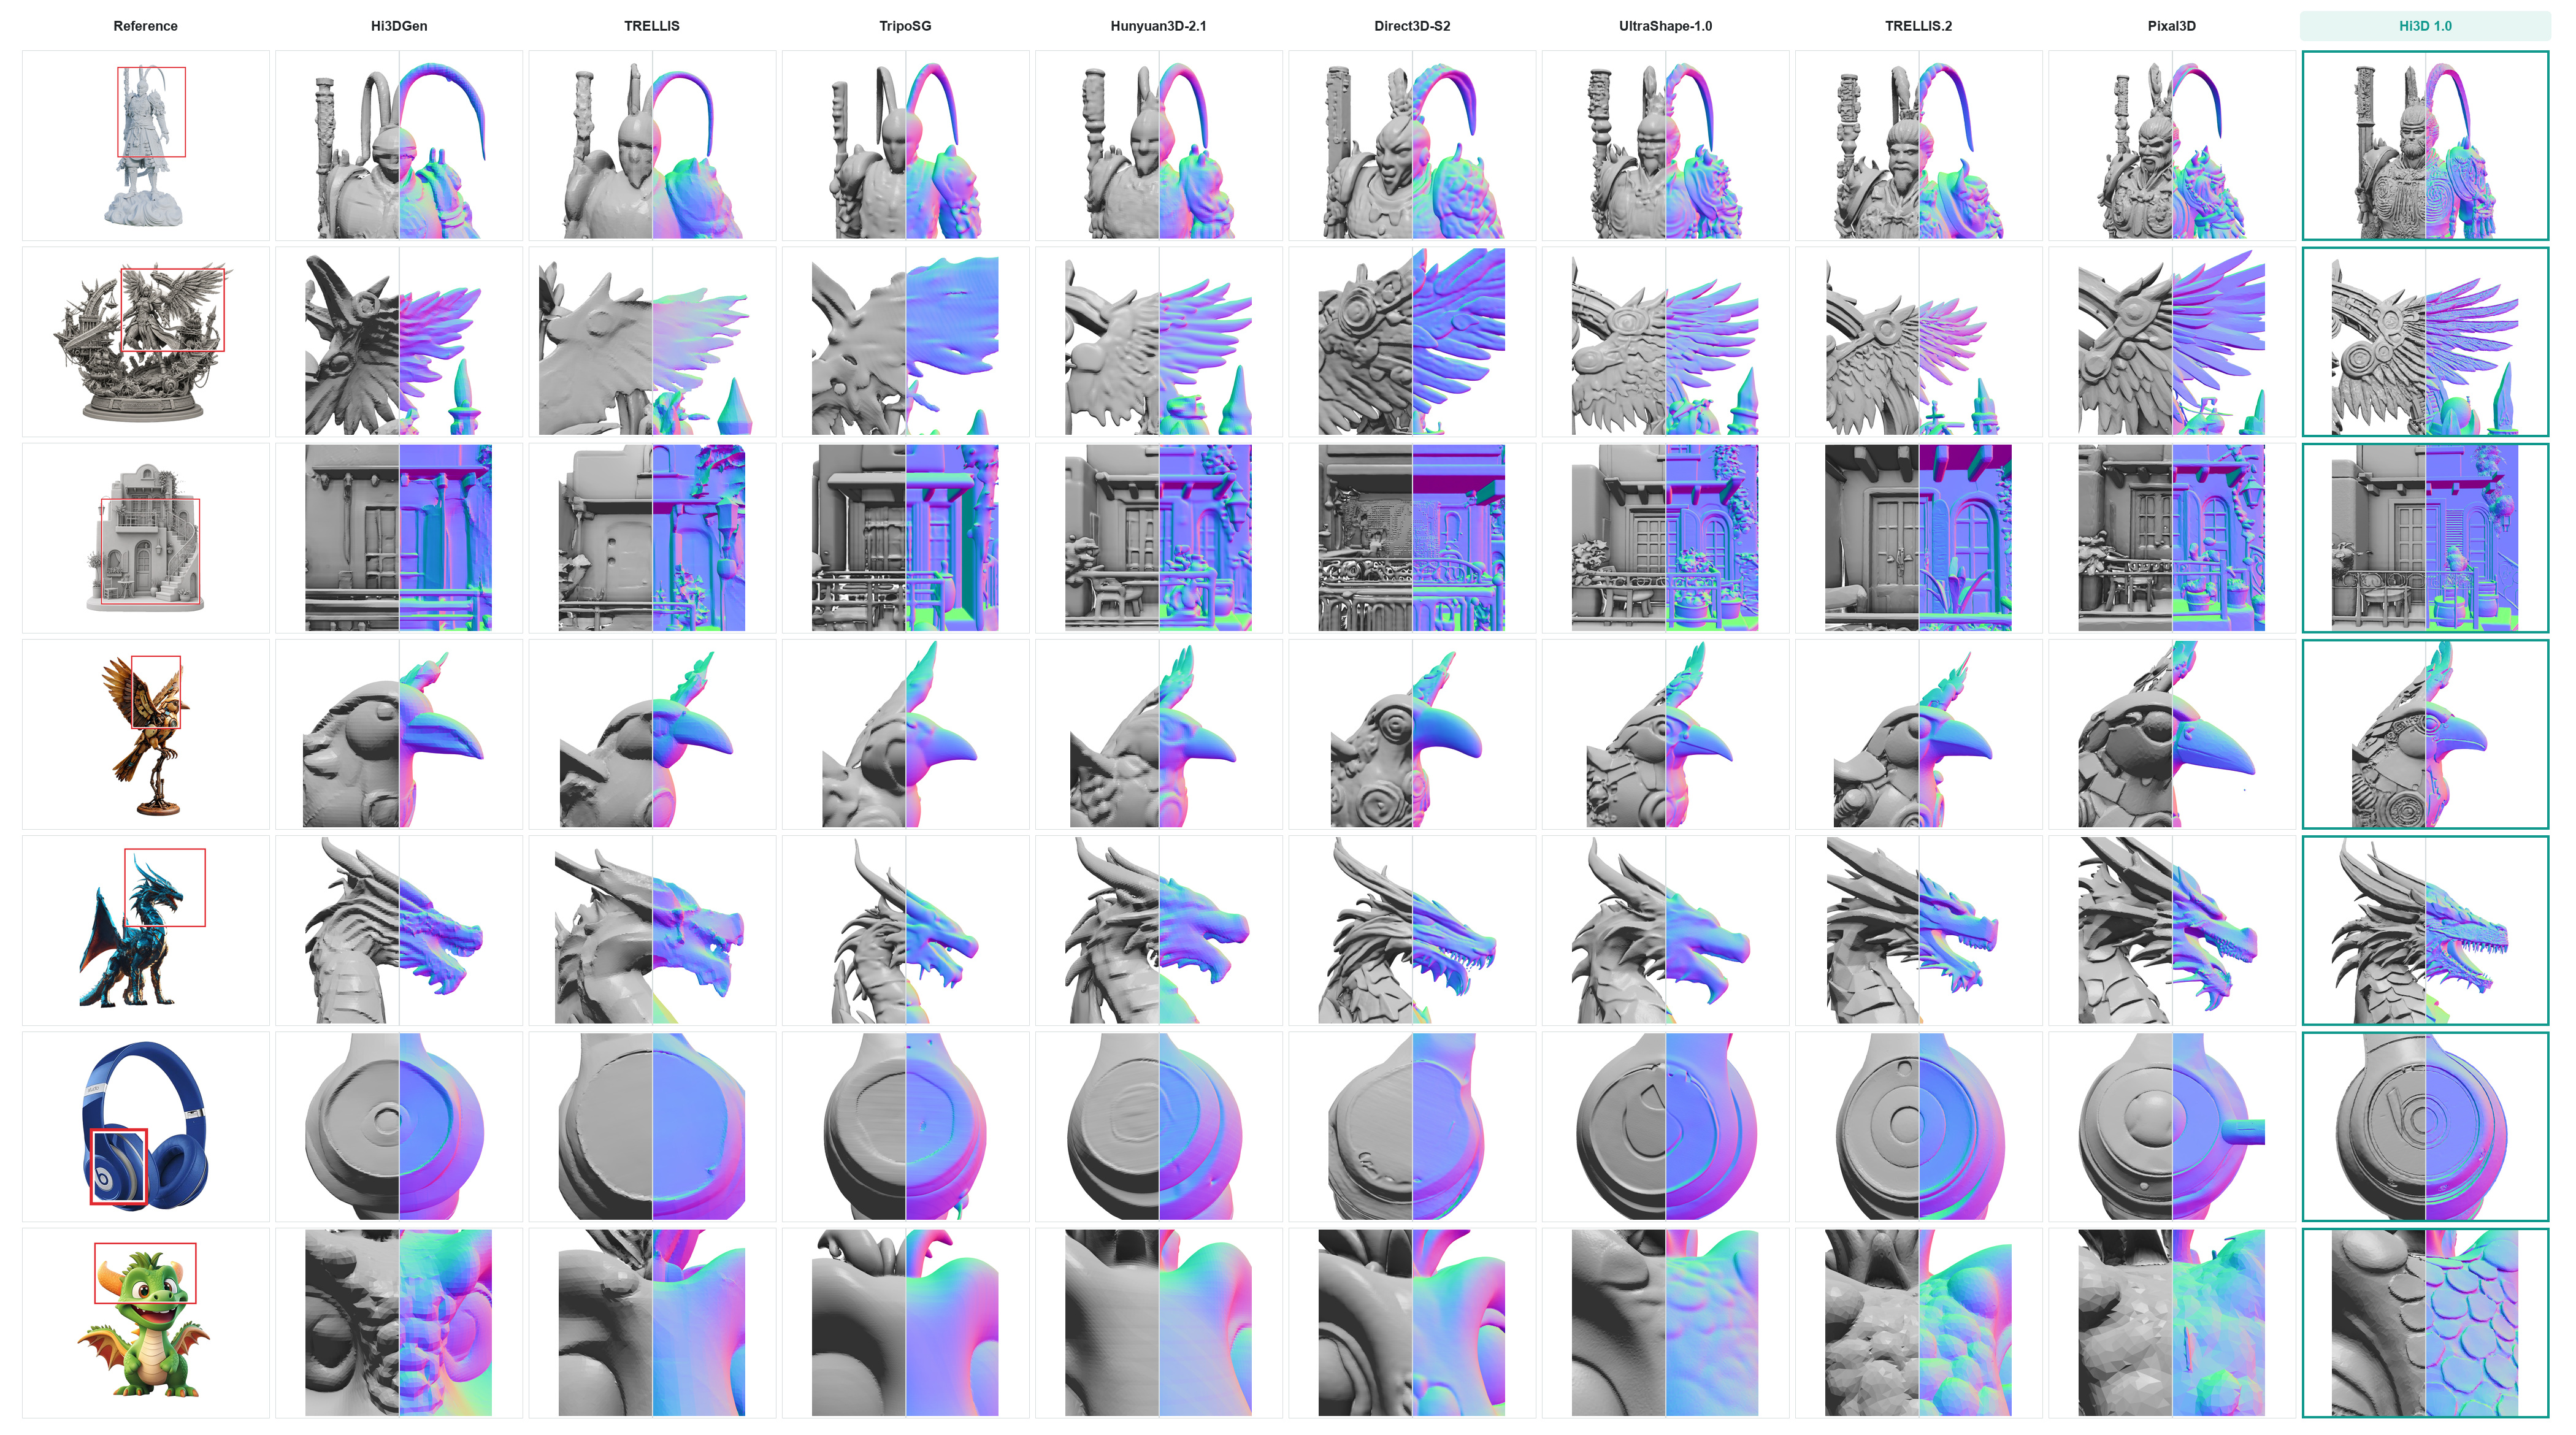
Las regiones de referencia están marcadas con cuadros rojos y se muestran ampliadas por fila, como geometría sombreada y como normales de superficie coloreadas.
La prueba más amplia son cuatro objetos (un vehículo, un personaje acorazado, un sillón y un bolso) vistos desde el frente, la parte trasera y abajo, que es donde una etapa de refinamiento mantiene una silueta coherente o se aleja de la referencia.
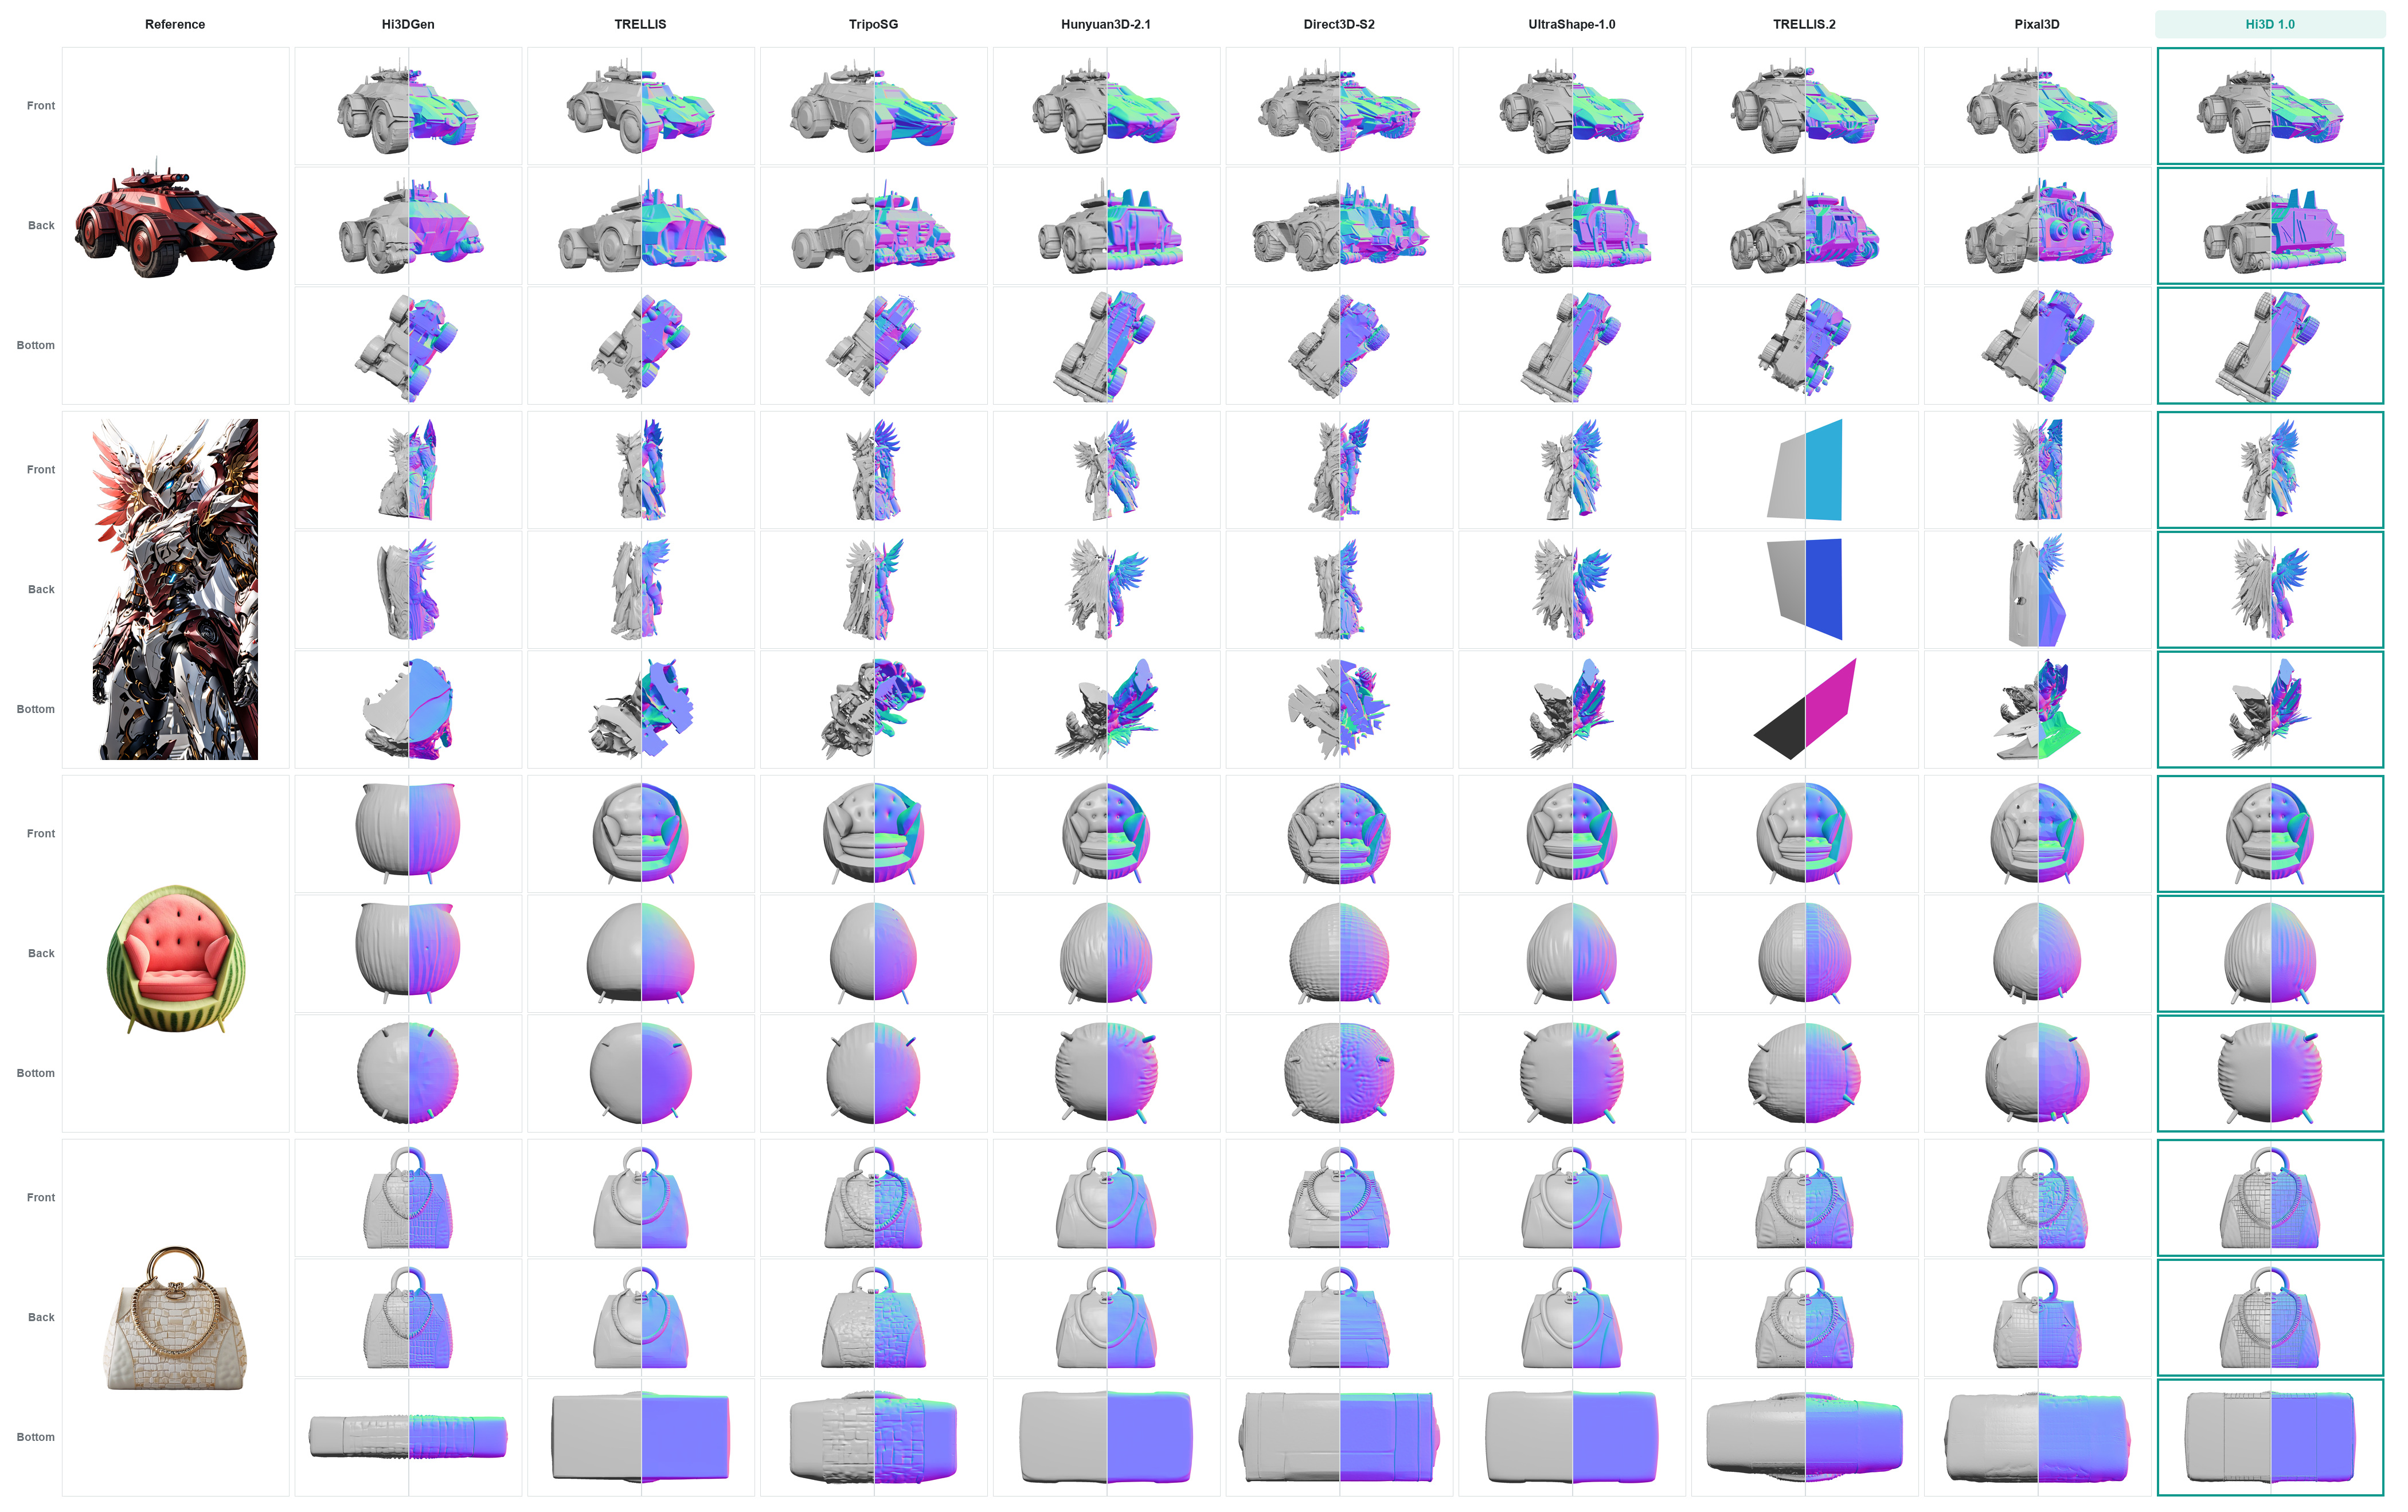
Geometría sombreada y renderizados de normales de superficie uno al lado del otro. Las vistas ocultas ilustran una finalización plausible en lugar de una reconstrucción exacta de las superficies no vistas.
El informe que respalda el lanzamiento describe el entrenamiento con aproximadamente dos millones de recursos 3D curados. El código de entrenamiento, el arnés de evaluación y las mallas de comparación no forman parte del lanzamiento, por lo que las tablas publicadas no pueden reproducirse solo con el repositorio; las cifras anteriores son del propio proyecto.
Lo que la etapa de refinamiento no hace
Las declaraciones de alcance de la tarjeta del modelo son inusualmente directas y establecen las expectativas correctamente:
- Solo geometría. Sin texturas, sin materiales, sin colores de vértices. Hi3D devuelve una malla
trimesh, y la salida se recentra y se normaliza a un radio máximo unitario, por lo que no se conservan las coordenadas del mundo ni la escala absoluta. - La etapa gruesa decide mucho. Los errores estructurales graves de la malla de entrada pueden sobrevivir al refinamiento, y la geometría que la imagen de referencia nunca muestra se convierte en una finalización plausible, no en una reconstrucción.
- La resolución es una solicitud, no una garantía. Una ejecución que no puede alcanzar la resolución solicitada lanza un error en lugar de devolver silenciosamente una malla más gruesa.
Disponibilidad
Hi3D v1.0 se distribuye como un paquete de inferencia en Python con pesos en Hugging Face: ocho archivos de ejecución dispuestos en la raíz del repositorio, con los dos transformers cargados como componentes separados. La etapa gruesa opcional es un adaptador para Hunyuan3D-2 mini, y explícitamente no es una dependencia: demo/refine_mesh.py y Sparc3DPipeline aceptan cualquier malla triangular directamente. Una demo alojada está en línea para probar el refinamiento sin necesidad de instalar nada.
Todavía no hay integración con ComfyUI. El repositorio no contiene Nodos Personalizados, ni Plantillas de flujos de trabajo, ni referencias a ComfyUI, por lo que Hi3D actualmente se ejecuta fuera de ComfyUI a través de su propio pipeline. En los canales 3D de Banodoco, donde el lanzamiento se compartió el 27 de octubre, la pregunta inmediata fue si seguirán nodos nativos; allí el modelo se usa como una etapa de refinamiento delante de los flujos de trabajo de TRELLIS.2 y Pixal3D que la gente ya ejecuta.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.